
Fondamentaux de l’IA
Qu’est-ce que l’ingénierie des plateformes ? Plateformes, expérience développeur et garde-fous

 Ajouter Unite.AI à vos sources préférées sur Google
L’ingénierie des plateformes consiste à concevoir et exploiter des capacités internes partagées qui aident les équipes de développement à livrer et exécuter des applications via des flux de travail en libre-service pris en charge. La plateforme est considérée comme un produit dont les utilisateurs sont les développeurs et les autres équipes techniques.
Une plateforme n’est pas automatiquement un portail, un cluster Kubernetes ou un ensemble de scripts. Elle devient utile lorsqu’elle réduit la charge cognitive et le délai de mise en production tout en améliorant la fiabilité, la sécurité, l’observabilité et la cohérence organisationnelle.
Points clés
- Commencez par la recherche auprès des développeurs et les frictions récurrentes, pas par une pile d’outils prédéterminée.
- Proposez des chemins dorés optionnels et pris en charge, avec des voies de sortie claires pour les exceptions légitimes.
- Exposez les capacités via des API, des modèles, de l’automatisation et de la documentation ; un portail n’est qu’une interface.
- Mesurez les résultats utilisateurs et l’adoption du produit conjointement avec la livraison, la fiabilité, la sécurité et le coût.
La plateforme comme produit interne
Une équipe de plateforme identifie les utilisateurs internes, leurs parcours, leurs points de douleur et les résultats souhaités. Elle maintient une feuille de route, des niveaux de service, de la documentation, du support et des boucles de rétroaction comme toute équipe produit. L’adoption se gagne grâce à l’utilité, et non en imposant une équipe centrale.
Cela étend la coopération DevOps. Les équipes d’applications conservent la propriété de leurs services tandis que la plateforme fournit des capacités réutilisables et des politiques.
Capacités, portails et chemins dorés
Les capacités peuvent couvrir les dépôts, les environnements, le CI/CD, les secrets, l’identité, l’infrastructure, l’observabilité, les catalogues de services, les coûts et l’intégration des incidents. Un portail développeur peut les exposer, mais l’orchestration et les services opérationnels donnent à la plateforme sa réalité.
Un chemin doré est une méthode bien prise en charge pour accomplir une tâche courante. Il doit intégrer des paramètres sécurisés par défaut et rester transparent. Les équipes ont besoin d’un chemin d’exception gouverné lorsque les exigences diffèrent.
Architecture et garde-fous
Utilisez des interfaces stables et des API déclaratives afin que la plateforme puisse évoluer en arrière-plan. Séparez le plan de contrôle des charges de travail, limitez les identifiants, conservez les métadonnées de propriété et rendez les modifications générées révisables et réversibles.
Intégrez les vérifications DevSecOps, les politiques et la provenance des artefacts dans les flux de travail. Les garde-fous doivent fournir un retour rapide et des remédiations exploitables plutôt que des refus inexpliqués.
Mesurer et faire évoluer
Mesurez le temps jusqu’à la première mise en production, le délai de livraison, la récupération après un changement échoué, la disponibilité de la plateforme, la charge de support, l’adoption, la satisfaction, la posture de sécurité et le coût. Évitez de compter les connexions au portail comme un indicateur d’amélioration de la livraison.
Instrumentez la plateforme à l’aide des pratiques IT operations et interrogez régulièrement les utilisateurs. Retirez les chemins inutilisés, standardisez là où la répétition est coûteuse et autorisez la diversité lorsqu’elle crée de la valeur produit.
Plateformes de développeur internes et chemins dorés
Une plateforme de développeur interne est un produit qui expose l’infrastructure et les capacités opérationnelles approuvées via des interfaces en libre-service. Elle peut combiner un portail, un catalogue de services, des modèles, des API, des outils en ligne de commande, des flux de déploiement, des secrets, des environnements et de l’observabilité. La plateforme ne remplace pas le cloud ou Kubernetes ; elle les organise en capacités utilisables.
Un chemin doré est une méthode opinionnée et prise en charge pour accomplir une tâche courante, comme créer un service avec un dépôt, un pipeline CI, un runtime, des tableaux de bord, des alertes et des métadonnées de propriété. Il doit être l’option la plus simple et sûre tout en autorisant des exceptions justifiées. Un chemin obligatoire qui ne peut pas supporter de véritables charges de travail devient un goulot d’étranglement ou est contourné.
Les équipes de plateforme doivent considérer les développeurs comme des clients et les capacités comme des produits. Les entretiens de découverte, les analyses d’usage, les données de support, les feuilles de route, la documentation et les objectifs de niveau de service comptent autant que l’automatisation. L’adoption est la preuve de l’utilité, mais l’adoption seule ne prouve pas que la livraison, la fiabilité, la sécurité ou l’expérience développeur se sont améliorées.
Plans de contrôle, interfaces et modèle opérationnel
Le plan de contrôle de la plateforme réconcilie l’intention déclarée d’un développeur avec les ressources sous-jacentes. Une définition de service peut demander un runtime, une base de données, une région et un niveau de fiabilité ; les contrôleurs traduisent cela en configuration cloud, réseau, politique et observabilité. Les abstractions stables doivent masquer la complexité incidente sans cacher l’état opérationnel nécessaire au débogage.
Les interfaces peuvent inclure des portails web, des API, des configurations basées sur Git, des CLI et des composants de pipeline réutilisables. La meilleure interface dépend de la fréquence des tâches et du flux de travail de l’utilisateur. Chaque interface nécessite authentification, autorisation, validation, historique d’audit, explications d’erreurs et versionnage. Le libre-service sans gestion du cycle de vie engendre des ressources abandonnées et une prolifération de configurations.
Une équipe de plateforme possède les capacités partagées et les chemins balisés, tandis que les équipes d’applications conservent la responsabilité du comportement logiciel et des résultats métier. Les équipes de sécurité, de fiabilité, financières et d’infrastructure contribuent aux politiques et aux services. Des limites de responsabilité explicites empêchent la plateforme de devenir soit une file d’incidents non responsable, soit une tentative de centraliser chaque décision d’ingénierie.
Mesurer la valeur et éviter l’échec de la plateforme
Mesurez le délai de mise en production d’un premier déploiement, le temps de provisionnement d’environnement, la fréquence des déploiements, le taux d’échec des changements, le temps de récupération, la charge cognitive, le volume de support, la fiabilité et l’adoption des contrôles de sécurité. Segmentez les résultats par équipe et charge de travail. Un lancement de modèle plus rapide a une valeur limitée si les changements du jour deux restent lents ou si les incidents deviennent plus difficiles à diagnostiquer.
Les échecs courants incluent la construction avant de comprendre les utilisateurs, la copie d’une pile d’une grande entreprise, l’exposition d’une infrastructure brute derrière un portail, l’imposition d’une standardisation prématurée et l’optimisation pour la production de l’équipe plateforme. Commencez par un parcours récurrent douloureux, cartographiez ses étapes et ses attentes, fournissez un chemin fin de bout en bout, et itérez en fonction des résultats observés.
Les plateformes doivent évoluer sans déstabiliser chaque service. Utilisez des contrats versionnés, des fenêtres de dépréciation, des migrations automatisées, des tests de compatibilité et une propriété claire. Suivez les dépendances de la plateforme afin qu’une panne du plan de contrôle ne bloque pas tous les déploiements ni n’endommage les charges de travail en cours. Documentez les procédures de contournement d’urgence et testez régulièrement la récupération après une défaillance de la plateforme.
Exemple concret : un chemin en libre-service pour une nouvelle API
Un développeur sélectionne un modèle d’API approuvé et fournit le nom du service, le propriétaire, la classification des données, le langage et le niveau de fiabilité. La plateforme crée un dépôt, une politique de dépendance, un pipeline CI, un environnement de test, une configuration de déploiement, une entrée de catalogue de services, des tableaux de bord, des alertes et un livret d’exploitation initial. La politique valide les noms, les régions, les autorisations et l’exposition réseau avant le provisionnement, tandis que les artefacts générés restent inspectables et appartenant à l’équipe.
La plateforme expose les opérations du cycle de vie — créer un environnement, déployer, mettre à l’échelle, faire pivoter un secret, consulter les journaux, revenir en arrière et retirer — via des API stables et un portail. Les charges de travail en cours continuent de fonctionner si le portail est indisponible. Les exceptions utilisent un point d’extension documenté et une expiration plutôt qu’une modification manuelle non suivie. Les modèles versionnés et les migrations automatisées empêchent les améliorations de la plateforme de casser silencieusement les services existants.
Mesurez le temps entre la création du dépôt et un déploiement en production sain, l’effort développeur, la demande de support, les échecs de changement, la récupération, la conformité aux politiques et l’adoption selon le type de charge de travail. Interrogez les utilisateurs qui abandonnent le chemin et examinez où ils attendent ou échappent à l’abstraction. L’équipe plateforme doit prioriser la plus grande friction récurrente, publier la fiabilité et la feuille de route, et retirer les capacités inutilisées. Un catalogue soigné n’est pas une plateforme si les équipes ont encore besoin de tickets pour chaque opération significative.
L’adoption doit être progressive. Commencez avec des équipes volontaires et une classe de charge de travail, prouvez les opérations du jour deux, puis migrez avec les outils et le support. Publiez les objectifs de service et l’état des dépendances de la plateforme, et concevez un chemin de contournement d’urgence qui soit contrôlé mais utilisable en cas de panne. Le chargeback ou le showback peut révéler le coût des ressources, mais les équipes produit ont également besoin de valeurs par défaut sensées afin que la gouvernance financière ne devienne pas une autre file d’approbation manuelle.
Liste de contrôle de mise en œuvre pratique
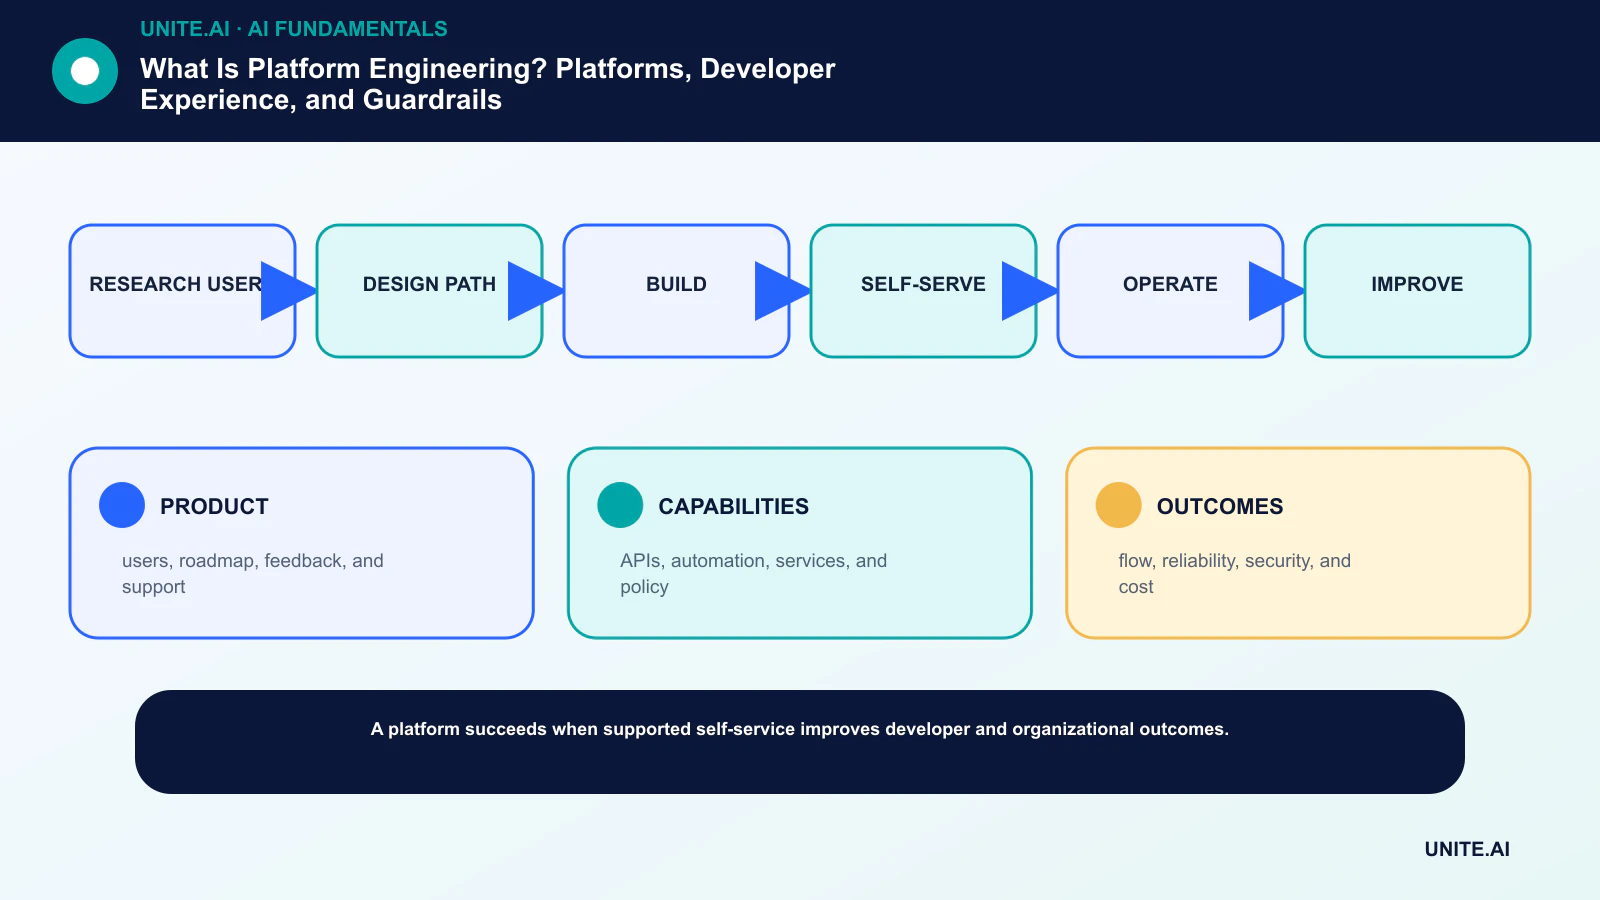
Transformez le concept en un flux de travail limité et testable : recherche des utilisateurs → conception du chemin → construction → libre-service → exploitation → amélioration. Désignez un propriétaire responsable, documentez les données et les dépendances, établissez une base simple, définissez les critères d’acceptation et d’arrêt, testez des échecs représentatifs, et définissez la surveillance, le rollback et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les pannes de dépendances et les abus ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la version, modifier un seuil, contourner une sortie ou arrêter l’opération. Réexaminez la décision après l’arrivée des données réelles, car un pilote techniquement réussi ne garantit pas des performances fiables à plus grande échelle.
- PRODUIT: utilisateurs, feuille de route, retours et support.
- CAPACITÉS: API, automatisation, services et politique.
- RÉSULTATS: flux, fiabilité, sécurité et coût.
Foire aux questions
L’ingénierie des plateformes remplace‑t‑elle DevOps ?
Non. L’ingénierie des plateformes est une façon de faire évoluer les principes DevOps en fournissant des produits partagés et des capacités en libre‑service. La collaboration et la responsabilité du service restent essentielles.
Un portail développeur interne est‑il la plateforme ?
En général, non. Un portail est une interface. La plateforme comprend également les API, l’automatisation, l’infrastructure, les politiques, les services, la documentation, le support et la responsabilité opérationnelle.
Références principales











