Fondamentaux de l’IA
FinOps 101: Guide du débutant aux opérations financières du cloud

 Ajouter Unite.AI à vos sources préférées sur Google
FinOps est un cadre opérationnel et une pratique culturelle visant à maximiser la valeur métier de la technologie grâce à la collaboration entre l’ingénierie, les finances, le produit, les achats et la direction. Il relie l’utilisation technique aux coûts, à la valeur et aux décisions en temps opportun.
FinOps n’est pas simplement une équipe de réduction des coûts. Dépenser davantage peut être justifié lorsqu’il améliore un service précieux ; dépenser moins peut être préjudiciable lorsqu’il réduit la fiabilité ou ralentit la croissance. L’objectif est de réaliser des compromis responsables en s’appuyant sur des données partagées.
Points clés
- Attribuer l’utilisation et le coût de la technologie à des périmètres responsables tels que les produits, les équipes ou les environnements.
- Utiliser l’économie unitaire — coût par transaction, client ou inférence de modèle — pour relier les dépenses à la valeur.
- Séparer l’optimisation de l’utilisation de l’optimisation des tarifs et inclure les contraintes de fiabilité, de sécurité et de durabilité.
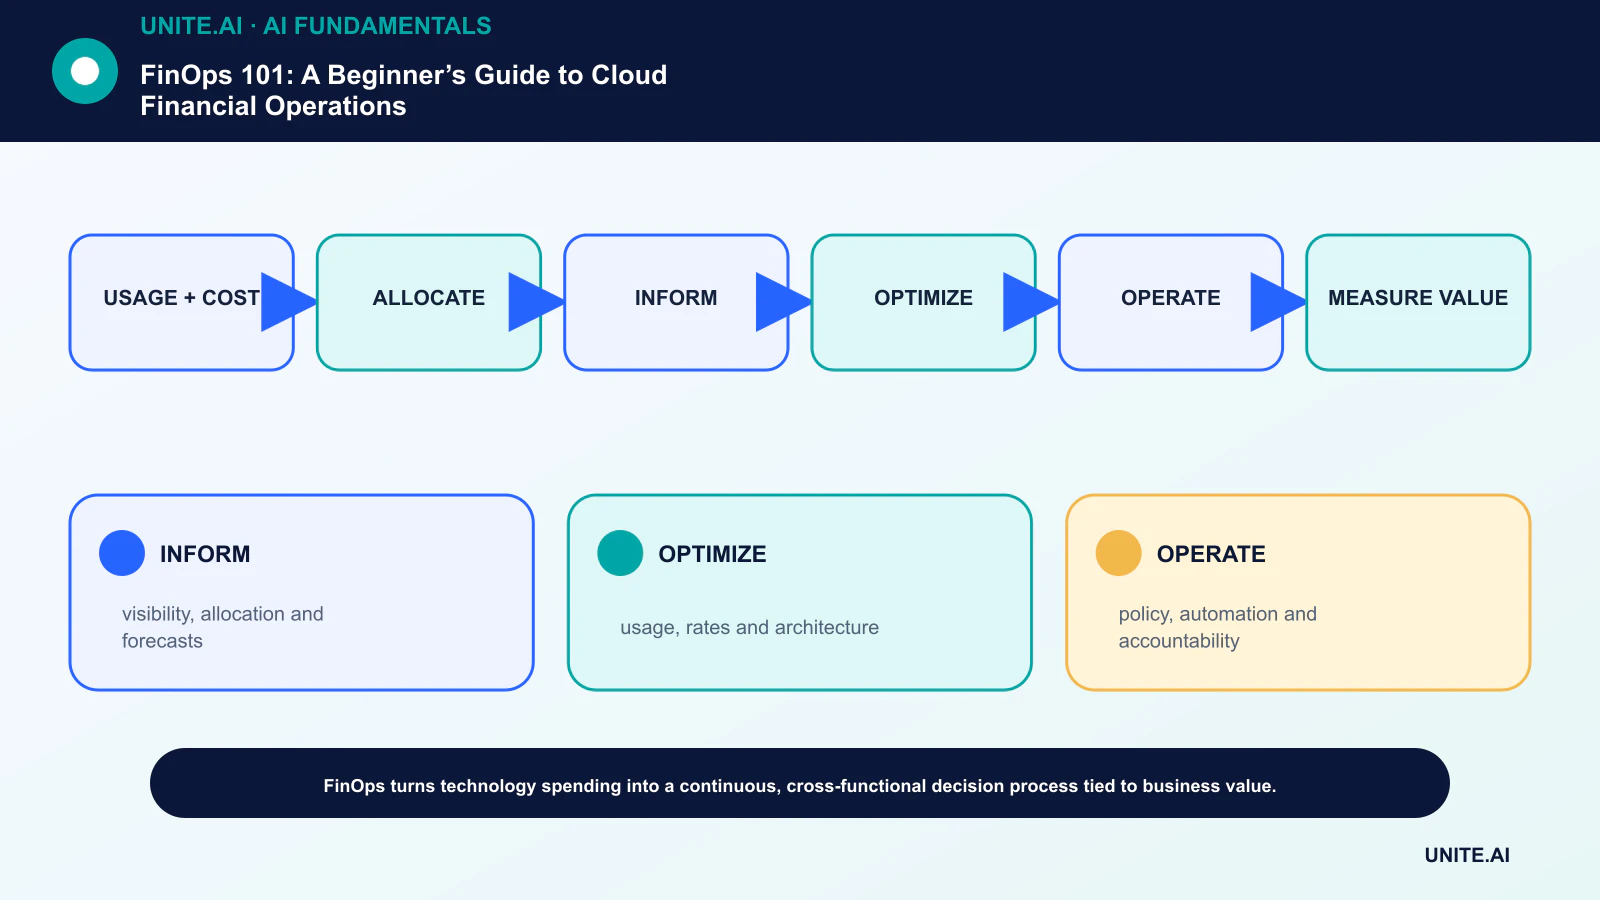
- Informer, Optimiser et Exploiter forment un cycle continu plutôt qu’un projet ponctuel d’économies.
Créer des périmètres partagés et des données de coûts
Un périmètre est un segment défini des dépenses technologiques aligné sur une construction métier. Les tags, comptes, projets et exportations de facturation aident à attribuer les coûts directs, tandis que les plateformes partagées nécessitent des règles d’allocation documentées.
Les données doivent être opportunes, suffisamment précises pour la décision et conciliables avec les factures. Les coûts non alloués et partagés doivent rester visibles plutôt que d’être forcés dans une fausse précision. Reliez les variations de coûts aux déploiements, au trafic et aux décisions architecturales.
Informer avec des prévisions et l’économie unitaire
Les tableaux de bord expliquent où se situent l’utilisation et les coûts ; les prévisions estiment la demande future ; les budgets expriment un plan convenu. La gestion des anomalies détecte rapidement les changements inattendus, mais une anomalie peut représenter une croissance légitime plutôt qu’un gaspillage.
Les métriques unitaires divisent le coût par un résultat lié à la valeur. Pour l’IA, des exemples incluent le coût par tâche réussie ou par mille inférences vérifiées. Associez les métriques financières à la qualité et à la latence afin que les équipes n’optimisent pas vers l’échec à bas coût.
Optimiser l’utilisation et les tarifs
L’optimisation de l’utilisation élimine les ressources inactives, ajuste la taille des charges de travail, planifie les jobs flexibles et modifie l’architecture. L’optimisation des tarifs utilise les engagements, réservations, tarifications négociées et stratégies de licences pour payer moins pour l’utilisation nécessaire.
Les engagements créent un risque de prévision, et un redimensionnement agressif peut réduire la marge de manœuvre. Évaluez la fiabilité, la sécurité, l’effort d’ingénierie et les implications carbone du placement. Les mesures provenant du travail AI carbon-footprint peuvent compléter les données de coûts.
Exploiter via la politique et l’automatisation
Les politiques définissent la propriété, les services approuvés, la conservation des données, l’autorité d’engagement et les seuils d’escalade. L’automatisation peut appliquer les tags, arrêter les environnements abandonnés ou notifier les propriétaires, mais les actions destructrices nécessitent des garde‑fous et des exceptions.
Intégrez FinOps avec DevOps afin que les ingénieurs voient le coût lors de la conception et de la livraison, pas seulement après la facture. Examinez les résultats, mettez à jour les prévisions et intégrez les leçons dans la prochaine phase d’Information.
Appliquer FinOps au‑delà du cloud public
Le cadre actuel de la FinOps Foundation couvre des périmètres technologiques plus larges, incluant le SaaS, les licences, les centres de données et l’IA. Les mêmes principes — données partagées, décisions responsables et mesure de la valeur — s’appliquent, bien que les mécanismes de facturation et d’allocation diffèrent.
Commencez par un problème à forte valeur et un petit nombre de capacités. Une pratique mature n’est pas celle qui possède le plus de tableaux de bord ; c’est celle qui réalise des compromis plus rapides et meilleurs et qui vérifie le résultat.
Principes de FinOps et le modèle de coût du cloud
FinOps est une pratique transversale qui aide les équipes d’ingénierie, de finances, d’achats et de produit à prendre des décisions opportunes concernant la valeur et le coût variables du cloud. Ce n’est pas un exercice ponctuel de réduction des coûts. Les factures cloud combinent utilisation, tarifs, engagements, régions, niveaux, transfert de données, support, licences et taxes. L’allocation cartographie ces charges aux produits, équipes, environnements ou clients responsables via comptes, abonnements, projets, tags, labels et règles de coûts partagés.
Le cycle FinOps est souvent décrit comme informer, optimiser et exploiter. Informer crée une allocation fiable, l’économie unitaire, les budgets et les prévisions. Optimiser élimine le gaspillage, ajuste la taille, planifie le non‑production, améliore les architectures et gère les engagements. Exploiter intègre le retour de coût dans la planification et l’ingénierie. La gouvernance centrale fournit normes et outils, tandis que les équipes produit possèdent les compromis avec fiabilité, sécurité, performance et feuille de route. Les finances valident la comptabilité et les prévisions ; les achats gèrent les conditions commerciales.
Métriques, engagements et optimisation
Le total des dépenses est incomplet. Les métriques unitaires — coût par transaction, client, inférence de modèle, construction ou enregistrement stocké — relient la consommation à la valeur et révèlent si la croissance est efficace. Suivez le coût amorti des engagements, les économies réalisées, le gaspillage, l’erreur de prévision, la couverture d’allocation et la réponse aux anomalies. Évitez les objectifs qui incitent les équipes à déplacer les coûts, à sous‑provisionner la fiabilité ou à supprimer une observabilité utile. Les estimations de coûts nécessitent la devise, la période temporelle et les règles d’inclusion.
La capacité réservée et les engagements d’économies abaissent les tarifs en échange d’un terme et d’un risque d’utilisation. Modélisez la demande de base, la croissance, la saisonnalité et la portabilité du service avant d’acheter. Le redimensionnement doit s’appuyer sur le CPU, la mémoire, les I/O, la latence et la redondance soutenus, pas uniquement sur la moyenne du CPU. La capacité spot convient aux charges de travail interrompues avec point de contrôle et nouvelle tentative. Le cycle de vie du stockage et le transfert de données nécessitent souvent des changements architecturaux. Chaque optimisation doit passer les tests de performance, de récupération et de sécurité.
Gouvernance et charges de travail cloud‑IA
Les budgets et les alertes d’anomalies nécessitent des propriétaires et des seuils actionnables. Le showback informe les équipes ; le chargeback attribue la responsabilité financière mais requiert une allocation stable. Automatisez la politique avec des exceptions et des expirations, et examinez les ressources inutilisées, les engagements orphelins et les outils dupliqués. L’IA introduit une rareté des accélérateurs, une utilisation variable des jetons, de grands déplacements de données et des expériences à valeur incertaine. Mesurez le coût par tâche réussie et qualifiée en qualité, en incluant les exécutions échouées et les revues. FinOps réussit lorsque le coût devient un signal de conception sans réduire la sécurité ou la valeur client du service.
Exemple pratique: réduction du coût unitaire d’un service d’IA
Une équipe définit l’unité comme le coût par cas de support résolu avec succès à la qualité requise. La facturation, les jetons, le modèle, le cache, la récupération, la revue et les données d’infrastructure sont alloués au service. L’analyse montre que les invites longues, le contexte de document répété, les nouvelles tentatives et un grand modèle pour des classifications simples augmentent le coût. Un routeur plus petit, un cache conscient des permissions, un contexte limité et un lot d’embeddings réduisent les dépenses tout en conservant un jeu d’évaluation privé inchangé.
Le déploiement compare la qualité, le taux de refus, la latence, l’escalade et le résultat client ainsi que les dépenses. Les budgets et les alertes d’anomalies ont des propriétaires de service ; les engagements ne sont achetés que pour une charge de base stable. L’allocation des coûts et les versions du modèle apparaissent dans les tableaux de bord, et la sécurité ou l’observabilité ne sont pas désactivées pour atteindre un objectif. L’équipe rapporte les économies par cas résolu plutôt que le prix par jeton, car un modèle bon marché qui engendre des nouvelles tentatives et des revues peut augmenter le coût total et la charge pour l’utilisateur.
Preuves de mise en œuvre et état de préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et la conséquence de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les dérives de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité des tâches conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sécurisé et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Questions fréquemment posées
Qui possède le coût du cloud dans FinOps ?
La propriété est partagée. L’ingénierie influence l’architecture et l’utilisation, les finances fournissent la planification et la réconciliation, et le produit ainsi que la direction relient les dépenses à la valeur.
FinOps est‑il réservé aux grandes entreprises ?
Non. Les petites équipes peuvent commencer avec une responsabilité claire, des budgets, des alertes d’anomalies et un rythme de révision régulier avant d’adopter des outils spécialisés.
Références principales