
Fondamentaux de l’IA
Qu’est‑ce qu’un entrepôt de données ? Architecture, ETL et cas d’utilisation

 Ajouter Unite.AI à vos sources préférées sur Google
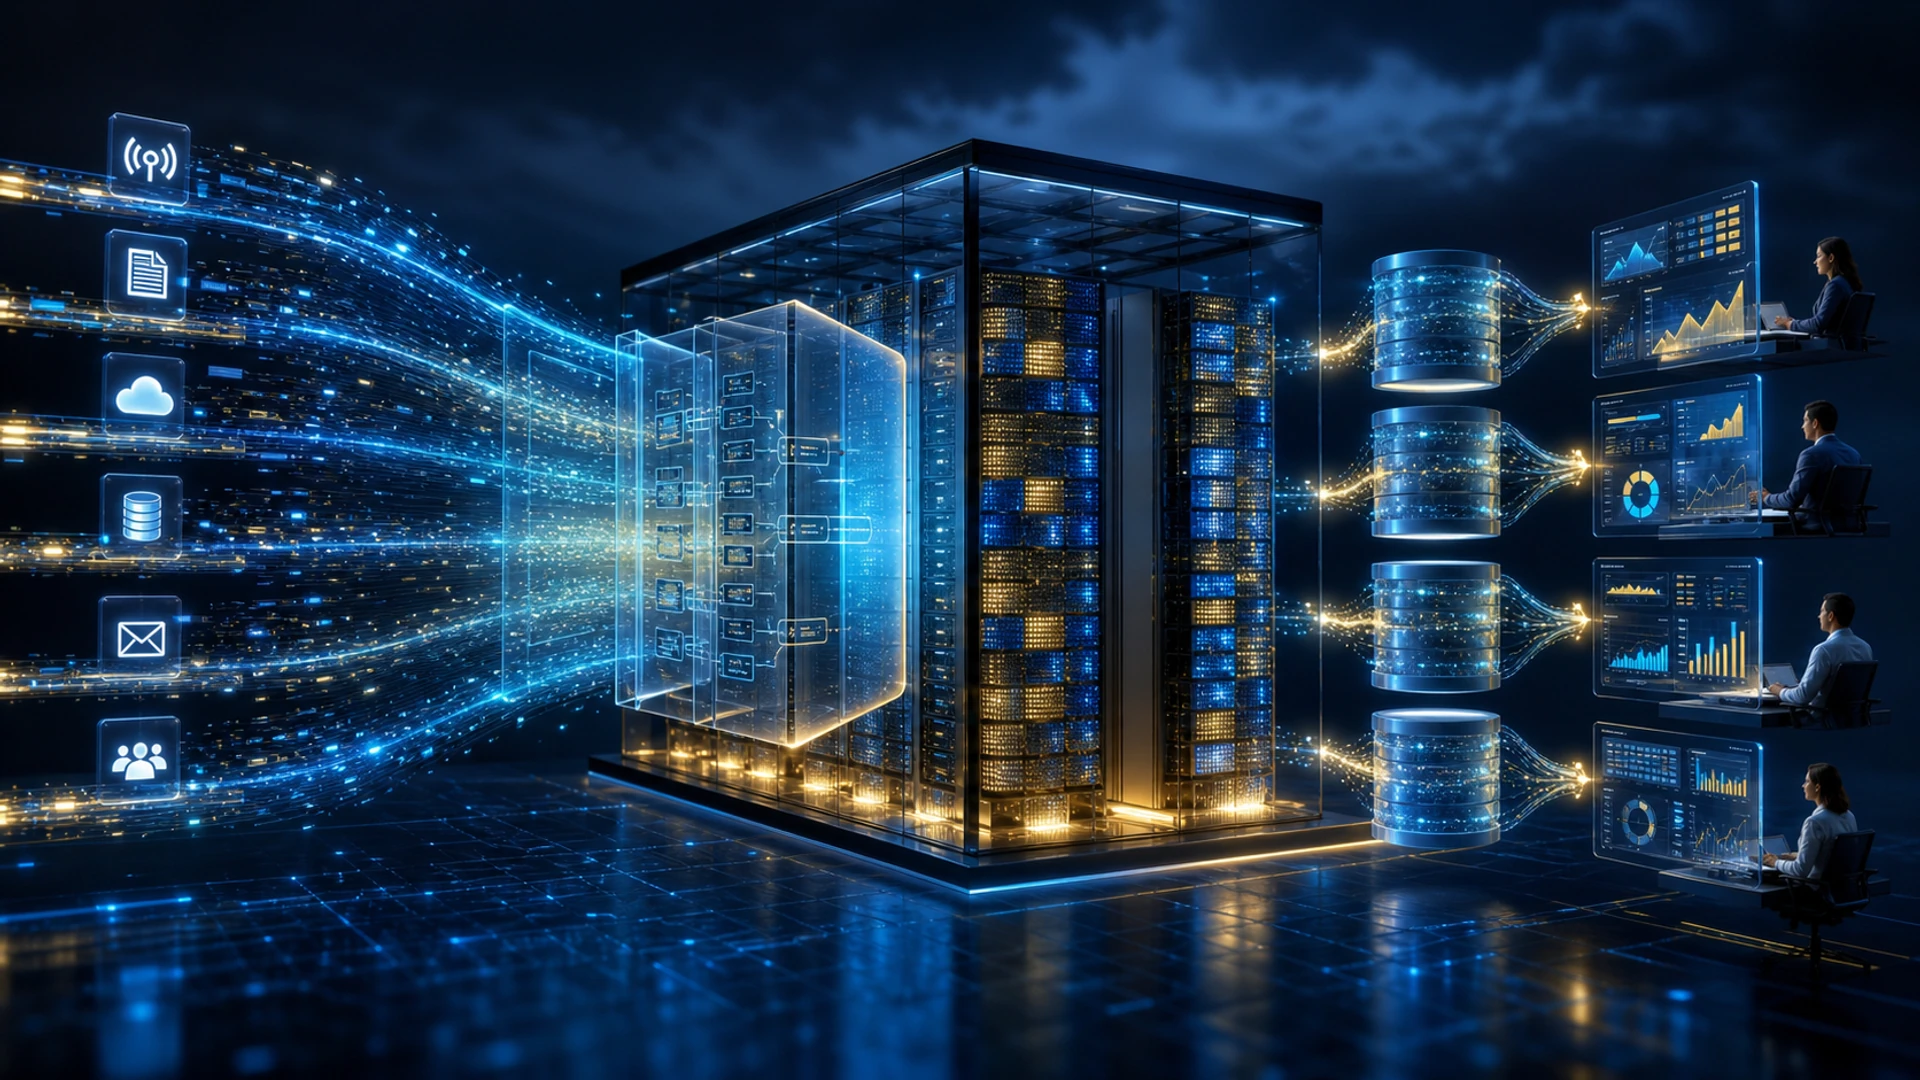
Un entrepôt de données est un système de données analytique qui intègre les informations provenant de sources opérationnelles et les organise pour le reporting, l’intelligence économique et l’analyse récurrente. Il sépare de nombreuses charges de travail analytiques des applications qui enregistrent les transactions.
Les entrepôts modernes peuvent être columnaires, distribués, serverless ou connectés à un stockage d’objets. Le travail de base reste constant: ingestion gouvernée, sémantique modélisée, historique, performance des requêtes, sécurité, qualité et livraison fiable aux utilisateurs.
Points clés
- Les systèmes opérationnels optimisent les transactions courantes ; les entrepôts optimisent l’analyse historique à travers les sources.
- L’ETL transforme avant le chargement, tandis que l’ELT charge d’abord et transforme au sein de la plateforme analytique.
- Les modèles dimensionnels, normalisés et à tables larges répondent à des charges de travail et des besoins de gouvernance différents.
- La confiance dépend de la traçabilité, des tests, de la fraîcheur, du contrôle d’accès, des définitions sémantiques et du suivi des coûts.
Sources, ingestion et stockage
Les données peuvent arriver par lots, capture de changements, flux, fichiers et API. Une couche d’atterrissage préserve le contexte source: les transformations standardisent les types, dédupliquent les enregistrements, gèrent les événements tardifs et créent des entités analytiques réutilisables.
Cela prolonge le flux de travail ETL. L’ELT utilise la puissance de calcul de l’entrepôt pour la transformation, tandis que l’ETL peut réduire ou valider les données avant le chargement. Le choix approprié dépend de la latence, de la confidentialité, de l’échelle et de la chaîne d’outils.
Modéliser les données pour les questions
Les modèles dimensionnels organisent les faits mesurables autour de dimensions descriptives telles que client, produit et temps. Les modèles de base normalisés peuvent préserver les relations d’entreprise, tandis que les marts dénormalisés simplifient les requêtes courantes.
Une couche sémantique fournit des définitions cohérentes aux indicateurs. Sans elle, les équipes peuvent produire plusieurs chiffres de revenu ou de rétention qui semblent valides à partir des mêmes lignes. Les données structurées nécessitent toujours une signification convenue.
Entrepôt, lac et lakehouse
Un lac de données stocke généralement des fichiers et des données brutes ou traitées diverses dans un stockage d’objets. Un entrepôt fournit des tables analytiques gérées et des services de requête. Les conceptions de lakehouse ajoutent des métadonnées de tables, des transactions et de la gouvernance au stockage du lac.
Il s’agit de modèles architecturaux, pas de garanties. Les organisations les combinent souvent via un data fabric ou une couche de gouvernance partagée. La charge de travail, les compétences, l’interopérabilité et le coût du cycle de vie comptent davantage que le libellé.
Qualité, sécurité et opérations
Définissez les propriétaires, les contrats, les objectifs de fraîcheur, la traçabilité, les tests, la rétention et les accès aux lignes ou colonnes. Séparez les données personnellement identifiables, utilisez le principe du moindre privilège et auditez les requêtes sensibles. Les reconstitutions et les changements de schéma nécessitent des procédures contrôlées et observables.
Mesurez les rafraîchissements réussis, le retard des données, les échecs de tests, la performance des requêtes, l’adoption, l’impact des incidents et le coût par charge de travail. Un entrepôt est utile lorsque les utilisateurs peuvent tracer un indicateur jusqu’aux données gouvernées et reproduire le résultat.
Modélisation dimensionnelle et sémantique
Une table de faits enregistre des événements ou des mesures périodiques à un grain déclaré, tel qu’une ligne de commande ou un appareil par heure. Les dimensions fournissent un contexte descriptif. Déclarer le grain avant de sélectionner les colonnes évite de mélanger des niveaux qui entraînent un double comptage. Les mesures additives peuvent être additionnées sur toutes les dimensions ; les mesures semi‑additives nécessitent une attention particulière dans le temps.
Les clés de substitution découpent l’historique de l’entrepôt des identifiants sources changeants. Les dimensions à évolution lente définissent la façon dont les changements d’attributs sont gérés: écrasement, conservation d’une nouvelle ligne historique, ou maintien de valeurs antérieures limitées. La méthode correcte dépend de la question analytique et des obligations de rétention.
Une métrique sémantique doit définir la formule, les filtres, le comportement temporel, la devise, les exclusions, le propriétaire et les tests. Des définitions centrales réduisent les incohérences, mais la gouvernance doit permettre les changements proposés et la gestion des versions. Une couche sémantique unique devient un goulot d’étranglement si les utilisateurs ne peuvent pas l’inspecter ou l’étendre de manière responsable.
Stockage moderne et architecture de requête
Le stockage columnaire regroupe les valeurs d’une colonne, améliorant la compression et la lecture uniquement des champs nécessaires. Le partitionnement élimine de grandes sections par date ou autre clé; le clustering regroupe les valeurs liées; les vues matérialisées et les caches réutilisent les résultats. De mauvais choix de partition créent de petits fichiers, des déséquilibres ou des scans complets coûteux.
Les moteurs de requête massivement parallèles répartissent les scans, les jointures et les agrégations entre les travailleurs. Le déplacement des données lors des jointures peut dominer le temps d’exécution, ainsi la distribution, les statistiques et l’ordre des jointures sont importants. L’autoscaling et les services serverless simplifient la capacité mais exigent des contrôles de coûts, des priorités de charge de travail et des limites sur les requêtes incontrôlées.
Les formats de tables lakehouse ajoutent des métadonnées, des instantanés, l’évolution du schéma et des sémantiques de transaction sur les fichiers d’objets. Ils améliorent l’interopérabilité mais introduisent des responsabilités de catalogue et de maintenance. Les formats ouverts réduisent le verrouillage uniquement lorsque les moteurs de calcul, la gouvernance et les procédures opérationnelles peuvent réellement les exploiter.
Pipelines fiables et produits de données
Les pipelines doivent être idempotents ou capables de concilier les doublons. Les repères temporels et le temps d’événement gèrent les arrivées tardives; les reconstitutions reproduisent les transformations historiques; les contrats de schéma définissent les changements compatibles. Les tests de données couvrent l’unicité, la complétude, les valeurs acceptées, les relations et les invariants métier — pas seulement si un job s’est exécuté.
Considérez les ensembles de données importants comme des produits avec des propriétaires, une documentation, des attentes de service, une découvrabilité, un support et des utilisateurs. La traçabilité relie les champs sources à travers les transformations aux rapports, rendant l’impact des changements et l’investigation des incidents plus rapides. Les politiques d’accès doivent se propager ou être réévaluées lorsqu’une donnée est copiée.
Un programme d’entrepôt réussit lorsque les décisions deviennent plus fiables et plus rapides, et non lorsque le volume de stockage augmente. Retirez les tables inutilisées, exposez le coût des requêtes et du stockage, examinez les accès sensibles, et mesurez si les équipes font confiance et réutilisent les métriques gouvernées au lieu de maintenir des feuilles de calcul privées.
Exemple pratique : concevoir un entrepôt d’analyse des ventes
Définissez le grain de fait comme une ligne de commande terminée, puis reliez les dimensions produit, client, canal, promotion, géographie et date via des clés de substitution. Conservez les événements d’état de commande dans une table de faits séparée plutôt que de mélanger instantanés et transactions. Le revenu, la quantité, la remise, la taxe et le coût nécessitent des règles explicites de devise, de retour, d’annulation et de reconnaissance. La définition de la métrique doit produire la même réponse dans les tableaux de bord, les notebooks et la réconciliation financière.
L’ingestion capture les changements sources, atterrit les données brutes immuables, valide le schéma et les transforme en modèles de staging et dimensionnels testés. Les mises à jour tardives doivent corriger la période historique appropriée sans dupliquer les faits. Comparez les comptes de lignes et les totaux monétaires avec les systèmes sources, testez l’unicité et les relations, et enregistrez la traçabilité du champ de rapport à la source. Les reconstitutions utilisent du code versionné et une validation isolée avant de remplacer les tables de confiance.
L’accès sépare les identifiants clients des agrégats largement disponibles et applique le principe du moindre privilège selon le rôle et le but. La gestion des charges de travail maintient les tableaux de bord exécutifs réactifs tandis que les analystes exécutent des requêtes exploratoires. Surveillez la fraîcheur, les tests échoués, le coût des requêtes, les tables inutilisées et les changements sémantiques. Un entrepôt réussit lorsque les métriques gouvernées soutiennent des décisions récurrentes ; la simple centralisation des données peut centraliser la confusion si la propriété, la qualité et les définitions restent non résolues.
La reprise après sinistre doit préciser la couverture des sauvegardes, les copies inter‑régionales, la restauration du catalogue et des autorisations, la perte de données acceptable et le temps de récupération. Testez la restauration dans un environnement isolé et vérifiez les métriques, pas seulement les fichiers. Les clés de chiffrement, la configuration d’identité, le code d’orchestration et les définitions sémantiques font partie du système récupérable. Un entrepôt qui peut restaurer des pétaoctets mais ne peut pas reproduire la politique d’accès ou les calculs de confiance n’a pas récupéré son service analytique.
Liste de contrôle de mise en œuvre pratique
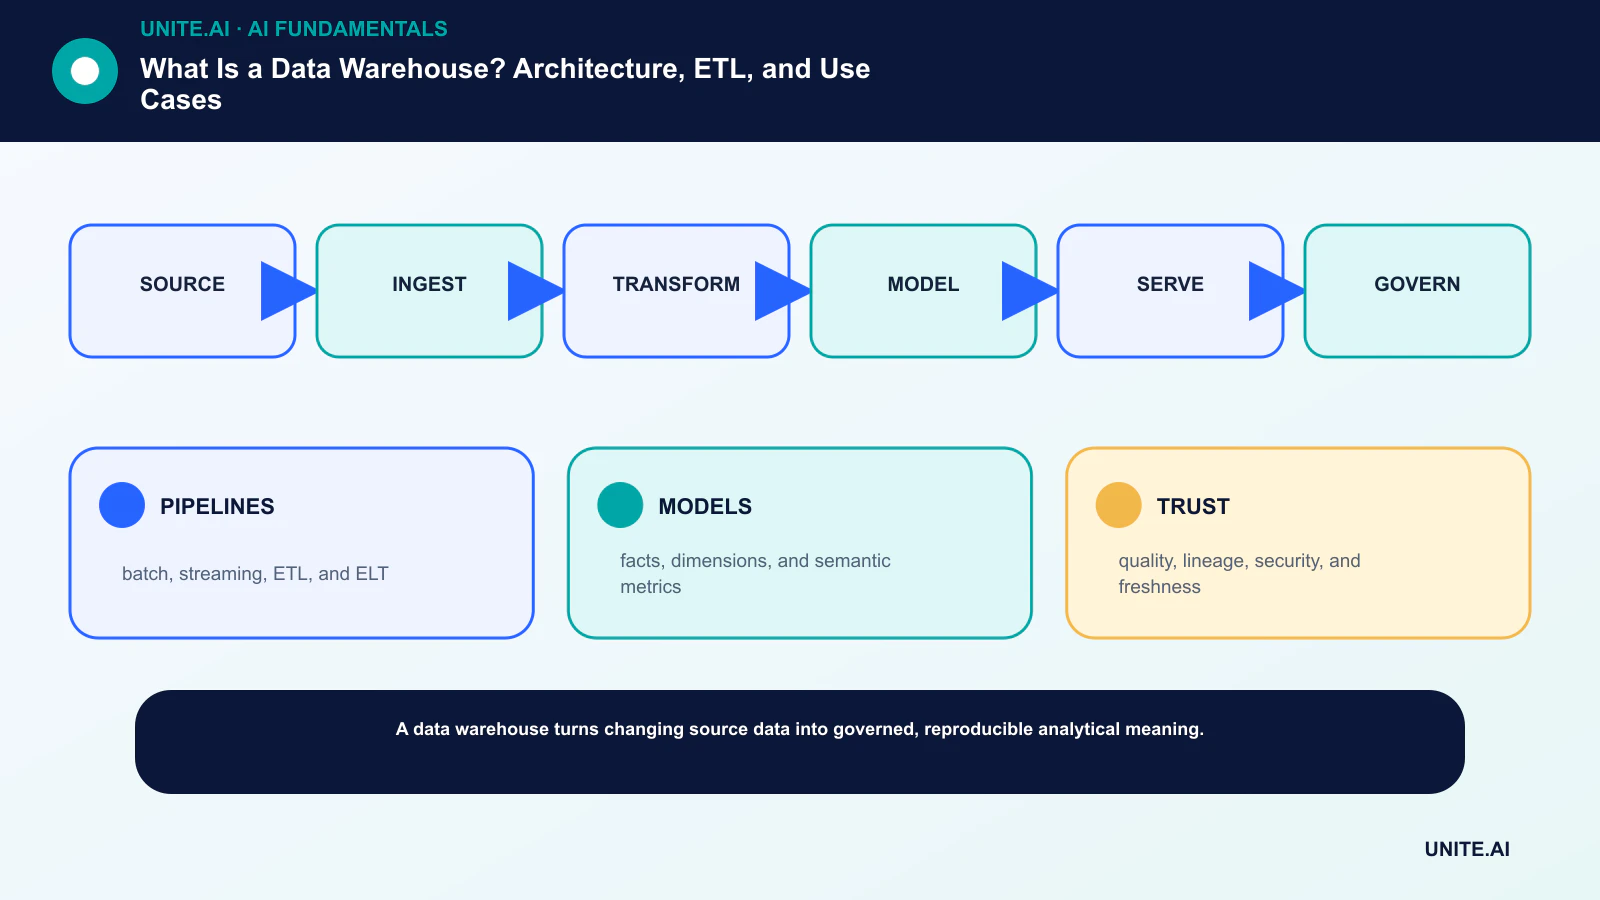
Transformez le concept en un flux de travail limité et testable: source → ingestion → transformation → modélisation → service → gouvernance. Désignez un propriétaire responsable, documentez les données et les dépendances, établissez une base simple, définissez les critères d’acceptation et d’arrêt, testez des échecs représentatifs, et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les échecs de dépendances et les usages abusifs; conservez les preuves et les risques non résolus. Définissez qui peut approuver la mise en production, modifier un seuil, outrepasser une sortie ou arrêter l’opération. Reconsidérez la décision après l’arrivée de données réelles, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- PIPELINES: lots, flux, ETL et ELT.
- MODÈLES: faits, dimensions et métriques sémantiques.
- CONFIANCE: qualité, traçabilité, sécurité et fraîcheur.
Questions fréquemment posées
Un entrepôt de données n’est‑il qu’une grande base de données ?
Il s’agit d’une base de données ou d’une plateforme analytique conçue autour d’une analyse intégrée et historique. Sa modélisation, son ingestion, sa gouvernance et ses modèles de charge de travail diffèrent de ceux d’une base de données d’application transactionnelle.
Une entreprise doit‑elle utiliser l’ETL ou l’ELT ?
Beaucoup utilisent les deux. Transformez tôt lorsque la confidentialité, la validation ou la bande passante l’exigent; transformez après le chargement lorsque la puissance de calcul de l’entrepôt et l’itération rapide sont avantageuses.
Références principales











