
Fondamentaux de l’IA
Qu’est‑ce que l’ETL ? Extraction, Transformation, Chargement expliqué

 Ajouter Unite.AI à vos sources préférées sur Google
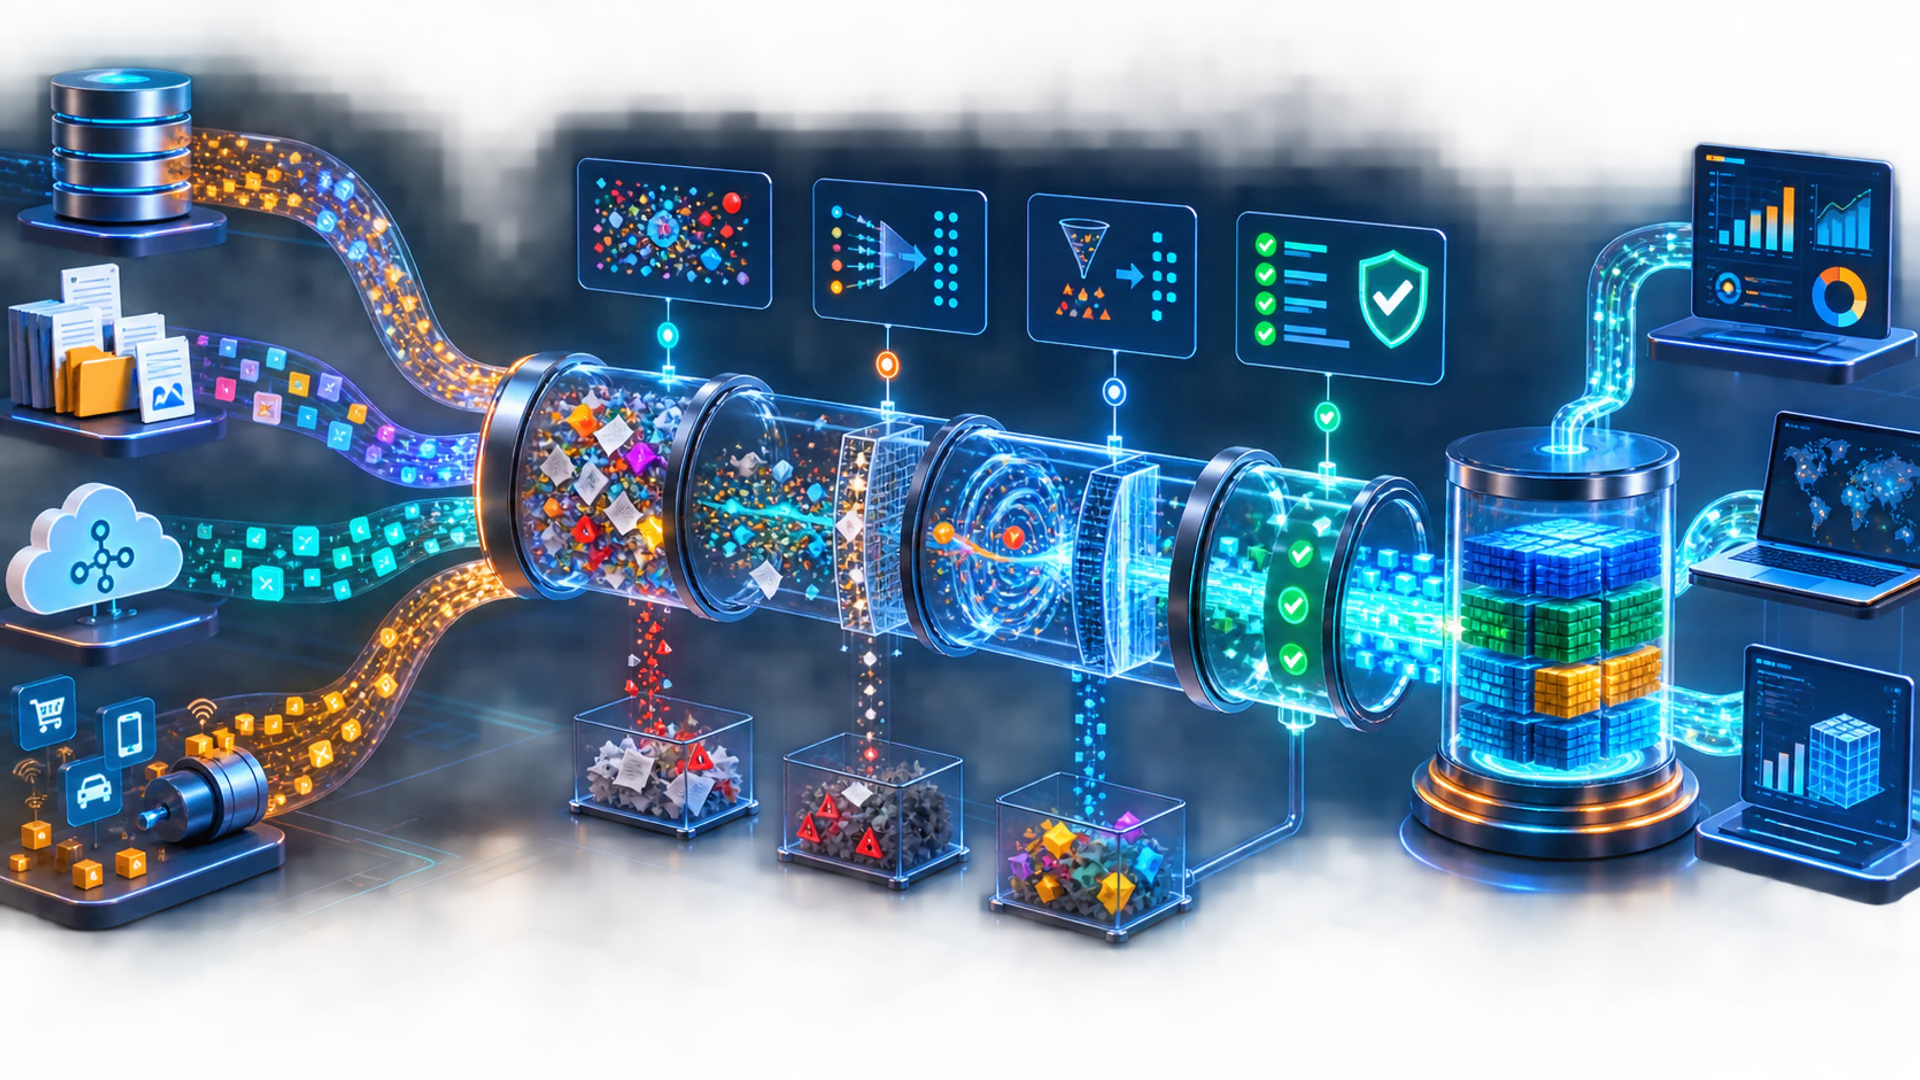
ETL—extraction, transformation, chargement—est un modèle d’intégration de données qui lit les données depuis les systèmes sources, les valide et les re‑forme, puis les écrit dans une destination adaptée à l’analyse, aux rapports, à l’apprentissage automatique ou aux opérations.
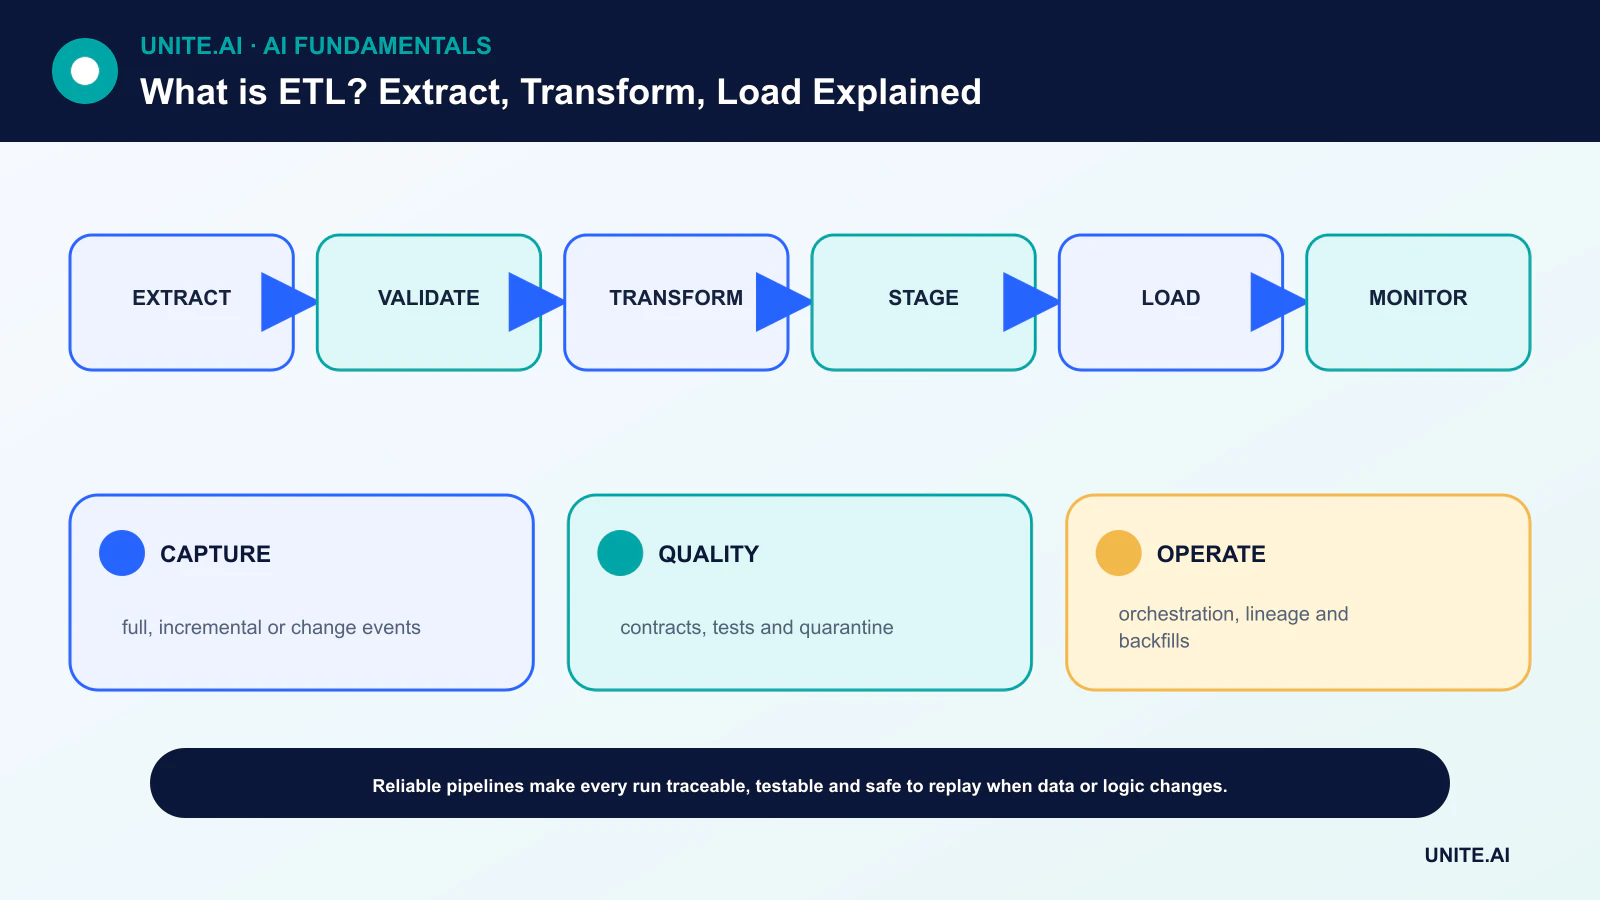
Un pipeline ETL en production ne se résume pas à trois blocs. Il nécessite une exécution répétable, des contrôles de schéma et de qualité, la traçabilité, l’orchestration, l’observabilité, la sécurité ainsi qu’une méthode sûre pour reconstituer ou rejouer les données lorsque la logique évolue.
Points clés
- L’extraction doit minimiser l’impact sur la source et enregistrer l’intervalle ou le jeu de changements capturés.
- Les transformations codifient la signification métier, elles nécessitent donc un contrôle de version, des tests et une responsabilité.
- Les chargements doivent être idempotents ou, à défaut, protéger contre les doublons et les échecs partiels.
- ETL vs ELT porte principalement sur le lieu d’exécution de la transformation ; les systèmes modernes utilisent souvent les deux.
Extraire les données de manière fiable
Les sources peuvent inclure des bases de données, des fichiers, des API, des flux d’événements et des applications. Une extraction complète copie l’ensemble des données ; une extraction incrémentielle lit les enregistrements modifiés depuis un point de contrôle. La capture de changements (CDC) consomme les journaux ou les événements de la base de données afin de réduire les analyses répétées.
Enregistrez les identifiants de source, les limites temporelles et les points de contrôle. Respectez les limites de débit et les sémantiques transactionnelles. Si une source modifie son schéma de manière silencieuse, échouez de façon sécurisée ou mettez les enregistrements en quarantaine plutôt que de charger des données ambiguës comme si de rien n’était.
Transformer avec des contrats explicites
Les transformations normalisent les types et les unités, analysent les enregistrements, joignent les sources, suppriment ou signalent les doublons, appliquent les règles métier et calculent les attributs. Séparez les données invalides des données manquantes mais acceptables, et conservez suffisamment de preuves pour remonter une sortie à ses entrées.
Versionnez les transformations avec la même rigueur que la livraison logicielle. Les tests doivent couvrir le schéma, les plages, l’intégrité référentielle, les distributions attendues et les exemples connus. Un contrat de données définit les attentes entre le producteur et le consommateur.
Charger de façon sûre et répétable
Un chargement peut ajouter des événements, fusionner des enregistrements modifiés, remplacer une partition ou reconstruire une table. L’idempotence signifie que réexécuter la même entrée produit le même état de destination. Les transactions, les tables de staging et les échanges atomiques limitent l’exposition aux mises à jour partielles.
Le partitionnement et l’indexation doivent correspondre aux modèles de consommation. Protégez les champs sensibles et appliquez les autorisations de destination avant que les données ne deviennent interrogeables. Les exigences de conservation et de suppression doivent accompagner les données.
ETL, ELT, traitement par lots et flux
L’ETL traditionnel transforme les données dans un moteur séparé avant le chargement. L’ELT charge d’abord les données brutes ou légèrement traitées, puis utilise la puissance de calcul de la destination pour la transformation. Un entrepôt ou lakehouse cloud peut rendre l’ELT pratique, mais cela n’élimine pas les travaux de qualité ou de gouvernance.
Les pipelines par lots traitent des intervalles bornés ; les pipelines de flux traitent des événements continus avec des sémantiques de temps et d’ordre définies. De nombreuses architectures utilisent l’ingestion en flux suivie d’une réconciliation périodique, car les données tardives ou corrigées sont courantes.
Orchestration, traçabilité et observabilité
Un orchestrateur planifie les tâches, respecte les dépendances, relance les échecs définis et enregistre l’état. Les relances nécessitent des limites et des tâches idempotentes. Les reconstitutions doivent être isolées et conscientes de la capacité afin que les réparations historiques n’interfèrent pas avec les données actuelles.
Surveillez la fraîcheur, le volume, le schéma, la qualité, la durée et le coût. La traçabilité et la couche de métadonnées d’un data fabric aident les consommateurs à comprendre quelle version a produit un jeu de données et ce qui a échoué en amont.
Extraction : sources, contrats et capture incrémentielle
L’ETL déplace les données depuis les systèmes sources, les transforme en structures gouvernées et les charge vers une destination. L’extraction peut s’appuyer sur des fichiers, des requêtes de base de données, des API, des journaux, des flux ou la capture de changements. Définissez la propriété de la source, le schéma, les clés, les horodatages, le fuseau horaire, les unités, la sémantique de suppression et le chargement autorisé. Les extractions complètes sont simples mais coûteuses ; la capture incrémentielle réduit le volume mais nécessite des repères, des positions de journal ou des champs de version ainsi qu’une stratégie pour les enregistrements tardifs ou corrigés.
Ne supposez pas qu’un succès d’API équivaut à une extraction complète. Enregistrez les décomptes, les sommes de contrôle, les lacunes de séquence, la pagination, les limites de débit, les nouvelles tentatives et les instantanés de source. Conservez les données brutes immuables là où la politique le permet afin que les transformations puissent être rejouées. Protégez les identifiants et les champs sensibles, et rendez les nouvelles tentatives idempotentes. Les changements de schéma doivent être classés comme compatibles ou rupturs via les contrats, plutôt que découverts lorsqu’un tableau de bord en aval change silencieusement.
Transformer et charger avec des sémantiques reproductibles
Les transformations analysent les types, standardisent les unités, dédoublonnent, joignent, appliquent les règles métier, gèrent l’historique et dérivent des faits et des dimensions. Chaque règle nécessite des tests et une traçabilité. Appliquez le prétraitement statistique uniquement sur des données d’entraînement appropriées lorsque l’ETL alimente le ML. Les dimensions à évolution lente déterminent si les changements d’attributs écrasent ou conservent l’historique. Déclarez le grain du fait avant la jointure ; les erreurs de type plusieurs‑à‑plusieurs créent des mesures dupliquées qui peuvent survivre aux vérifications de lignes de base.
Le chargement peut ajouter, fusionner, remplacer des partitions ou mettre à jour des enregistrements. Utilisez des tables de staging et des échanges atomiques lorsque possible afin que les lecteurs ne voient pas d’état partiel. Impliquez l’unicité, les relations, les valeurs acceptées, la complétude et les invariants métier. Gérez les événements tardifs et les reconstitutions avec le temps d’événement et le code versionné. La réconciliation avec les totaux sources est essentielle pour les données financières et opérationnelles. L’ELT charge les données brutes avant la transformation dans la destination ; les exigences de gouvernance et de correction demeurent.
Opérations et récupération
L’orchestration gère les dépendances, la planification, les nouvelles tentatives, la concurrence et les alertes. Surveillez la fraîcheur, le volume, la qualité, la durée, le coût et l’impact en aval. Un job échoué doit pouvoir reprendre ou être rejoué sans duplication. Versionnez le code et les schémas, conservez la traçabilité et testez les reconstitutions en isolement. La reprise après sinistre comprend les données brutes, les catalogues, les autorisations, l’état d’orchestration et les définitions sémantiques. L’ETL est fiable lorsqu’un utilisateur peut remonter une métrique à ses sources et la reproduire après modification — pas seulement lorsqu’un pipeline vert s’est terminé avec succès.
Exemple pratique : un pipeline de commandes incrémentiel
Un job ETL lit les journaux de changements de la base de données pour les commandes et les articles, stocke des événements immuables, valide la séquence et le schéma, puis les fusionne dans une table de faits d’entrepôt à un grain de ligne de commande. Le temps d’événement et la version de mise à jour gèrent les corrections tardives ; des clés déterministes rendent le rejouement idempotent. Les dimensions conservent l’historique sélectionné des clients et des produits via des clés de substitution. Les décomptes de lignes, les totaux de commandes, les taxes, les retours et les annulations sont réconciliés avec les périodes sources.
Une modification de champ source rupturante interrompt la promotion vers les tables de confiance et alerte les propriétaires grâce à la traçabilité en aval. Les reconstitutions s’exécutent avec du code versionné en isolement et sont comparées avant un échange atomique. La politique d’accès restreint les identifiants clients, et la suppression se propage aux copies dérivées autorisées. La surveillance couvre la fraîcheur, le volume, la qualité, le coût et l’impact sur les tableaux de bord. Les tests de récupération reconstruisent une période à partir des événements bruts et restaurent l’état d’orchestration. Un planificateur vert est insuffisant à moins que les chiffres métier restent reproductibles et réconciliés.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’optimisation. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendance, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité des tâches conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype séduisant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de repli sécurisée et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés, sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Questions fréquemment posées
L’ETL est-il obsolète sur les plateformes de données cloud ?
Non. Certaines plateformes privilégient l’ELT, mais les responsabilités d’extraction, de transformation et de chargement existent toujours. Les équipes combinent souvent les deux modèles.
Qu’est‑ce qui rend un pipeline ETL idempotent ?
Il peut traiter en toute sécurité la même entrée à nouveau sans créer d’état de destination dupliqué ou incohérent, généralement grâce à des clés stables, des points de contrôle et des écritures transactionnelles.
Références principales












