
Fondamentaux de l’IA
Qu’est‑ce que la science des données ?

 Ajouter Unite.AI à vos sources préférées sur Google
Data science est la pratique qui consiste à transformer les données en connaissances, prédictions ou décisions défendables. Elle combine expertise métier, statistiques, informatique, ingénierie des données, visualisation et communication. Un modèle peut faire partie du travail, mais la discipline débute avant la modélisation et se poursuit après le déploiement.
La question la plus importante n’est pas « Quel algorithme devons‑nous utiliser ? » mais « Quelle décision soutenons‑nous, quelles preuves y répondraient, et comment saurons‑nous que le résultat reste utile ? »
Points clés
- La data science est un flux de travail de bout en bout basé sur les preuves, et non un synonyme du machine learning.
- La définition du problème, la mesure et la gouvernance des données déterminent souvent le succès davantage que la complexité du modèle.
- Les questions prédictives et causales nécessitent des hypothèses et des conceptions d’évaluation différentes.
- Une analyse déployée nécessite une surveillance, une documentation et une communication adaptées à ses utilisateurs.
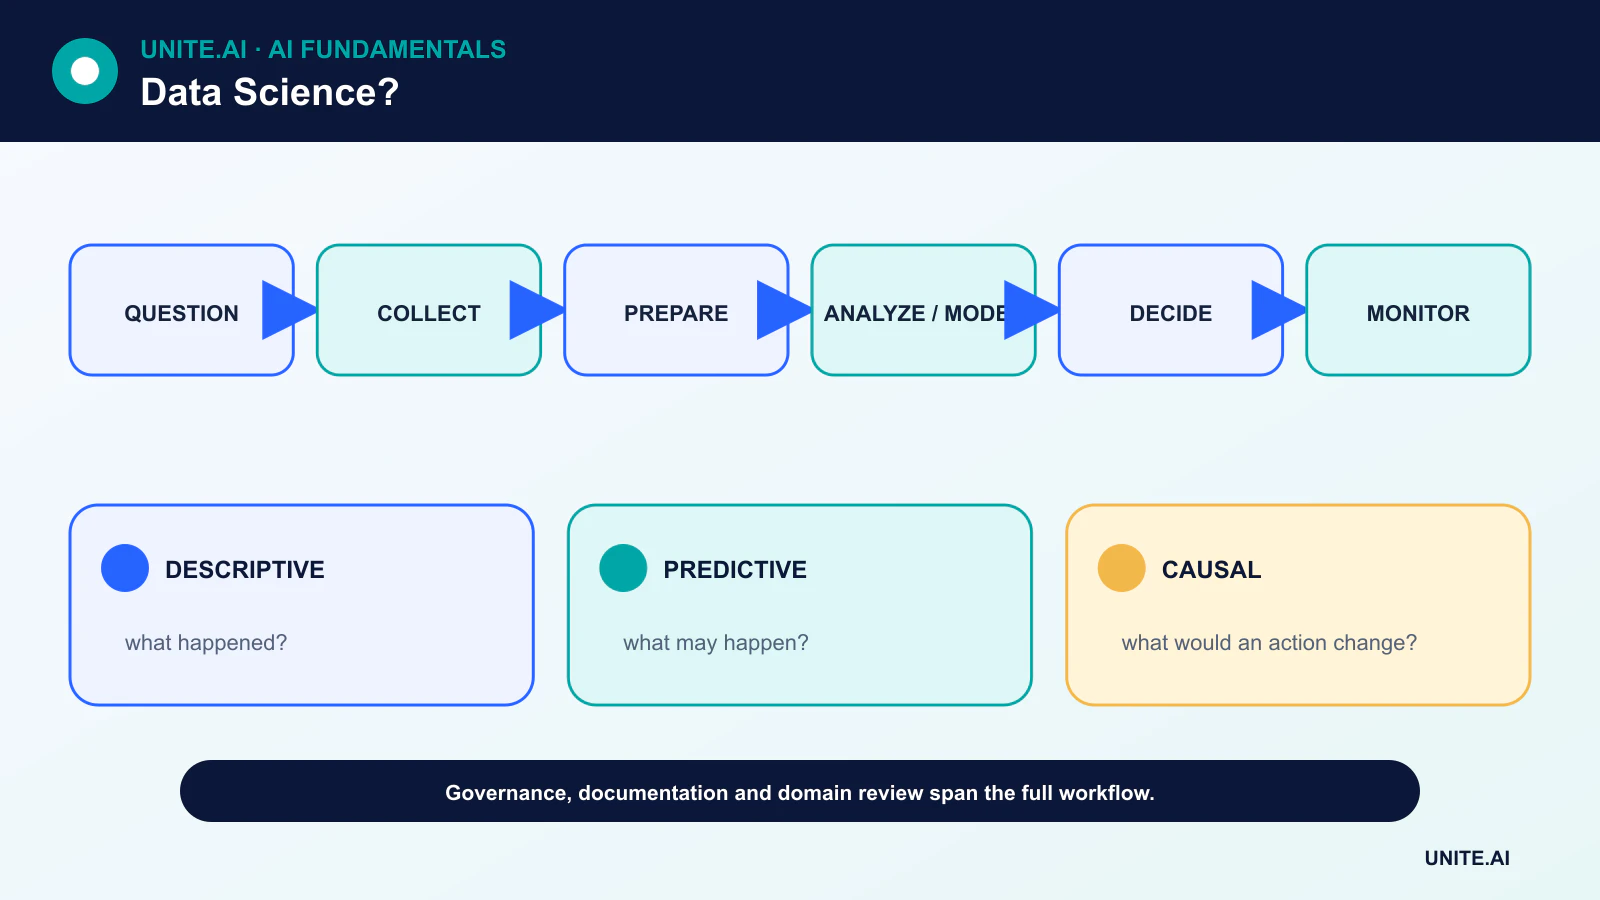
Commencer par une décision et un estimand
Un projet doit identifier l’utilisateur, la décision, l’intervention et le coût d’erreur. Pour une question descriptive, la cible peut être un taux ou une tendance. Pour une prédiction, il peut s’agir de la demande future ou du risque. Pour une question causale, l’estimand décrit l’effet d’une intervention définie sous les hypothèses énoncées.
Des objectifs vagues tels que « trouver des insights » rendent l’évaluation impossible. Un objectif mesurable crée une limite pour la collecte de données et empêche l’analyse de s’étendre à tous les champs disponibles.
Collecter, gouverner et comprendre les données
Les équipes répertorient les sources, la propriété, le consentement, la conservation, la traçabilité et l’accès. Elles distinguent les données structurées et non structurées, définissent les unités et les horodatages, et vérifient si les enregistrements représentent la population et la période d’intérêt.
Le nettoyage ne consiste pas seulement à supprimer les lignes manquantes. Il comprend la résolution des doublons, des valeurs impossibles, des ambiguïtés d’étiquettes, des dérives de schéma, du censurage et des jointures qui modifient l’unité d’analyse. Chaque transformation doit être reproductible et documentée.
Explorer avant de modéliser
L’analyse exploratoire étudie les distributions, les valeurs manquantes, les relations et les éventuels artefacts de mesure. La visualisation peut révéler des valeurs aberrantes et des différences de sous‑groupes qu’une moyenne résumée masque. L’exploration doit alimenter les hypothèses sans être confondue avec des preuves confirmatoires.
L’ingénierie des caractéristiques, la réduction de dimensionnalité et l’apprentissage de représentation peuvent améliorer la modélisation, mais les transformations doivent être ajustées uniquement sur les données d’entraînement afin d’éviter les fuites.
Choisir les méthodes en fonction de la question
L’estimation statistique quantifie l’incertitude autour des quantités d’intérêt. Le machine learning est utile lorsque l’objectif principal est la performance prédictive sur de nouvelles données. Les expériences et les méthodes d’inférence causale sont nécessaires lorsque le but est d’évaluer l’effet d’une intervention.
Une référence de base doit être suffisamment simple à comprendre. Les modèles plus complexes doivent justifier leur coût supplémentaire par une meilleure performance hors‑échantillon, une incertitude calibrée, une valeur opérationnelle ou une capacité nécessaire telle que le traitement d’images ou de langage.
Évaluer, communiquer et surveiller
L’évaluation doit correspondre à la décision. Un classificateur peut nécessiter précision, rappel, calibration et analyse de sous‑groupes plutôt que la simple exactitude ; un système de prévision a besoin d’un back‑testing sensible au temps. Le surapprentissage et les fuites sont des défaillances de processus, pas seulement des propriétés du modèle.
La communication comprend les hypothèses, l’incertitude, les limites et les actions recommandées. Une fois qu’un modèle ou un tableau de bord est utilisé, les équipes surveillent la qualité des entrées, la dérive des résultats, le comportement des utilisateurs et l’impact en aval. Un processus décisionnel retiré nécessite une archive et une responsabilité claire tout comme un processus déployé nécessite un opérateur.
Le cycle de vie de la data science et les questions analytiques
La data science combine connaissance métier, statistiques, informatique et communication pour transformer les données en preuves à l’appui de décisions. Commencez par distinguer description, diagnostic, prédiction et inférence causale. Un tableau de bord qui rend compte de ce qui s’est passé, un modèle qui prédit qui va churner, et une expérience qui estime si une intervention modifie le churn répondent à des questions différentes. Définissez l’unité, la population, la fenêtre temporelle, le résultat, l’action et le coût des erreurs avant d’extraire les données. De nombreux projets échoués résolvent un proxy mesurable qui ne peut pas soutenir la décision prévue.
L’acquisition nécessite la provenance, les autorisations, la conception d’échantillonnage et un contrat de données. L’exploration vérifie les distributions, les valeurs manquantes, les doublons, les valeurs aberrantes, les relations, les changements de mesure et les fuites potentielles. Les choix de nettoyage sont des hypothèses analytiques : supprimer les lignes manquantes, imputer des valeurs ou plafonner les valeurs aberrantes peuvent modifier la population et la conclusion. Versionnez les données brutes de façon immuable ainsi que les transformations sous forme de code, et créez un dictionnaire de données avec unités et signification. Séparez les données d’évaluation avant d’apprendre les transformations ou de tester de façon répétée des hypothèses.
Modélisation, inférence et reproductibilité
L’inférence statistique quantifie l’incertitude sous des hypothèses ; la modélisation prédictive estime la performance hors‑échantillon ; l’analyse causale nécessite une identification via le design ou des hypothèses défendables. Sélectionnez les méthodes qui correspondent à la question et au processus de génération des données. Comparez avec des références simples, utilisez une validation groupée ou sensible au temps, et rapportez l’incertitude et la sensibilité. Une forte corrélation ou importance d’une caractéristique n’établit pas la causalité. Les tests multiples, la liberté de recherche du chercheur et la sélection de résultats peuvent fabriquer des motifs convaincants, d’où l’utilité de la préinscription ou d’une phase de confirmation clairement séparée.
La reproductibilité comprend le code, l’environnement, l’instantané des données, les graines aléatoires, les définitions de requêtes et un registre des décisions manuelles. Les tests automatisés doivent couvrir les schémas, les invariants métier, les transformations et les métriques. Les notebooks sont utiles pour l’exploration, mais le travail en production nécessite des pipelines modulaires et révisables. L’évaluation par les pairs doit remettre en cause les hypothèses, les fuites, la validité de la cible et la généralisabilité des résultats. Communiquez les tailles d’effet, l’incertitude, les limites et les contre‑preuves plutôt que de vous limiter à la signification statistique ou à un score de modèle.
Déploiement et impact de la décision
Si l’analyse alimente un processus récurrent, attribuez des responsables, surveillez la fraîcheur des données et la qualité des résultats, et définissez les procédures de retour en arrière ou de retrait. Protégez les informations personnelles et confidentielles par la minimisation, le contrôle d’accès, la conservation et des sorties sécurisées. Évaluez les effets sur les sous‑groupes et la façon dont les utilisateurs réagissent au modèle ; les boucles de rétroaction peuvent modifier les données futures. Mesurez si la décision a amélioré le véritable objectif, et non simplement si un modèle a été déployé. La data science réussit lorsque les preuves modifient l’action de manière fiable et transparente — et non lorsqu’une organisation accumule tableaux de bord, fonctionnalités ou expériences sans responsabilité.
Exemple pratique : mesurer une intervention de rétention
Une équipe produit observe une baisse de rétention et définit un utilisateur actif, une cohorte, une fenêtre, des exclusions et une décision. Les analystes auditent l’instrumentation, les événements manquants et le mix d’acquisition avant la modélisation. Les cohortes descriptives identifient où la chute se produit, un modèle prédictif priorise les participants à la recherche, et une expérience aléatoire d’onboarding estime si le changement proposé améliore la rétention. Il s’agit de trois analyses distinctes avec des hypothèses et des sorties séparées.
Le notebook, les requêtes, l’instantané des données, la définition de la métrique et le plan d’expérience sont versionnés et revus par les pairs. Les résultats rapportent la taille d’effet et l’incertitude avec des garde‑fous pour la demande de support et l’accessibilité. Un tableau de bord surveille l’expérience mais ne remplace pas l’analyse pré‑déclarée. Si l’intervention réussit, le déploiement reste étagé et vérifie le comportement à long terme. Le travail n’est considéré précieux que s’il soutient une décision reproductible, et non parce qu’un modèle complexe ou un graphique visuellement attrayant a été produit.
Preuve de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une référence reproductible et un ensemble d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées mal formées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attractif.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les changements, le retour en arrière et le retrait. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
La data science est‑elle identique à l’analyse de données ?
Les termes se chevauchent. La data science inclut souvent la création de produits de données et de systèmes prédictifs, tandis que l’analytics peut se concentrer davantage sur le support décisionnel descriptif et diagnostique. L’usage organisationnel varie.
Chaque projet de data science nécessite‑t‑il une IA ?
Non. Une requête, un graphique, une expérience ou une estimation statistique bien conçus peuvent être plus utiles et plus fiables qu’un modèle complexe.
Références principales











