
Fondamentaux de l’IA
Qu’est‑ce qu’un tissu de données ?

 Ajouter Unite.AI à vos sources préférées sur Google
Un tissu de données est un modèle architectural permettant de découvrir, connecter, gouverner et livrer des données à travers des systèmes distribués. Il fournit une couche partagée de métadonnées et de contrôle afin que les personnes et les applications puissent trouver des données fiables sans contraindre chaque jeu de données à être stocké physiquement dans un même entrepôt.
Un tissu de données n’est pas un produit unique et il n’efface pas les différences entre systèmes sources. Sa valeur repose sur des métadonnées précises, une propriété claire, des politiques applicables, une intégration fiable et la preuve que les consommateurs reçoivent des données adaptées à leurs besoins.
Points clés
- Un plan de contrôle riche en métadonnées relie catalogues, traçabilité, qualité, politiques et accès.
- Les données peuvent rester distribuées et être copiées, diffusées, transformées ou virtualisées selon la charge de travail.
- Le tissu de données est orienté technologie ; le maillage de données met l’accent sur la propriété par domaine et les données en tant que produit.
- L’automatisation aide à faire évoluer la gouvernance, mais les propriétaires responsables définissent toujours la signification, la qualité et les usages autorisés.
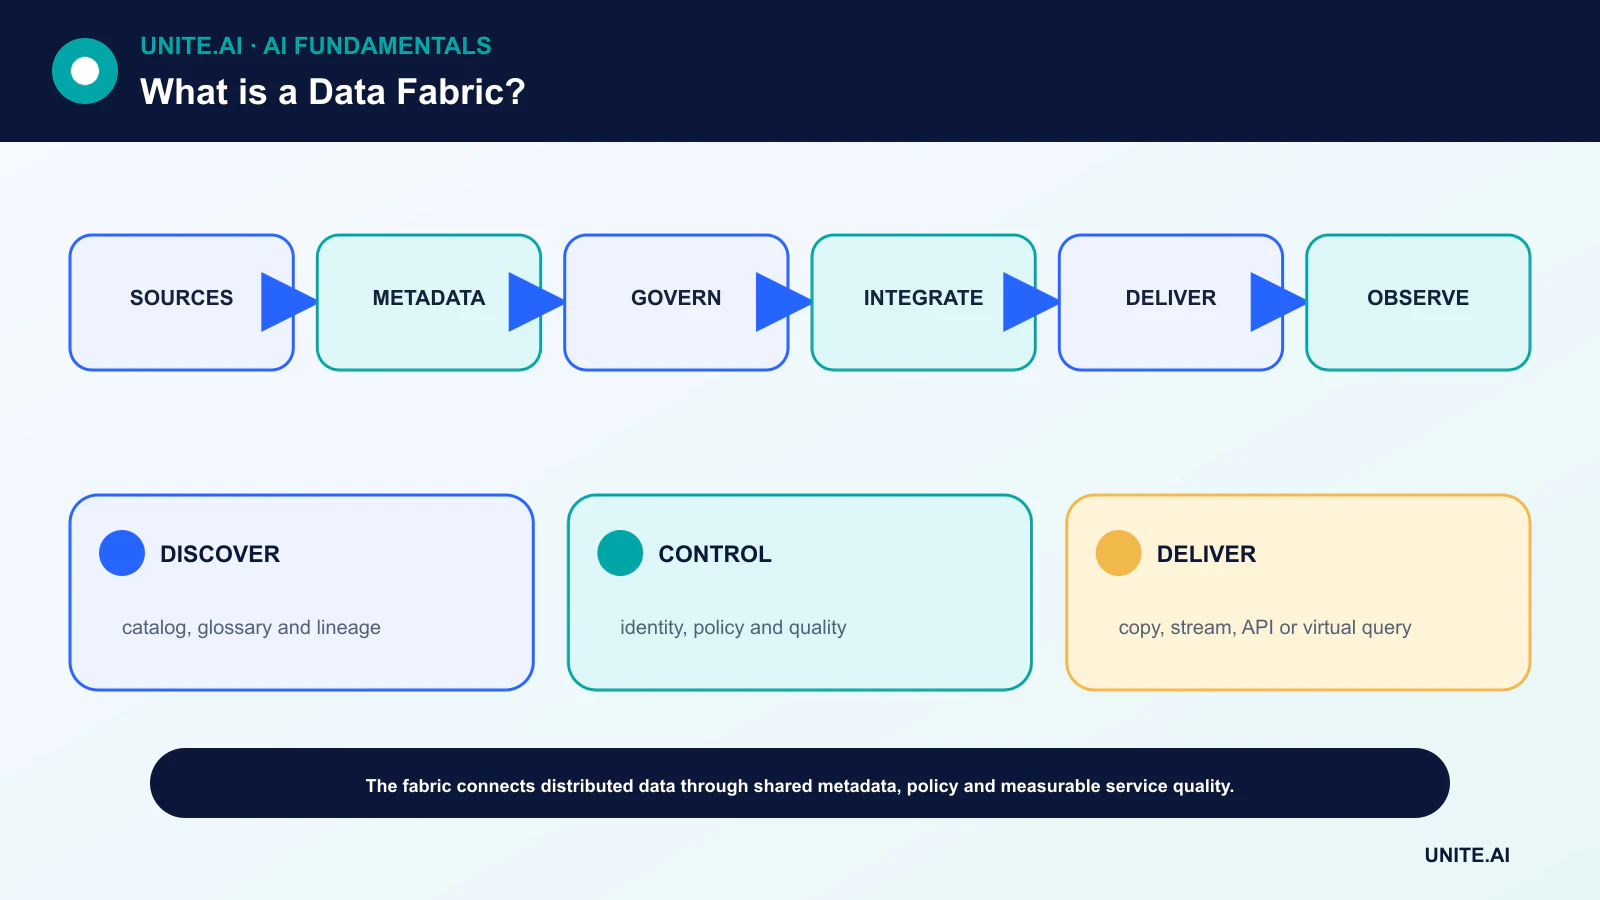
Le plan de contrôle et le plan de données
Le plan de données comprend les bases de données, les fichiers, les flux, les API et les pipelines qui les déplacent ou les interrogent. Le plan de contrôle enregistre les métadonnées techniques et métier : schémas, propriétaires, classifications, mesures de qualité, traçabilité, politiques et utilisations.
Un catalogue ou un graphe de connaissances peut relier ces informations afin qu’un consommateur découvre un jeu de données et comprenne son contexte. Le tissu utilise alors les métadonnées pour orienter l’accès, la transformation, l’observabilité et l’application des politiques sur des plateformes hétérogènes.
Intégration sans magasin obligatoire
Certaines charges de travail copient les données via l’ETL ; d’autres utilisent la capture de changements, les flux d’événements, les API ou la virtualisation des requêtes. Le modèle approprié dépend de la fraîcheur, des performances, de la cohérence, de la souveraineté, du coût et des limites du système source.
L’accès virtuel peut réduire la duplication mais exposer les consommateurs à la latence et à la disponibilité des sources. La matérialisation physique améliore les performances et la reproductibilité, mais engendre des responsabilités de synchronisation et de gestion du cycle de vie.
Gouvernance, sémantique et qualité
Un glossaire métier confère une signification partagée aux termes tels que client, commande ou compte actif. La traçabilité indique l’origine d’un champ et son évolution. La classification et les politiques déterminent qui peut accéder aux enregistrements sensibles et dans quel but.
Les règles de qualité doivent être associées à des cas d’usage spécifiques. Une exhaustivité suffisante pour un tableau de bord peut être inappropriée pour des décisions automatisées. Un tissu doit mettre en évidence la fraîcheur, l’historique de validation et les limites connues plutôt que de simplement qualifier un actif de certifié.
Tissu de données, maillage et lakehouse
Le maillage de données est une approche sociotechnique qui attribue aux équipes de domaine la responsabilité des produits de données interopérables. Un tissu de données met l’accent sur les services techniques partagés et l’automatisation des métadonnées. Les organisations peuvent les combiner : la propriété par domaine peut fonctionner via un tissu commun.
Un lakehouse combine la flexibilité d’un lac de données avec la gestion et les fonctionnalités de requête d’un entrepôt. Il peut constituer une plateforme participante, mais il ne représente pas l’ensemble du tissu inter‑systèmes. De même, un entrepôt ou un catalogue seul ne fournit pas toutes les fonctions d’intégration et de politique.
Mise en œuvre et évaluation
Commencez par un cas d’usage inter‑systèmes à forte valeur ajoutée et dressez l’inventaire des sources, propriétaires, politiques et attentes de niveau de service minimaux. Mettez en place l’identité, les normes de métadonnées, les contrats, les tests et l’observabilité avant d’ajouter des recommandations automatisées.
Mesurez le temps de découverte, le délai d’approbation d’accès, les taux d’incident, la fraîcheur des données, la réutilisation et la confiance des consommateurs. Reliez le tissu à la gouvernance des données structurées et non structurées ainsi qu’à la cybersécurité ; une connectivité sans contrôle peut accroître l’exposition.
Architecture du tissu de données et plan de métadonnées
Un tissu de données est une approche architecturale visant à connecter des données distribuées via des métadonnées partagées, la gouvernance, l’intégration et les services d’accès. Ce n’est pas une base de données ou un produit unique. Les sources peuvent rester dans des entrepôts, des lacs, des systèmes opérationnels, des flux et des plateformes SaaS tandis que les catalogues décrivent les jeux de données, la traçabilité suit les transformations, les politiques contrôlent l’accès et les définitions sémantiques rendent les concepts réutilisables. La virtualisation, la réplication, les API et les pipelines sont des méthodes de livraison complémentaires choisies selon la latence, l’échelle, les capacités des sources et les exigences de cohérence.
Les métadonnées actives capturent les schémas, la propriété, l’utilisation, la qualité, les classifications, la traçabilité, les modèles de requêtes et les événements opérationnels et peuvent alimenter l’automatisation. Un graphe de connaissances peut relier les concepts métier aux champs physiques et aux politiques. L’automatisation peut recommander des jointures, détecter des dérives, propager des classifications ou acheminer des incidents, mais les métadonnées inférées nécessitent confiance et gouvernance. Un catalogue qui n’est pas relié à la livraison et aux contrôles devient une dette documentaire ; l’intégration automatisée sans propriété sémantique engendre des incohérences plus rapides.
Intégration, gouvernance et produits de données
L’ETL par lots, la capture de changements, les flux, la fédération et le reverse ETL présentent des sémantiques différentes en termes de fraîcheur et d’échec. Définissez les sources autoritaires, les identifiants, les contrats, le temps des événements, les données tardives, les suppressions et les réconciliations. Les requêtes virtuelles évitent les copies mais dépendent des performances et de la disponibilité des sources ; la matérialisation améliore la vitesse mais crée des obligations de fraîcheur et de rétention. Les politiques sensibles doivent être appliquées ou réévaluées pour les données dérivées, les caches, les embeddings et les exportations.
Considérez les jeux de données à forte valeur comme des produits avec propriétaires, utilisateurs, documentation, attentes de service, tests et support. La propriété fédérée permet aux domaines de gérer la signification tandis que les normes partagées préservent l’interopérabilité. Les équipes centrales fournissent les capacités de plateforme et la gouvernance, sans posséder chaque champ. Mesurez le temps de découverte, la réutilisation, la qualité des données, le délai d’accès, la résolution d’incidents, l’adoption de métriques fiables et le coût. Le nombre d’entrées de catalogue ou de connecteurs n’est pas une preuve que les utilisateurs peuvent trouver et exploiter des données fiables.
Stratégie de mise en œuvre
Commencez par un parcours inter‑domaines dont les retards et les risques sont connus. Faites l’inventaire des sources et des contrats, établissez l’identité et la classification, reliez la traçabilité et la qualité, puis automatisez les contrôles récurrents. Évitez une tentative pluriannuelle de modéliser l’ensemble de l’entreprise avant de livrer de la valeur. Testez les pannes de source, les changements de schéma, la révocation d’accès, les événements tardifs et la reprise après sinistre. Un tissu de données réussit lorsque les données distribuées deviennent plus faciles à gouverner et à exploiter sans effacer les réalités opérationnelles et la responsabilité des systèmes d’origine.
Exemple pratique : un tissu de données client
Une entreprise relie les données de commerce, de support, de marketing et de produit tout en conservant les systèmes opérationnels comme sources autoritaires. Un catalogue partagé associe les définitions de client, compte, commande, consentement et interaction aux champs physiques. La capture de changements alimente les produits gouvernés, tandis que la virtualisation assure des recherches actuelles à faible volume et les tables matérialisées soutiennent l’analyse. L’identité, la traçabilité, la qualité et les politiques sont mises en place avant qu’une couche d’IA de personnalisation ne soit autorisée à exploiter les données.
Un retrait de consentement se propage à travers les tables d’entrepôt, les index de recherche, les embeddings et les systèmes d’activation, avec une preuve de réalisation. Les contrats de schéma et les tests de réconciliation détectent les changements de source. Les propriétaires publient les attentes de fraîcheur et de qualité, et les métadonnées d’utilisation aident à retirer les copies inutilisées. Le pilote mesure le délai d’accès, la réutilisation de métriques fiables, la résolution d’incidents et la conformité à la confidentialité. Le tissu est considéré comme un succès parce qu’un parcours inter‑domaines devient fiable et gouvernable — et non parce qu’un fournisseur a connecté le plus grand nombre de sources.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendance, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité des tâches conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype séduisant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les modifications, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés, sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de rétention, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Un tissu de données déplace‑t‑il toutes les données en un seul endroit ?
Non. Il peut coordonner des données qui restent distribuées et choisir le déplacement physique ou la virtualisation selon la charge de travail.
Un tissu de données est‑il identique à un maillage de données ?
Non. Le tissu décrit principalement une architecture habilitante et l’automatisation ; le maillage décrit principalement la propriété décentralisée par domaine et les responsabilités liées aux produits de données. Ils peuvent coexister.
Références principales











