Fondamentaux de l’IA
Qu’est‑ce que l’AIOps ? Intelligence artificielle pour les opérations informatiques

 Ajouter Unite.AI à vos sources préférées sur Google
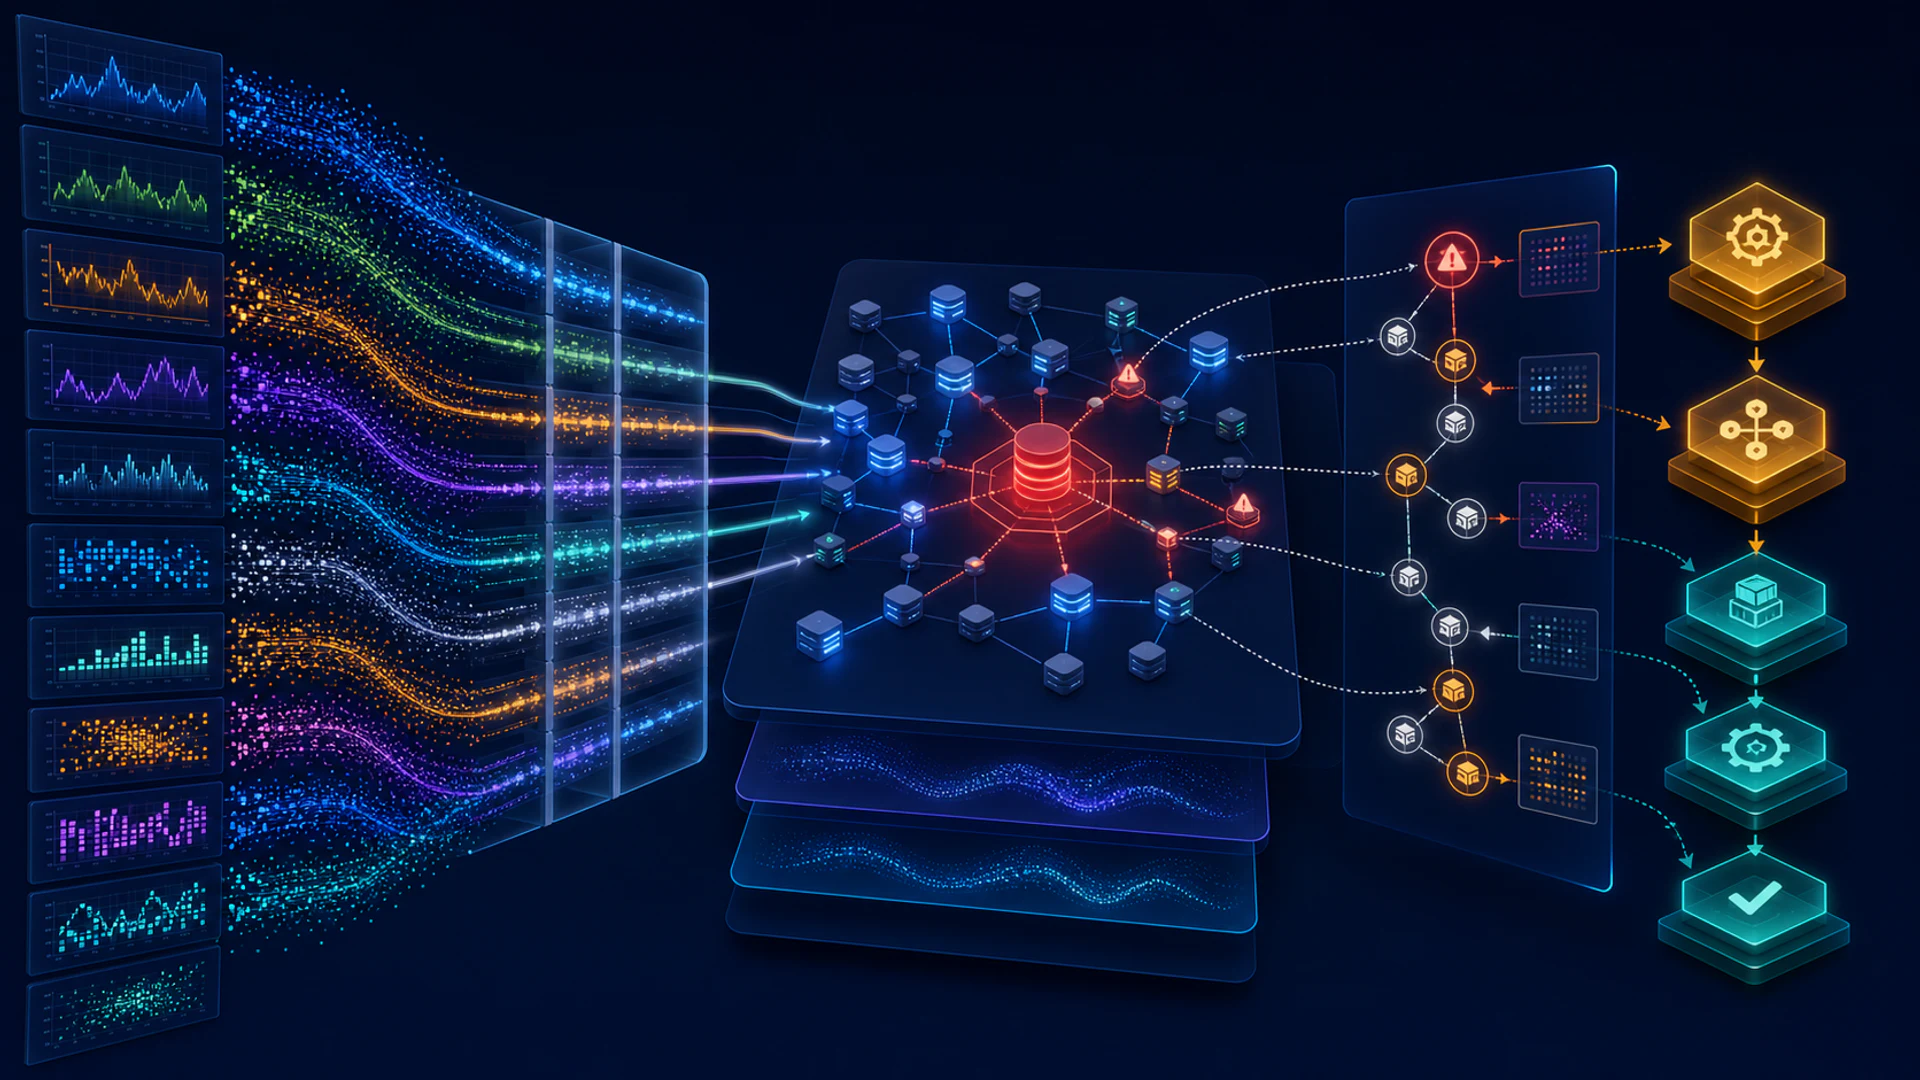
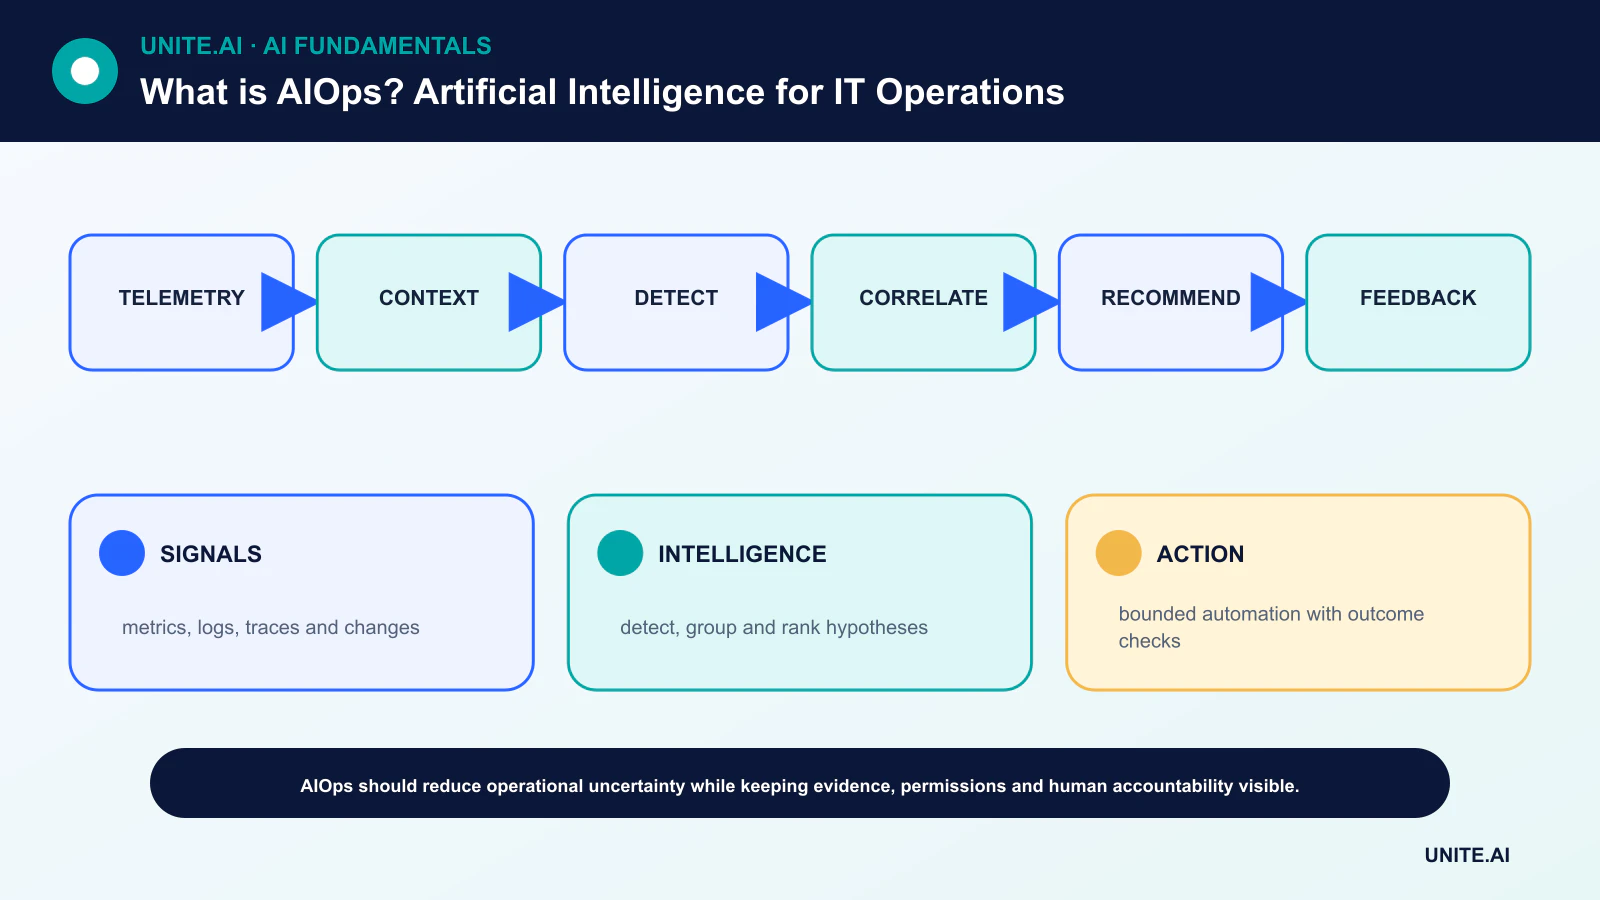
AIOps applique l’apprentissage automatique et l’automatisation aux données des opérations informatiques afin que les équipes puissent détecter des comportements inhabituels, réduire les alertes en double, connecter les événements liés, classer les causes probables et recommander ou exécuter des actions de réponse.
AIOps n’est pas un remplacement autonome des opérations. C’est une couche au sein d’un système ITOps, et sa valeur dépend de la qualité de la télémétrie, de la topologie des services, de l’historique des changements, des retours humains et des limites d’automatisation sécurisées.
Points clés
- Normalisez les événements et ajoutez le contexte du service avant d’appliquer des modèles sophistiqués.
- La détection d’anomalies identifie des écarts, pas nécessairement des pannes ou des causes profondes.
- La corrélation et le classement des causes probables doivent exposer les preuves et l’incertitude.
- La remédiation automatisée nécessite le principe du moindre privilège, des approbations, des canaris, un retour en arrière et une surveillance des résultats.
Construire une couche de données opérationnelles
Les plateformes AIOps ingèrent les métriques, les journaux, les traces, les alertes, les tickets, la topologie, les déploiements et les changements de configuration. Les horodatages, les identifiants et la propriété des services doivent être conciliés afin que le système puisse connecter les signaux se référant au même incident.
Un contexte manquant ou incohérent engendre des corrélations erronées. La conservation des données, l’accès et la confidentialité sont également importants, car les journaux peuvent contenir des identifiants ou des informations personnelles. Appliquez la même gouvernance que celle attendue pour les autres systèmes de données de production.
Détection et réduction du bruit
Les seuils statiques fonctionnent pour des limites connues ; les méthodes statistiques et d’apprentissage automatique peuvent modéliser la saisonnalité ou les motifs multivariés. La déduplication regroupe les notifications répétées, tandis que la suppression élimine les alertes non exploitables selon des règles définies.
Une anomalie n’est qu’une déviation par rapport au comportement attendu. Les versions planifiées, les campagnes de trafic et les cycles économiques peuvent être inhabituels mais sains. Évaluez la précision, le rappel, le délai de détection et la charge de travail des opérateurs plutôt que de célébrer le nombre d’alertes supprimées.
Corrélation et cause probable
La corrélation d’événements relie les symptômes à travers un graphe de dépendances et une fenêtre temporelle. Un modèle de cause probable peut classer les composants ou les changements récents susceptibles d’expliquer l’incident. Cela priorise l’enquête ; cela n’établit pas la causalité.
Présentez les preuves contributives, les hypothèses alternatives et le niveau de confiance. L’IA explicable est particulièrement importante lorsqu’un opérateur doit décider d’isoler un service ou de revenir à une version précédente d’un déploiement.
De la recommandation à l’automatisation
Un runbook peut collecter des diagnostics, redémarrer un worker sans état ou augmenter la capacité. Les copilotes peuvent résumer les incidents et récupérer les procédures. Les agents peuvent planifier des appels d’outils, mais les autorisations de production doivent être limitées et les actions validées par rapport à l’état actuel.
Commencez par des recommandations en lecture seule. Faites évoluer les actions matures grâce à la simulation, à l’approbation humaine, aux canaris et au retour en arrière automatique. Enregistrez les entrées, la version du modèle, l’autorisation et le résultat de chaque action.
Évaluation et retour opérationnel
Rejouez les incidents historiques sans faire fuiter leurs étiquettes finales dans les caractéristiques. Testez sur de nouveaux services et changements, mesurez la suppression erronée, le temps de détection, le temps d’atténuation, l’acceptation par les opérateurs et la récurrence. Comparez avec les règles existantes et des références simples.
Le dérive survient lorsque l’architecture, le trafic ou les pratiques de réponse changent. Bouclez le processus en permettant aux opérateurs de corriger les corrélations et les résultats, puis examinez si le système réduit la charge de travail sans masquer les risques ou créer une complaisance d’automatisation.
Pipeline de données et analytique AIOps
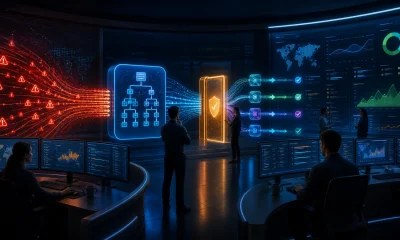
AIOps applique des méthodes statistiques et d’apprentissage automatique aux données d’opérations telles que les métriques, les journaux, les traces, les événements, la topologie, les tickets et les changements. Le pipeline collecte et normalise les signaux, les enrichit avec le contexte de service et de propriété, détecte les anomalies, corrèle les événements liés, estime les causes probables et recommande ou déclenche une action. La qualité dépend des horodatages, des identifiants, de la topologie et des enregistrements de changements. Un modèle sophistiqué ne peut pas corréler de façon fiable les alertes se référant au même service sous des noms incohérents.
La détection d’anomalies apprend les bases de référence par service, saison et état de fonctionnement ; les seuils statiques peuvent être plus adaptés pour des limites de sécurité connues. La corrélation d’événements regroupe les symptômes en un incident en utilisant le temps, la topologie, le texte et les modèles historiques. Le classement des causes racines propose des hypothèses mais peut confondre la première défaillance observée avec la vraie cause ou manquer une dépendance partagée absente de la topologie. Les résumés en langage naturel peuvent aider les intervenants, mais ils doivent renvoyer aux preuves brutes et indiquer l’incertitude.
Automatisation, évaluation et retour
Commencez par le soutien à la décision et une remédiation réversible à faible risque. Chaque action automatisée nécessite une autorisation, des préconditions, un périmètre limité, un délai d’expiration, une vérification post‑condition, un retour en arrière et une traçabilité. Le modèle ne doit pas s’octroyer des identifiants ni traiter le texte des journaux comme des instructions fiables. Les intervenants humains doivent accepter, rejeter ou corriger les recommandations, et ces résultats doivent mettre à jour les règles ou les données d’entraînement via une révision plutôt que par un auto‑apprentissage incontrôlé.
Évaluez la réduction des alertes sans manquer d’incidents, le délai de détection, la précision de la corrélation, le classement des causes racines, le succès de la remédiation, le temps de récupération, la récurrence et la charge de travail des intervenants. Utilisez la relecture historique et les fautes injectées, mais tenez compte des étiquettes d’incident incomplètes. Mesurez par service et type d’incident ; une moyenne peut masquer des défaillances dangereuses dans des systèmes critiques rares. Comparez avec des règles déterministes et une observabilité améliorée avant d’ajouter la complexité de l’IA.
Gouvernance et modes de défaillance
AIOps peut amplifier les lacunes de télémétrie, automatiser un mauvais diagnostic ou créer des actions corrélées à l’échelle du parc. Isolez les environnements, limitez la concurrence, maintenez un interrupteur d’arrêt en dehors du modèle et entraînez la défaillance de la plateforme AIOps elle‑même. Protégez les journaux et les tickets contenant des secrets ou des données personnelles. Surveillez la dérive du modèle, la fraîcheur de la topologie, les actions erronées et les contournements. AIOps soutient des opérations fiables lorsqu’il rend les preuves et les actions limitées plus rapides ; il ne remplace pas de façon autonome la responsabilité du service, le commandement d’incident ou le jugement d’ingénierie.
Exemple pratique : AIOps pour un incident de paiement
AIOps regroupe une vague d’erreurs d’API, de saturation de base de données et d’alertes régionales en un seul incident et l’enrichit avec un déploiement récent, la topologie et le propriétaire. Il classe le déploiement comme un contributeur probable tout en exposant la télémétrie brute et les alternatives. Une politique déterministe suspend le déploiement supplémentaire ; un commandant d’incident humain approuve le basculement du trafic après avoir vérifié que la capacité et la cohérence des données sont sûres.
Le système mesure la précision du regroupement, le délai de détection, la justesse du classement, l’acceptation par les intervenants, la récupération et les remédiations erronées lors de la relecture historique et des journées d’exercice. Toutes les actions automatisées sont limitées, idempotentes, soumises à des vérifications post‑condition et à un retour en arrière. Les journaux sont nettoyés et le texte malveillant ne peut pas devenir une commande. Après l’incident, la cause confirmée et les résultats des actions mettent à jour les règles révisées et les données d’évaluation. La plateforme AIOps aide à fournir des preuves et à coordonner ; elle ne remplace jamais le commandement d’incident ou l’autorisation externe.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement opérationnel, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un ensemble d’évaluations versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendance, les abus, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité des tâches conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et chaque seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour les versions, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes intentionnellement injectées. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage d’incident, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
L’AIOps est‑il identique à l’observabilité ?
Non. L’observabilité fournit et explore les signaux du système ; l’AIOps utilise l’analyse et l’automatisation sur ces signaux. Chacun peut exister sans l’autre.
L’AIOps peut‑il déterminer automatiquement la cause racine ?
Il peut classer les hypothèses et collecter des preuves, mais les affirmations de causalité nécessitent la topologie, le contexte des changements et une validation. De nombreux incidents ont des causes interactives.
Références principales