
Fondamentaux de l’IA
Qu’est‑ce que la gestion de la performance des actifs (APM) ?

 Ajouter Unite.AI à vos sources préférées sur Google
La gestion de la performance des actifs (APM) combine la stratégie d’actifs, la maintenance, la surveillance de l’état, l’analyse de fiabilité et les données opérationnelles afin d’améliorer la valeur fournie par les actifs physiques. Elle est couramment utilisée pour des équipements tels que les turbines, les pompes, les véhicules, les lignes de production et les infrastructures.
L’APM n’est pas un tableau de bord de capteurs ni un modèle de maintenance prédictive en soi. C’est un processus décisionnel qui équilibre performance, coût, risque, sécurité et durabilité tout au long du cycle de vie de l’actif, avec une responsabilité clairement définie pour les inspections, les travaux, les pièces de rechange et la planification du capital.
Points clés
- Commencez par la criticité et les conséquences des défaillances, pas par le capteur le plus facile à collecter.
- Combinez les données d’état avec l’historique de maintenance, le contexte opérationnel et les connaissances d’ingénierie.
- Utilisez les signaux prédictifs pour soutenir une décision de travail définie et une exigence de délai.
- Mesurez le risque évité, la disponibilité, la qualité de la maintenance, le coût du cycle de vie et les fausses alarmes.
De la stratégie d’actifs au travail
Les organisations définissent des objectifs, des hiérarchies d’actifs, la criticité, les normes de performance, les modes de défaillance et les stratégies de maintenance. Un système de gestion du travail planifie les inspections et les réparations ; les analyses APM aident à prioriser quand et pourquoi les travaux doivent être effectués.
La même condition peut impliquer une action différente pour une pompe redondante à faible coût et une turbine critique pour la sécurité. L’APM relie les preuves techniques au contexte commercial et de sécurité plutôt que d’optimiser un seul score de prédiction.
Données et représentations numériques
Les sources utiles comprennent les séries temporelles des capteurs, les alarmes, les rondes d’opérateur, les notes de maintenance, les pièces, l’environnement, les charges et les limites de conception. Les identifiants d’actifs et les horodatages doivent être alignés avant l’analyse. Des capteurs manquants, dérivés ou remplacés peuvent engendrer de fausses tendances.
Un jumeau numérique peut combiner des modèles d’ingénierie et l’état en temps réel, mais il nécessite des hypothèses validées et des règles de mise à jour. Les notes non structurées du technicien peuvent apporter un contexte que la télémétrie ne possède pas.
Condition, prédiction et décision
Les seuils détectent les limites connues ; les modèles d’anomalie signalent les écarts ; les modèles de diagnostic estiment les causes ; les modèles de pronostic estiment la durée de vie résiduelle utile. Chacun nécessite un horizon temporel et une incertitude adaptés à la décision de maintenance.
Un modèle qui prédit une défaillance cinq minutes avant qu’elle ne survienne peut être précis mais opérationnellement inutile si les pièces nécessitent une semaine. L’apprentissage automatique doit être comparé aux règles et aux méthodes de fiabilité et testé sur différents régimes de fonctionnement.
Mise en œuvre et mesure
Commencez par une classe d’actifs critique, un mode de défaillance crédible, un délai disponible et un propriétaire capable d’agir. Intégrez les recommandations dans la planification, les ordres de travail et les stocks ; recueillez le résultat afin que la règle ou le modèle puisse être revu.
Suivez la disponibilité, les arrêts non planifiés, le coût de la maintenance, le respect du planning, les fausses alarmes, les événements manqués, l’exposition à la sécurité et la valeur du cycle de vie. Évitez d’affirmer des défaillances évitées sans méthode contrefactuelle et hypothèses documentées.
Hiérarchie des actifs, comportement de défaillance et criticité
Un programme APM débute par une hiérarchie d’actifs qui relie sites, systèmes, équipements, assemblages et composants maintenables. Chaque niveau nécessite des identifiants, une propriété, une localisation, des spécifications et des relations cohérents. Sans cette base, les flux de capteurs, les ordres de travail, les constats d’inspection et les enregistrements de coûts ne peuvent pas décrire de manière fiable le même actif physique.
Les modes de défaillance expliquent comment un actif peut cesser de remplir sa fonction requise, pourquoi la défaillance se produit, quelles preuves apparaissent en premier et quelles conséquences en découlent. L’analyse des modes de défaillance et de leurs effets, la maintenance centrée sur la fiabilité et l’analyse des causes profondes transforment la maintenance d’une activité calendaire en une discipline informée par le risque. L’analyse doit distinguer les symptômes des mécanismes causaux.
La criticité combine la probabilité avec les conséquences pour la sécurité, l’environnement, la production, la qualité, la conformité et le coût. Une pompe redondante desservant une boucle non essentielle ne doit pas recevoir le même budget de surveillance qu’un compresseur à point de défaillance unique. La criticité évolue avec le contexte opérationnel, de sorte que les équipes doivent revoir les classements après des changements de processus, d’actif ou de demande.
Surveillance de l’état, prédiction et décisions de maintenance
La surveillance de l’état peut utiliser la vibration, la température, la pression, le courant, l’émission acoustique, l’analyse de lubrifiant, l’inspection visuelle et les observations de l’opérateur. La fréquence d’échantillonnage doit correspondre à la physique de la défaillance. La vibration de roulement à haute fréquence et la corrosion qui dérive lentement nécessitent des capteurs, des capacités de stockage, des caractéristiques et une logique d’alerte différents. L’étalonnage et la qualité d’installation font partie de la qualité des données.
Les modèles prédictifs peuvent détecter des anomalies, classer des défauts connus, estimer des indicateurs de santé ou prédire la durée de vie résiduelle utile. Un signal statistiquement inhabituel n’est pas automatiquement une défaillance exploitable. Les modèles ont besoin du contexte d’état opérationnel, de l’incertitude, de l’évaluation du délai et d’une validation sur différents équipements, saisons, charges et événements de maintenance. Les fausses alarmes consomment la confiance et la main‑d’œuvre ; les détections manquées peuvent engendrer des pertes graves.
Le résultat des analyses doit être relié à une décision : inspecter, lubrifier, déclasser, planifier un travail, commander une pièce ou arrêter la production. Les seuils de décision doivent refléter les conséquences de la défaillance, le délai d’intervention, la capacité de la main‑d’œuvre, les pièces de rechange et les fenêtres de production. Le seuil économiquement optimal n’est généralement pas celui qui maximise une métrique générique du modèle.
Intégration de l’APM, mesure de la valeur et gouvernance
L’APM relie la technologie opérationnelle aux systèmes d’entreprise tels que la gestion informatisée de la maintenance, la gestion d’actifs d’entreprise, les historiens, les stocks et la planification. L’intégration doit préserver les horodatages, les unités, l’identité de l’actif, le statut du travail et la provenance. La segmentation du réseau et les passerelles contrôlées sont essentielles, car la commodité du diagnostic ne doit pas créer de voie d’accès aux systèmes de contrôle critiques pour la sécurité.
Mesurez la valeur par la réduction des temps d’arrêt, la diminution du travail d’urgence, le coût de la maintenance, la disponibilité des pièces de rechange, l’efficacité énergétique, le rendement, l’exposition à la sécurité et la durée de vie des actifs. Les défaillances évitées sont contrefactuelles, il faut donc utiliser des références crédibles, des actifs comparables, des hypothèses documentées et des fourchettes de sensibilité. Un pilote qui détecte de nombreuses anomalies mais n’entraîne aucun changement de décision de maintenance n’a pas démontré de valeur commerciale.
La gouvernance désigne des propriétaires pour les capteurs, les modèles, les règles d’alarme, les bibliothèques de défaillances et les processus de travail. Examinez les alertes après chaque intervention, consignez si le diagnostic était correct et réintégrez les résultats confirmés dans les règles et les modèles. Les opérateurs et les mainteneurs ont besoin d’un moyen de contester les recommandations ; le savoir local est une preuve, pas une résistance à l’automatisation.
Exemple pratique : protection d’un actif rotatif critique
Pour un compresseur de production, l’équipe cartographie les composants et les modes de défaillance, classe les conséquences sur la perte de production et la sécurité, et relie les balises d’historien, les capteurs de vibration, les échantillons de lubrifiant, les inspections et les ordres de travail à une identité d’actif unique. Les données de référence doivent couvrir le démarrage, la charge stable, la réduction de charge et les conditions saisonnières. Sinon le modèle peut signaler les transitions normales d’exploitation comme des défauts ou manquer une dégradation visible uniquement à une charge particulière.
Une couche analytique détecte les changements du spectre de vibration et de la température des roulements, estime l’incertitude et affiche les preuves à côté d’événements historiques comparables. Une alerte persistante génère une demande d’inspection plutôt que d’arrêter automatiquement le système. Le mainteneur consigne les constats, l’action, la pièce remplacée et la cause confirmée. Ces résultats déterminent si le seuil, le modèle de défaillance ou l’installation du capteur doit être modifié.
Évaluez le délai d’avertissement, le taux de détection confirmé, le fardeau des fausses alarmes, les temps d’arrêt évités, le travail d’urgence, la disponibilité des pièces de rechange et le coût de la maintenance par rapport à une référence documentée. Incluez le coût des capteurs, de l’intégration, de l’analyse et des processus de travail modifiés. L’examen de la cybersécurité isole la surveillance du contrôle, et la gouvernance désigne des propriétaires pour les données et les modèles. L’objectif est une décision de maintenance économiquement sûre, et non la plus grande collection possible de télémétrie d’actifs.
Checklist de mise en œuvre pratique
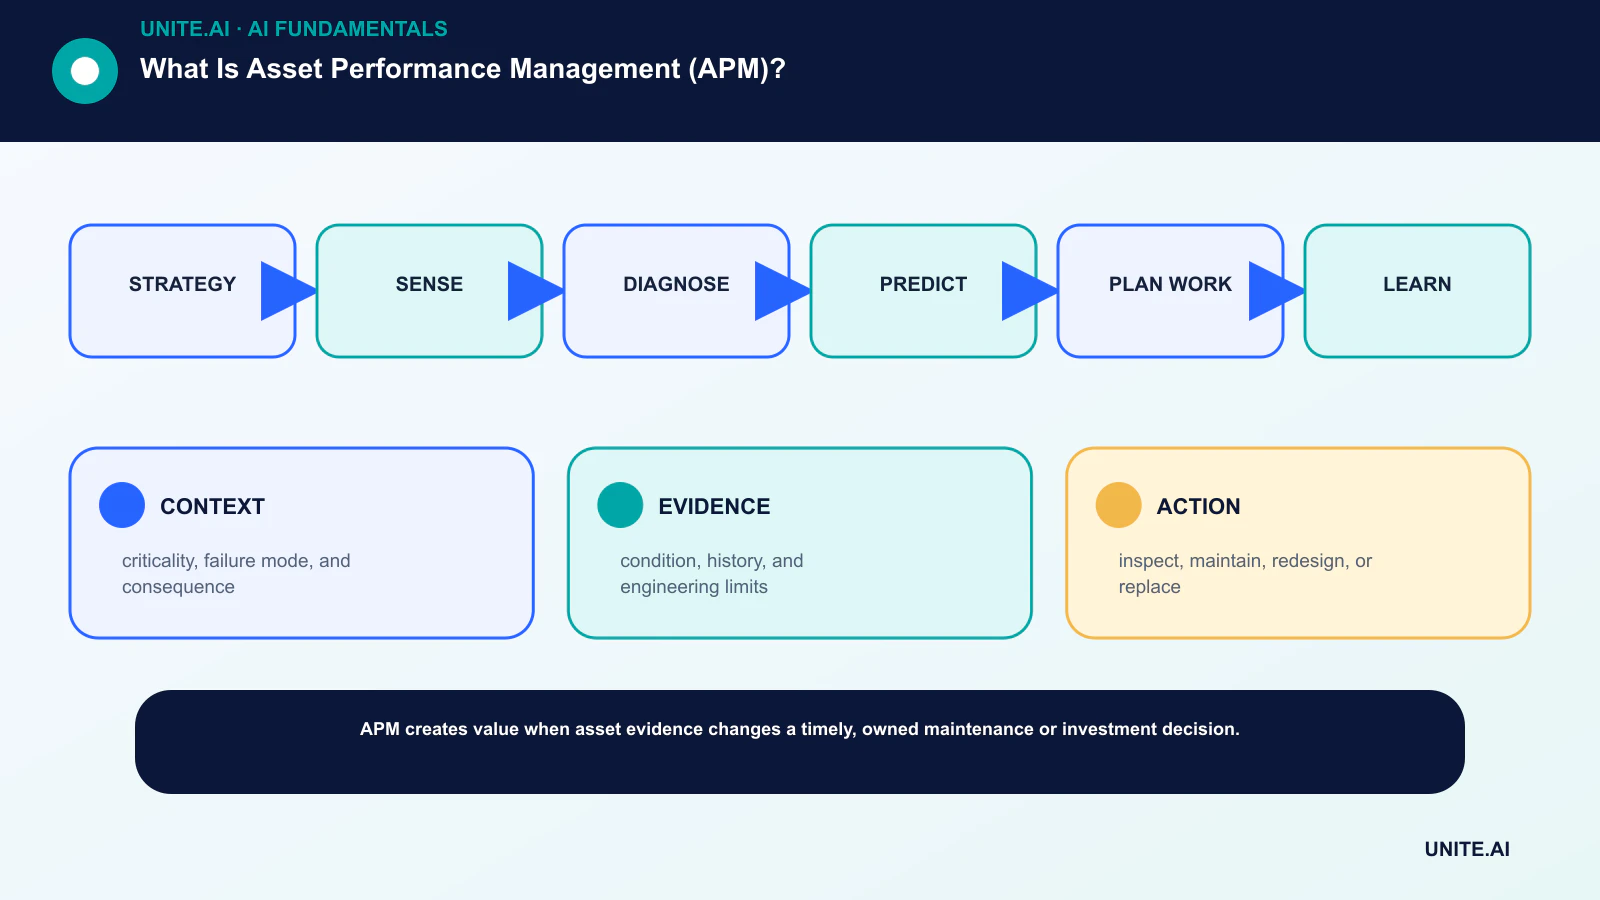
Transformez le concept en un flux de travail limité et testable : stratégie → détection → diagnostic → prédiction → planification du travail → apprentissage. Désignez un propriétaire responsable, documentez les données et les dépendances, établissez une référence simple, définissez les critères d’acceptation et d’arrêt, testez des défaillances représentatives et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les défaillances de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la mise en production, modifier un seuil, outrepasser une sortie ou arrêter l’opération. Revoyez la décision après l’arrivée des données réelles, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- CONTEXTE: criticité, mode de défaillance et conséquence.
- EVIDENCE: état, historique et limites d’ingénierie.
- ACTION: inspecter, entretenir, redessiner ou remplacer.
Questions fréquemment posées
En quoi l’APM diffère-t-il d’un CMMS ?
Un CMMS gère principalement les travaux de maintenance, les plannings et les enregistrements. L’APM ajoute la stratégie d’actifs, l’analyse de fiabilité et d’état, la priorisation et les décisions de performance ; les systèmes s’intègrent souvent.
La maintenance prédictive est-elle requise pour l’APM ?
Non. Les stratégies préventive, basée sur l’état, de fonctionnement jusqu’à la défaillance, de redessin et de remplacement peuvent toutes être appropriées. La prédiction n’est qu’un outil au sein d’une stratégie d’actifs.
Références principales












