Fondamentaux de l’IA
Qu’est‑ce que l’Emotion AI (informatique affective) et pourquoi est‑ce important ?

 Ajouter Unite.AI à vos sources préférées sur Google
L’Emotion AI, souvent appelée informatique affective, applique le calcul aux signaux associés à l’affect, tels que le langage, la prosodie vocale, les mouvements du visage, la posture, la physiologie ou les schémas d’interaction. Un système peut classer une étiquette, estimer des dimensions comme la valence et l’excitation, ou adapter une interface.
Le résultat est une inférence — pas une lecture directe d’un état émotionnel interne. Les expressions varient selon la personne, la culture, le contexte, la santé et la situation, de sorte que le même signal observable peut soutenir plusieurs explications. Les usages à enjeux élevés nécessitent des preuves solides, le consentement et un examen juridique.
Points clés
- Définissez précisément la cible observable ; émotion, expression, sentiment, stress et engagement ne sont pas interchangeables.
- Validez sur la population et l’environnement visés, pas seulement sur un benchmark sélectionné.
- Privilégiez l’assistance et le contrôle de l’utilisateur plutôt que la surveillance cachée ou le jugement automatisé aux conséquences.
- Documentez l’incertitude, les droits sur les données, la conservation, les performances par sous‑groupe et une procédure pour contester les décisions.
Signaux et cibles des modèles
Les modèles textuels peuvent estimer le sentiment exprimé ; les modèles audio utilisent le timing, la hauteur et l’énergie ; les modèles vision analysent les mouvements ; les systèmes physiologiques peuvent exploiter la fréquence cardiaque ou la conductance cutanée. Les systèmes multimodaux combinent les signaux, mais davantage de capteurs ne produisent pas automatiquement une étiquette plus exacte.
Une étiquette telle que « frustré » dépend des consignes d’annotation et du contexte. L’analyse de sentiment des mots est plus restreinte que l’inférence de l’état émotionnel d’une personne, et aucune des deux ne doit être confondue avec une évaluation clinique.
Pourquoi le contexte et l’incertitude dominent
Les personnes masquent, exagèrent ou expriment leurs sentiments différemment. Le handicap, la langue, l’éclairage, la qualité du microphone et les normes sociales peuvent modifier les signaux observés. Les jeux de données de laboratoire peuvent ne pas représenter un centre d’appels, une salle de classe, un véhicule ou une clinique.
Évaluez la calibration, l’abstention, les erreurs par groupe, les performances inter‑domaines et les alternatives. Les matrices de confusion aident à identifier les étiquettes confondues, mais une revue qualitative est nécessaire pour en comprendre les raisons.
Applications utiles et à risque
Les applications contrôlées par l’utilisateur peuvent soutenir l’accessibilité, le journal réflexif, la formation adaptative ou une alerte de sécurité. Ces usages doivent préciser ce qui est mesuré, permettre la correction et éviter de surestimer la certitude.
Les décisions liées à l’emploi, à l’éducation, à l’assurance, à la police et à la santé créent des enjeux bien plus élevés. Le règlement européen sur l’IA interdit certaines utilisations de la reconnaissance des émotions dans les milieux de travail et l’éducation, sous réserve d’exceptions précisées, et classe les autres usages selon le risque. Les exigences varient selon la juridiction et évoluent avec le temps.
Déploiement responsable
Demandez si la tâche nécessite réellement une inférence émotionnelle. Appliquez la minimisation des données, un objectif explicite, une courte conservation, la sécurité, des tests indépendants, une notification à l’utilisateur et une révision humaine. Évitez de créer des profils secondaires à partir de signaux collectés à d’autres fins.
Appliquez les pratiques d’IA explicable sans laisser entendre qu’une carte de saillance prouve une émotion. Communiquez l’incertitude en langage clair et offrez une méthode significative pour se désinscrire ou contester un résultat aux conséquences.
Comment l’affect est représenté
Les modèles catégoriels prédisent des étiquettes telles que joie, colère, peur, tristesse ou neutre. Les modèles dimensionnels estiment des valeurs continues comme la valence, l’excitation et la dominance. Les modèles d’évaluation décrivent comment une personne juge un événement. Ces représentations sont des théories et des choix de mesure, pas des vérités de terrain interchangeables.
Les annotations peuvent provenir de la personne vivant l’événement, d’un observateur, d’un clinicien ou d’un protocole expérimental. L’auto‑déclaration comporte des limites d’introspection et de mémoire ; les étiquettes d’observateur infèrent l’état à partir du comportement ; les mesures physiologiques reflètent l’excitation et de nombreux processus non émotionnels. Un jeu de données doit indiquer de quel point de vue l’étiquette est donnée.
La modélisation temporelle est importante car l’affect se déploie sur la durée. Les étiquettes faciales au niveau de la trame peuvent réagir excessivement à un mouvement transitoire, tandis qu’une moyenne au niveau de l’énoncé peut masquer les changements. La longueur de la fenêtre, la synchronisation entre capteurs, les canaux manquants et les références du locuteur influencent le résultat.
Pipelines de modélisation par modalité
Les pipelines de vision détectent et alignent les visages ou les corps, extraient les trames ou les points de repère, puis classifient les caractéristiques spatiales et temporelles. L’occlusion, l’angle de la caméra, la compression, le teint de peau, les lunettes, les différences faciales et les expressions délibérées peuvent altérer les performances. Les unités d’action faciale décrivent le mouvement plus directement qu’une émotion affirmée et peuvent constituer une cible plus sûre.
Les pipelines audio séparent la parole, normalisent le niveau et modélisent les motifs spectraux, prosodiques et temporels. Une hauteur accrue peut indiquer de l’excitation, du stress, une question ou une habitude du locuteur. Les pipelines texte capturent l’évaluation exprimée et le contexte mais perdent le ton à moins d’être combinés avec l’audio. La fusion multimodale peut se faire au niveau des caractéristiques, des décisions ou des couches d’attention croisée.
La personnalisation peut calibrer le modèle sur la ligne de base d’un individu, mais elle nécessite davantage de données et crée un profil longitudinal sensible. Les systèmes devraient privilégier une adaptation locale ou de courte durée lorsque cela est possible et doivent éviter d’utiliser les données d’une personne pour faire des inférences non liées sans un but légitime.
Évaluation, facteurs humains et garde‑fous
Diviser aléatoirement les trames d’une même vidéo entre l’entraînement et le test crée des fuites. Réservez des personnes, des sessions, des appareils, des sites et des périodes selon la revendication visée. Rapportez des métriques macro afin que les classes courantes ne masquent pas les échecs sur des états rares, et incluez une option d’abstention pour les entrées ambiguës.
Les études utilisateurs devraient mesurer si l’adaptation aide réellement. Une interface qui modifie le ton en fonction d’une inférence incorrecte peut sembler intrusive ou condescendante. Permettez aux utilisateurs de corriger le système, de choisir le degré d’adaptation et de voir la raison fonctionnelle d’une réponse sans se voir attribuer une étiquette émotionnelle définitive.
Un déploiement à haut risque nécessite une évaluation d’impact, un examen juridique, la sécurité et une interdiction des usages secondaires. Conservez les vidéos brutes ou les données biométriques uniquement lorsque cela est nécessaire, limitez l’accès et définissez la suppression. N’utilisez pas les scores émotionnels comme unique preuve de tromperie, de performance, de compétence, d’intention ou de santé mentale.
Évaluer un cas d’usage d’Emotion AI avant le déploiement
Commencez par définir le construit revendiqué : mouvement facial, prosodie vocale, sentiment auto‑déclaré, comportement observé ou état clinique ne sont pas interchangeables. Identifiez la décision qui utilisera la sortie et si un signal moins intrusif peut la servir. Un système qui ajuste la difficulté d’un jeu en fonction d’un retour explicite de frustration possède un profil de preuve et de risque différent de celui qui infère l’honnêteté d’un employé à partir d’une webcam.
La validation nécessite des personnes, cultures, langues, appareils, contextes et conditions d’enregistrement représentatifs, avec une vérité terrain adaptée à la revendication. Comparez avec des bases simples et rapportez l’incertitude, les erreurs par sous‑groupe, les désaccords entre évaluateurs et les performances hors laboratoire. Ne convertissez pas un score probabiliste en une affirmation catégorique sur ce que ressent une personne. Offrez aux utilisateurs la correction, la possibilité de se désinscrire et une voie non biométrique lorsque cela est possible.
Interdisez les décisions aux conséquences basées uniquement sur l’émotion inférée, en particulier dans l’emploi, l’éducation, l’assurance, la police, les soins de santé et l’accès aux services. Minimisez la conservation des enregistrements audio et vidéo bruts, isolez les identifiants biométriques et contrôlez les usages secondaires. La documentation doit expliquer le contexte d’entraînement, l’usage prévu, les usages invalides et les facteurs de confusion connus tels que le handicap, le masquage, le stress, la culture ou les médicaments. L’Emotion AI est une revendication de mesure qui nécessite des preuves, et non une fenêtre magique sur l’expérience interne.
Checklist de mise en œuvre pratique
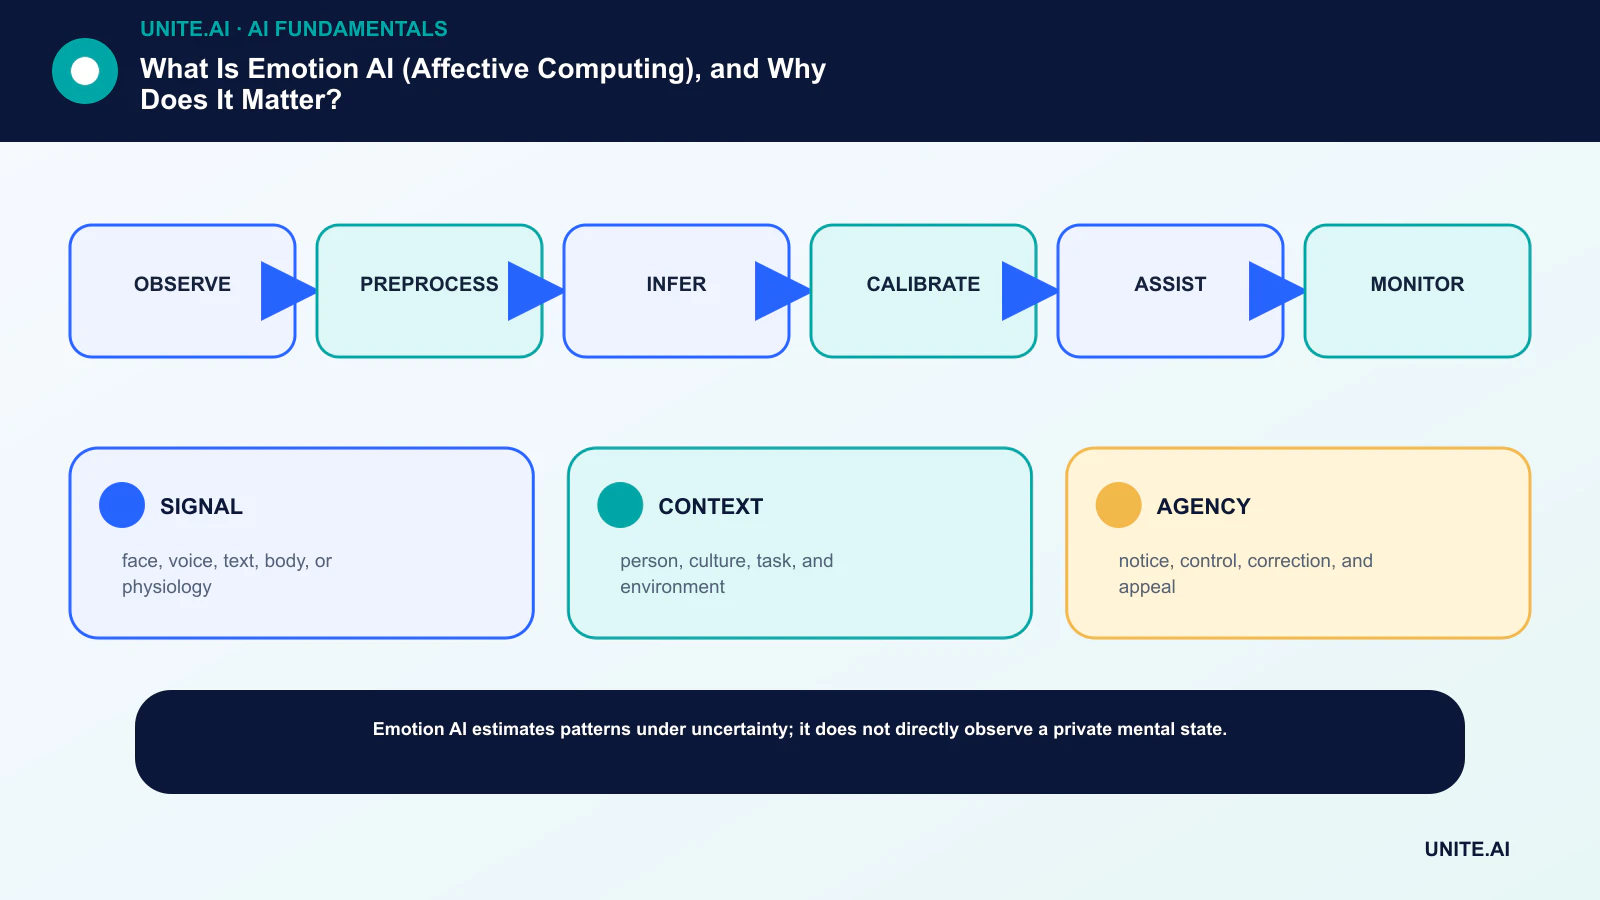
Transformez le concept en un flux de travail limité et testable : observer → prétraiter → inférer → calibrer → assister → surveiller. Désignez un responsable imputable, documentez les données et les dépendances, établissez une base simple, définissez des critères d’acceptation et d’arrêt, testez des échecs représentatifs et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les modifications.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les pannes de dépendances et les abus ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la mise en production, modifier un seuil, annuler une sortie ou arrêter le fonctionnement. Reconsidérez la décision après l’arrivée de données réelles, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- SIGNAL: visage, voix, texte, corps ou physiologie.
- CONTEXT: personne, culture, tâche et environnement.
- AGENCY: notification, contrôle, correction et appel.
Foire aux questions
L’IA peut‑elle lire avec précision les émotions d’un visage ?
Elle peut prédire les étiquettes du jeu de données à partir des mouvements faciaux, mais ces mouvements ne déterminent pas de façon unique une émotion interne. La précision dépend fortement du contexte, de la population, des étiquettes et de la conception de la mesure.
L’Emotion AI est‑elle légale ?
Cela dépend de l’usage, des données, des personnes et de la juridiction. Certains contextes sont interdits ou à haut risque. Les organisations ont besoin de conseils juridiques à jour, et non d’une checklist technique générique.
Références principales