
Fondamentaux de l’IA
Qu’est‑ce que l’analyse de sentiment ? Méthodes, usages et limites

 Ajouter Unite.AI à vos sources préférées sur Google
L’analyse de sentiment estime le langage évaluatif dans un texte, une transcription orale ou tout autre contenu. Un système peut classer la polarité comme positive, négative ou neutre ; détecter les opinions au niveau des aspects ; estimer l’intensité ; ou identifier la position vis‑à‑vis d’une affirmation particulière.
La cible doit être définie avec soin. Le sentiment n’est pas identique à l’émotion, à l’intention, à la toxicité, à la satisfaction ou à la vérité. Une phrase positive peut décrire un événement néfaste de façon sarcastique, tandis qu’une critique négative d’un produit peut néanmoins recommander le produit dans l’ensemble.
Points essentiels
- Définir l’unité, la cible, les étiquettes et le contexte avant de collecter des exemples.
- Les lexiques sont des repères transparents ; les modèles supervisés et les transformeurs peuvent saisir davantage de contexte mais nécessitent des données représentatives.
- La négation, le sarcasme, le vocabulaire du domaine, le texte multilingue et les limites des aspects restent difficiles.
- Évaluer par classe, sous‑groupe, domaine et période ; inclure une révision humaine pour les usages à conséquences.
Niveaux et cibles
L’analyse au niveau du document produit une seule étiquette pour l’ensemble de l’élément. L’analyse au niveau de la phrase sépare les énoncés, tandis que l’analyse basée sur les aspects associe le sentiment à une entité ou à un attribut — par exemple, positif concernant la qualité de l’image mais négatif concernant l’autonomie de la batterie.
La position interroge si un locuteur soutient une proposition précise, ce qui peut différer du ton émotionnel. Ces distinctions doivent être définies dans le guide d’annotation avant d’appliquer les méthodes de classification de texte.
Lexiques, modèles classiques et transformeurs
Un lexique attribue des scores aux mots et les combine avec des règles de négation ou d’intensité. Il est interprétable et économique, mais a du mal avec le contexte. Les modèles supervisés classiques utilisent des caractéristiques de mots ou de n‑grammes, tandis que les transformeurs apprennent des représentations contextuelles et peuvent être ajustés finement.
Le prompting en few‑shot peut être pratique, mais les sorties dépendent des exemples et du libellé. Comparez chaque approche complexe avec une base de référence et n’utilisez l’apprentissage few‑shot qu’avec un jeu d’évaluation réservé, versionné.
Défis liés aux données et à la langue
Les étiquettes peuvent refléter la perspective de l’annotateur plutôt qu’un fait objectif. Le décalage de domaine est sévère : « imprévisible » peut être un éloge pour un film et une critique pour un véhicule. Le changement de code, le dialecte, les emojis, les citations et l’ironie compliquent les signaux au niveau des tokens.
Équilibrer les classes intentionnellement et empêcher que des auteurs, produits ou conversations liés ne se retrouvent à la fois dans les ensembles d’entraînement et de test. Un modèle qui mémorise une marque ou un locuteur peut sembler précis sans réellement apprendre le sentiment.
Évaluation et usage responsable
Rapporter la précision, le rappel, le F1 et une matrice de confusion plutôt que la simple exactitude. Examiner les erreurs par aspect, longueur, dialecte et période, et calibrer les seuils en fonction du coût opérationnel de chaque erreur.
L’agrégation des tendances peut soutenir la recherche ou le triage, mais déduire l’état d’un individu ou prendre des décisions d’emploi, de crédit, de santé ou de police engendre un risque accru. Fournir l’incertitude, le contexte source, des contrôles de confidentialité et une révision humaine.
Annotation et construction de jeux de données
Rédiger un guide d’annotation contenant l’entité cible, l’unité d’analyse, les définitions des étiquettes, la prise en charge des cas mixtes et neutres, les règles de citation, la politique de sarcasme et des exemples du domaine. Piloter avec plusieurs annotateurs, calculer l’accord, discuter des désaccords et réviser la tâche avant de généraliser les étiquettes.
L’échantillonnage détermine ce que le modèle apprend. Un flux de réseaux sociaux peut surreprésenter les comptes très actifs ; les tickets de support peuvent omettre les clients satisfaits ; les notes en étoiles peuvent ne pas correspondre au texte de l’avis. Conserver les métadonnées de source et de temps, respecter les conditions d’utilisation de la plateforme et la confidentialité, et créer un ensemble de test à partir de la population où les décisions seront prises.
Des fuites d’étiquettes peuvent survenir via les notes, les emojis insérés par le système de collecte, les signatures modèles ou les noms de produits corrélés au sentiment. Dédupliquer les publications quasi‑identiques et regrouper les conversations ou les auteurs afin que leur langage n’apparaisse pas des deux côtés d’une division.
Choix de modélisation et calibration
Les systèmes basés sur des lexiques additionnent les scores des mots et ajustent pour la négation, les intensificateurs, la ponctuation ou les emojis. Ils offrent une vérification de cohérence utile et peuvent être adaptés avec des termes du domaine. Les modèles linéaires avec des caractéristiques TF–IDF restent compétitifs sur certains jeux de données et mettent en évidence les n‑grammes influents.
Les encodeurs contextuels représentent les mots en fonction du texte environnant et peuvent être ajustés finement pour la polarité ou les aspects. Les longs documents peuvent nécessiter des modèles hiérarchiques, une agrégation de phrases ou la récupération de passages pertinents. Les approches multilingues peuvent entraîner un modèle partagé, traduire vers une langue pivot ou maintenir des modèles locaux ; chacune comporte des compromis de couverture et culturels.
La calibration des probabilités est importante lorsque les scores déclenchent une action. Les courbes de fiabilité et l’erreur de calibration attendue révèlent si une confiance de 0,8 rapportée correspond à environ 80 % de justesse. Les seuils peuvent créer une bande d’abstention pour la révision humaine, et des seuils distincts peuvent être justifiés lorsque les coûts d’erreur diffèrent — sans masquer une qualité inégale.
Applications et interprétations erronées courantes
L’agrégation du sentiment peut aider à prioriser les thèmes, comparer les réactions aux campagnes ou orienter les messages de service urgents. L’analyse des aspects est souvent plus exploitable que la polarité globale car elle identifie ce que les gens discutent. L’analyse des tendances nécessite un échantillonnage stable et des définitions d’étiquettes cohérentes dans le temps.
Ne pas assimiler la prévalence des publications négatives à l’opinion de la population. Le comportement de publication, les bots, la modération, la démographie de la plateforme, les campagnes et les requêtes de collecte façonnent l’échantillon. Un modèle de sentiment ne mesure pas la population silencieuse, et une modification du libellé peut sembler être un changement d’attitude.
Pour des décisions individuelles, les fausses étiquettes peuvent être stigmatisantes et difficiles à contester. Évitez d’utiliser le sentiment comme proxy de l’engagement des employés, de la santé mentale, de la solvabilité, de l’intention ou de la tromperie. Lorsque des personnes sont concernées, afficher le contexte source, permettre la correction et exiger un décideur humain disposant d’une vraie discrétion.
Exemple pratique : analyse de sentiment pour les retours clients
Une entreprise analysant les commentaires du support doit définir si elle a besoin du sentiment du document, du sentiment d’aspect, de l’émotion, de l’urgence ou de la classification des problèmes. « La livraison était rapide mais le produit s’est cassé » ne peut pas être représenté fidèlement par une seule étiquette positive ou négative. Créez un guide d’annotation pour les cibles, la négation, le sarcasme, les déclarations mixtes, les citations et les cas inconnus, puis mesurez l’accord avant de considérer les étiquettes comme vérité de base.
Comparer un lexique ou une base linéaire avec un encodeur ajusté finement ou un modèle de langage prompté. Diviser les données par période ou par client pour éviter les fuites de quasi‑doublons, et conserver la prévalence des classes. Rapporter la précision, le rappel, le F1, la calibration et la matrice de confusion par langue, canal, produit et proxys démographiques uniquement lorsque cela est légal et justifié. Examiner les erreurs à haute confiance car elles sont plus dangereuses dans le routage automatisé que les sorties incertaines qui sont escaladées.
Utilisez le sentiment comme un signal parmi d’autres pour l’agrégation ou la priorisation, et non comme une mesure incontestable de l’état d’une personne. Surveillez le vocabulaire et le dérive du produit, réentraîner avec des exemples révisés, et permettre aux agents de corriger les étiquettes. Ne jamais déduire des caractéristiques protégées ou sanctionner des travailleurs à partir de scores de sentiment non validés. Pour les rapports exécutifs, indiquer la taille de l’échantillon, l’incertitude, les données manquantes et les sujets à l’origine du changement afin qu’un score fluctuant conduise à une enquête plutôt qu’à une conclusion simpliste.
Le déploiement multilingue ne doit pas supposer que la traduction des entrées conserve le ton, la négation, l’idiome ou la convention culturelle. Valider chaque langue prise en charge et chaque schéma multilingue avec des relecteurs natifs, et fournir un résultat « inconnu » lorsque les preuves sont faibles. L’adaptation au domaine compte également : des mots qui semblent négatifs dans une conversation ordinaire peuvent être des descriptions techniques neutres. Conserver des seuils ou des modèles séparés uniquement lorsque les preuves opérationnelles justifient la complexité et la charge de gouvernance supplémentaires.
Checklist de mise en œuvre pratique
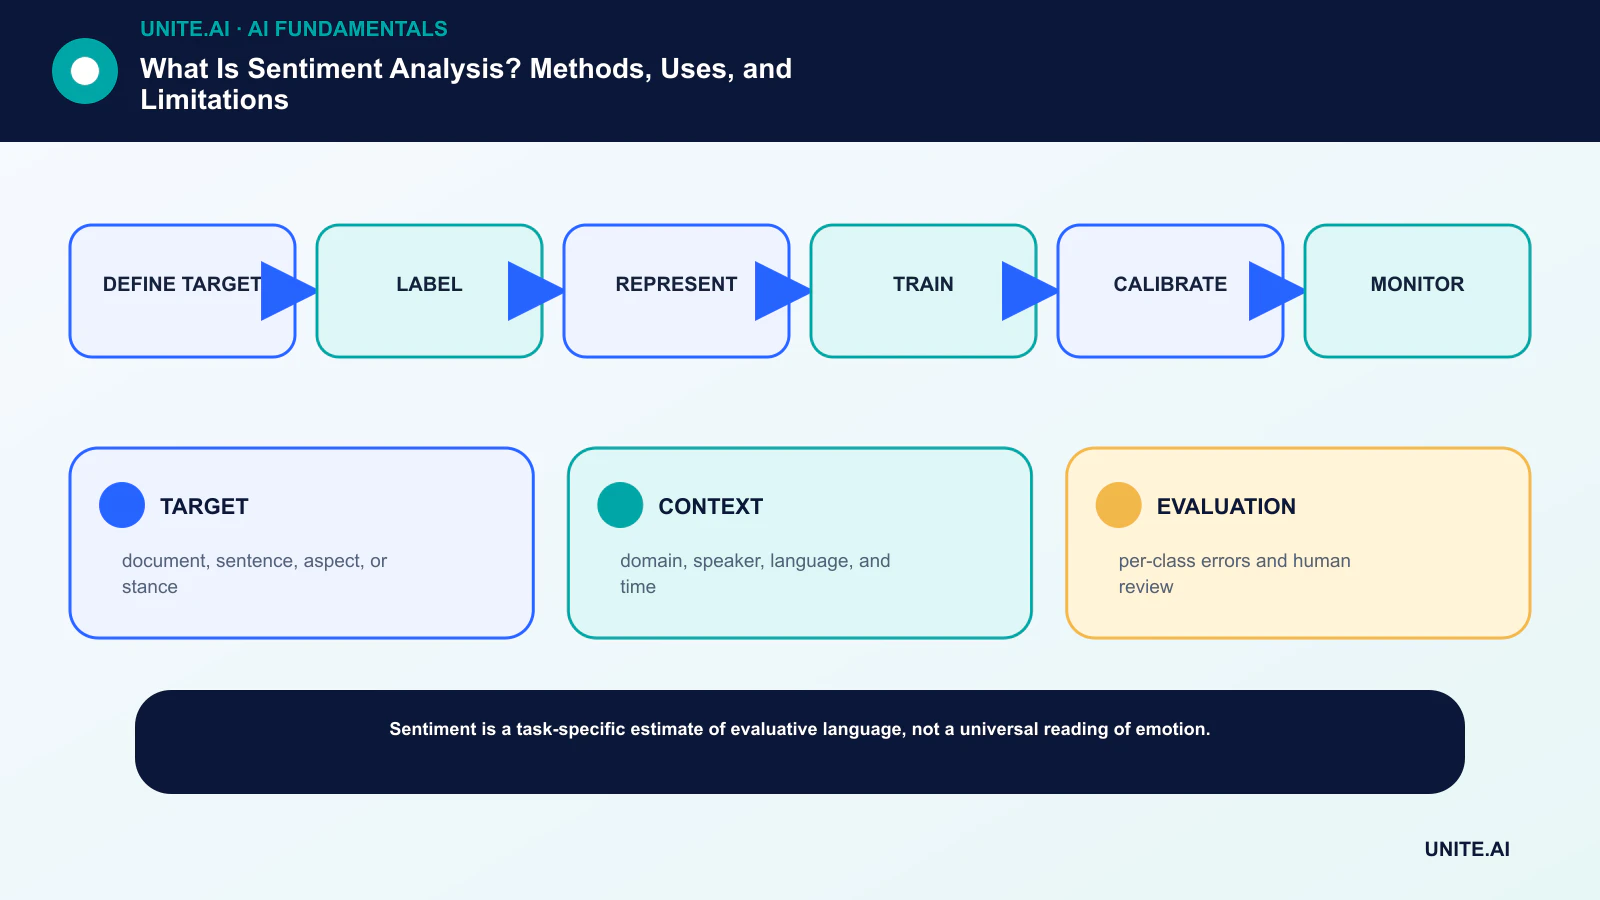
Transformer le concept en un flux de travail borné et testable : définir la cible → l’étiquette → la représentation → l’entraînement → la calibration → la surveillance. Nommer un responsable imputable, documenter les données et les dépendances, établir une base simple, définir les critères d’acceptation et d’arrêt, tester des échecs représentatifs, et définir la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrer les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuer une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Tester les cas normaux, les conditions limites, les pannes de dépendances et les usages abusifs ; conserver les preuves et les risques non résolus. Définir qui peut approuver la mise en production, modifier un seuil, annuler une sortie ou arrêter l’opération. Revoir la décision après l’arrivée de données réelles, car un pilote techniquement réussi ne garantit pas des performances fiables à plus grande échelle.
- CIBLE: document, phrase, aspect ou position.
- CONTEXTE: domaine, locuteur, langue et temps.
- ÉVALUATION: erreurs par classe et révision humaine.
Questions fréquentes
L’analyse de sentiment est‑elle objective ?
Non. Elle estime des étiquettes définies par une tâche et un processus d’annotation. Certains textes sont réellement ambigus, mixtes, dépendants du contexte, ou interprétés différemment par les lecteurs.
L’analyse de sentiment peut‑elle détecter le sarcasme ?
Les modèles peuvent apprendre certains schémas, mais le sarcasme dépend souvent de l’historique du locuteur, de connaissances partagées et du contexte hors texte. Il demeure un mode d’échec fréquent.
Références principales












