
Fondamentaux de l’IA
Qu’est‑ce que l’IA explicable ?

 Ajouter Unite.AI à vos sources préférées sur Google
IA explicable (XAI) regroupe des méthodes et des pratiques qui aident les gens à comprendre le comportement ou la sortie d’un système d’IA. Une explication peut décrire les entrées influentes, présenter un exemple similaire, proposer un changement contrefactuel, résumer une règle globale ou indiquer quand le système ne sait pas.
Aucune explication n’est universellement la meilleure. Un développeur qui débogue un modèle, un auditeur qui teste la conformité d’une politique et une personne affectée par une décision ont besoin de preuves différentes. Les explications doivent donc être évaluées en fonction de leur exactitude, de leur sens et de leur usage prévu — pas seulement de leur attrait visuel.
Points clés
- La transparence décrit les informations disponibles ; l’interprétabilité concerne le sens ; l’explication communique des preuves ou des raisons.
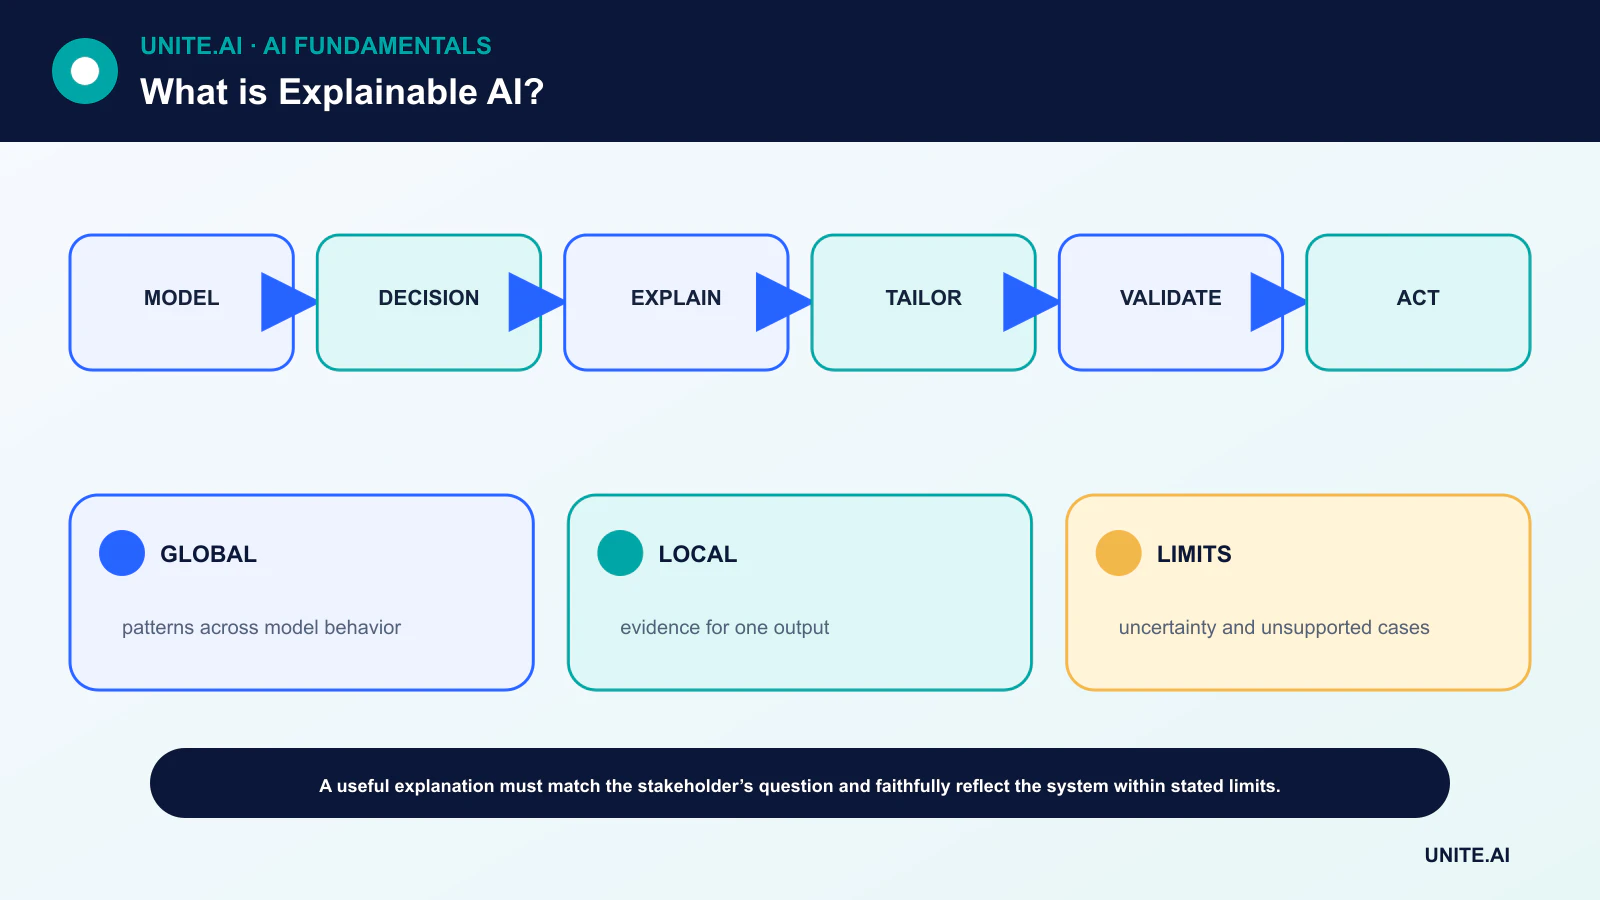
- Les méthodes globales résument un modèle, tandis que les méthodes locales traitent d’une prédiction ou d’une petite région.
- Les explications post‑hoc peuvent être utiles mais peuvent être instables ou ne pas refléter fidèlement le modèle sous‑jacent.
- Une explication ne prouve pas l’équité, la causalité, la robustesse ou la justesse.
Quatre principes pour des explications utiles
Le NIST propose qu’un système fournisse une explication, la rende pertinente pour l’utilisateur visé, veille à ce qu’elle reflète avec précision le processus du système, et communique ses limites de connaissance. Ces principes distinguent l’existence d’une explication de sa qualité.
Le sens dépend du public. Un code de raison concis peut aider un demandeur, tandis qu’un développeur de modèle peut avoir besoin de distributions, du comportement des caractéristiques et de groupes d’échecs. Les deux doivent être liés au même système documenté et au contexte de décision.
Méthodes intrinsèques et post‑hoc
Un modèle linéaire parcimonieux ou un arbre de décision contraint peut être directement interprétable dans son domaine de validité. Un modèle complexe peut, quant à lui, recourir à une attribution de caractéristiques post‑hoc, à un surrogate local, à des exemples, à des cartes de saillance ou à des contrefactuels.
La simplicité intrinsèque n’est pas automatiquement fidèle lorsque les caractéristiques sont mal définies ou que le pipeline est caché. La complexité post‑hoc n’est pas non plus automatiquement trompeuse. La méthode doit être testée par rapport à la question à laquelle elle est censée répondre.
Attribution des caractéristiques et entrées corrélées
Les méthodes d’attribution assignent des parties d’une sortie aux caractéristiques d’entrée selon des hypothèses explicites. LIME ajuste un surrogate local simple autour d’une prédiction ; les méthodes liées à SHAP relient les attributions additives aux concepts de valeur de Shapley.
Les caractéristiques corrélées peuvent partager ou échanger l’attribution, et une forte attribution n’est pas un effet causal. Modifier une caractéristique isolément peut engendrer une personne, une image ou une transaction impossible. Les explications doivent préciser leurs hypothèses de base, d’échantillonnage et de dépendance.
Contrefactuels, exemples et comportement global
Un contrefactuel interroge quel changement réalisable modifierait un résultat. Les contraintes sont essentielles: une explication exploitable ne doit pas recommander de changements immuables, illégaux ou irréalistes. Les méthodes basées sur des exemples affichent des prototypes ou des cas d’entraînement influents, mais peuvent exposer des données privées.
L’analyse globale examine la performance, la dépendance partielle, la monotonie, les interactions et le comportement des sous‑groupes. Pour les ensembles tels que le gradient boosting, combinez les résumés avec des preuves locales et des tests directs des contraintes attendues.
Valider l’explication et le système
Testez la fidélité, la stabilité face à de petites perturbations, la cohérence entre entrées équivalentes, la compréhension par l’utilisateur et si l’explication soutient une décision appropriée. Les tests adversariaux doivent vérifier si une explication persuasive peut accompagner une sortie erronée ou manipulée.
L’XAI s’inscrit dans une évaluation plus large: qualité hors échantillon, calibration, équité, confidentialité, sécurité, surveillance et mécanismes de recours. Une explication peut soutenir la responsabilité, mais elle ne peut pas se substituer à une gouvernance responsable.
Cibles d’explication et familles de méthodes
L’IA explicable doit commencer par une question et un public: pourquoi une décision a eu lieu, comment le modèle se comporte généralement, quelles preuves l’ont influencé, ce qui changerait le résultat, ou si une politique a été respectée. Les explications locales portent sur une prédiction ; les explications globales résument un comportement plus large. Les modèles intrinsèquement interprétables exposent coefficients, règles ou structures, tandis que les méthodes post‑hoc approximent les modèles complexes. Une explication du comportement d’un modèle n’est pas automatiquement une explication causale du monde ni une justification de l’équité d’une décision.
Les méthodes d’attribution de caractéristiques comprennent les gradients, les gradients intégrés, les valeurs de type SHAP, la permutation et les modèles de surrogate locaux. Les explications basées sur des exemples récupèrent des cas influents ou similaires ; les contrefactuels proposent des changements associés à une sortie différente ; les méthodes conceptuelles relient les représentations internes à des catégories humaines. Chaque méthode repose sur des hypothèses concernant les bases, l’indépendance des caractéristiques, la linéarité locale ou l’accès au modèle. Les variables corrélées, les interactions et le pré‑traitement peuvent rendre les attributions instables ou trompeuses. Comparez les méthodes et perturbez les entrées pour tester si une explication prédit le comportement.
Évaluation et facteurs humains
Évaluez la fidélité — si l’explication correspond au modèle — séparément de la plausibilité pour une personne. Testez la stabilité, la sensibilité, la complétude, la parcimonie et l’utilité pour une tâche définie telle que le débogage ou le recours. Les études humaines nécessitent des participants représentatifs et doivent mesurer la qualité de décision, la détection d’erreurs, la dépendance et le temps, et non pas si les utilisateurs jugent un graphique clair. Une explication persuasive peut accroître la confiance dans un modèle erroné, ainsi les interfaces doivent afficher l’incertitude, les alternatives et les limites.
Les contrefactuels doivent être réalisables, exploitables et ne pas recommander de modifier des traits protégés ou immuables. Les explications peuvent divulguer des informations sur le modèle ou personnelles et aider les attaquants à rétro‑ingénier les décisions. Appliquez des contrôles d’accès et minimisez les sorties. Pour les usages réglementés ou à fort impact, conservez la provenance des données, la version du modèle, le seuil et la logique décisionnelle réelle ; un graphique générique d’importance des caractéristiques ne peut remplacer une raison juridiquement significative ou une révision humaine.
Utiliser les explications de manière responsable
Sélectionnez le modèle le plus simple qui satisfait les exigences de performance et opérationnelles, mais ne sacrifiez pas la validité pour une interprétabilité superficielle. Combinez les explications avec des tests de sous‑groupes, des vérifications de robustesse, des analyses causales le cas échéant, et une surveillance des résultats. Documentez le public visé et les inférences invalides. Si une explication change après une perturbation inoffensive, enquêtez avant le déploiement. L’explicabilité constitue une preuve concernant un système selon une méthode ; elle est précieuse pour le débogage, la supervision et la communication, mais ne certifie ni la vérité, ni l’équité, ni la sécurité, ni la compréhension.
Exemple détaillé : expliquer un modèle de risque de crédit
Un prêteur définit d’abord le public et la raison requise: les demandeurs ont besoin de facteurs de décision précis et d’un chemin de correction, tandis que les développeurs ont besoin de diagnostics. Une base interprétable calibrée est comparée à un modèle boosté. Les attributions locales, les contrefactuels et l’analyse globale des erreurs sont testés pour leur fidélité, stabilité, comportement des caractéristiques corrélées et utilité. Les explications ne peuvent pas recommander de modifier l’âge, le handicap ou tout autre trait immuable, et elles ne sont pas présentées comme des effets causaux.
Le registre de décision de production conserve les données sources, la transformation des caractéristiques, le modèle, le seuil, la politique et l’action humaine. Les demandeurs peuvent contester des données incorrectes et obtenir un examen significatif. La surveillance vérifie la stabilité des résultats et des explications entre les groupes et lors des mises à jour du modèle. Si une explication plausible change suite à une perturbation inoffensive d’une caractéristique ou omet une règle de politique décisive, le déploiement s’arrête. L’explicabilité complète la validation et les droits procéduraux ; elle n’excuse pas un objectif invalide, des résultats discriminatoires ou l’absence d’une autorité humaine responsable.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement opérationnel, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement à la calibration ou à l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer la preuve d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les modifications, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés, sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage d’incident, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Les cartes d’attention sont‑elles des explications ?
Ils peuvent constituer des signaux de diagnostic, mais les poids d’attention seuls ne garantissent pas de représenter fidèlement les raisons de la sortie d’un modèle.
L’IA explicable nécessite‑t‑elle un modèle simple ?
Pas toujours. Les modèles complexes peuvent être analysés avec des méthodes post‑hoc, mais ces explications nécessitent une validation indépendante et des limites clairement énoncées.
Références principales












