
Fondamentaux de l’IA
Comment créer un chatbot : architecture, données, sécurité et évaluation

 Ajouter Unite.AI à vos sources préférées sur Google
Un chatbot est une application qui reçoit un message, détermine ce dont l’utilisateur a besoin et renvoie une réponse sous forme de texte ou de parole. Les systèmes modernes peuvent combiner des règles, la recherche, des classificateurs, transformers, des outils et de grands modèles de langage plutôt que de se reposer sur un seul modèle.
Construire un chatbot utile est donc un problème de produit et de systèmes. La couche de dialogue doit se connecter à des connaissances fiables et à des actions commerciales, tandis que l’identité, les autorisations, la journalisation, l’évaluation, les solutions de repli et l’escalade humaine limitent ce que le bot est autorisé à faire.
Points clés
- Commencez par une tâche utilisateur précise et un critère de succès mesurable.
- Séparez la génération de texte de la recherche, des outils, des autorisations et des règles métier.
- Testez des conversations complètes, incluant l’ambiguïté, l’interruption, le refus et la récupération.
- Considérez les invites et les sorties du modèle comme des données non fiables ; surveillez la production et préservez les voies d’escalade.
Définir la tâche avant de choisir un modèle
Notez qui est l’utilisateur, ce qu’il cherche à accomplir, quelles données le système peut consulter et quelles actions nécessitent une confirmation. Un bot de FAQ, un assistant de suivi de commande et un agent de gestion de compte ont des profils de risque très différents.
Élaborez une base de référence non IA et un ensemble d’acceptation de conversations représentatives. Mesurez l’achèvement des tâches, le soutien des réponses, la latence, l’abandon, l’escalade et le coût des erreurs préjudiciables. Une démonstration fluide n’est pas la preuve que le flux de travail fonctionne de manière fiable.
Utiliser une architecture à couches
Un pipeline typique comprend un adaptateur de canal, l’état de session, la validation des entrées, la logique d’intention ou de routage, la recherche, un modèle de réponse ou de politique, des adaptateurs d’outils et l’observabilité. La recherche peut ancrer les réponses dans des documents approuvés ; les outils exécutent des actions contrôlées via des schémas explicites.
Conservez les vérifications déterministes en dehors du modèle de langage. L’authentification, l’autorisation, les limites d’inventaire, les remboursements et les actions irréversibles doivent être appliqués par le code de l’application. L’ingénierie des invites peut façonner le comportement, mais ce n’est pas un système de contrôle d’accès.
Concevoir le dialogue, les connaissances et la récupération ensemble
Les bonnes conversations gèrent les requêtes incomplètes, les corrections, les intentions multiples et les références aux tours précédents. Conservez uniquement le contexte nécessaire à la tâche, rendez la rétention visible et distinguez une déclaration d’utilisateur d’un fait fiable renvoyé par un système approuvé.
Lorsque la confiance ou les preuves sont insuffisantes, le bot doit poser une question ciblée, proposer une alternative sûre ou transférer à une personne avec un résumé concis. La récupération fait partie de l’expérience centrale — ce n’est pas un cas marginal ajouté après le lancement.
Évaluer et exploiter le système complet
Testez la qualité de la recherche, la sélection d’outils, la précision des arguments, la conformité aux politiques, la résistance aux injections d’invites, les fuites de confidentialité et les résultats de bout en bout. Effectuez des tests d’adversaires en équipe rouge et vérifiez qu’un document malveillant ne peut pas remplacer silencieusement les instructions du système.
Versionnez les invites, les index, les modèles, les politiques et les outils. Examinez des conversations échantillonnées avec des contrôles de confidentialité, surveillez la dérive et les groupes de défaillances, et maintenez la capacité de retour en arrière. Cette discipline opérationnelle relie le développement de chatbots à AIOps et à la réponse aux incidents.
Composants de base du chatbot en détail
La couche de canal normalise les entrées provenant du chat web, des applications mobiles, des plateformes de messagerie ou de la parole. Une couche de session associe les messages à une conversation authentifiée ou anonyme, impose l’expiration et ne stocke que l’état nécessaire à la tâche. Les contrôles d’entrée limitent la taille et les types de fichiers, détectent les charges dangereuses et suppriment le balisage que les systèmes en aval ne doivent pas exécuter.
Un routeur décide alors si la requête appartient à un flux déterministe, à une recherche, à une génération ou à une file d’attente humaine. Les classificateurs d’intention classiques restent utiles lorsque l’ensemble des libellés est stable ; les modèles de langage sont plus flexibles mais plus difficiles à calibrer. Les routeurs hybrides peuvent réserver les tâches réglementées ou à fort volume à des flux de travail testés et utiliser un modèle général pour des explications ouvertes.
La couche de réponse doit transporter séparément les preuves et l’état. Une phrase générée peut citer un passage récupéré, mais l’application doit conserver la source et la version qui l’ont soutenue. La mémoire de la conversation doit distinguer les préférences de l’utilisateur des données de compte vérifiées, et ne doit jamais permettre à un message antérieur de l’utilisateur d’accorder de nouvelles autorisations.
Recherche, outils et transactions
La qualité de la recherche commence avant la recherche vectorielle. Les documents nécessitent une propriété, des étiquettes d’accès, des versions canoniques, des fragments utiles et des dates de suppression. La réécriture de requêtes, la recherche par mots-clés, les embeddings, les filtres et le re‑ranking peuvent être combinés. L’évaluation doit mesurer si les preuves nécessaires ont été récupérées, si les passages hors sujet ont été exclus et si la réponse suit réellement les preuves.
Les outils transforment une suggestion du modèle en une requête typée vers le code de l’application. Chaque outil nécessite un objectif restreint, un schéma explicite, une validation côté serveur, des identifiants au moindre privilège, des délais d’expiration, de l’idempotence quand c’est possible et un résultat clair. Le modèle ne doit pas construire de requêtes de base de données brutes ou d’URL arbitraires lorsqu’une opération commerciale bornée peut être exposée à la place.
Les transactions nécessitent une confirmation au moment de l’engagement. Affichez à l’utilisateur les champs matériels — destinataire, montant, adresse, date ou modification d’accès — et ne considérez pas un ancien « oui » comme une approbation d’une nouvelle action. Pour un travail à plusieurs étapes, conservez une machine d’état hors du modèle afin qu’une nouvelle tentative ou un message réordonné ne puisse pas contourner une porte obligatoire.
Plan pratique de construction et d’évaluation
Commencez avec vingt à cinquante tâches représentatives et incluez des requêtes infructueuses, ambiguës et hors de portée. Indiquez l’action attendue, les preuves, l’escalade et le comportement interdit. Mettez en œuvre le flux viable le plus simple, puis ajoutez la recherche ou la génération uniquement lorsqu’elles améliorent un résultat mesuré. Cela produit une suite de régression réutilisable avant que l’interface ne devienne complexe.
Évaluez les composants et les conversations séparément. Les métriques de recherche, la précision des appels d’outil, les contrôles de politique et le soutien des réponses diagnostiquent des échecs spécifiques ; l’achèvement des tâches et l’effort de l’utilisateur révèlent la qualité au niveau du système. Utilisez des tests à plusieurs tours qui corrigent des détails antérieurs, interrompent un flux, changent de sujet, retiennent des informations requises et déclenchent des pannes de dépendance.
Le déploiement en production doit être étalonné par groupe d’utilisateurs, tâche et autorisation. Surveillez les affirmations non prises en charge, les clarifications répétées, le rejet d’outils, l’escalade, la latence et l’abandon. Examinez des échantillons respectueux de la vie privée, maintenez un chemin de désactivation d’urgence pour chaque outil et utilisez les constats d’incident pour mettre à jour les invites, les données, le code et le jeu de tests conjointement.
Exemple concret : un chatbot d’assistance du prototype à la production
Supposons qu’un détaillant souhaite un chatbot qui répond aux questions de commande et de retour. Définissez d’abord les intentions prises en charge, les conditions d’escalade, les connaissances approuvées, les règles d’authentification et les actions interdites. Construisez un jeu de tests à partir de questions historiques anonymisées, incluant des requêtes vagues, des fautes de frappe, des entrées multilingues, des utilisateurs en colère, des injections d’invites et des questions sans réponse. Une base de recherche doit renvoyer des preuves avant que toute réponse générative ne soit autorisée à revendiquer une politique ou le statut d’une commande.
Le runtime peut classer l’intention, récupérer les passages de politique, demander une vérification d’identité uniquement lorsque les données du compte sont nécessaires, appeler une API de commande à portée restreinte, composer une réponse et y joindre des citations. Chaque appel d’outil nécessite un schéma explicite, une vérification d’autorisation, un délai d’expiration, une politique de nouvelle tentative et une clé d’idempotence. Le modèle ne doit jamais construire de requêtes de base de données brutes ou décider de ses propres autorisations. Les actions à fort impact telles que l’annulation ou les remboursements exigent une confirmation et, au-delà des limites définies, une approbation humaine.
Évaluez la précision de l’intention, la justesse de la réponse, le soutien des preuves, la qualité du refus, la maîtrise réussie, la précision de l’escalade, la latence et le coût par conversation résolue. Examinez les résultats par intention et groupe d’utilisateurs plutôt que par une moyenne unique. En production, consignez des traces respectueuses du consentement, les résultats des outils, les versions des documents récupérés et les corrections des utilisateurs. Déployez progressivement, comparez avec le canal existant et désactivez les capacités lorsque les seuils d’erreur, d’abus ou de dépendance sont dépassés.
Checklist de mise en œuvre pratique
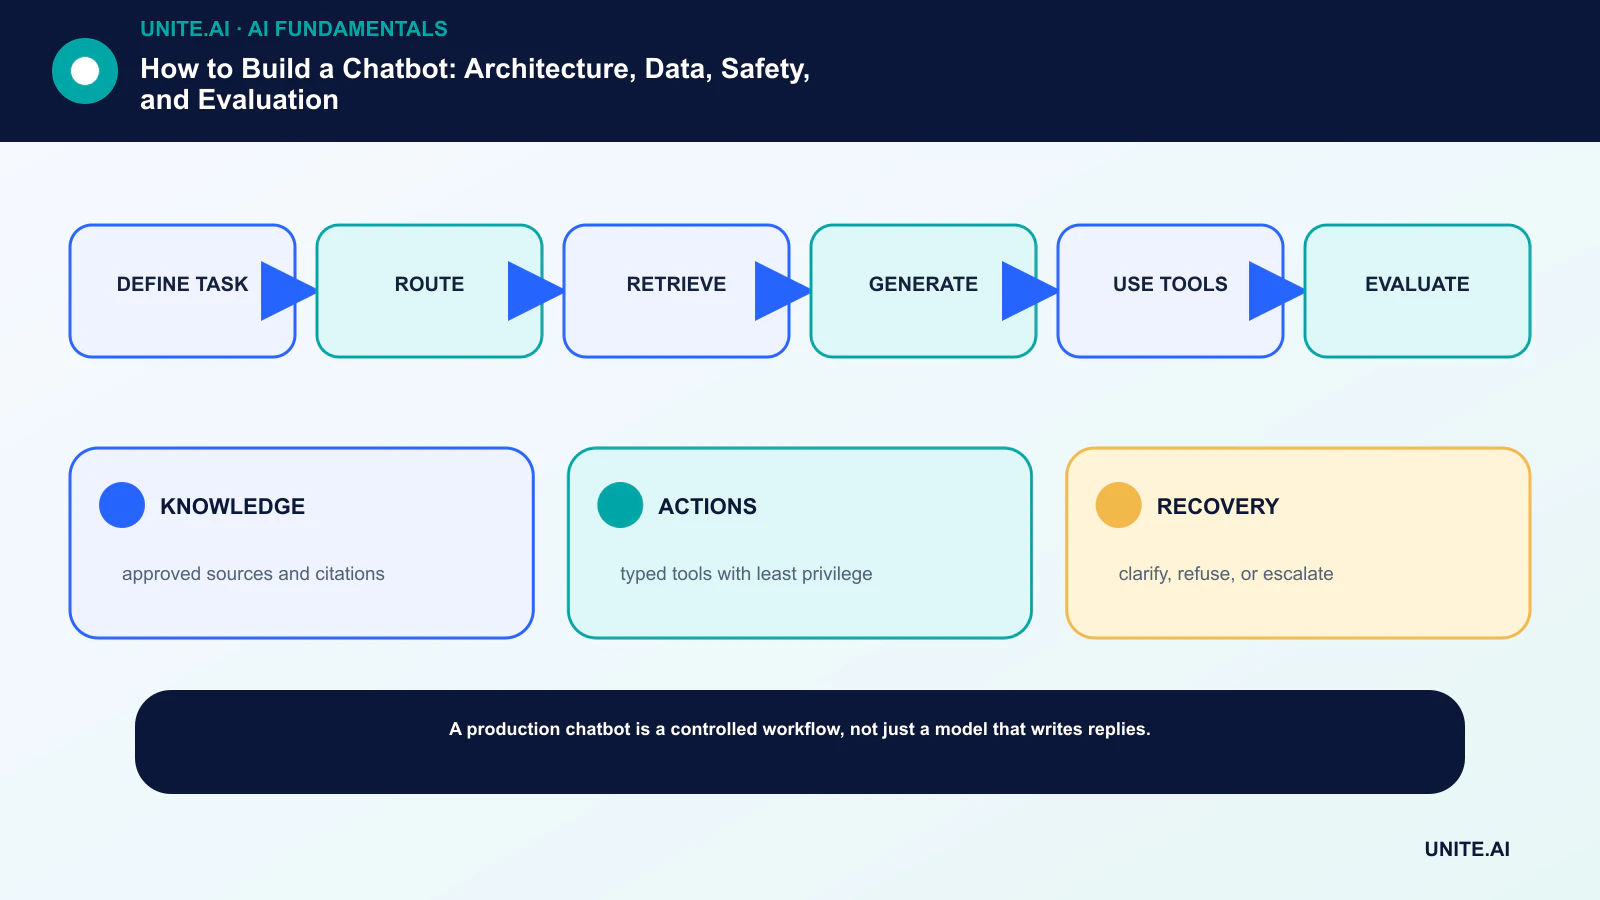
Transformez le concept en un flux de travail limité et testable: définir la tâche → router → récupérer → générer → utiliser les outils → évaluer. Désignez un responsable imputable, documentez les données et les dépendances, établissez une base simple, définissez les critères d’acceptation et d’arrêt, testez des échecs représentatifs et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les pannes de dépendance et les abus ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la mise en production, modifier un seuil, passer outre une sortie ou arrêter l’opération. Reconsidérez la décision après l’arrivée des données du monde réel, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- CONNAISSANCES: sources approuvées et citations.
- ACTIONS: outils typés avec le moindre privilège.
- RÉCUPÉRATION: clarifier, refuser ou escalader.
Questions fréquemment posées
Un chatbot a-t-il besoin d’un grand modèle de langage ?
Non. Les règles, la recherche, les formulaires et les petits classificateurs peuvent être plus sûrs et moins coûteux pour des tâches limitées. Un LLM est utile lorsque la compréhension ou la génération flexible du langage apporte une valeur mesurable.
Que doit‑on tester avant le lancement ?
Des tâches représentatives, des requêtes non prises en charge, un langage ambigu, des pannes d’outil, les limites de confidentialité, des invites adversariales, le transfert humain, la latence et la précision de chaque action conséquente.
Références principales












