
Fondamentaux de l’IA
Comment fonctionne la classification de texte ?

 Ajouter Unite.AI à vos sources préférées sur Google
Classification de texte attribue une ou plusieurs étiquettes à un document, un message ou un fragment de texte. Parmi les exemples figurent la détection de spam, le routage d’intention, l’analyse de sentiment, le balisage de sujet, la modération et la priorisation des tickets de support.
Un classificateur en production est plus qu’un modèle. Il dépend d’une taxonomie d’étiquettes précise, d’annotations représentatives, de découpages sans fuite, d’une règle de décision calibrée et d’une surveillance des évolutions du langage et de la prévalence des classes.
Points clés
- Définir les étiquettes et les cas ambigus avant de choisir une architecture.
- Les bases simples sac de mots restent utiles ; les encodeurs pré‑entraînés ajoutent du contexte et de l’apprentissage par transfert.
- La précision peut masquer une mauvaise performance sur les classes minoritaires, il faut donc utiliser des métriques sensibles aux classes et une analyse des erreurs.
- L’étalonnage des probabilités, l’abstention et la révision humaine transforment les scores en décisions plus sûres.
Définir la taxonomie et la politique d’annotation
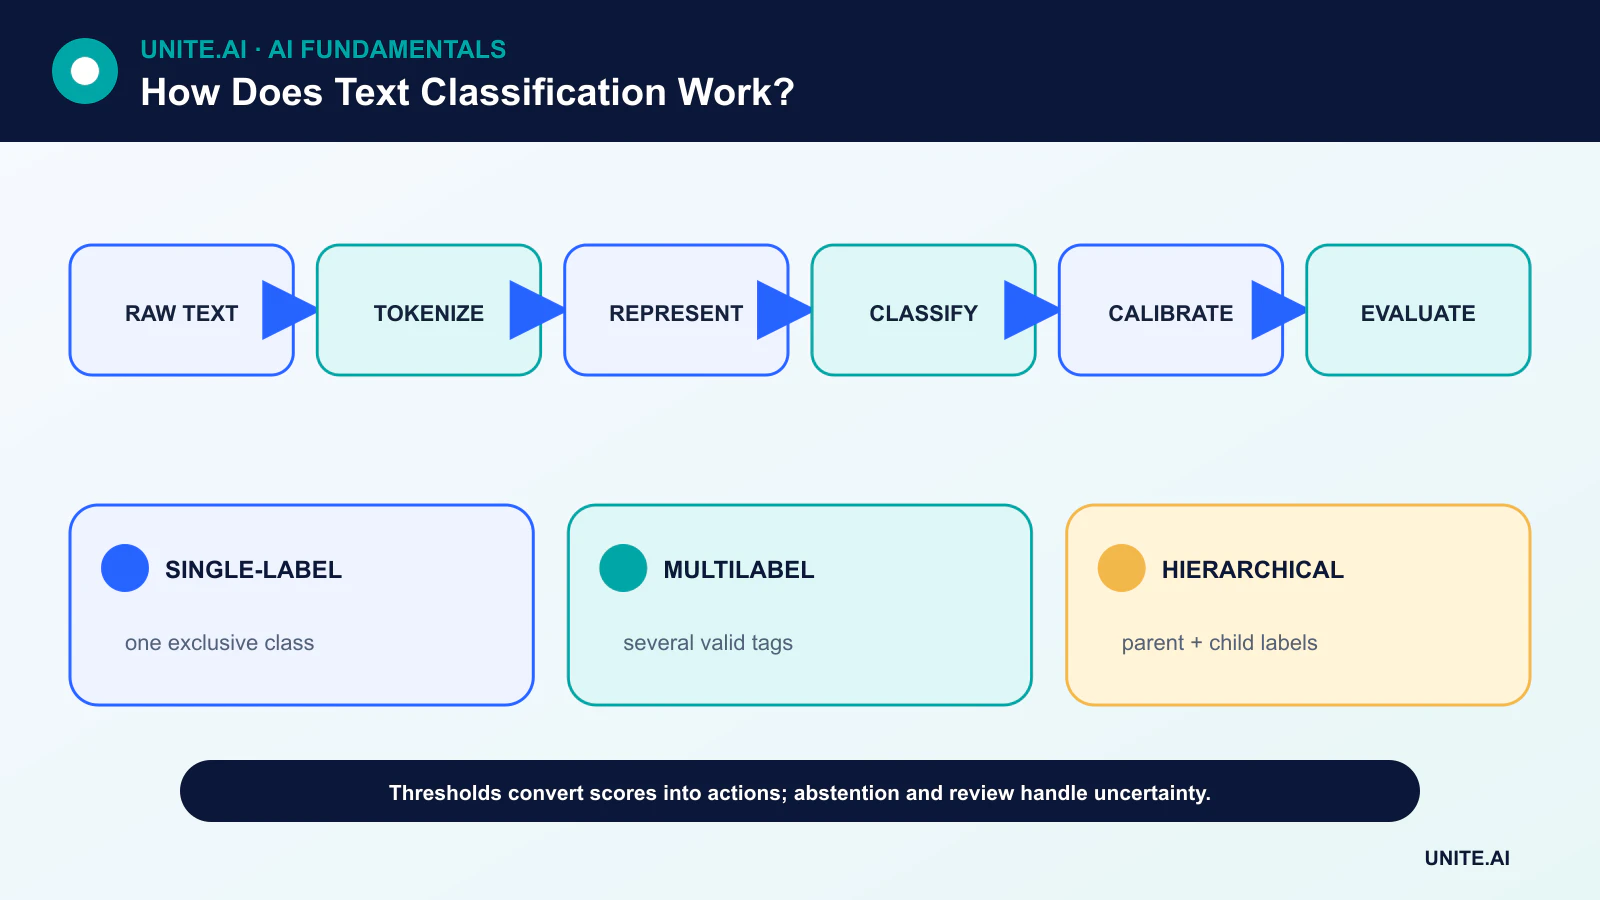
Une tâche à étiquette unique choisit une classe mutuellement exclusive. Une tâche multi‑étiquette peut attribuer plusieurs tags indépendants. Les taxonomies hiérarchiques contiennent des étiquettes parent et enfant. Ce sont des problèmes d’apprentissage différents et nécessitent des sorties et des métriques différentes.
Les annotateurs ont besoin de définitions, d’exemples positifs et négatifs, de règles pour le contexte manquant et d’un chemin d’escalade. Les statistiques d’accord peuvent révéler une tâche peu claire, mais le désaccord peut aussi refléter une ambiguïté réelle que le système doit préserver.
Représenter le texte
Les pipelines traditionnels utilisent le comptage de tokens, les n‑grammes et le TF‑IDF avec des classificateurs linéaires ou machines à vecteurs de support. Ils s’entraînent rapidement, exposent les termes influents et offrent une solide base de référence.
Les systèmes neuronaux transforment les tokens en embeddings. Les encodeurs de transformeurs pré‑entraînés utilisent l’attention pour produire des représentations contextuelles et peuvent être ajustés avec des exemples étiquetés. Les classificateurs sollicités ou zéro‑shot peuvent réduire l’étiquetage initial, mais le libellé des étiquettes, la version du modèle et l’étalonnage doivent être évalués sur le domaine réel.
Entraîner sans fuite
Le jeu de données est séparé en ensembles d’entraînement, de validation et de test final. Les documents quasi‑dupliqués, les messages provenant de la même conversation ou les modèles provenant de la même source doivent rester dans le même découpage. Pour une utilisation dépendante du temps, un découpage chronologique représente mieux le déploiement.
Le déséquilibre des classes peut être traité par pondération, sur‑échantillonnage, sélection de seuil ou données additionnelles. Les exemples synthétiques ne doivent pas remplacer la révision des échecs réels de classes minoritaires et peuvent introduire des artefacts que le modèle apprend trop facilement.
Métriques et décisions calibrées
Une matrice de confusion montre quelles étiquettes sont confondues. La précision mesure combien de positifs prédites sont corrects ; le rappel mesure combien de vrais positifs sont trouvés. Les moyennes macro pondèrent les classes de façon égale, tandis que les moyennes micro pondèrent les exemples individuels.
Un score softmax brut n’est pas automatiquement une probabilité fiable. L’étalonnage compare la confiance avec la justesse observée. Les équipes peuvent définir des seuils spécifiques à chaque classe, s’abstenir lorsque la confiance est faible et orienter les cas sensibles vers un réviseur.
Déploiement, utilisation multilingue et dérive
Le texte évolue avec les produits, les événements, l’argot et les comportements adverses. La surveillance doit suivre la langue d’entrée, la longueur, les motifs hors vocabulaire, les taux de classe, la confiance et les résultats différés. Le ré‑entraînement nécessite des données versionnées et une suite de régression d’exemples importants.
Les performances multilingues doivent être testées par langue et dialecte. Traduire tout en une seule langue peut modifier le sentiment ou les entités ; un encodeur multilingue peut encore présenter des performances inégales parce que son pré‑entraînement et ses étiquettes ne sont pas également représentatifs.
Représentations et familles de classificateurs
La classification de texte associe un document, une phrase ou une séquence de tokens à une ou plusieurs étiquettes. Définissez si les étiquettes sont mutuellement exclusives, multilabel, hiérarchiques, ordonnées ou en ensemble ouvert. Les pipelines traditionnels tokenisent le texte, construisent des caractéristiques sac de mots ou TF–IDF, et entraînent une régression logistique, un naïf Bayes ou un SVM linéaire. Les systèmes neuronaux apprennent des embeddings avec convolution, récurrence ou transformeurs. Les modèles de langage sollicités peuvent classer sans entraînement spécifique à la tâche, mais les contraintes de sortie, le coût, la dérive et les preuves nécessitent encore une évaluation par rapport à des bases plus simples.
Le pré‑traitement dépend de la représentation. Mettre en minuscules ou supprimer la ponctuation peut détruire des signaux pour les noms, le sentiment, le code ou la langue ; le stemming peut fusionner des sens distincts. Les tokenizers de transformeur opèrent sur des sous‑mots et ont des limites de longueur, donc la stratégie de troncature importe. Les longs documents peuvent nécessiter un découpage en morceaux et une agrégation. Conservez le texte brut et la version de transformation, et découpez par auteur, conversation, source ou temps afin d’empêcher les quasi‑doublons et les modèles récurrents de traverser l’entraînement et le test.
Étiquettes, métriques et analyse d’erreurs
Un guide d’annotation doit définir le périmètre, des exemples, les cas ambigus et une option inconnue ou d’abstention. Mesurez l’accord et tranchez les désaccords plutôt que de les masquer avec un vote majoritaire. Pour des classes déséquilibrées, la précision est insuffisante ; rapportez précision, rappel, F1, confusion, étalonnage et charge de travail spécifique au seuil par classe. Les tâches multilabel nécessitent des métriques micro, macro et au niveau de l’étiquette. Évaluez les langues, dialectes, domaines, longueur des messages et le temps. Un découpage aléatoire peut surestimer la qualité lorsque le vocabulaire ou les modèles dérivent.
L’analyse d’erreurs doit séparer l’échec de représentation, le contexte insuffisant, l’ambiguïté d’étiquette, le vocabulaire rare, la négation, le sarcasme et les indices fallacieux. Utilisez des tests contrefactuels qui changent les noms, les marqueurs de dialecte ou les métadonnées non pertinentes tout en conservant le sens. Inspectez les erreurs à haute confiance et les cas rejetés. Un modèle peut apprendre qu’un canal client ou une signature prédit une étiquette plutôt que d’interpréter le contenu. Éliminez les fuites et révisez les données avant d’augmenter simplement la capacité du modèle.
Conception de production
Servez un tokenizer et un modèle fixes avec validation de schéma, limites de longueur, traitement par lots et une solution de secours pour les langues non prises en charge ou la faible confiance. Surveillez la distribution d’entrée, les taux d’étiquettes, l’étalonnage, la latence et les résultats révisés. Protégez le texte car il peut contenir des instructions personnelles, confidentielles ou adverses. Pour la modération automatisée, l’éligibilité ou le routage, fournissez un recours et mesurez les erreurs disparates. Versionnez les étiquettes et les seuils selon la politique d’entreprise. La classification de texte n’est fiable que dans le cadre de son système d’étiquettes défini et de la distribution des données ; des explications de modèle fluides ne prouvent pas qu’une classification est correcte.
Exemple pratique: classification des demandes de support entrantes
Une équipe de support définit des étiquettes de routage mutuellement exclusives ainsi que des indicateurs urgent, multilingue et inconnu. Les annotateurs étiquettent des messages dé‑identifiés avec des consignes pour les problèmes mixtes et mesurent l’accord. Une base logistique TF–IDF, un encodeur finement ajusté et un modèle sollicité utilisent le même jeu de test basé sur le temps. Les rapports d’évaluation indiquent la précision et le rappel par classe, les faux négatifs urgents, l’étalonnage, la validité du schéma, la latence et le coût, avec les modèles quasi‑dupliqués regroupés pour éviter les fuites.
Le classificateur déployé valide la langue et la longueur, s’abstient en cas de preuves faibles, et laisse les agents corriger les itinéraires. Les invites et les messages sont traités comme non fiables ; l’accès aux outils est absent. La surveillance suit la prévalence des étiquettes, la confiance, les corrections, le temps de réponse et les sujets émergents. Un changement de politique ou de produit met à jour la taxonomie et les données de ré‑entraînement via révision. Le système améliore le placement dans la file d’attente, mais il n’infère jamais l’émotion ou le sentiment du client au‑delà des étiquettes validées.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et la conséquence de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le glissement de distribution, les pannes de dépendance, les usages abusifs et les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec l’étalonnage ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et chaque seuil afin qu’un réviseur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité d’entrée, le comportement de sortie, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez des seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage d’incident, de suppression et de rétention, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
L’analyse de sentiment est‑elle une tâche de classification de texte ?
En général oui, mais le sentiment peut être multi‑étiquette, basé sur les aspects ou continu plutôt que d’être limité à une seule étiquette positive/neutre/négative.
Quand un classificateur de texte doit‑il s’abstenir ?
Lorsque la confiance est faible, que le texte est hors du périmètre, que le contexte requis est absent ou que le coût d’une action automatique incorrecte dépasse le coût d’une révision.
Références principales












