
Fondamentaux de l’IA
Qu’est‑ce que les grands modèles de langage (LLM) ?

 Ajouter Unite.AI à vos sources préférées sur Google
Un grand modèle de langage (LLM) est un réseau de neurones entraîné sur de vastes collections de séquences afin de prédire des tokens ou des objectifs linguistiques associés. La plupart des LLM actuels utilisent des architectures de type transformeur et peuvent générer, classer, résumer, traduire, récupérer et transformer le langage via une interface commune.
Un LLM n’est pas une base de données ni un raisonneur garanti. Sa sortie est une prédiction conditionnelle façonnée par les données d’entraînement, le post‑entraînement, le contexte, les outils et le décodage. La fluidité peut coexister avec des erreurs factuelles, de l’incertitude, des biais ou un comportement dangereux.
Points clés
- La tokenisation convertit le texte en unités discrètes ; les embeddings et l’attention construisent des représentations contextuelles.
- Le pré‑entraînement apprend des motifs généraux, tandis que le fine‑tuning et les méthodes de préférence façonnent le comportement pour chaque tâche.
- La récupération et les outils peuvent ajouter des preuves ou des actions actuelles, mais nécessitent des autorisations et une validation séparées.
- Évaluez le système déployé en termes de qualité, d’ancrage, de sécurité, de latence, de coût et de dérive.
Tokens, transformateurs et pré‑entraînement
Le texte est découpé en tokens. Un transformeur les projette en vecteurs, mélange l’information via les mécanismes d’attention et les couches feed‑forward, et produit une distribution de probabilité sur le token suivant ou manquant.
Les objectifs auto‑supervisés génèrent des signaux d’entraînement à partir de séquences brutes. L’augmentation du nombre de paramètres, des données et de la puissance de calcul peut réduire la perte de façon prévisible sur des intervalles, mais la qualité du jeu de données, l’architecture, l’optimisation et l’évaluation déterminent les capacités qui émergent en pratique.
Post‑entraînement et inférence
Le réglage par instructions utilise des démonstrations ; l’optimisation des préférences peut rendre les sorties plus conformes aux jugements humains ou à une politique. En inférence, une invite et l’historique de la conversation définissent le contexte, tandis que la température et les paramètres d’échantillonnage influencent la variabilité.
RLHF et des méthodes similaires façonnent le comportement plutôt que d’instaurer un vérificateur de faits complet. Le modèle peut néanmoins générer une réponse plausible mais non étayée.
Récupération, outils et agents
La génération augmentée par récupération fournit des passages sélectionnés dans une collection externe. L’appel d’outils permet au code applicatif d’interroger des bases de données, de calculer, de rechercher ou d’agir. Ces schémas séparent une partie des connaissances et de l’exécution des poids du modèle.
L’application doit valider les arguments des outils, appliquer les autorisations, conserver les citations et considérer le contenu récupéré comme une entrée non fiable. La recherche de similarité vectorielle facilite la récupération mais ne prouve pas qu’un passage soutient la réponse.
Limites et évaluation
Les LLM peuvent halluciner, exposer du contenu mémorisé, suivre des instructions malveillantes, reproduire des biais et échouer sur des tâches qui semblent similaires aux exemples d’entraînement. Un long contexte ne garantit pas que chaque fait soit utilisé ou concilié correctement.
Évaluez sur des tâches privées représentatives avec des invites et des versions documentées. Mesurez le soutien par les sources, les refus, la calibration, la sécurité, les résultats par sous‑groupe, la charge de travail humaine, la latence et le coût. Surveillez après le déploiement, car les modèles, les données et le comportement des utilisateurs évoluent.
Données d’entraînement et développement du modèle
Les corpus de pré‑entraînement combinent des pages Web, des livres, du code, du matériel académique, des conversations et des sources sous licence ou sélectionnées. Les pipelines détectent la langue, éliminent les doublons, filtrent la qualité et le contenu dangereux, gèrent les données personnelles et choisissent les poids de mélange. Ces décisions façonnent les connaissances, la couverture linguistique, le style, les biais et la mémorisation.
Les processus d’optimisation traitent des lots de séquences de tokens et minimisent la perte de prédiction par descente de gradient. L’entraînement distribué répartit les données, les tenseurs du modèle, les étapes du pipeline ou les experts sur plusieurs accélérateurs. La gestion des points de contrôle, la stabilité numérique, la communication réseau et la récupération des pannes deviennent des enjeux majeurs à grande échelle.
L’évaluation pendant l’entraînement suit la perte et les suites de capacités, mais la contamination des benchmarks peut gonfler les résultats. Réservez des périodes temporelles et des tâches propriétaires, recherchez les recoupements, et rapportez les invites exactes, le décodage, les outils et le scoring. Un modèle peut améliorer la perte moyenne tandis que des régressions apparaissent en matière de sécurité ou pour une langue à faibles ressources.
Fenêtres de contexte, décodage et inférence
En inférence, le cache clé‑valeur conserve les projections d’attention des tokens précédents afin qu’elles n’aient pas à être recomptées à chaque étape. La mémoire du cache augmente avec le nombre de couches, la longueur de la séquence, la taille du lot et la représentation. La quantification et le paging réduisent la pression mais peuvent modifier la qualité ou la latence.
Le décodage glouton sélectionne le token à la probabilité la plus élevée ; la température re‑échelle les probabilités ; top‑k et top‑p restreignent l’ensemble des candidats ; la recherche en faisceau suit plusieurs séquences. La meilleure stratégie dépend de la priorité de la tâche entre déterminisme, diversité, sortie structurée ou vraisemblance de la séquence. Validez toujours le schéma après la génération.
Un long contexte augmente la quantité d’informations disponibles, mais ne garantit pas le rappel ou le raisonnement. La position, les distracteurs, les contradictions et la structure de l’invite influencent l’utilisation. La récupération peut sélectionner un jeu de preuves plus restreint, tandis que le résumé compresse l’historique au risque de perdre des détails. Mesurez les performances selon la longueur et la localisation du contexte.
Adaptation, déploiement et aspects économiques
Le fine‑tuning complet met à jour tous les paramètres ; les méthodes à efficacité paramétrique mettent à jour des adaptateurs ou des matrices de faible rang ; le pré‑entraînement continu adapte la distribution du domaine ; le réglage par instruction et par préférence façonne les réponses. La récupération est souvent préférable pour des faits qui évoluent fréquemment, tandis que le réglage l’est davantage pour le comportement et le format des tâches. Les méthodes peuvent être combinées.
Les options de déploiement comprennent les API hébergées, les points de terminaison gérés, les poids ouverts auto‑hébergés, les modèles embarqués sur l’appareil et les solutions hybrides. Comparez la gestion des données, le contrôle de version, la latence, le débit, les régions, la disponibilité, la portabilité du modèle, le support et le coût total. L’auto‑hébergement transfère la responsabilité de la sécurité, de la montée en charge, des mises à jour et de la surveillance des abus.
Le coût par token est incomplet. Un modèle faible peut nécessiter des nouvelles tentatives, des invites plus longues, davantage de vérifications ou engendrer des erreurs coûteuses. Mesurez le coût par tâche correctement accomplie selon le niveau de qualité et de risque requis. Utilisez la mise en cache, le traitement par lots, des modèles plus petits et le code déterministe lorsqu’ils améliorent le flux de travail complet.
Exemple pratique : ancrer un LLM dans des documents d’entreprise
Un assistant documentaire doit commencer avec un corpus conscient des autorisations, des identifiants de documents stables, des dates de version et d’entrée en vigueur, une structure analysable, ainsi qu’un jeu d’évaluation contenant des questions répondables, non répondables, ambiguës et conflictuelles. Les index de récupération découpent le texte en fragments et métadonnées, mais la taille des fragments et le chevauchement doivent correspondre à la structure du document. La qualité de la recherche est mesurée indépendamment avant la génération afin qu’un modèle fluide ne puisse pas masquer des preuves manquantes.
En temps réel, authentifiez l’utilisateur, filtrez la récupération selon les droits d’accès, récupérez et re‑classez les preuves, construisez une invite bornée, générez une réponse citée et validez la sortie requise. Le modèle doit indiquer quand les sources sont en conflit ou ne soutiennent pas une réponse. L’utilisation d’outils et d’actions externes nécessite une autorisation distincte. Protégez‑vous contre les instructions intégrées dans les documents récupérés en traitant le contenu comme des données plutôt que comme une politique système prioritaire.
Évaluez le rappel de la récupération, la précision des citations, la justesse des réponses, l’ancrage, les refus, la latence et le coût selon les rôles et les types de documents. Suivez les versions du modèle, de l’invite, de l’index, du parseur et du corpus pour chaque test. En production, consignez les identifiants des preuves et les retours sans exposer le texte privé, surveillez les nouvelles questions non répondables après des changements de contenu, et maintenez une solution de secours sécurisée. Une interface LLM ne remplace pas la gestion des dossiers, le contrôle d’accès ou la révision responsable par des experts.
La planification de capacité doit modéliser les distributions de longueur des invites et des sorties, le nombre d’utilisateurs simultanés, le comportement du cache, la latence des outils et les taux de nouvelles tentatives. Le streaming améliore la latence perçue mais complique la modération et l’annulation, car un contenu dangereux ou incorrect peut atteindre l’utilisateur avant que la réponse complète ne soit vérifiée. Définissez des budgets de tokens et d’outils, isolez les locataires, protégez les identifiants du fournisseur et entraînez le basculement entre versions de modèle sans modifier silencieusement le comportement dont les utilisateurs dépendent.
Checklist de mise en œuvre pratique
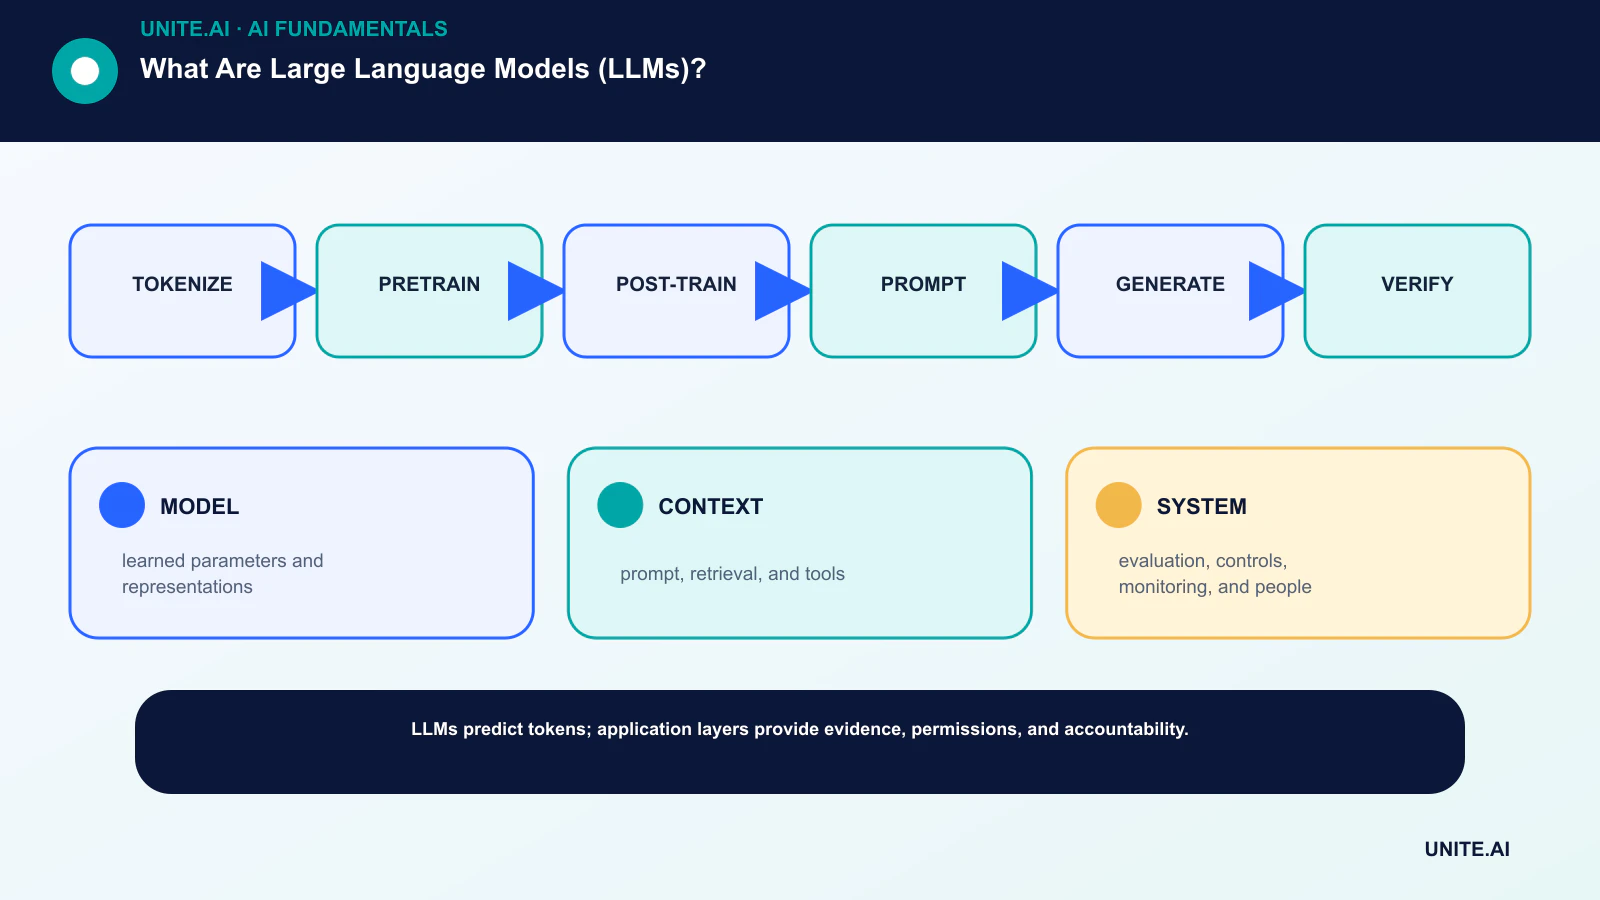
Transformez le concept en un flux de travail borné et testable : tokeniser → pré‑entraîner → post‑entraîner → inviter → générer → vérifier. Désignez un responsable imputable, documentez les données et les dépendances, établissez une base simple, définissez les critères d’acceptation et d’arrêt, testez des échecs représentatifs, et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui conçoivent, exploitent, sécurisent et sont impactées par le système. Testez les cas normaux, les conditions limites, les défaillances de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la mise en production, modifier un seuil, annuler une sortie ou interrompre le fonctionnement. Reconsidérez la décision après l’arrivée de données réelles, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- MODÈLE: paramètres et représentations appris.
- CONTEXTE: invite, récupération et outils.
- SYSTÈME: évaluation, contrôles, surveillance et personnes.
Foire aux questions
Pourquoi les LLM sont‑ils appelés grands ?
Il n’existe pas de seuil de paramètres universel. « Grand » fait référence à une échelle relative aux modèles de langage antérieurs, incluant le nombre de paramètres, les données d’entraînement, la puissance de calcul et l’étendue d’utilisation.
Les LLM comprennent‑ils le langage ?
Ils construisent des représentations internes utiles et affichent un comportement complexe, mais le terme « comprendre » possède plusieurs sens. La performance doit être démontrée tâche par tâche plutôt qu’inférée à partir de la fluidité.
Références principales












