
Fondamentaux de l’IA
Qu’est‑ce que l’IA générative ?

 Ajouter Unite.AI à vos sources préférées sur Google
IA générative désigne les modèles qui apprennent les motifs présents dans les données et produisent de nouveaux textes, images, audio, vidéo, code ou autres représentations lorsqu’ils sont conditionnés par des instructions ou des exemples. La sortie est synthétisée à partir d’un modèle probabiliste ; elle n’est pas récupérée telle quelle depuis une base de données, bien que des outils de récupération puissent fournir des preuves externes.
Les différentes familles de modèles génèrent de manières distinctes. Les transformeurs autoregressifs prédisent une séquence un jeton à la fois, les modèles de diffusion débruitent itérativement un échantillon, et les réseaux antagonistes génératifs (GAN) apprennent par le biais d’un concours entre un générateur et un discriminateur.
Points clés
- La génération est un échantillonnage conditionnel à partir d’une distribution apprise, sans garantie de rappel factuel.
- Les transformeurs, les modèles de diffusion, les GAN et les auto‑encodeurs variationnels impliquent des compromis différents.
- La récupération et les outils peuvent ancrer un système, mais leurs sorties et autorisations nécessitent toujours une validation.
- La gestion des risques couvre les données, le modèle, l’interface, le déploiement, la surveillance et la provenance du contenu.
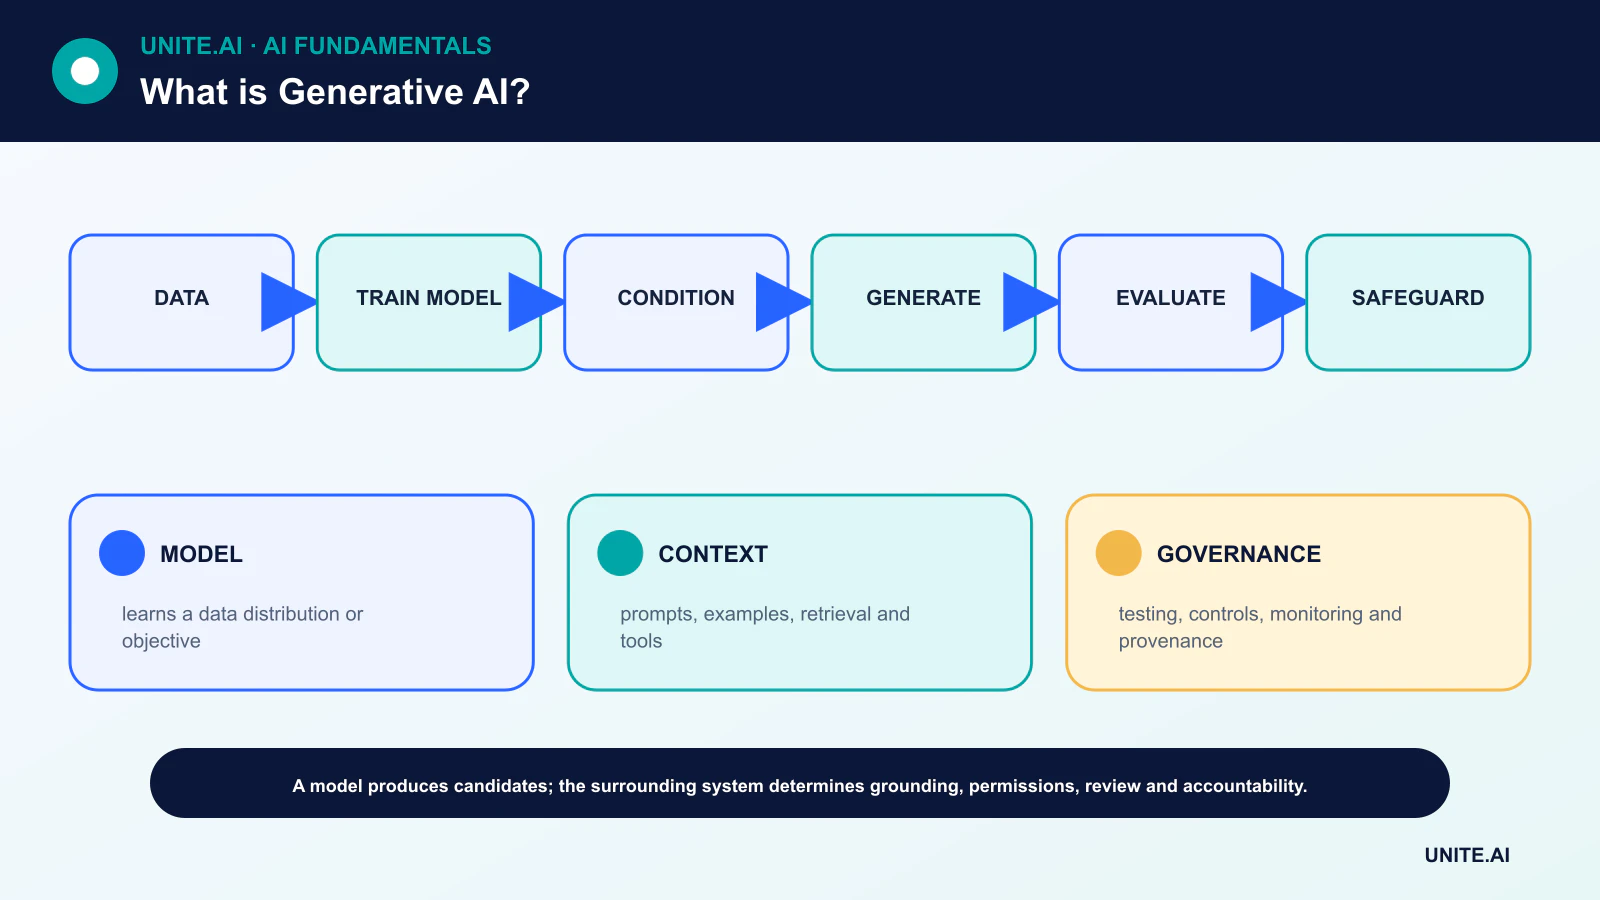
Comment les modèles génératifs apprennent
Les objectifs d’entraînement récompensent un modèle pour la prédiction ou la reconstruction des motifs présents dans les exemples. Un modèle de langage estime le prochain jeton ; un modèle de diffusion apprend à inverser un processus de bruit ; un auto‑encodeur variationnel apprend une distribution latente structurée et un décodeur.
Cet entraînement crée une généralisation statistique, mais il peut également reproduire des biais, mémoriser des séquences rares ou échouer en dehors de la distribution des données. La documentation des jeux de données, la déduplication, les contrôles de confidentialité et l’évaluation sur des jeux de test sont donc essentiels avant le déploiement.
Principales familles d’architectures
Les transformeurs autoregressifs dominent le texte et prennent en charge les séquences multimodales. Les modèles de diffusion sont largement utilisés pour la génération d’images et d’audio haute fidélité. Les GAN peuvent créer des échantillons nets et des systèmes d’image contrôlables, mais ils peuvent être difficiles à entraîner.
Les auto‑encodeurs variationnels offrent une modélisation à variables latentes et des représentations efficaces, servant parfois au sein de pipelines génératifs plus vastes. Les produits réels combinent souvent plusieurs modèles avec récupération, filtres, outils et code déterministe.
Conditionnement, échantillonnage et contrôle
Une invite, une étiquette de classe, une image, un extrait audio ou un enregistrement structuré peuvent conditionner la génération. Les paramètres d’échantillonnage modifient la diversité et le déterminisme. Une température plus basse peut concentrer les probabilités des jetons, mais elle ne rend pas une réponse incorrecte vraie.
Le contrôle s’améliore lorsque le système utilise des schémas explicites, un décodage contraint, du matériel de référence et une validation. L’ingénierie des invites modifie le contexte ; le réglage fin change les paramètres ; la récupération fournit des informations externes. Chaque approche traite un mode d’échec différent.
L’évaluation dépend de l’application
Les systèmes textuels peuvent nécessiter des tests de factualité, d’accomplissement de tâche, de support de citation, de toxicité et de calibration. Les systèmes d’image ou d’audio peuvent nécessiter la fidélité, l’alignement sémantique, la diversité, la sécurité d’identité et une révision perceptuelle. Associez les métriques automatisées à une évaluation humaine représentative.
Construisez un jeu d’évaluation versionné incluant des cas ordinaires, rares, adversaires et pertinents pour la politique. Suivez la latence, le coût et le comportement de refus ainsi que la qualité des sorties. Une démonstration choisie par son créateur n’est pas une preuve de fiabilité à l’échelle de la population.
Risques, mesures de protection et provenance
Les risques importants comprennent les hallucinations, l’injection d’invites, le contenu nocif, l’usurpation d’identité, l’utilisation d’outils non sécurisés, les fuites de confidentialité, les litiges de droits d’auteur, le biais d’automatisation et les chaînes d’approvisionnement opaques. Le Profil d’IA générative du NIST organise les actions à travers la gouvernance, la provenance du contenu, les tests pré‑déploiement et la divulgation d’incidents.
Utilisez des outils au moindre privilège, des contrôles d’entrée/sortie, une révision humaine pour les décisions conséquentes, la journalisation, le retour en arrière et le signalement par les utilisateurs. Les filigranes ou les justificatifs de contenu peuvent ajouter des signaux, mais aucun détecteur ou étiquette unique n’établit la vérité. Le flux de travail plus large des médias synthétiques doit préserver le contexte et la responsabilité.
Familles de modèles et mécanismes de génération
Les modèles d’IA générative estiment ou apprennent un processus capable de produire de nouveaux textes, images, audio, vidéo, code ou données structurées. Les modèles autoregressifs prédisent le prochain jeton ou élément ; les modèles de diffusion apprennent à inverser un processus de bruit ; les auto‑encodeurs variationnels apprennent des variables latentes probabilistes ; les GAN entraînent un générateur contre un discriminateur. Les systèmes multimodaux relient les représentations entre les médias. La sortie est échantillonnée à partir de la structure statistique apprise, conditionnée par des invites, du contexte, des outils ou d’autres entrées — elle n’est pas récupérée comme un fait garanti.
Les modèles de fondation sont pré‑entraînés sur de vastes ensembles de données et adaptés via l’invocation, la récupération, le réglage fin, l’optimisation des préférences, les réseaux de contrôle ou des têtes spécifiques à une tâche. Les tokeniseurs, encodeurs, décodeurs, espaces latents et paramètres d’échantillonnage façonnent les résultats. La température et le filtrage des candidats équilibrent déterminisme et diversité. Des invites plus longues fournissent du contexte mais peuvent entrer en conflit, distraire ou contenir des instructions malveillantes. La récupération peut ancrer des connaissances évolutives, tandis que le code déterministe doit gérer les calculs exacts et les règles.
Évaluation, provenance et droits
Évaluez par tâche : exactitude factuelle et citation pour les réponses, exécution et sécurité pour le code, fidélité et diversité pour les médias, et résultat humain pour l’assistance créative. Incluez les refus, la calibration, la latence, le coût, les langues, l’accessibilité et les tests adversaires. Une sortie fluide ou photoréaliste peut être erronée. Conservez le modèle, l’invite, la graine, les preuves sources, les appels d’outil et le post‑traitement pour la reproductibilité. Séparez la qualité de la récupération de la génération afin qu’une réponse polie ne puisse masquer l’absence de preuves.
L’entraînement et les sorties soulèvent des questions de droits d’auteur, de licence, de consentement, de confidentialité, de publicité et de secret. Établissez la provenance et l’usage autorisé des données d’entrée ; empêchez les utilisateurs de divulguer des secrets ; testez la mémorisation ; et fournissez des processus de signalement et de suppression. Les médias synthétiques doivent porter une provenance durable ou une divulgation lorsque cela est possible, surtout lorsqu’ils peuvent être pris pour des preuves. N’utilisez pas l’apparence, la voix ou le style d’une manière qui viole les droits ou trompe.
Contrôles de déploiement
Considérez la sortie du modèle comme une entrée non fiable. Validez les schémas, désinfectez le code et les fichiers, isolez l’exécution, autorisez chaque outil de façon externe, limitez le coût et le débit, et exigez une confirmation pour les actions conséquentes. Surveillez les échecs, les abus, la dérive et les corrections des utilisateurs, avec retour en arrière et solution de secours non générative. Documentez les usages prévus et interdits. L’IA générative étend l’interface de création et de transformation de l’information, mais la fiabilité et la responsabilité proviennent des données environnantes, de l’évaluation, de la sécurité, de la provenance et du processus de décision humaine.
Exemple pratique : un assistant génératif de description de produit
Un détaillant autorise les rédacteurs à générer des brouillons de descriptions uniquement à partir des attributs de produit approuvés et des directives de la marque. L’invite comprend des faits structurés, tandis que la récupération fournit la politique actuelle. La sortie doit respecter un schéma et est validée par rapport aux valeurs sources ; les dimensions non prises en charge, les allégations de sécurité ou les certifications entraînent un rejet. L’évaluation couvre la précision factuelle, le style, la duplication, la qualité multilingue, l’accessibilité, la latence et la correction par l’éditeur, comparées aux modèles et à la rédaction manuelle.
Les rédacteurs approuvent chaque publication et peuvent voir les champs sources. Le modèle n’a aucune capacité à modifier le prix, le stock ou à publier directement. Les invites et les données produit sont protégées contre les injections, et les notes confidentielles des fournisseurs sont exclues. La surveillance suit les allégations non prises en charge, les modifications, les plaintes, le coût et les versions du fournisseur. Le texte généré est stocké avec sa provenance. Le système économise du temps de rédaction uniquement si les corrections et la révision n’annulent pas le bénéfice et que la vérité du produit reste régie par des données autoritaires.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le changement de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Consignez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés, sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Questions fréquentes
L’IA générative est‑elle la même chose qu’un grand modèle de langage ?
Non. Les LLM sont une classe de modèle génératif. L’IA générative comprend également les systèmes d’image, d’audio, de vidéo et de données structurées construits avec plusieurs architectures.
Un modèle copie‑t‑il ses données d’entraînement ?
Il synthétise généralement à partir de motifs appris, mais la mémorisation et la quasi‑duplication peuvent se produire. Les risques de confidentialité et de provenance doivent être évalués plutôt que supposés inexistants.
Références principales












