Fondamentaux de l’IA
Qu’est‑ce que l’apprentissage par renforcement profond ?

 Ajouter Unite.AI à vos sources préférées sur Google
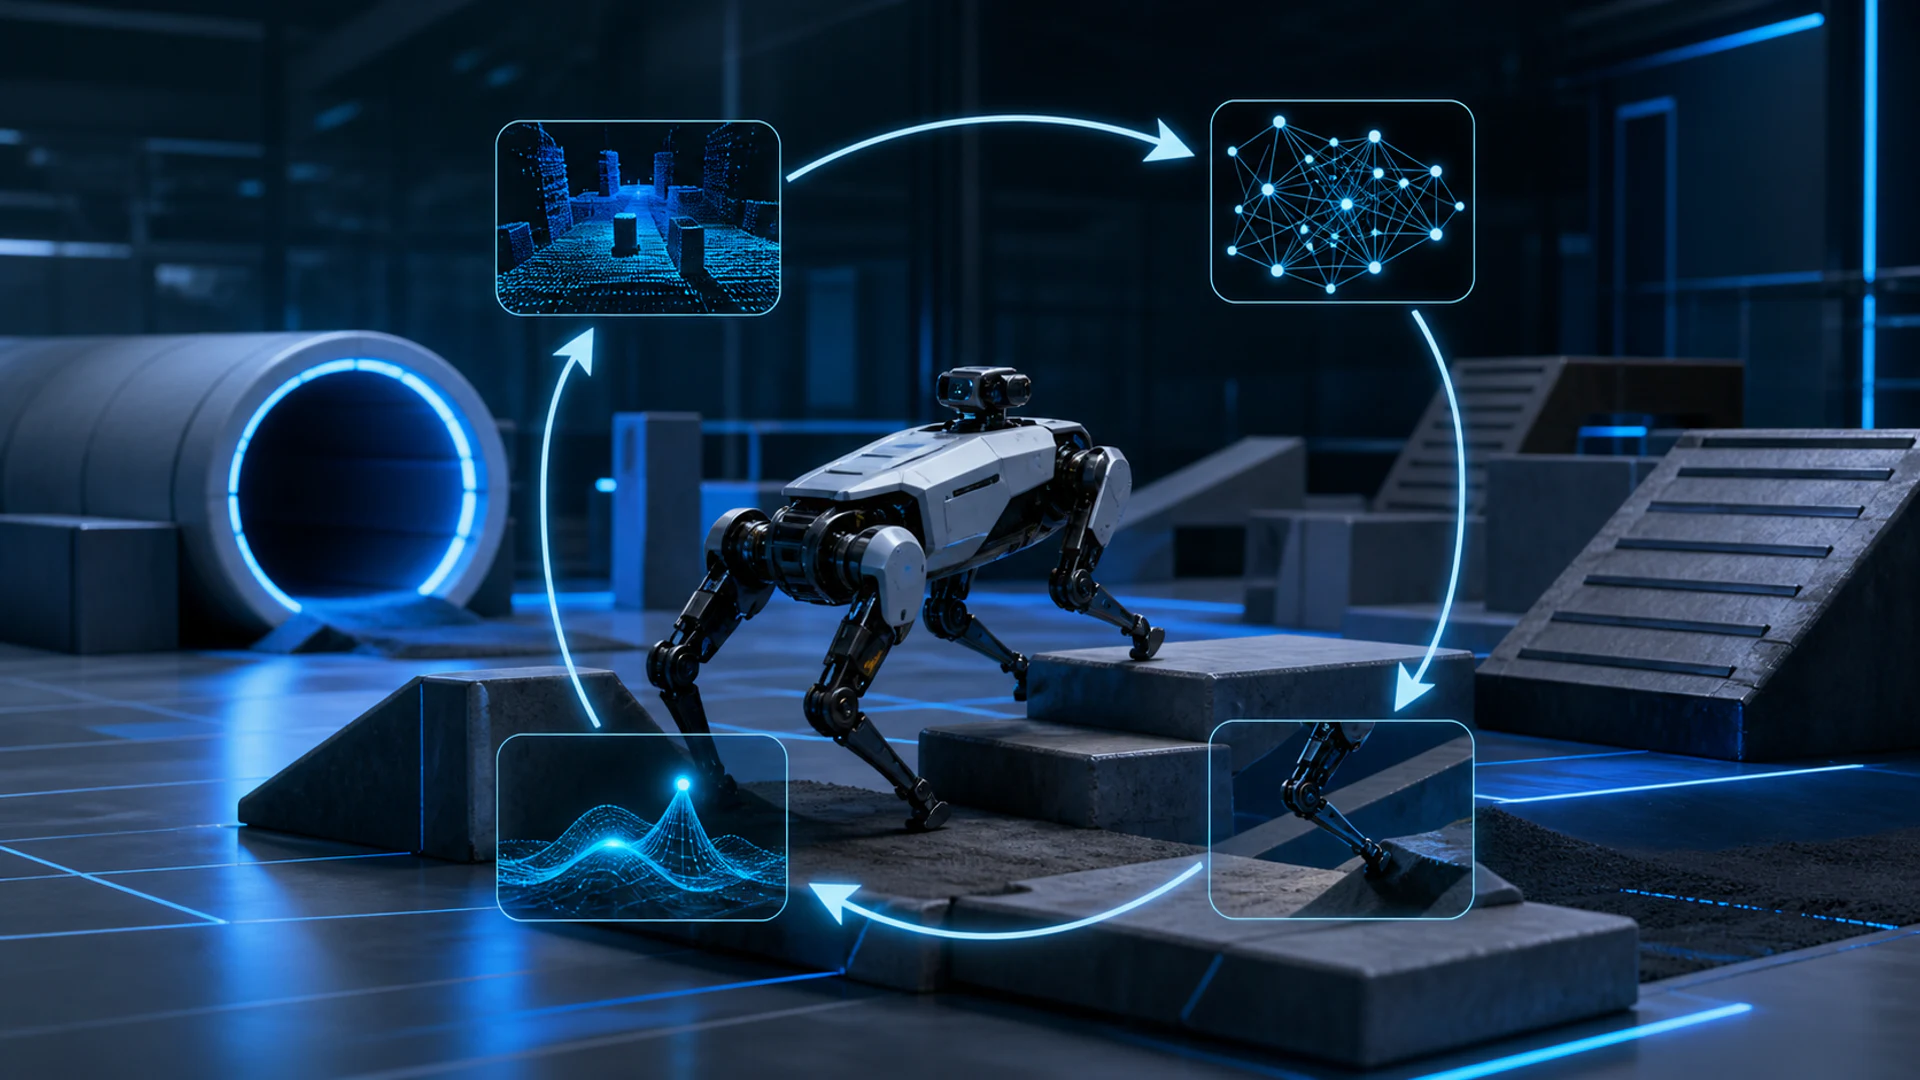
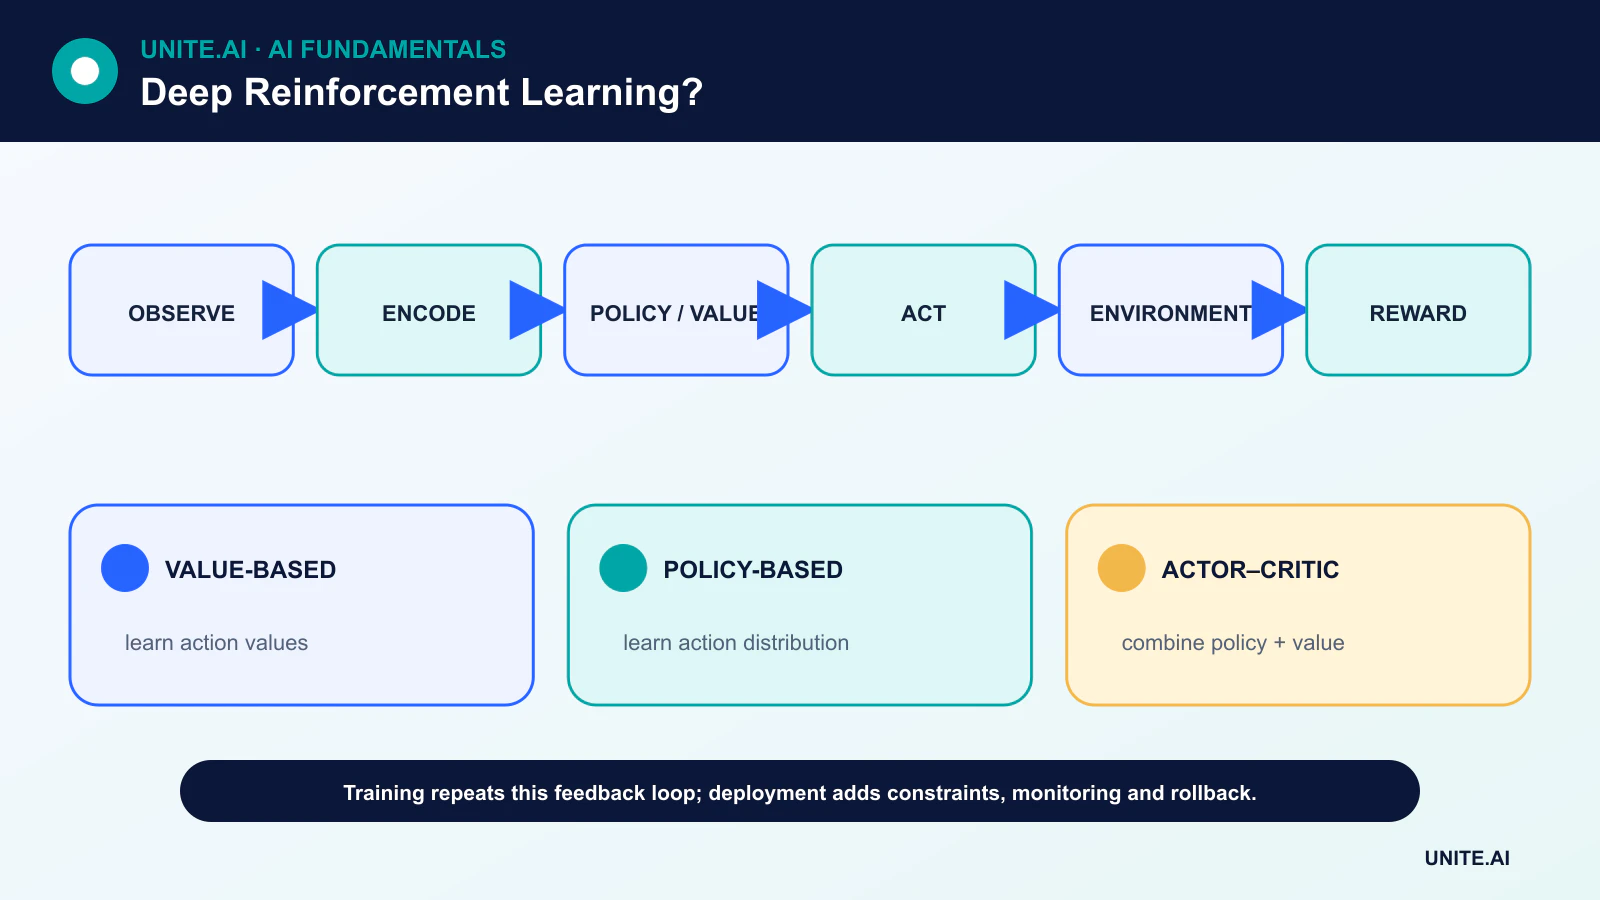
Apprentissage par renforcement profond (deep RL) combine l’apprentissage par renforcement avec des réseaux neuronaux profonds. Un agent observe un état, choisit une action, reçoit une récompense et une nouvelle observation, puis ajuste une politique ou une fonction de valeur afin d’améliorer les décisions futures.
Le réseau profond n’élimine pas les aspects difficiles de l’apprentissage par renforcement. Il offre une manière flexible de représenter des images, des flux de capteurs, de grands espaces d’actions ou des fonctions de valeur complexes. L’exploration, le crédit différé, l’entraînement instable et l’évaluation sûre dans le monde réel restent des problèmes d’ingénierie centraux.
Points clés
- L’apprentissage par renforcement profond apprend des décisions séquentielles à partir d’interactions plutôt qu’à partir d’une table fixe d’exemples étiquetés.
- Les méthodes basées sur la valeur estiment la qualité des actions ; les méthodes de politique apprennent directement la distribution des actions ; les méthodes acteur‑critique combinent les deux.
- Les tampons de relecture, les réseaux cibles et une conception soigneuse des récompenses peuvent améliorer l’entraînement, mais aucun ne garantit un comportement fiable.
- Un bon score dans le simulateur n’est pas une preuve de robustesse, de sécurité ou de transfert réussi vers le monde physique.
Le problème de décision: états, actions et récompenses
De nombreuses tâches d’apprentissage par renforcement profond sont modélisées comme un processus de décision de Markov. Au temps t, l’agent reçoit un état ou une observation st, sélectionne une action at, puis reçoit la récompense rt+1 et l’état suivant. L’objectif est le retour attendu actualisé, pas nécessairement la récompense immédiate seule.
Le facteur d’actualisation contrôle l’importance accordée aux récompenses lointaines. Une fonction de récompense définit ce que le processus d’optimisation cherchera à maximiser, de sorte qu’un proxy incomplet peut engendrer un comportement techniquement réussi mais opérationnellement indésirable. C’est une des raisons pour lesquelles la conception des récompenses et les tests de contraintes méritent la même attention que l’architecture du modèle.
Méthodes basées sur la valeur, basées sur la politique et acteur‑critique
Un algorithme basé sur la valeur estime une valeur d’état ou une valeur d’action. Les réseaux Q profonds (Deep Q‑networks) utilisent un réseau neuronal pour approximer les valeurs Q et choisissent généralement l’action avec l’estimation la plus élevée tout en conservant une certaine exploration. Un algorithme de gradient de politique, quant à lui, optimise une politique paramétrée qui produit une distribution d’actions.
Les systèmes acteur‑critique conservent à la fois un acteur, qui propose des actions, et un critique, qui estime leur valeur. Cette conception prend en charge le contrôle continu mais introduit des sources d’erreur d’estimation interagissantes. L’apprentissage par renforcement profond dépend donc des mêmes fondements que l’apprentissage profond, la descente de gradient et la rétropropagation.
Pourquoi les tampons de relecture et les réseaux cibles aident
Les échantillons d’expérience successifs sont corrélés, tandis qu’une mise à jour du réseau modifie les cibles utilisées par les mises à jour ultérieures. La relecture d’expérience rompt une partie de cette corrélation temporelle en échantillonnant des transitions plus anciennes. Un réseau cible évolue plus lentement que le réseau en ligne, rendant les cibles bootstrappées moins volatiles.
Ces mécanismes améliorent la stabilité de l’entraînement, mais le réglage reste crucial. Le taux d’apprentissage, le planning d’exploration, l’échelle des récompenses, la composition du tampon de relecture et la capacité du réseau peuvent tous influencer le résultat. Plusieurs graines aléatoires doivent être rapportées, car une exécution unique peut être trompeuse.
Apprentissage par renforcement hors‑ligne, basé sur le modèle et sim‑to‑real
L’apprentissage par renforcement hors‑ligne apprend à partir d’un jeu de données journalisé fixe sans collecter de nouvelles interactions. Il peut être utile lorsque l’exploration est coûteuse ou dangereuse, mais la politique doit éviter les actions mal représentées dans le journal. L’apprentissage par renforcement basé sur le modèle apprend ou utilise un modèle de transition pour planifier, échangeant des hypothèses supplémentaires contre une meilleure efficacité d’échantillonnage.
En robotique, on entraîne souvent en simulation, on randomise les paramètres physiques, puis on affine ou valide sur du matériel réel. L’écart entre simulation et réalité peut encore révéler des erreurs de perception, de synchronisation, de dynamique de contact et des cas limites non modélisés. Un apprentissage par renforcement doit être évalué sous perturbations, décalage de distribution et contraintes de sécurité explicites.
Évaluation et déploiement
Une évaluation pertinente sépare les environnements d’entraînement et de test, rapporte les distributions de retour plutôt que seulement le meilleur score, et vérifie les violations de contraintes, la fréquence d’intervention et le comportement dans le pire des cas. Pour les systèmes réels, les équipes ont également besoin de surveillance, de procédures de retour en arrière, d’espaces d’actions bornés et d’une possibilité d’intervention humaine.
L’apprentissage par renforcement profond est le plus convaincant lorsque les décisions sont séquentielles, que le retour d’information est disponible et que les règles de contrôle écrites à la main sont insuffisantes. C’est un mauvais choix par défaut lorsque les étiquettes supervisées sont abondantes, qu’un optimiseur conventionnel résout le problème, ou que l’exploration mettrait en danger des personnes ou des actifs.
Architectures de deep RL et signaux d’entraînement
L’apprentissage par renforcement profond utilise des réseaux neuronaux pour représenter une fonction de valeur, une politique, un modèle d’environnement, ou une combinaison de ceux‑ci. Un réseau Q profond prédit les valeurs d’actions et apprend à partir de cibles de différence temporelle ; la relecture d’expérience réduit la corrélation entre les mises à jour, tandis qu’un réseau cible stabilise l’objectif mouvant. Les méthodes de gradient de politique optimisent directement le retour attendu, et les méthodes acteur‑critique utilisent un critique appris pour réduire la variance du gradient. Les actions continues nécessitent souvent des variantes acteur‑critique déterministes ou stochastiques, tandis que les actions discrètes de haute dimension exigent une exploration soigneuse et une conception de sortie adaptée.
L’entraînement est non stationnaire parce que la politique modifie les données qu’elle collecte. Les données de relecture deviennent hors‑politique, les cibles bootstrappées dépendent des estimations courantes, et l’approximation fonctionnelle peut amplifier les erreurs — une combinaison parfois appelée la « triade mortelle ». Les estimateurs doubles réduisent la surestimation des valeurs ; les fonctions d’avantage améliorent l’attribution du crédit ; les bonus d’entropie encouragent l’exploration ; les objectifs tronqués limitent les mises à jour destructrices de la politique. Normalisez les observations et les récompenses uniquement avec un état sûr contre les fuites, et consignez l’environnement, le wrapper, la répétition d’actions, la terminaison et le pré‑traitement des récompenses, car chacun modifie le problème.
Évaluation, simulateurs et sécurité du déploiement
Rapportez les distributions de retour sur plusieurs graines indépendantes et instances d’environnement, pas seulement le meilleur essai. Évaluez l’efficacité d’échantillonnage, les violations de contraintes, les issues catastrophiques, la sensibilité à l’échelle des récompenses et la robustesse au bruit d’observation, aux délais, aux erreurs d’actionneur et aux dynamiques modifiées. Comparez avec le contrôle scripté, le contrôle classique, l’imitation supervisée et les RL plus simples. Réservez des variations d’environnement et testez des métriques de résultat sans récompense, car un agent peut exploiter la récompense programmée tout en échouant à la tâche prévue. L’inspection vidéo et de trajectoires révèle souvent des comportements cachés par le retour agrégé.
La simulation permet l’exploration mais introduit un écart avec la réalité. Randomisez les physiques et la perception pertinentes, calibrez par rapport aux mesures réelles, et utilisez un transfert conservateur. Les données journalisées ou le RL hors‑ligne évitent l’exploration en ligne mais ne peuvent pas évaluer de façon fiable les actions non soutenues par la politique de comportement. Les systèmes de production doivent contraindre l’ensemble d’actions, le taux, les ressources et l’enveloppe opérationnelle ; exiger une approbation pour les actions à fort impact ; et inclure un contrôleur sûr vérifié ou un arrêt. Surveillez les entrées de la politique, la distribution des actions, la récompense, les résultats réels et les interventions, avec un retour en arrière vers une version de politique testée.
Exemple concret de contrôle
Pour le routage de robots d’entrepôt, définissez l’état à partir de la localisation, de la charge, de la batterie, du trafic à proximité et de la file d’attente des tâches ; les actions à partir des déplacements autorisés et des décisions de charge ; et la récompense à partir du travail accompli, de l’énergie, de la congestion et des contraintes de sécurité. Entraînez d’abord dans un simulateur calibré avec une demande aléatoire et des pannes de capteurs, puis superposez les décisions réelles. Ne laissez jamais la politique apprise contourner l’évitement des collisions. Évaluez le débit conjointement aux quasi‑accidents, aux blocages, aux urgences de batterie et aux retards dans le pire des cas. Le projet ne réussit que si le système en couches améliore les opérations sans transférer un risque d’exploration inacceptable aux personnes ou aux équipements.
Exemple pratique: DRL pour le refroidissement des centres de données
Un centre de données contraint un agent d’apprentissage par renforcement à des points de consigne de refroidissement approuvés et l’entraîne dans un simulateur calibré à partir des données historiques de météo, de charge de travail, de températures et de réponse de l’équipement. La récompense inclut l’énergie, mais des contraintes strictes protègent séparément la température, l’humidité et le cycle de l’équipement. Le contrôle prédictif basé sur le modèle et les règles existantes servent de références. L’évaluation couvre les saisons, le bruit des capteurs, le délai des actionneurs, les pannes d’équipement, les charges inhabituelles et plusieurs graines, en rapportant l’énergie, les violations, la variance et la récupération.
La politique apprise fonctionne en mode ombre avant un essai dans une zone limitée. Un contrôleur de sécurité externe tronque les actions et les opérateurs peuvent intervenir. Le taux d’action, la couverture d’état, l’incertitude du modèle et les résultats réels de l’installation sont surveillés ; un décalage du simulateur ou des interventions répétées déclenchent un retour en arrière. Un équipement ou une logique de contrôle mis à jour crée une nouvelle version d’environnement et une validation. Les économies d’énergie ne sont acceptées que lorsque la fiabilité, la marge thermique, la maintenance et la réponse aux pannes restent au moins aussi solides que la référence.
Preuves d’implémentation et disponibilité opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le décalage de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement à la calibration ou à l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un plan de secours sûr et vérifiez la surveillance avec des pannes intentionnellement injectées. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
L’apprentissage par renforcement profond est‑il identique à l’apprentissage profond ?
Non. L’apprentissage profond fournit les approximateurs de fonction ; l’apprentissage par renforcement fournit l’interaction, la récompense et l’objectif de décision séquentielle.
Un haut niveau de récompense signifie‑t‑il que l’agent a appris le comportement prévu ?
Pas nécessairement. Cela signifie que la politique a trouvé un comportement qui obtient un bon score selon la récompense et l’environnement implémentés. Des tests indépendants de sécurité et d’alignement sur les objectifs restent nécessaires.
Références principales