Fondamentaux de l’IA
Qu’est‑ce que le théorème de Bayes ?

 Ajouter Unite.AI à vos sources préférées sur Google
Le théorème de Bayes décrit comment mettre à jour la probabilité d’une hypothèse après avoir observé des preuves. Il relie la probabilité d’une preuve donnée une hypothèse à la probabilité de l’hypothèse donnée cette preuve.
Cette distinction est centrale dans le raisonnement statistique et l’apprentissage automatique. Un test peut être très précis lorsqu’une condition est présente, alors qu’un résultat positif a encore une probabilité modeste d’indiquer la condition si celle‑ci est rare.
Points clés
- Le postérieur combine une croyance a priori avec la vraisemblance des preuves observées.
- Le terme de preuve normalise les hypothèses possibles.
- Les taux de base peuvent dominer des preuves apparemment fortes.
- Le Naïve Bayes suppose que les caractéristiques sont conditionnellement indépendantes étant donné la classe, et non indépendantes dans toutes les circonstances.
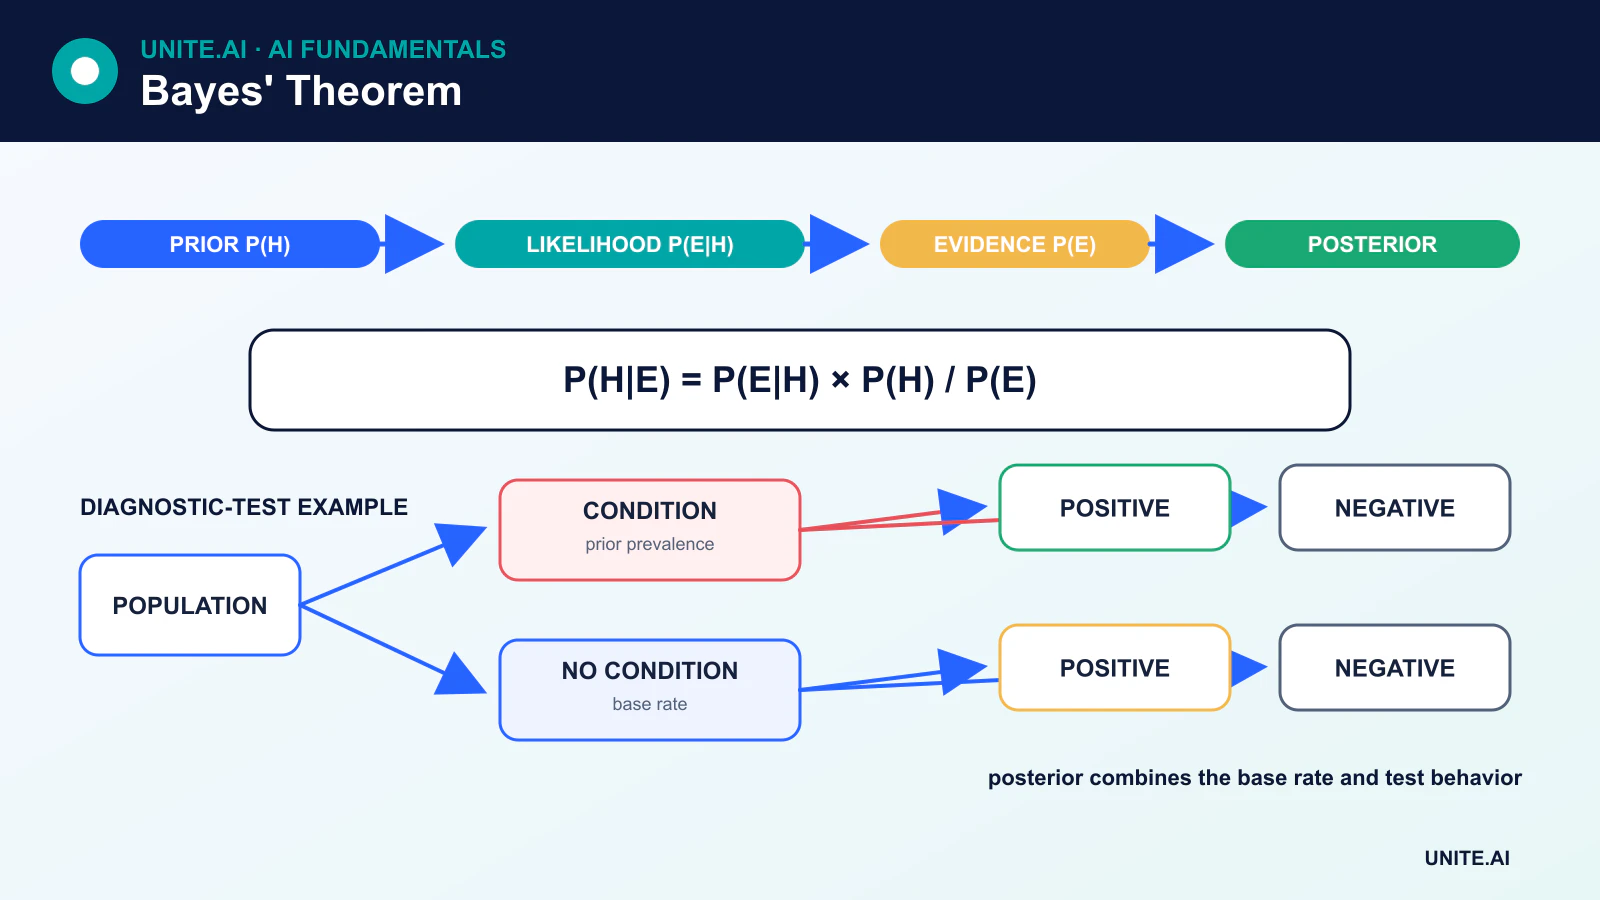
La formule
P(A|B) = P(B|A)P(A) / P(B)
- P(A) est la probabilité a priori de l’hypothèse A.
- P(B|A) est la vraisemblance d’observer la preuve B si A est vrai.
- P(B) est la probabilité globale de la preuve.
- P(A|B) est la probabilité a posteriori de A après avoir observé B.
Le théorème découle de deux expressions équivalentes de la probabilité conjointe : P(A ∩ B) = P(B|A)P(A) et P(A ∩ B) = P(A|B)P(B).
Exemple numérique d’un taux de base
Supposons qu’une condition affecte 1 % d’une population. Un test a une sensibilité de 90 % et un taux de faux‑positifs de 5 %. Considérons 1 000 personnes :
- Environ 10 sont atteints de la condition ; le test signale correctement 9.
- Environ 990 ne le sont pas ; un taux de faux‑positifs de 5 % signale environ 50 personnes.
- Il y a donc environ 59 résultats positifs, dont 9 sont de vrais positifs.
La probabilité de la condition après un résultat positif est d’environ 9 / 59 ≈ 15 %, et non 90 %. La sensibilité du test répond à P(positif | condition) ; l’utilisateur veut généralement P(condition | positif). Le théorème de Bayes les relie en utilisant le taux de base.
Mise à jour bayésienne
À mesure que de nouvelles preuves arrivent, un a posteriori peut devenir le a priori pour la mise à jour suivante. Un modèle bayésien complet spécifie les hypothèses possibles, les distributions a priori, une vraisemblance et la quantité à inférer. L’incertitude est représentée par une distribution a posteriori plutôt que par une simple estimation ponctuelle.
Le a priori doit être documenté et testé pour sa sensibilité. Un a priori faiblement informatif peut régulariser des valeurs peu plausibles, tandis qu’un a priori fortement choisi de manière inadéquate peut dominer des données limitées.
Classifieurs Naïve Bayes
Le Naïve Bayes prédit une classe y à partir des caractéristiques x₁ … xₙ en utilisant le théorème de Bayes et l’hypothèse :
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
On suppose que les caractéristiques sont conditionnellement indépendantes une fois la classe connue. Cela est souvent irréaliste, mais le classifieur peut bien fonctionner lorsque les scores de classe obtenus restent utiles.
Variantes courantes
- Multinomial Naive Bayes modélise des caractéristiques de type comptage et est couramment utilisé en classification de documents.
- Bernoulli Naive Bayes modélise la présence binaire d’une caractéristique.
- Gaussian Naive Bayes modélise chaque caractéristique continue avec une distribution gaussienne conditionnelle à la classe.
- Categorical Naive Bayes modélise des catégories discrètes.
Lissage et stabilité numérique
Si une valeur de caractéristique n’apparaît jamais avec une classe lors de l’entraînement, une estimation de probabilité non lissée peut devenir zéro et éliminer tout le produit. Un lissage additif ou de type Laplace empêche cela. Les implémentations calculent les probabilités logarithmiques de sorte que la multiplication de nombreuses petites valeurs se transforme en addition de valeurs logarithmiques stables.
Probabilités, scores et calibration
Les sorties de probabilité du Naïve Bayes peuvent être mal calibrées parce que les caractéristiques corrélées sont effectivement comptées plusieurs fois. Un classifieur peut bien classer les catégories tout en surestimant la confiance. La calibration doit être évaluée sur des données de validation lorsque les probabilités guident les décisions.
Bayes au‑delà du Naïve Bayes
L’inférence bayésienne prend en charge les modèles hiérarchiques, les tests A/B, l’estimation de paramètres scientifiques, les prévisions, la prise de décision consciente de l’incertitude et les modèles graphiques probabilistes. Des méthodes approximatives telles que les chaînes de Markov Monte Carlo et l’inférence variationnelle sont utilisées lorsqu’un a posteriori ne peut être calculé sous forme close.
Erreurs de raisonnement courantes
- Confondre P(A|B) avec P(B|A).
- Ignorer un taux de base rare ou commun.
- Considérer un a priori comme objectif ou le laisser non documenté.
- Supposer qu’une forte vraisemblance implique automatiquement un a posteriori élevé.
- Interpréter une association prédictive comme une causalité.
Probabilité conditionnelle, cotes et preuves
Le théorème de Bayes relie la probabilité d’une hypothèse après des preuves à sa probabilité a priori, à la vraisemblance d’observer ces preuves sous l’hypothèse, et à la probabilité totale des preuves. Sous forme de cotes, les cotes a posteriori égalent les cotes a priori multipliées par un rapport de vraisemblance. Cela sépare ce qui était cru avant le test de la force avec laquelle le test distingue les hypothèses. Un test qui semble très précis peut néanmoins produire de nombreux faux positifs lorsque la condition est rare, car le taux de base intervient dans le a posteriori.
La vraisemblance est une fonction de l’hypothèse pour des données observées fixes et ne doit pas être confondue avec la probabilité de l’hypothèse. La normalisation des preuves consiste à sommer ou intégrer sur les hypothèses concurrentes. Les hypothèses d’indépendance conditionnelle peuvent simplifier le calcul, comme dans le Naïve Bayes, mais doivent être vérifiées quant à leurs conséquences. Plusieurs éléments de preuve ne peuvent pas être multipliés comme indépendants lorsqu’ils partagent des causes ou dupliquent des informations. La direction causale importe également : P(preuve|hypothèse) n’est généralement pas P(hypothèse|preuve), l’erreur classique de probabilité inverse.
Choix de modélisation, calcul et utilisation décisionnelle
L’analyse bayésienne spécifie un a priori, une vraisemblance et une distribution prédictive a posteriori. Les a priori peuvent encoder des connaissances établies, régulariser de petits échantillons ou être faiblement informatifs ; ils doivent être justifiés et testés par une analyse de sensibilité. Les modèles conjugués offrent des mises à jour analytiques, tandis que les chaînes de Markov Monte Carlo, l’inférence variationnelle et les méthodes séquentielles approximent des a posteriori complexes. On doit diagnostiquer la convergence, la taille d’échantillon effective, l’erreur d’approximation et la plausibilité prédictive du a priori plutôt que de rapporter un nombre a posteriori sans vérifications de calcul.
Une probabilité a posteriori informe mais ne choisit pas à elle seule une action. Les décisions nécessitent des pertes, des bénéfices, des contraintes et des alternatives disponibles. Évaluez les modèles probabilistes avec la calibration, des règles de score appropriées et des vérifications prédictives a posteriori sur de nouvelles données. Mettez à jour uniquement avec des preuves collectées dans le cadre d’un processus modélisé ; le biais de sélection et le déplacement du jeu de données peuvent invalider la vraisemblance. Communiquez les intervalles crédibles et les hypothèses sans les présenter comme des intervalles de fréquence garantis. Le théorème de Bayes est une algèbre de probabilité exacte, tandis que la qualité d’une conclusion bayésienne dépend du modèle et des preuves fournies.
Exemple pratique : interprétation d’un test diagnostique
Un test a une sensibilité de 95 % et une spécificité de 90 %, mais la condition ne touche que 1 % de la population dépistée. Pour 10 000 personnes, on s’attend à environ 95 vrais positifs et 990 faux positifs, ce qui donne une valeur prédictive positive inférieure à 9 %. Le théorème de Bayes rend explicite l’effet du taux de base. Le calcul indique la population, le seuil du test et l’incertitude plutôt que de présenter la sensibilité comme la probabilité qu’un résultat positif soit correct. Cette distinction est également fondamentale pour une science des données rigoureuse.
Les cliniciens mettent à jour la probabilité avec des preuves supplémentaires uniquement lorsque la dépendance entre les tests est modélisée. Un seuil décisionnel intègre le préjudice d’une maladie manquée, le risque du test de confirmation, le coût et la préférence du patient. La calibration est vérifiée dans la population locale, et les changements de prévalence déclenchent une révision. Le a posteriori soutient la discussion et les étapes suivantes ; il ne remplace pas le diagnostic de confirmation. Le rapport utilise des fréquences naturelles et une analyse de sensibilité afin que les patients et les praticiens puissent voir comment la conclusion évolue sous des hypothèses plausibles.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un ensemble d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le changement de distribution, les pannes de dépendance, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et chaque seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sécurisé et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, un apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Quelle est la différence entre une vraisemblance et une probabilité ?
Lorsque les paramètres sont fixes, un modèle attribue une probabilité aux données possibles. Lorsque les données observées sont fixes, la même expression peut être vue comme une fonction de vraisemblance sur les valeurs de paramètres possibles. La formule numérique peut être identique tandis que l’interprétation diffère.
Le Naïve Bayes constitue‑t‑il une inférence bayésienne complète ?
Il utilise le théorème de Bayes pour la classification sous un modèle d’indépendance conditionnelle forte. L’inférence bayésienne plus large place des distributions sur les quantités inconnues et raisonne avec une distribution a posteriori.
Références principales