
Fondamentaux de l’IA
Qu’est‑ce qu’une NPU ? Unités de traitement neuronal expliquées

 Ajouter Unite.AI à vos sources préférées sur Google
Une unité de traitement neuronal (NPU) est un accélérateur spécialisé conçu pour exécuter efficacement les opérations courantes de réseaux neuronaux. Dans les téléphones, les PC, les véhicules, les caméras et les systèmes embarqués, elle peut exécuter les charges de travail d’IA prises en charge avec moins d’énergie ou libérer le CPU et le GPU pour d’autres tâches.
NPU est un terme industriel large plutôt qu’une architecture universelle. Les performances dépendent des opérateurs pris en charge, des formats numériques, de la mémoire, du compilateur et du runtime, des limites thermiques, et de la proportion d’une application qui peut rester sur l’accélérateur.
Points clés
- Les NPU privilégient les opérations matricielles, vectorielles et tensorielles avec une forte réutilisation des données et une faible consommation d’énergie.
- Le TOPS maximal n’est pas un benchmark d’application de bout en bout et peut supposer une précision ou une parcimonie spécifiques.
- Un modèle peut nécessiter une conversion, une quantification, un partitionnement du graphe et un repli pour les opérations non prises en charge.
- Comparez la latence, le débit, l’énergie, la mémoire, la qualité, la confidentialité et la portabilité sur la charge de travail réelle.
Rôles du CPU, du GPU et de la NPU
Les CPU excellent dans le contrôle de flux général et offrent une large compatibilité. Les GPU offrent un débit parallèle programmable et un vaste écosystème logiciel. Les NPU se spécialisent dans les opérations tensorielles répétées et peuvent inclure une mémoire locale, des réseaux de multiplication‑accumulation et un flux de données optimisé pour l’inférence.
Les systèmes hétérogènes planifient les différentes parties là où elles sont les plus appropriées. Cela importe pour l’edge AI, où la puissance soutenue et la réactivité peuvent être plus importantes que le débit maximal d’un centre de données.
Compilation et exécution du modèle
Un graphe de framework est converti en une représentation intermédiaire, optimisé, quantifié le cas échéant, puis compilé pour les opérateurs pris en charge. Le runtime peut partitionner le graphe afin que les couches non prises en charge s’exécutent sur le CPU ou le GPU.
Les transferts entre processeurs peuvent annuler les gains de l’accélérateur. Les formes statiques, la disposition, la précision, le batch et la réutilisation de la mémoire influencent les performances. Testez l’artifact compilé car la qualité du modèle deep‑learning peut changer après conversion.
Comprendre les revendications TOPS et d’efficacité
Le TOPS indique des billions d’opérations par seconde sous des hypothèses définies. Les fournisseurs peuvent compter séparément les multiplications et les additions, utiliser une précision entière à faible nombre de bits, ou supposer de la parcimonie. Un nombre plus élevé ne garantit pas une latence plus faible pour un modèle donné.
Mesurez le démarrage à froid et à chaud, la latence par requête, le débit, l’énergie, la mémoire maximale, le throttling thermique, le contexte ou la taille d’image pris en charge, et la fraction du graphe accélérée. Utilisez une précision et des versions logicielles équivalentes.
Compromis de l’IA embarquée
L’exécution locale peut réduire la dépendance au réseau et garder les données brutes sur l’appareil, mais les modèles téléchargés, les journaux, les sauvegardes et les repli cloud génèrent toujours des flux de données. La livraison sécurisée des modèles et les mises à jour de la plateforme restent nécessaires.
Les NPU peuvent prendre en charge les applications de vision, d’audio, de langage et de capteurs, y compris les charges de travail adjacentes à TinyML. Les développeurs doivent concevoir un repli élégant et communiquer lorsque le traitement quitte l’appareil.
Architecture NPU et opérations prises en charge
Une NPU accélère les opérations tensorielles en utilisant des réseaux d’unités de multiplication‑accumulation, une mémoire locale, une planification du flux de données et des formats numériques spécialisés. Garder les poids et les activations proches du calcul réduit les déplacements de données coûteux. Les appareils réels diffèrent par le support des opérateurs, la hiérarchie mémoire, la précision, la parcimonie, la programmabilité et la façon dont le travail est partagé avec le CPU et le GPU.
Les performances maximales sont souvent annoncées en TOPS, mais le TOPS ne précise pas la précision, l’utilisation, les limites de mémoire, la couverture des opérateurs ou la latence de bout en bout. Deux processeurs affichant le même chiffre peuvent se comporter différemment sur le même modèle. Évaluez le modèle compilé, des tailles de lot et de séquence réalistes, le pré‑traitement, les transferts et le mode d’alimentation.
Les NPU sont efficaces pour les charges de travail neuronales prises en charge telles que la vision, la parole, le dé‑bruitage, les effets d’arrière‑plan et les modèles linguistiques compacts. Les opérateurs non pris en charge peuvent rebasculer vers le CPU ou le GPU, créant des transferts et une latence imprévisible. Examinez les rapports du compilateur et les traces du runtime pour confirmer le placement plutôt que de supposer que le graphe entier utilise l’accélérateur.
Conversion du modèle, quantification et déploiement
Le déploiement passe généralement d’un framework d’entraînement à travers l’exportation, l’optimisation du graphe, la quantification, la compilation par le fournisseur et l’intégration au runtime. Les formes statiques et les opérateurs courants sont les plus faciles à accélérer. Les flux de contrôle dynamiques, les noyaux personnalisés, les gros tenseurs intermédiaires et les normalisations ou schémas d’attention non pris en charge peuvent nécessiter des modifications du graphe ou une exécution hybride.
Les formats entiers et à moindre précision réduisent la taille du modèle, la bande passante, l’énergie et la latence, mais les données de calibration doivent représenter les entrées réelles. Comparez la quantification post‑entraînement avec la quantification consciente de l’entraînement lorsque la qualité est sensible. Évaluez le comportement par classe et dans les pires cas, car la précision moyenne peut masquer une dégradation dans des cas rares ou critiques pour la sécurité.
L’inférence embarquée améliore la latence, le fonctionnement hors ligne et la confidentialité en limitant les transferts de données, mais l’appareil a toujours besoin de modèles sécurisés, d’un accès aux données conforme aux autorisations et de mécanismes de mise à jour. Protégez les fichiers de modèle le cas échéant, signez les mises à jour, divulguez le repli cloud et assurez‑vous que la télémétrie ne réintroduise pas l’exposition à la vie privée que l’architecture locale était censée réduire.
Évaluation des performances et compromis au niveau du système
Mesurez la latence au démarrage à froid et en régime permanent, le débit, l’énergie par inférence, la mémoire, le comportement thermique, la précision et l’impact sur la batterie. Les tests longs révèlent le throttling que les benchmarks courts ne détectent pas. Incluez le pré‑traitement et le post‑traitement car le redimensionnement, la tokenisation, le décodage ou les copies de données peuvent dominer un accélérateur autrement rapide.
La planification est un problème système. Le CPU gère la logique de l’application, le GPU peut rendre ou exécuter des couches non prises en charge, et la NPU exécute les graphes compatibles. Les charges de travail concurrentes de caméra, d’audio, d’affichage et d’IA se disputent la bande passante mémoire et l’alimentation. Testez le scénario utilisateur complet plutôt qu’un modèle isolé dans un outil fournisseur.
La portabilité reste limitée entre les compilateurs et les runtimes. Privilégiez les représentations de modèle standard lorsqu’elles fonctionnent, isolez le code propriétaire derrière des interfaces, conservez les sorties de référence et maintenez la couverture de test des appareils. Choisissez le matériel en fonction des charges de travail validées, du support logiciel, de l’horizon de mise à jour et du coût total du système — pas d’une seule spécification d’accélérateur.
Exemple pratique: déploiement d’un modèle de vision sur un ordinateur portable NPU
Une équipe entraîne un modèle de segmentation pour les effets d’arrière‑plan, l’exporte vers un format d’échange pris en charge, remplace les opérateurs non supportés et calibre la quantification entière avec des caméras, un éclairage, des tons de peau, des vêtements et des arrière‑plans représentatifs. Le compilateur du fournisseur indique quels nœuds s’exécutent sur la NPU et lesquels reviennent en fallback. L’équipe considère chaque repli comme un coût système, car les transferts de tenseurs peuvent dominer un noyau individuel rapide.
Le benchmarking mesure le pré‑traitement de la caméra, l’exécution du modèle, le compositing, la mémoire, le démarrage à froid, la latence en régime permanent, la stabilité des images, la consommation et le throttling thermique lors d’un appel vidéo réel. Les résultats sont comparés aux voies CPU et GPU avec une qualité de sortie équivalente. L’application utilise la détection de capacités et un repli testé plutôt que de supposer que l’accélérateur existe ou supporte le même graphe après une mise à jour du pilote.
Les tests de version couvrent les modèles d’appareils, les versions du système d’exploitation et des pilotes, les charges de travail concurrentes, les modes batterie et les entrées malformées. Les paquets de modèle sont signés et versionnés ; la télémétrie enregistre les performances et les échecs sans collecter de vidéo inutile. Le produit indique quand le traitement reste sur l’appareil et quand les fonctionnalités cloud sont utilisées. La NPU gagne sa place en améliorant l’expérience complète sous des contraintes réalistes, et non en obtenant un benchmark TOPS ou noyau isolé.
Checklist de mise en œuvre pratique
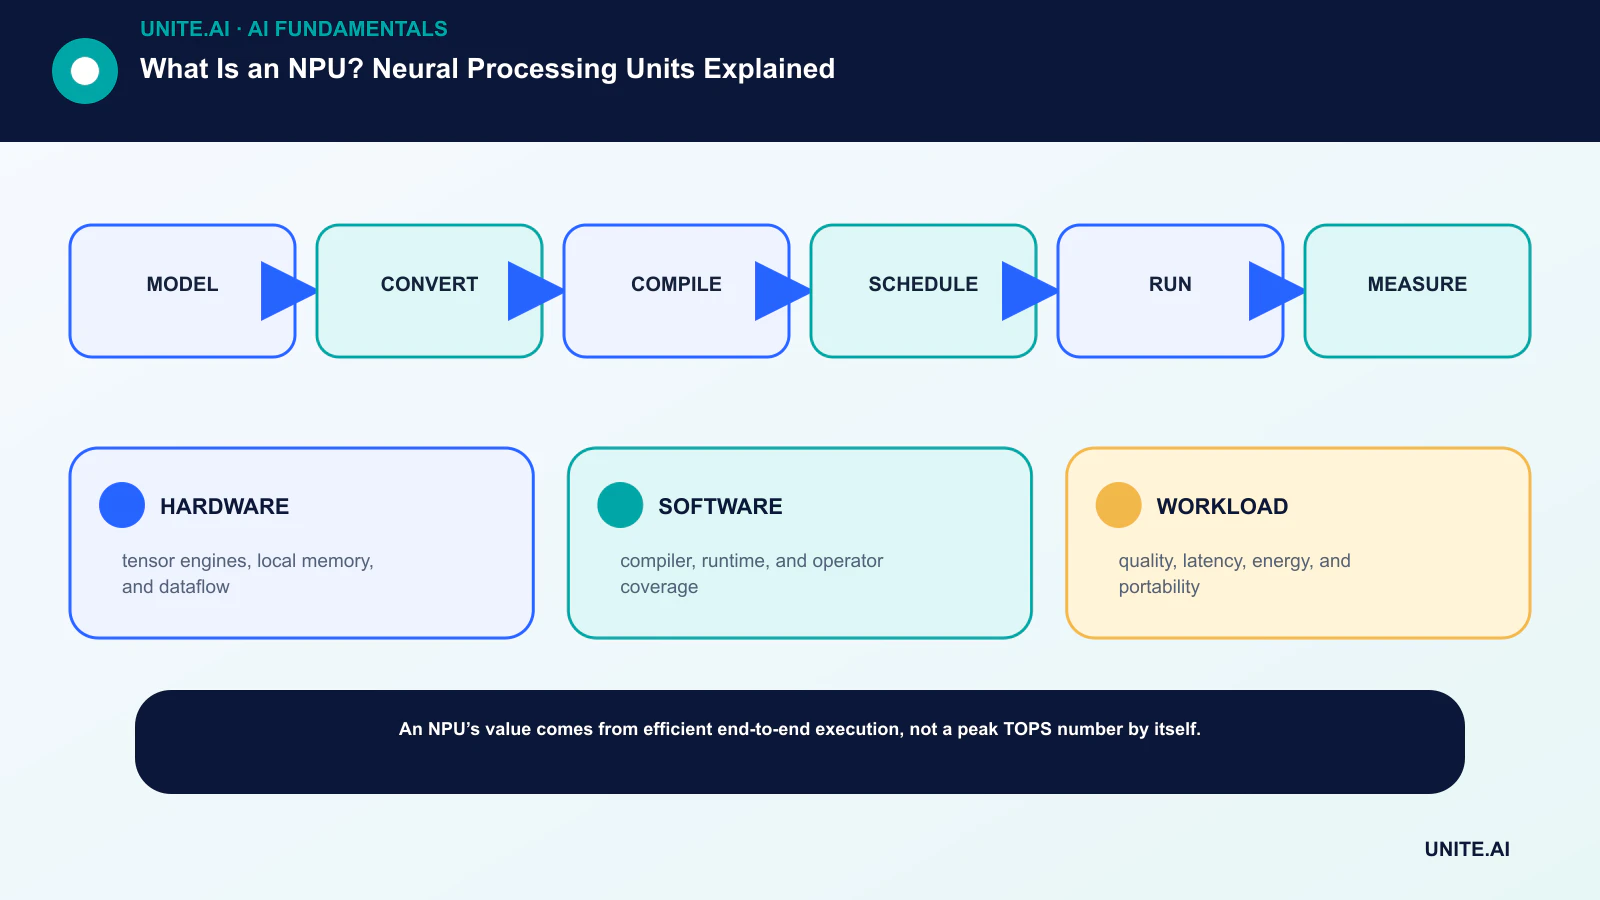
Transformez le concept en un flux de travail limité et testable: modèle → conversion → compilation → planification → exécution → mesure. Désignez un responsable, documentez les données et les dépendances, établissez une base simple, définissez les critères d’acceptation et d’arrêt, testez des échecs représentatifs, et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les pannes de dépendances et les mauvais usages ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la version, modifier un seuil, annuler une sortie ou arrêter l’opération. Reconsidérez la décision après l’arrivée de données réelles, car un pilote techniquement réussi ne garantit pas des performances fiables à plus grande échelle.
- HARDWARE: moteurs de tenseurs, mémoire locale et flux de données.
- SOFTWARE: compilateur, runtime et couverture des opérateurs.
- WORKLOAD: qualité, latence, énergie et portabilité.
Foire aux questions
Une NPU est‑elle plus rapide qu’un GPU ?
Cela dépend du modèle, de la précision, du support des opérateurs, de la taille du lot, de la limite de puissance et du logiciel. Une NPU peut être plus efficace pour une charge de travail embarquée prise en charge, tandis qu’un GPU est plus rapide ou plus flexible ailleurs.
Une NPU conserve‑t‑elle toutes les données d’IA privées ?
Non. Elle permet un traitement local, mais l’application peut encore envoyer des données ou des sorties vers des services cloud. La confidentialité dépend de l’architecture complète et de la politique.
Références principales












