
Fondamentaux de l’IA
Qu’est-ce que l’interprétabilité mécaniste ? Comment les chercheurs analysent les modèles d’IA

 Ajouter Unite.AI à vos sources préférées sur Google
L’interprétabilité mécaniste étudie comment les composants appris à l’intérieur d’un réseau de neurones produisent causalement un comportement. Au lieu de simplement corréler les entrées aux sorties, les chercheurs formulent des hypothèses sur les caractéristiques, les têtes d’attention, les neurones et les circuits, puis interviennent pour tester ces hypothèses.
Le domaine a produit des explications détaillées pour certains comportements dans des modèles petits et moyens, mais un compte rendu complet et fidèle d’un modèle de pointe reste hors de portée. Les explications automatisées et les visualisations attrayantes peuvent constituer des points de départ utiles, mais pas une preuve.
Points clés
- Les caractéristiques sont des motifs représentés ; les circuits sont des composants interactifs proposés pour implémenter un calcul.
- Le patching d’activation, l’ablation et le traçage causal testent si un composant modifie un comportement.
- La superposition signifie qu’un neurone peut participer à de nombreuses caractéristiques ; les auto‑encodeurs parcimonieux tentent une base de caractéristiques différente.
- Les méthodes d’interprétabilité nécessitent une vérité de référence, des tests falsifiables, une couverture et une évaluation face à des explications alternatives.
De la représentation au mécanisme
Le probing interroge la possibilité de décoder l’information à partir d’une activation. L’attribution estime quels entrées ou composants sont pertinents. Le travail mécaniste va plus loin en proposant un calcul interne et en vérifiant si les interventions modifient le comportement intermédiaire et final attendu.
Cela le rend apparenté, mais plus restreint que l’intelligence artificielle explicable. Une explication post‑hoc d’une décision n’est pas nécessairement un algorithme rétro‑ingénieré à l’intérieur du modèle.
Circuits et interventions causales
Les chercheurs peuvent identifier une tête d’attention ou une caractéristique associée à une tâche, l’ablater, patcher des activations provenant d’une autre exécution, ou tracer le déplacement de l’information à travers les couches. Une bonne hypothèse prédit le comportement sur de nouveaux exemples et résiste aux contrôles.
Les interventions peuvent créer des états hors distribution, de sorte qu’un changement de comportement ne révèle pas automatiquement le calcul naturel. Utilisez plusieurs méthodes, des contrôles appariés et des effets quantitatifs plutôt qu’une seule invite illustrative.
Superposition et caractéristiques parcimonieuses
Les réseaux de neurones peuvent représenter plus de caractéristiques que de dimensions individuelles en les superposant. Un neurone peut ainsi s’activer pour plusieurs motifs sans rapport, rendant les étiquettes au niveau du neurone trompeuses.
Les auto‑encodeurs parcimonieux apprennent un dictionnaire plus vaste de caractéristiques à partir des activations du modèle. Ils peuvent rendre les motifs plus séparables, mais la parcimonie choisie, les données d’entraînement, l’erreur de reconstruction et les étiquettes automatisées influencent ce qui est récupéré. Les caractéristiques de réseaux de neurones nécessitent toujours une validation causale.
Sécurité, débogage et limites
Les outils mécanistes peuvent aider à repérer des faits mémorisés, des biais, des stratégies trompeuses ou des circuits de défaillance et peuvent soutenir l’édition ou la surveillance. Les mêmes outils peuvent manquer des calculs distribués, rares ou dépendants du contexte.
Considérez les résultats comme des preuves limitées: version du modèle, tâche, jeu de données, couche, intervention, effet et incertitude. Reliez l’interprétation aux évaluations comportementales, au red‑team et à la gouvernance responsable‑IA plutôt que de l’utiliser comme un certificat de sécurité généralisé.
Représentations, circuits et preuves causales
L’interprétabilité mécaniste étudie comment les calculs internes produisent le comportement du modèle. Les chercheurs examinent les activations, les poids, l’attention et les caractéristiques intermédiaires, puis formulent des hypothèses sur les représentations et les circuits. Une représentation n’est pas nécessairement stockée dans un seul neurone ; elle peut être répartie sur plusieurs directions, couches, jetons et combinaisons dépendantes du contexte.
Les auto‑encodeurs parcimonieux tentent de décomposer les activations denses en un ensemble plus large de caractéristiques qui s’activent sélectivement. Les étiquettes de caractéristiques sont des interprétations humaines d’exemples observés, et non une vérité de référence. L’erreur de reconstruction, la parcimonie, la division des caractéristiques, l’absorption et les caractéristiques mortes influencent ce que la décomposition révèle et ce qu’elle omet.
La corrélation est insuffisante pour une affirmation mécaniste. Le patching d’activation, l’ablation, le traçage causal, le steering et les interventions ciblées sur les poids testent si un composant modifie le comportement comme prévu. Les interventions peuvent également créer des états hors distribution, de sorte que les résultats nécessitent des contrôles, une analyse dose‑réponse, des explications alternatives et une réplication sur différents prompts et modèles.
Un flux de travail d’interprétabilité rigoureux
Commencez par un comportement mesuré avec précision et un jeu de données qui sépare les hypothèses concurrentes. Localisez les couches, positions, composants ou caractéristiques pertinents ; examinez les mécanismes candidats ; intervenez ; et testez si le circuit proposé prédit de nouveaux cas. Gardez les exemples exploratoires séparés de l’évaluation confirmatoire afin de réduire le biais de sélection.
Les outils automatisés peuvent classer les neurones, les caractéristiques, les têtes ou les chemins, tandis que les modèles de langage peuvent proposer des descriptions. L’automatisation augmente la couverture mais peut fabriquer des récits plausibles. Évaluez les explications sur des exemples d’activation hors‑échantillon et des prédictions causales, consignez l’incertitude et rendez les artefacts reproductibles avec la version du modèle, le tokenizer, les prompts et le code.
Les mécanismes peuvent être polysémiques, redondants, non linéaires et distribués. Supprimer un composant peut être compensé par d’autres, tandis qu’une caractéristique peut participer à plusieurs comportements. Les résultats négatifs sont informatifs: un circuit apparent qui échoue en dehors des exemples sélectionnés doit être restreint ou rejeté plutôt que sauvé par une explication de plus en plus vague.
Applications, limites et affirmations de sécurité
L’interprétabilité peut aider à déboguer les hallucinations, les biais, la mémorisation, les comportements de contournement ou les généralisations inattendues ; comparer les modèles ; et générer des hypothèses scientifiques. Elle peut également identifier des caractéristiques à surveiller ou à intervenir. Ces usages nécessitent une validation spécifique à la tâche, car une visualisation de recherche utile n’est pas automatiquement un contrôle de production fiable.
L’absence d’une caractéristique détectée ne prouve pas l’absence d’une capacité ou d’une intention, et une caractéristique lisible ne prouve pas que le modèle l’utilise dans une réponse donnée. Les outils observent une projection du calcul avec une couverture limitée. Les affirmations de sécurité doivent préciser la sensibilité de détection, les faux positifs, la distribution, l’adversaire et les angles morts connus.
Utilisez l’interprétabilité en parallèle des évaluations comportementales, du red‑team, de la gouvernance des données, des contrôles d’accès, de la surveillance et de la réponse aux incidents. Publiez les méthodes et les contre‑exemples lorsque possible. Le domaine progresse rapidement, mais les techniques actuelles ne fournissent pas une explication complète et fidèle du raisonnement des modèles de pointe ni une garantie générale d’alignement.
Exemple travaillé : tester un circuit de modèle proposé
Supposons qu’un modèle semble utiliser un ensemble de têtes d’attention et de caractéristiques pour résoudre un objet indirect dans une phrase. Les chercheurs définissent un jeu de données contrôlé avec des noms, positions, distracteurs et contre‑exemples variés, puis mesurent le comportement. L’inspection des activations identifie les composants candidats, mais l’hypothèse est rédigée avant l’intervention: quelles informations chaque composant transporte, où il se déplace, et comment le modifier devrait changer la sortie.
Le patching d’activation et l’ablation testent la nécessité et la suffisance sur des exemples hors‑échantillon. Une modification ciblée qui change le jeton prédit dans la direction attendue soutient le mécanisme ; une dégradation générale des performances ne le fait pas. Les contrôles patchent des positions et composants non liés, varient l’ampleur de l’intervention et comparent des circuits alternatifs. L’équipe publie des cas négatifs où l’explication échoue et évite d’attribuer un but lisible à l’homme uniquement à partir de la corrélation.
Pour revendiquer une application de sécurité, la méthode doit détecter le comportement pertinent avec une sensibilité connue sous des prompts réalistes et une adaptation adversariale. Les moniteurs de caractéristiques sont évalués pour les faux positifs, l’évasion, les mises à jour du modèle et la pertinence causale. Les preuves d’interprétabilité peuvent guider le débogage et d’autres tests, mais l’application reste dans les contrôles externes et la surveillance comportementale. Un diagramme de circuit convaincant est une hypothèse scientifique étayée par des preuves — pas une explication complète d’un modèle ni une garantie concernant un comportement non observé.
Liste de contrôle d’implémentation pratique
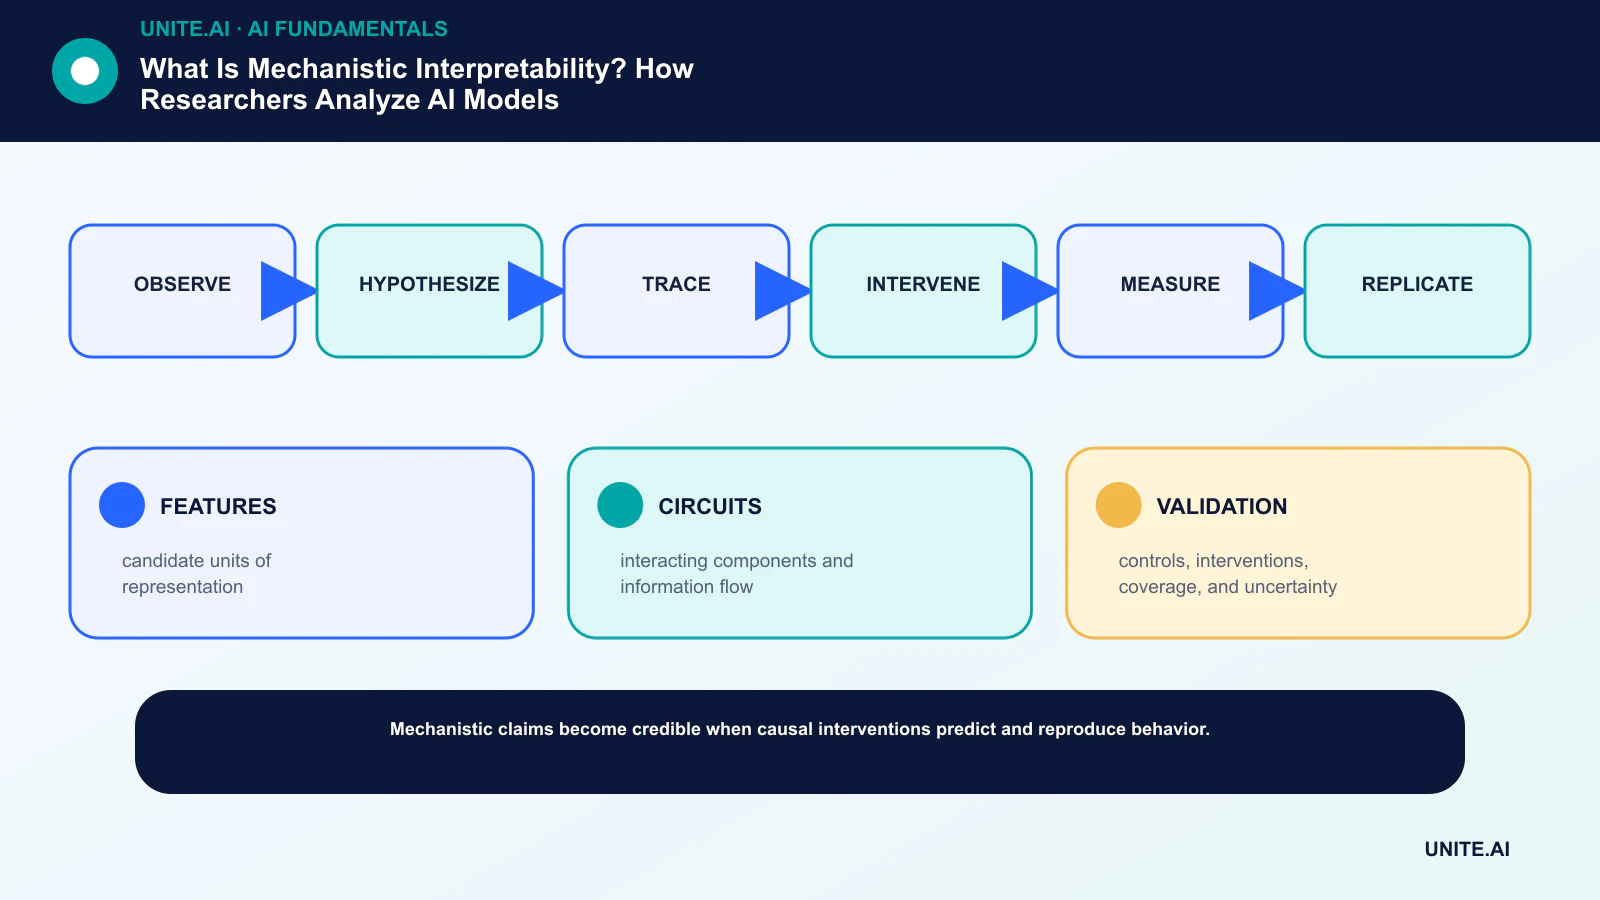
Transformez le concept en un flux de travail limité et testable: observer → formuler une hypothèse → tracer → intervenir → mesurer → reproduire. Désignez un responsable imputable, documentez les données et dépendances, établissez une base simple, définissez des critères d’acceptation et d’arrêt, testez des échecs représentatifs, et définissez la surveillance, le retour en arrière et la révision avant d’étendre le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre ce qui a changé.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui construisent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les pannes de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la mise en production, modifier un seuil, outrepasser une sortie ou arrêter l’opération. Réexaminez la décision après l’arrivée de données réelles, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- CARACTÉRISTIQUES: unités candidates de représentation.
- CIRCUITS: composants interactifs et flux d’information.
- VALIDATION: contrôles, interventions, couverture et incertitude.
Foire aux questions
L’interprétabilité mécaniste est‑elle identique à la lecture des poids du modèle ?
Non. Les poids bruts ne sont pas auto‑explicatifs. Les chercheurs analysent les activations, les caractéristiques, les composants et les interventions pour construire et tester des hypothèses causales.
Les auto‑encodeurs parcimonieux peuvent‑ils expliquer entièrement un LLM ?
Non. Ils offrent une base de caractéristiques candidates et peuvent soutenir l’analyse de circuits, mais la couverture, la fidélité, la reconstruction, l’étiquetage et l’évolutivité restent des problèmes ouverts.
Références principales












