
Modèles et plateformes d’IA
Le problème de la boîte noire dans les LLM : défis et solutions émergentes

 Ajouter Unite.AI à vos sources préférées sur Google

L’apprentissage automatique, un sous-ensemble de l’IA, implique trois composants : les algorithmes, les données de formation et le modèle résultant. Un algorithme, essentiellement un ensemble de procédures, apprend à identifier des modèles à partir d’un grand ensemble d’exemples (données de formation). Le résultat de cette formation est un modèle d’apprentissage automatique. Par exemple, un algorithme formé avec des images de chiens aboutit à un modèle capable d’identifier les chiens dans les images.
La boîte noire dans l’apprentissage automatique
Dans l’apprentissage automatique, l’un des trois composants – algorithme, données de formation ou modèle – peut être une boîte noire. Bien que les algorithmes soient souvent connus publiquement, les développeurs peuvent choisir de garder le modèle ou les données de formation secrètes pour protéger la propriété intellectuelle. Cette obscurité rend difficile la compréhension du processus de prise de décision de l’IA.
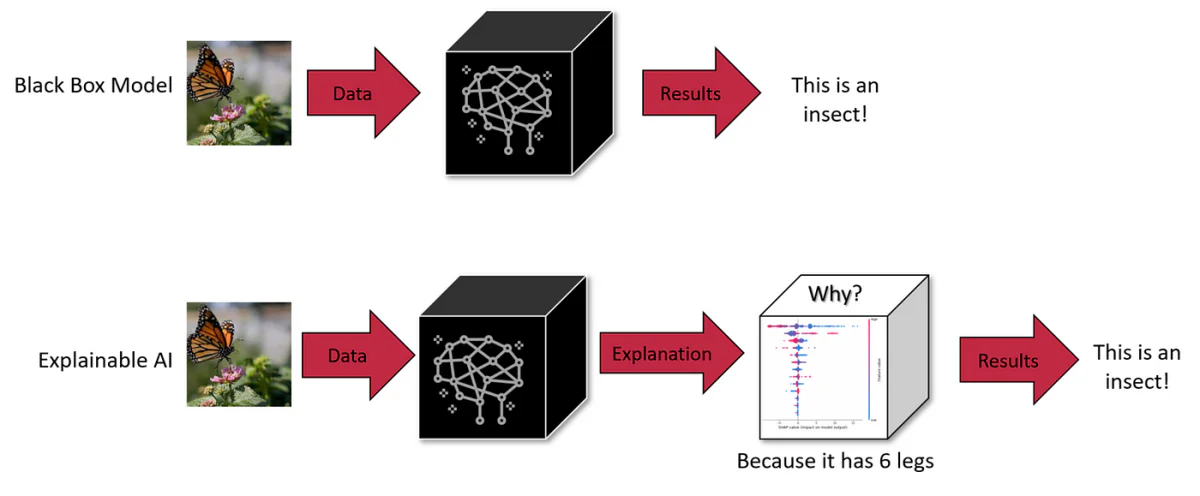
Les boîtes noires de l’IA sont des systèmes dont les mécanismes internes restent opaques ou invisibles pour les utilisateurs. Les utilisateurs peuvent saisir des données et recevoir des sorties, mais la logique ou le code qui produit la sortie reste caché. Il s’agit d’une caractéristique courante de nombreux systèmes d’IA, notamment les modèles génératifs avancés comme ChatGPT et DALL-E 3.
Les LLM tels que GPT-4 présentent un défi important : leurs mécanismes internes sont largement opaques, les rendant des “boîtes noires”. Une telle opacité n’est pas seulement un puzzle technique ; elle pose des préoccupations réelles en matière de sécurité et d’éthique. Par exemple, si nous ne pouvons pas discerner comment ces systèmes parviennent à des conclusions, pouvons-nous leur faire confiance dans des domaines critiques comme les diagnostics médicaux ou les évaluations financières ?


L’échelle et la complexité des LLM
L’échelle de ces modèles ajoute à leur complexité. Prenez GPT-3, par exemple, avec ses 175 milliards de paramètres, et les modèles plus récents ayant des trillions. Chaque paramètre interagit de manière complexe au sein du réseau neuronal, contribuant à des capacités émergentes qui ne sont pas prévisibles en examinant les composants individuels seuls. Cette échelle et cette complexité rendent presque impossible de comprendre pleinement leur logique interne, posant un obstacle pour diagnostiquer les biais ou les comportements indésirables dans ces modèles.
Le compromis : échelle vs interprétabilité
Réduire l’échelle des LLM pourrait améliorer l’interprétabilité, mais au prix de leurs capacités avancées. L’échelle est ce qui permet les comportements que les modèles plus petits ne peuvent pas atteindre. Cela présente un compromis inhérent entre l’échelle, la capacité et l’interprétabilité.
Impact du problème de la boîte noire des LLM
1. Prise de décision erronée
L’opacité dans le processus de prise de décision des LLM comme GPT-3 ou BERT peut conduire à des biais et des erreurs non détectés. Dans des domaines tels que la santé ou la justice pénale, où les décisions ont des conséquences loin d’être négligeables, l’incapacité à auditer les LLM pour leur solidité éthique et logique est une préoccupation majeure. Par exemple, un diagnostic médical LLM basé sur des données obsolètes ou biaisées peut faire des recommandations nuisibles. De même, les LLM dans les processus de recrutement peuvent perpétuer involontairement les biais de genre. La nature de boîte noire ne cache pas seulement les défauts, mais peut potentiellement les amplifier, nécessitant une approche proactive pour améliorer la transparence.
2. Adaptabilité limitée dans des contextes divers
Le manque de compréhension des mécanismes internes des LLM restreint leur adaptabilité. Par exemple, un LLM de recrutement pourrait être inefficace pour évaluer les candidats pour un rôle qui valorise les compétences pratiques plutôt que les qualifications académiques, en raison de son incapacité à ajuster ses critères d’évaluation. De même, un LLM médical pourrait avoir du mal avec les diagnostics de maladies rares en raison de déséquilibres de données. Cette inflexibilité met en évidence le besoin de transparence pour recalibrer les LLM pour des tâches et des contextes spécifiques.
3. Biais et lacunes de connaissance
Le traitement par les LLM de vastes données de formation est soumis aux limites imposées par leurs algorithmes et architectures de modèle. Par exemple, un LLM médical pourrait montrer des biais démographiques s’il est formé sur des ensembles de données déséquilibrés. De plus, la compétence d’un LLM dans des sujets de niche pourrait être trompeuse, conduisant à des sorties incorrectes et trop confiantes. Pour résoudre ces biais et ces lacunes de connaissance, il faut plus que de simples données supplémentaires ; il faut examiner les mécanismes de traitement du modèle.
4. Responsabilité juridique et éthique
La nature opaque des LLM crée une zone grise juridique en ce qui concerne la responsabilité pour tout préjudice causé par leurs décisions. Si un LLM dans un contexte médical fournit des conseils erronés conduisant à un préjudice pour le patient, déterminer la responsabilité devient difficile en raison de l’opacité du modèle. Cette incertitude juridique pose des risques pour les entités qui déployant des LLM dans des domaines sensibles, soulignant le besoin d’une gouvernance et d’une transparence claires.
5. Problèmes de confiance dans les applications sensibles
Pour les LLM utilisés dans des domaines critiques tels que la santé et la finance, le manque de transparence sape leur fiabilité. Les utilisateurs et les régulateurs doivent s’assurer que ces modèles ne cachent pas de biais ou ne prennent pas de décisions basées sur des critères injustes. Vérifier l’absence de biais dans les LLM nécessite une compréhension de leurs processus de prise de décision, mettant en évidence l’importance de l’explicabilité pour un déploiement éthique.
6. Risques liés aux données personnelles
Les LLM nécessitent de vastes données de formation, qui peuvent inclure des informations personnelles sensibles. La nature de boîte noire de ces modèles soulève des inquiétudes quant à la manière dont ces données sont traitées et utilisées. Par exemple, un LLM médical formé sur des dossiers de patients soulève des questions sur la confidentialité et l’utilisation des données. Assurer que les données personnelles ne sont pas mal utilisées ou exploitées nécessite des processus de traitement de données transparents au sein de ces modèles.
Solutions émergentes pour l’interprétabilité
Pour relever ces défis, de nouvelles techniques sont en développement. Celles-ci incluent les méthodes d’approximation des contre-faits. La première méthode implique de solliciter un LLM pour modifier un concept de texte spécifique tout en gardant les autres concepts constants. Cette approche, bien que efficace, est intensive en ressources au moment de l’inférence.
La deuxième approche implique la création d’un espace d’intégration dédié guidé par un LLM pendant la formation. Cet espace s’aligne sur un graphique causal et aide à identifier les correspondances approximant les contre-faits. Cette méthode nécessite moins de ressources au moment du test et a été montrée pour expliquer efficacement les prédictions du modèle, même dans les LLM avec des milliards de paramètres.
Ces approches mettent en évidence l’importance des explications causales dans les systèmes NLP pour assurer la sécurité et établir la confiance. Les approximations de contre-faits offrent un moyen d’imaginer comment un texte donné changerait si un concept spécifique dans son processus de génération était différent, aidant ainsi à estimer pratiquement l’effet causal de concepts de haut niveau sur les modèles NLP.
Plongée approfondie : méthodes d’explication et causalité dans les LLM
Outils de sondage et d’importance des caractéristiques
Le sondage est une technique utilisée pour déchiffrer ce que les représentations internes des modèles codent. Il peut être supervisé ou non supervisé et vise à déterminer si des concepts spécifiques sont codés à certains endroits du réseau. Bien que cela soit efficace dans une certaine mesure, les sondages ne fournissent pas d’explications causales, comme le soulignent Geiger et al. (2021).
Les outils d’importance des caractéristiques, une autre forme de méthode d’explication, se concentrent souvent sur les caractéristiques d’entrée, bien que certaines méthodes basées sur les gradients s’étendent aux états cachés. Un exemple est la méthode des gradients intégrés, qui offre une interprétation causale en explorant les entrées de référence (contre-faits, CF). Malgré leur utilité, ces méthodes ont encore du mal à relier leurs analyses à des concepts du monde réel au-delà des propriétés d’entrée simples.
Méthodes basées sur l’intervention
Les méthodes basées sur l’intervention impliquent de modifier les entrées ou les représentations internes pour étudier les effets sur le comportement du modèle. Ces méthodes peuvent créer des états de contre-fait pour estimer les effets causaux, mais elles génèrent souvent des entrées ou des états de réseau implausibles à moins d’être soigneusement contrôlées. Le modèle de proxy causal (CPM), inspiré du concept de l’apprenant S, est une approche novatrice dans ce domaine, imitant le comportement du modèle expliqué sous des entrées de contre-fait. Cependant, le besoin d’un expliquant distinct pour chaque modèle est une limitation majeure.
Approximation des contre-faits
Les contre-faits sont largement utilisés dans l’apprentissage automatique pour l’augmentation de données, impliquant des perturbations de divers facteurs ou étiquettes. Ceux-ci peuvent être générés par édition manuelle, remplacement de mots clés heuristiques ou réécriture de texte automatisée. Bien que l’édition manuelle soit précise, elle est également intensive en ressources. Les méthodes basées sur les mots clés ont leurs limites, et les approches génératives offrent un équilibre entre fluidité et couverture.
Explications fidèles
La fidélité dans les explications se réfère à la représentation exacte de la raison sous-jacente du modèle. Il n’y a pas de définition universellement acceptée de la fidélité, conduisant à sa caractérisation à travers diverses métriques comme la sensibilité, la cohérence, l’accord des caractéristiques, la robustesse et la simulabilité. La plupart de ces méthodes se concentrent sur les explications au niveau des caractéristiques et confondent souvent la corrélation avec la causalité. Notre travail vise à fournir des explications de concepts de haut niveau, en exploitant la littérature sur la causalité pour proposer un critère intuitif : l’ordre-fidélité.
Nous avons plongé dans les complexités inhérentes aux LLM, en comprenant leur nature de “boîte noire” et les défis importants qu’elle pose. Des risques de prise de décision erronée dans des domaines sensibles comme la santé et la finance aux dilemmes éthiques entourant les biais et l’équité, le besoin de transparence dans les LLM n’a jamais été plus évident.
L’avenir des LLM et leur intégration dans notre vie quotidienne et dans les processus de prise de décision critiques dépendent de notre capacité à rendre ces modèles non seulement plus avancés mais également plus compréhensibles et responsables. La poursuite de l’explicabilité et de l’interprétabilité n’est pas seulement une entreprise technique mais un aspect fondamental de la construction de la confiance dans les systèmes d’IA. À mesure que les LLM deviennent plus intégrés dans la société, la demande de transparence augmentera, non seulement des praticiens de l’IA mais de chaque utilisateur qui interagit avec ces systèmes.


