
Fondamentaux de l’IA
Modèles d’apprentissage automatique génératifs vs discriminatifs

 Ajouter Unite.AI à vos sources préférées sur Google
Génératif et discriminatif décrivent ce qu’un modèle apprend des données et des cibles. Dans la classification supervisée classique, un modèle génératif apprend une distribution conjointe telle que P(x, y) ou la distribution conditionnelle par classe P(x|y), tandis qu’un modèle discriminatif apprend P(y|x) ou une frontière de décision directe.
Cette distinction est utile, mais les systèmes modernes combinent souvent les objectifs. Un modèle peut apprendre des représentations génératives puis être affiné pour la prédiction discriminative, ou partager une même architecture de base entre génération et classification.
Points clés
- Les classificateurs génératifs modélisent la façon dont les entrées et les étiquettes sont générées ; les classificateurs discriminatifs modélisent l’étiquette donnée l’entrée ou une frontière.
- Les hypothèses génératives peuvent aider lorsque les données étiquetées sont limitées, mais elles peuvent aussi être erronées.
- Les méthodes discriminatives concentrent souvent la capacité sur la tâche de prédiction et peuvent obtenir une meilleure erreur de classification asymptotique.
- Les GAN, les VAE et les modèles de langage sont des systèmes génératifs, mais « génératif » ne signifie pas que chaque composant est un classificateur génératif.
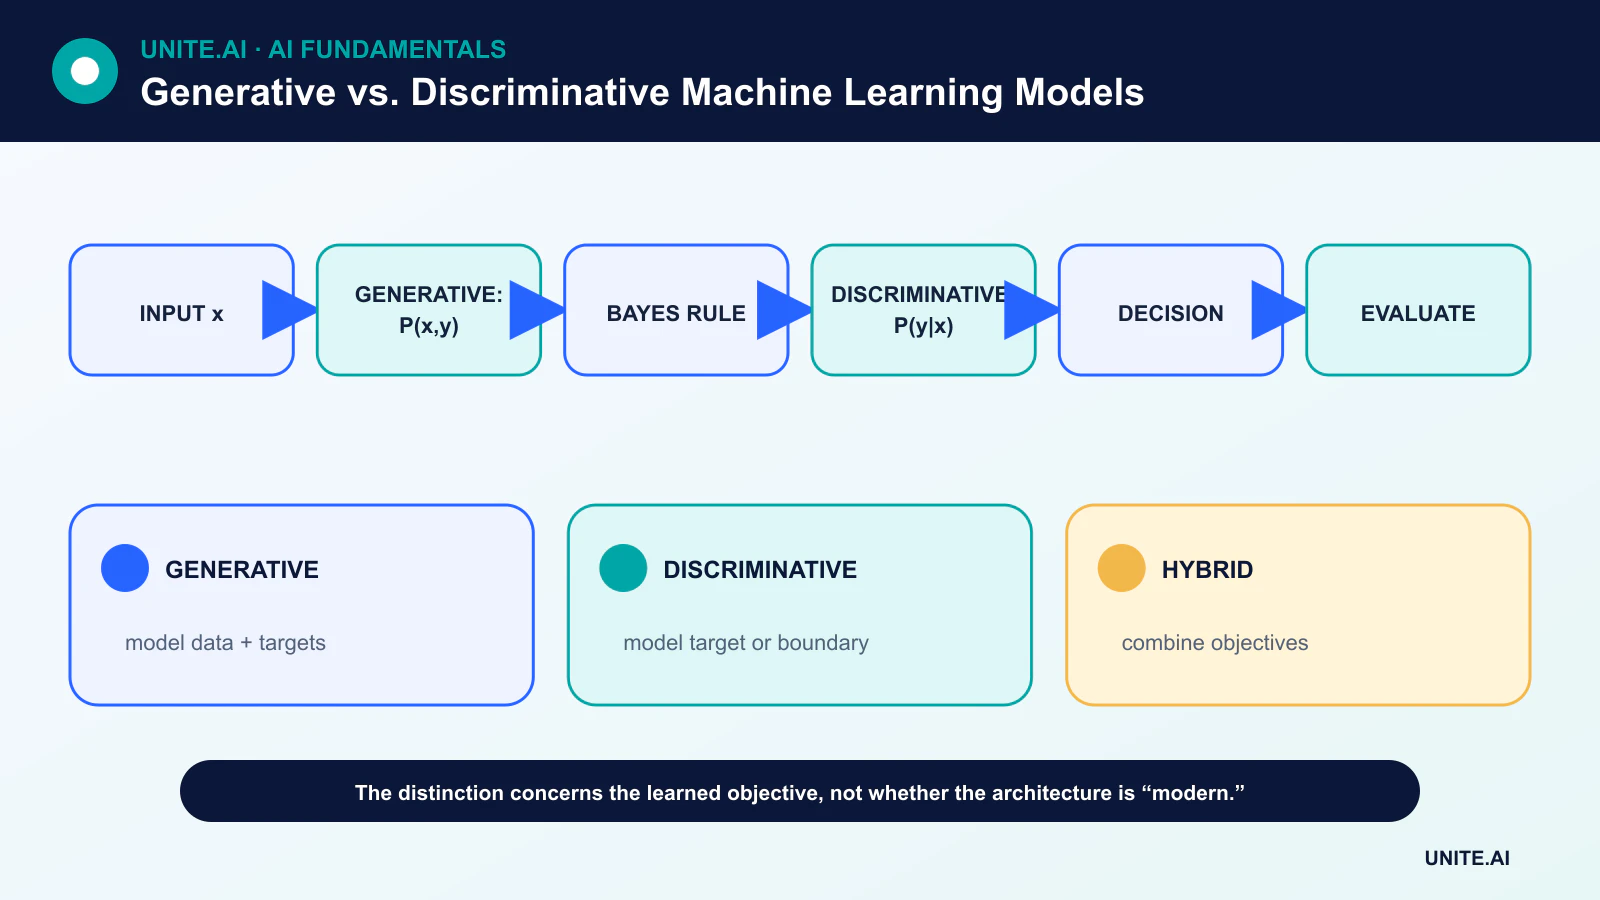
Factorisation de la probabilité
Un classificateur génératif peut estimer P(x|y) et P(y), puis utiliser le théorème de Bayes pour obtenir P(y|x). Le classificateur Naïve Bayes en est un exemple classique. Un classificateur discriminatif tel que la régression logistique estime directement P(y|x) ; un SVM apprend une frontière séparatrice.
Modéliser P(x,y) est une tâche plus large que de prédire y à partir de x. Cette structure supplémentaire peut faciliter le prélèvement ou le raisonnement sur des données manquantes, mais elle impose également des hypothèses sur la distribution des entrées.
Efficacité des données et comportement asymptotique
La comparaison de Ng et Jordan entre le Naïve Bayes et la régression logistique a mis en évidence un compromis utile : selon leurs hypothèses, le modèle génératif peut atteindre sa performance limite avec moins d’exemples, tandis que le modèle discriminatif peut atteindre une erreur asymptotique plus faible.
Il ne s’agit pas d’un classement universel. Les résultats dépendent de l’adéquation de la famille de modèles aux données, de la dimension, de la régularisation, de l’optimisation et de la qualité des étiquettes. Une comparaison empirique sur une conception de validation représentative reste indispensable.
Familles de modèles représentatives
Les modèles génératifs comprennent les distributions conditionnelles par classe, les modèles de Markov cachés, les modèles de mélange, les auto‑encodeurs variationnels, les modèles de langage autorégressifs, les modèles de diffusion et les GAN.
Les modèles discriminatifs comprennent la régression logistique, les arbres de décision, les champs aléatoires conditionnels, les machines à vecteurs de support et les classificateurs neuronaux. La même architecture neuronale peut appartenir à l’une ou l’autre catégorie selon son objectif d’entraînement et sa sortie.
Systèmes hybrides et auto‑supervisés
Un modèle de langage ou de vision pré‑entraîné peut apprendre à partir de données non étiquetées avec un objectif génératif ou auto‑supervisé, puis recevoir une tête discriminative pour une tâche cible. Les méthodes semi‑supervisées peuvent optimiser simultanément la classification étiquetée et un objectif sur les données non étiquetées.
L’hybridation rend les étiquettes d’architecture moins informatives que l’ensemble du pipeline d’entraînement. La documentation doit préciser l’objectif, les données, les sorties et l’inférence prévue — et ne pas simplement qualifier un modèle de génératif.
Choisir entre les approches
Laissez la tâche guider votre choix. Si l’objectif est d’obtenir une frontière calibrée avec de nombreuses étiquettes, un modèle discriminatif constitue une base naturelle. Si l’échantillonnage, l’estimation de densité, la structure de données manquantes ou les données non étiquetées sont essentiels, un composant génératif peut être utile.
Comparez la robustesse, l’efficacité d’échantillonnage, le coût de calcul, la vraisemblance ou la calibration selon le cas. Un bon échantillon généré ne prouve pas la qualité d’un classificateur, et un classificateur très précis n’implique pas un modèle réaliste de la distribution des entrées.
Directions de probabilité et objectifs de modélisation
Un modèle discriminatif apprend une frontière ou une distribution conditionnelle P(y|x) : à partir des caractéristiques x, prédire l’étiquette y. La régression logistique, les machines à vecteurs de support, les champs aléatoires conditionnels et de nombreux classificateurs sont discriminatifs. Un modèle génératif apprend une distribution conjointe P(x,y), une distribution conditionnelle par classe P(x|y) ou une distribution de données inconditionnelle, ce qui permet l’échantillonnage ou des tâches liées à la vraisemblance. Naïve Bayes et l’analyse discriminante linéaire sont des classificateurs génératifs ; les GAN, les auto‑encodeurs variationnels, les modèles de diffusion et les modèles autorégressifs génèrent des données selon différents objectifs.
La distinction porte sur la distribution ou la règle de décision modélisée, et non sur l’utilisation d’un réseau de neurones. Un modèle de langage génératif peut être sollicité pour classer, tandis qu’un ré‑classeur discriminatif peut guider la génération. Les hypothèses génératives peuvent améliorer l’efficacité des données ou gérer des variables manquantes, mais elles introduisent un risque de mauvaise spécification du modèle. Les méthodes discriminatives excellent souvent avec de nombreuses données étiquetées car elles se concentrent directement sur la frontière de prédiction. Comparez les familles avec des caractéristiques, des données, un réglage et une capacité de calcul égaux, plutôt que de considérer une catégorie comme universellement supérieure.
Entraînement et évaluation selon les cas d’usage
L’évaluation de la classification utilise la précision, le rappel, la calibration, la robustesse et le coût d’erreur. L’évaluation d’un modèle génératif doit prendre en compte la fidélité, la diversité, la couverture, la vraisemblance ou l’utilité pour la tâche, la mémorisation et la sécurité. Un modèle peut produire des échantillons attractifs tout en négligeant certains modes, ou obtenir une bonne vraisemblance avec une sortie perceptuelle médiocre. L’utilité des données synthétiques doit être testée en entraînant et en évaluant des modèles en aval sur des données réelles indépendantes, y compris des groupes rares. Gardez les données de test hors des invites de génération et de la sélection.
Dans l’apprentissage semi‑supervisé, un modèle génératif peut exploiter la structure des données non étiquetées ; en détection d’anomalies, la vraisemblance peut échouer lorsque des données hors distribution reçoivent une densité élevée pour des raisons non pertinentes. Dans la génération augmentée par récupération, un modèle de réponse génératif et un récupérateur ou ré‑classeur discriminatif forment un hybride. Diagnostiquez les étapes séparément afin qu’une sortie fluide ne masque pas un échec de récupération. Choisissez la décomposition qui rend les preuves et le contrôle observables.
Déploiement et gouvernance
Les systèmes génératifs introduisent des risques liés à la provenance du contenu, à la propriété intellectuelle, à l’usurpation d’identité, aux injections d’invite et à la modération des sorties ; les systèmes discriminatifs ajoutent des risques de seuil, de refus et d’erreurs inégales. Les deux nécessitent des droits sur les données, des artefacts sécurisés, le versionnage, des tests représentatifs, une surveillance et une autorité humaine proportionnelle aux conséquences. Consignez l’objectif précis et la sémantique des sorties dans la documentation. La distinction génératif vs. discriminatif est statistiquement utile, mais les systèmes réels les combinent souvent, et la fiabilité dépend de l’ensemble du pipeline de données et de décision.
Exemple pratique : classification et génération de réponses d’assistance
Une plateforme d’assistance utilise un classificateur discriminatif pour identifier le type de problème et son urgence, ainsi qu’un modèle génératif pour rédiger une réponse à partir de politiques approuvées. Le classificateur est évalué avec le rappel spécifique à chaque classe et la calibration ; le récupérateur avec le rappel des preuves ; le générateur avec la pertinence, la justesse et le refus. Chaque étape a un résultat incertain, et le modèle génératif ne peut pas modifier la classification ou le droit du client grâce à un texte persuasif.
Les agents voient le chemin prédit, les sources, et le brouillon qu’ils approuvent ou corrigent avant l’envoi. Des filtres d’autorisation s’appliquent avant la récupération, et l’injection d’invite dans le texte du client ne peut autoriser d’outils. La surveillance sépare les erreurs de routage, les lacunes de récupération, les affirmations non prises en charge et les modifications des agents. Un changement de politique met à jour les sources immédiatement et déclenche des tests de régression ; le réglage est réservé à un comportement stable. La conception hybride exploite les forces discriminatives et génératives tout en préservant les preuves et l’autorité humaine.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant le réglage. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Consignez chaque transformation et chaque seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype séduisant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les modifications, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sécurisée et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés, sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage d’incident, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Le discriminateur d’un GAN est‑il un modèle discriminatif ?
Il effectue la discrimination pendant l’entraînement, mais le GAN dans son ensemble est un cadre génératif dont la sortie est produite par le générateur.
L’apprentissage discriminatif est‑il toujours supervisé ?
Non. Le terme décrit la relation ou la frontière modélisée, tandis que la supervision décrit le signal d’entraînement. Les objectifs modernes peuvent brouiller les catégories.
Références principales












