AI:n perusteet
Mikä on syvä vahvistusoppiminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
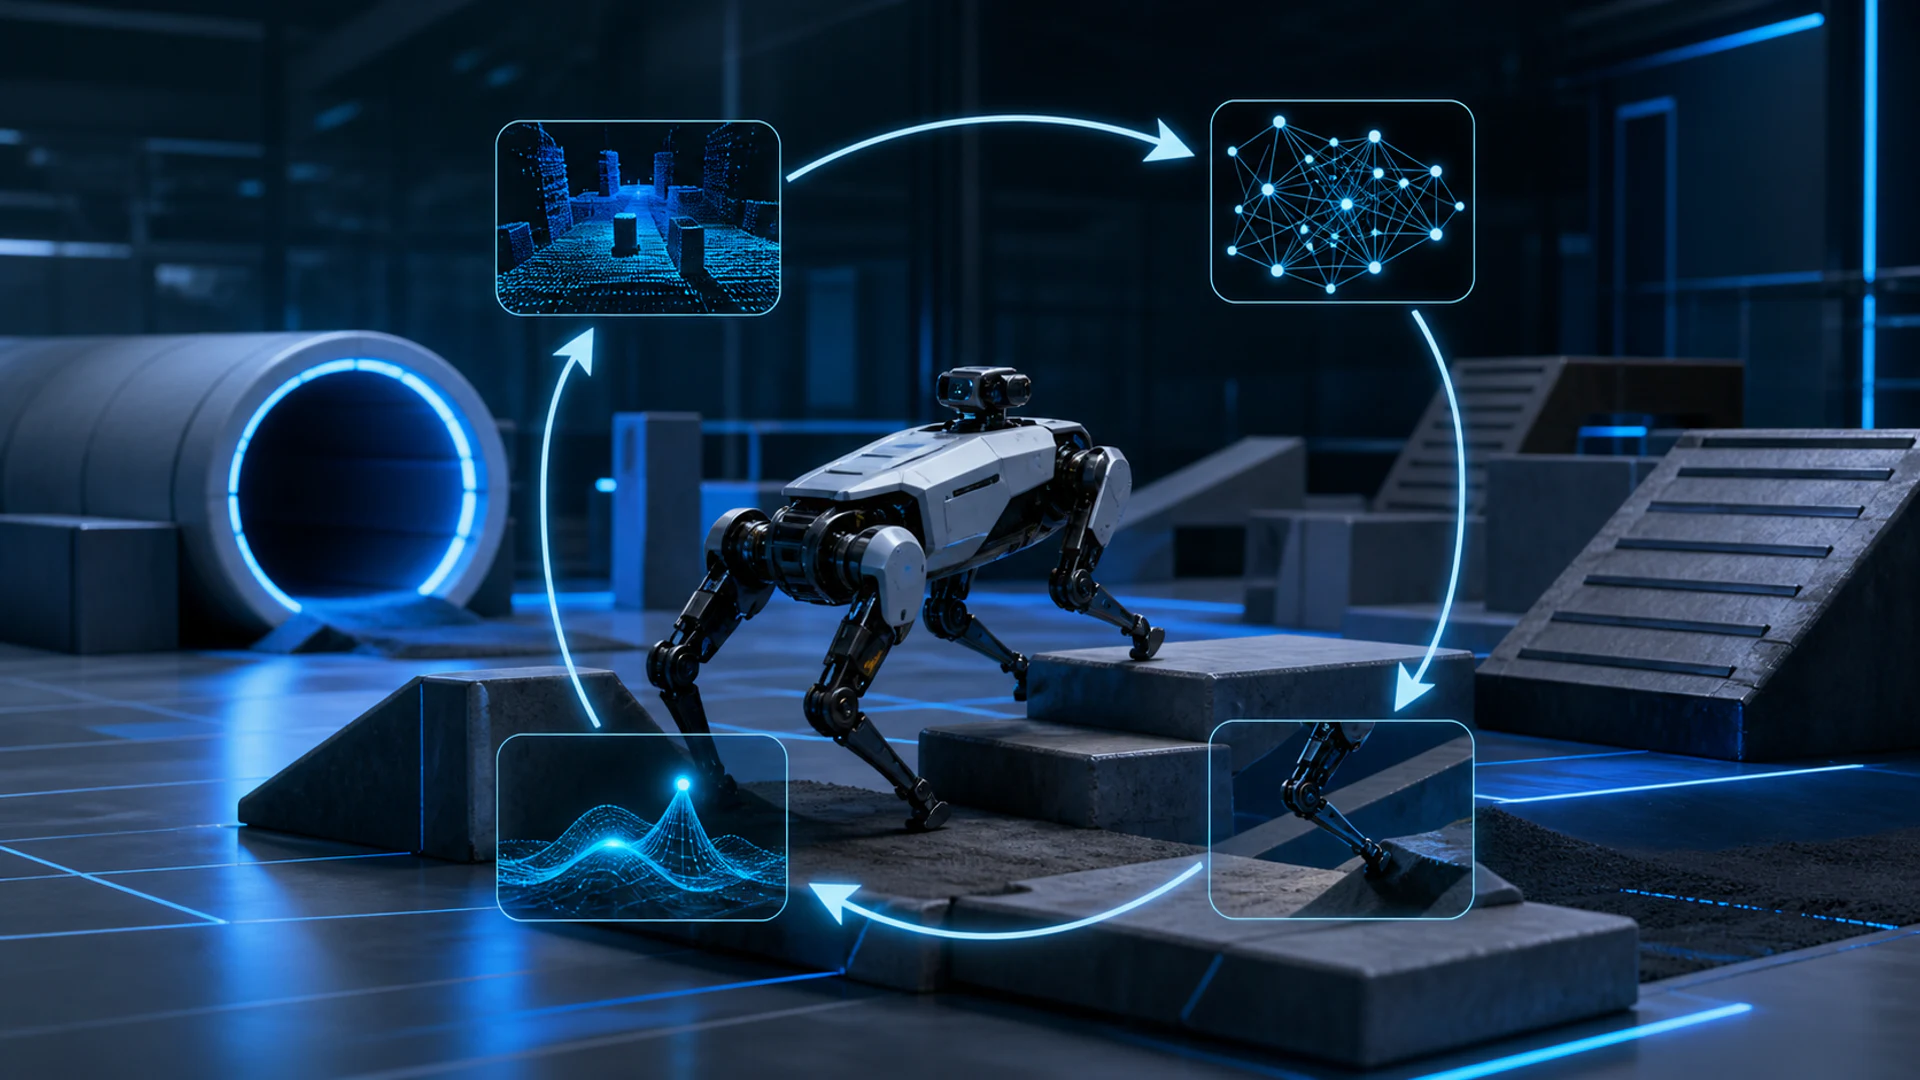
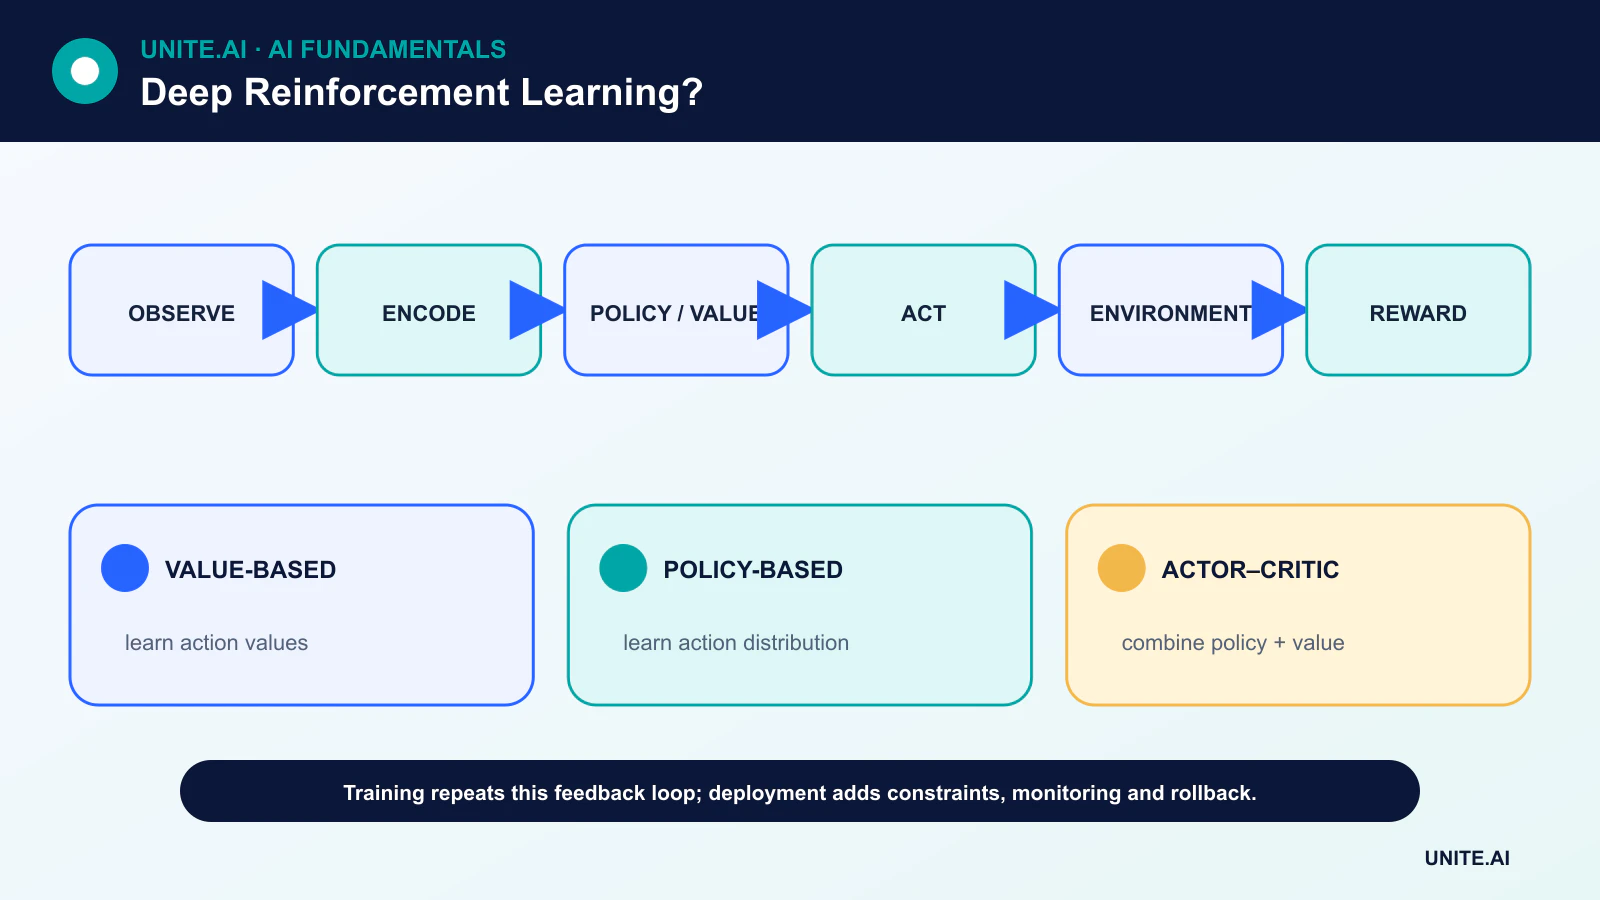
Syvä vahvistusoppiminen (syvä RL) yhdistää vahvistusoppimisen syviin neuroverkkoihin. Agentti havaitsee tilan, valitsee toiminnon, saa palkkion ja uuden havainnon, jonka jälkeen se säätää politiikkaa tai arvofunktiota parantaakseen tulevia päätöksiä.
Syvä verkko ei poista vahvistusoppimisen vaikeita osia. Se tarjoaa joustavan tavan esittää kuvia, anturivirtoja, suuria toimintatiloja tai monimutkaisia arvofunktioita. Tutkiminen, viivästynyt ansainta, epävakaa koulutus ja turvallinen todellisessa maailmassa tapahtuva arviointi pysyvät keskeisinä tekniikkaongelmina.
Keskeiset havainnot
- Syvä RL oppii peräkkäisiä päätöksiä vuorovaikutuksesta sen sijaan, että se käyttäisi kiinteää taulua merkittyjä esimerkkejä.
- Arvo-pohjaiset menetelmät arvioivat, kuinka hyviä toiminnot ovat; politiikkamenetelmät oppivat suoraan toimintojakauman; toimija‑kritiikki‑menetelmät yhdistävät molemmat.
- Uudelleenkäyttöpuskurit, kohdeverkot ja huolellinen palkkioiden suunnittelu voivat parantaa koulutusta, mutta mikään ei takaa luotettavaa käyttäytymistä.
- Vahva simulaattorin pistemäärä ei ole todiste kestävyydestä, turvallisuudesta tai onnistuneesta siirrosta fyysiseen maailmaan.
Päätösongelma: tilat, toiminnot ja palkkiot
Monet syvät RL -tehtävät mallinnetaan Markovin päätösprosessina. Ajan t hetkellä agentti saa tilan tai havainnon s_t, valitsee toiminnon a_t, jonka jälkeen se saa palkkion r_{t+1} ja seuraavan tilan. Tavoitteena on odotettu diskontattu tuotto, ei välttämättä pelkkä seuraava palkkio.
Diskonttokerroin säätelee, kuinka vahvasti kaukaiset palkkiot vaikuttavat. Palkkiofunktio määrittelee, mitä optimointiprosessi pyrkii maksimoimaan, joten epätäydellinen proxy voi tuottaa käyttäytymistä, joka on teknisesti onnistunutta mutta operatiivisesti ei-toivottua. Tämä on yksi syy, miksi palkkioiden suunnittelu ja rajoitteiden testaus ansaitsevat yhtä paljon huomiota kuin mallin arkkitehtuuri.
Arvo-pohjaiset, politiikka-pohjaiset ja toimija‑kritiikki‑menetelmät
Arvo-pohjainen algoritmi arvioi tilan arvon tai toiminnon arvon. Syvät Q-verkot käyttävät neuroverkkoa Q-arvojen approksimoimiseen ja valitsevat tyypillisesti toiminnon, jonka arvio on suurin, säilyttäen samalla jonkin tutkimisen. Politiikkagradientti-algoritmi puolestaan optimoi parametrisoitua politiikkaa, joka tuottaa toimintojakauman.
Toimija‑kritiikki-järjestelmät ylläpitävät sekä toimijaa, joka ehdottaa toimintoja, että kritiikkiä, joka arvioi niiden arvon. Tämä rakenne tukee jatkuvaa ohjausta, mutta tuo mukanaan vuorovaikutteisia arviointivirheen lähteitä. Syvä RL siis perustuu samoihin perusteisiin kuin syvä oppiminen, gradienttimenetelmä ja takaisinkytkentä (backpropagation).
Miksi uudelleenkäyttöpuskurit ja kohdeverkot auttavat
Peräkkäiset kokemuksen näytteet ovat korreloituneita, kun taas verkon päivitys muuttaa myöhempien päivitysten käyttämät kohteet. Kokemuksen uudelleenkäyttö rikkoo osan tästä aikakorrelaatiosta valitsemalla vanhempia siirtymiä. Kohdeverkko muuttuu hitaammin kuin online-verkko, mikä tekee käynnistetyistä kohteista vähemmän volatiileja.
Nämä mekanismit parantavat koulutuksen vakautta, mutta viritys on edelleen tärkeää. Oppimisnopeus, tutkimisaikataulu, palkkioiden skaalaus, uudelleenkäytön koostumus ja verkon kapasiteetti voivat kaikki vaikuttaa lopputulokseen. Useita satunnaisia siemeniä tulisi raportoida, koska yksi suorituskerta voi olla harhaanjohtava.
Offline‑RL, mallipohjainen RL ja sim‑todellisuus
Offline‑RL oppii kiinteästä lokitietoaineistosta keräämättä uusia vuorovaikutuksia. Se voi olla hyödyllistä, kun tutkiminen on kallista tai vaarallista, mutta politiikan on vältettävä toimintoja, jotka ovat huonosti edustettuina lokissa. Mallipohjainen RL oppii tai käyttää siirtymismallia suunnitteluun, vaihtamalla lisäoletuksia näytteen tehokkuuden puolesta.
Robotiikassa koulutetaan usein simulaatiossa, satunnaistetaan fyysisiä parametreja ja sitten hienosäädetään tai validoidaan laitteistossa. Todellisuuden kuilu voi edelleen paljastaa virheitä havainnoinnissa, ajoituksessa, kosketusdynaamisissa ja mallintamattomissa reunatapauksissa. Vahvistusoppimisjärjestelmä tulisi arvioida häiriöiden, jakauman siirtymän ja eksplisiittisten turvallisuusrajoitteiden alla.
Arviointi ja käyttöönotto
Hyödyllinen arviointi erottaa koulutus- ja testausympäristöt, raportoi tuottojakaumat eikä pelkästään parasta pistemäärää, ja tarkistaa rajoitteiden rikkomukset, puuttumisten tiheyden ja pahimman mahdollisen käyttäytymisen. Todellisissa järjestelmissä tiimit tarvitsevat myös valvontaa, palautusmenettelyjä, rajoitettuja toiminta-alueita ja ihmisen ohituksen.
Syvä RL on houkuttelevin, kun päätökset ovat peräkkäisiä, palaute on saatavilla ja käsin kirjoitetut ohjaussäännöt eivät riitä. Se on huono oletus, kun valvottuja merkintöjä on runsaasti, perinteinen optimointialgoritmi ratkaisee ongelman tai tutkiminen asettaisi ihmiset tai omaisuuden riskiin.
Syvän RL:n arkkitehtuurit ja koulutussignaalit
Syvä vahvistusoppiminen käyttää neuroverkkoja arvofunktion, politiikan, ympäristömallin tai niiden yhdistelmän esittämiseen. Syvä Q-verkko ennustaa toimintoarvot ja oppii aikadiferenssikohteista; kokemuksen uudelleenkäyttö vähentää päivitysten korrelaatiota, kun taas kohdeverkko vakauttaa liikkuvan tavoitteen. Politiikkagradientti-menetelmät optimoivat odotetun tuoton suoraan, ja toimija‑kritiikki-menetelmät käyttävät opittua kritiikkiä gradienttivarianssin vähentämiseksi. Jatkuvat toiminnot vaativat usein deterministisiä tai stokastisia toimija‑kritiikki-variantteja, kun taas diskreetit korkean dimensioiden toiminnot tarvitsevat huolellista tutkimista ja ulostulon suunnittelua.
Koulutus on ei‑stationaari, koska politiikka muuttaa keräämiään dataa. Uudelleenkäytön data muuttuu off-policy‑tilaan, käynnistetyet kohteet riippuvat nykyisistä arvioista, ja funktioiden approksimaatio voi vahvistaa virheitä – yhdistelmää kutsutaan joskus tappavaksi kolmikoksi. Kaksoisarviot vähentävät arvon yliarviointia; etuustoiminnot parantavat ansaintajakoa; entropialisäykset kannustavat tutkimiseen; leikatut tavoitteet rajoittavat tuhoisia politiikkapäivityksiä. Normalisoi havainnot ja palkkiot vain vuoto‑turvallisessa tilassa, ja tallenna ympäristö, wrapper, toiminnon toisto, lopetus ja palkkioiden esikäsittely, koska jokainen muuttaa ongelmaa.
Arviointi, simulaattorit ja käyttöönoton turvallisuus
Raportoi tuottojakaumat eri siemenistä ja ympäristöinstansseista, ei parhaan suorituksen perusteella. Arvioi näytteen tehokkuus, rajoitteiden rikkomukset, katastrofaaliset lopputulokset, herkkyys palkkioiden skaalaan ja kestävyys havaintokohinan, viiveen, toimilaitteen virheen ja muuttuneiden dynamiikkojen suhteen. Vertaa skriptattuun ohjaukseen, klassiseen ohjaukseen, valvottuun jäljittelyyn ja yksinkertaisempaan RL:ään. Pidä ympäristömuunnelmat erillään ja testaa palkkiotta tulosmittareita, koska agentti voi hyödyntää ohjelmoitua palkkiota epäonnistuen suunnitellussa tehtävässä. Video- ja trajektoriaineistot tarkastelu paljastaa usein käyttäytymistä, jota aggregoitu tuotto piilottaa.
Simulaatio mahdollistaa tutkimisen, mutta tuo mukanaan todellisuuden kuilun. Satunnaista olennaista fysiikkaa ja havainnointia, kalibroi todellisia mittauksia vastaan, ja käytä konservatiivista siirtoa. Lokitettu data tai offline‑RL välttää online‑tutkimisen, mutta ei voi luotettavasti arvioida toimintoja, joita käyttäytymispolitiikka ei tue. Tuotantojärjestelmien tulisi rajoittaa toimintojen joukkoa, nopeutta, resursseja ja toimintaympäristöä; vaatia hyväksyntä merkittäville toimille; ja sisällyttää tarkistettu turvallinen ohjain tai pysäytys. Valvo politiikan syötteitä, toimintojakaumaa, palkkioita, todellisia tuloksia ja puuttumisia, ja palauta testattuun politiikkaversioon tarvittaessa.
Konkreettinen ohjausesimerkki
Varastorobotin reititystä varten määrittele tila sijainnin, kuorman, akun, lähialueen liikenteen ja tehtäväjonon perusteella; toiminnot sallituista liikkeistä ja latauspäätöksistä; ja palkkio suoritetusta työstä, energiasta, ruuhkista ja turvallisuusrajoitteista. Kouluta ensin kalibroidussa simulaattorissa satunnaistettujen kysyntöjen ja anturivirheiden kanssa, ja sitten varjosta todellisia päätöksiä. Älä koskaan anna opitun politiikan ohittaa törmäyksenestoa. Arvioi läpäisykykyä yhdessä lähellä tapahtuneiden, lukkiutumisien, akun hätätilanteiden ja pahimman viiveen kanssa. Projekti onnistuu vain, jos kerroksellinen järjestelmä parantaa toimintoja siirtämättä hyväksymätöntä tutkimisriskiä ihmisille tai laitteille.
Työkalu-esimerkki: DRL datakeskuksen jäähdytykseen
Datakeskus rajoittaa RL‑agentin hyväksyttyihin jäähdytyspisteisiin ja kouluttaa sen simulaattorissa, joka on kalibroitu historiallisesta säästä, kuormituksesta, lämpötiloista ja laitteiston vasteesta. Palkkio sisältää energian, mutta kovia rajoitteita suojataan erikseen lämpötilan, kosteuden ja laitteiston sykkeen osalta. Mallipohjainen ohjaus ja olemassa olevat säännöt toimivat vertailukohtina. Arviointi kattaa vuodenaikojen, anturikohinan, toimilaitteiden viiveen, laitteiston menetykset, epätavalliset kuormat ja useita siemeniä, raportoiden energiaa, rikkomuksia, varianssia ja palautumista.
Opittu politiikka toimii varjotilassa ennen rajoitetun alueen koetta. Ulkoinen turvallisuusohjain leikkaa toimintoja ja operaattorit voivat ohittaa. Toimintanopeutta, tilan kattavuutta, mallin epävarmuutta ja todellisia laitostuloksia seurataan; simulaattorin epäsopivuus tai toistuva puuttuminen käynnistää palautuksen. Päivitetty laitteisto tai ohjauslogiikka luo uuden ympäristöversion ja validoinnin. Energiansäästö hyväksytään vain, kun luotettavuus, lämpövaraus, ylläpito ja vikavaste pysyvät vähintään yhtä vahvoina kuin vertailukohta.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän vian seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointisarja ennen viritystä. Testaa tavallisia tapauksia, reunatiloja, virheellisiä tai puuttuvia syötteitä, jakauman siirtymää, riippuvuuksien katkeamista, väärinkäyttöä sekä ryhmiä tai ympäristöjä, jotka todennäköisesti jäävät huomiotta. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpäisykyvyn, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja raja-arvo, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta määritä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, palautukselle ja poistamiselle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varmistus ja varmista valvonta tahallisesti injektoiduilla virheillä. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, ulostulon käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeettomia arkaluontoisia tietoja. Määritä hälytysrajat ja vastuu, tarkastele sitten todellisia todisteita käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina, kun tietolähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilyttämisen menettelyt sekä selkeän pisteen, jossa se tulisi poistaa käytöstä tai korvata.
Usein kysytyt kysymykset
Onko syvä vahvistusoppiminen sama kuin syvä oppiminen?
Ei. Syvä oppiminen tarjoaa funktioiden approksimaattorit; vahvistusoppiminen tarjoaa vuorovaikutuksen, palkkion ja peräkkäisten päätösten tavoitteen.
Merkkaaanko korkealla palkkiolla, että agentti oppi halutun käyttäytymisen?
Ei välttämättä. Se tarkoittaa, että politiikka löysi käyttäytymisen, joka saa hyvän pisteen toteutetussa palkkiojärjestelmässä ja ympäristössä. Riippumattomat turvallisuus- ja tavoiteyhtenäisyystestit ovat edelleen tarpeen.
Ensisijaiset lähteet