
AI:n perusteet
Mitä on vahvistusoppiminen ihmispalautteesta (RLHF)?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Ihmispalautteesta tapahtuva vahvistusoppiminen (RLHF) on menetelmäperhe, joka hyödyntää ihmisten arvioita mallin optimointiin silloin, kun haluttua käyttäytymistä on vaikea määritellä yksinkertaisella automaattisella palkkiolla. Kielenmallien kohdalla ihmiset vertailevat yleensä ehdotettuja vastauksia, ja opittu mieltymysmalli muuntaa nämä vertailut koulutussignaaliksi.
RLHF voi tehdä esikoulutetusta mallista avuliaamman tai paremmin kirjoitettuun politiikkaan soveltuvan, mutta se ei takaa totuudenmukaisuutta tai yhdenmukaisuutta kaikkien käyttäjien kanssa. Tulokseen vaikuttavat se, kuka palautetta antaa, miten kehotteita näytteistetään, mitä palkkimalli pystyy kuvaamaan ja miten optimointi rajoitetaan.
Keskeiset havainnot
- RLHF toteutetaan yleensä esikoulutuksen ja valvotun ohjeistuksen hienosäädön jälkeen.
- Parittaiset mieltymykset kouluttavat palkki- tai mieltymysmallin; politiikan optimointi suosii sen jälkeen korkeampipisteisiä tuloksia.
- Palkkion manipulointi, annotaattorien erimielisyys, jakautuman siirtymä ja yliohjelmointi ovat edelleen merkittäviä riskejä.
- Arvioi lopullinen politiikka suoraan tehtävän laadun, turvallisuuden, kalibroinnin ja alaryhmien vaikutusten osalta.
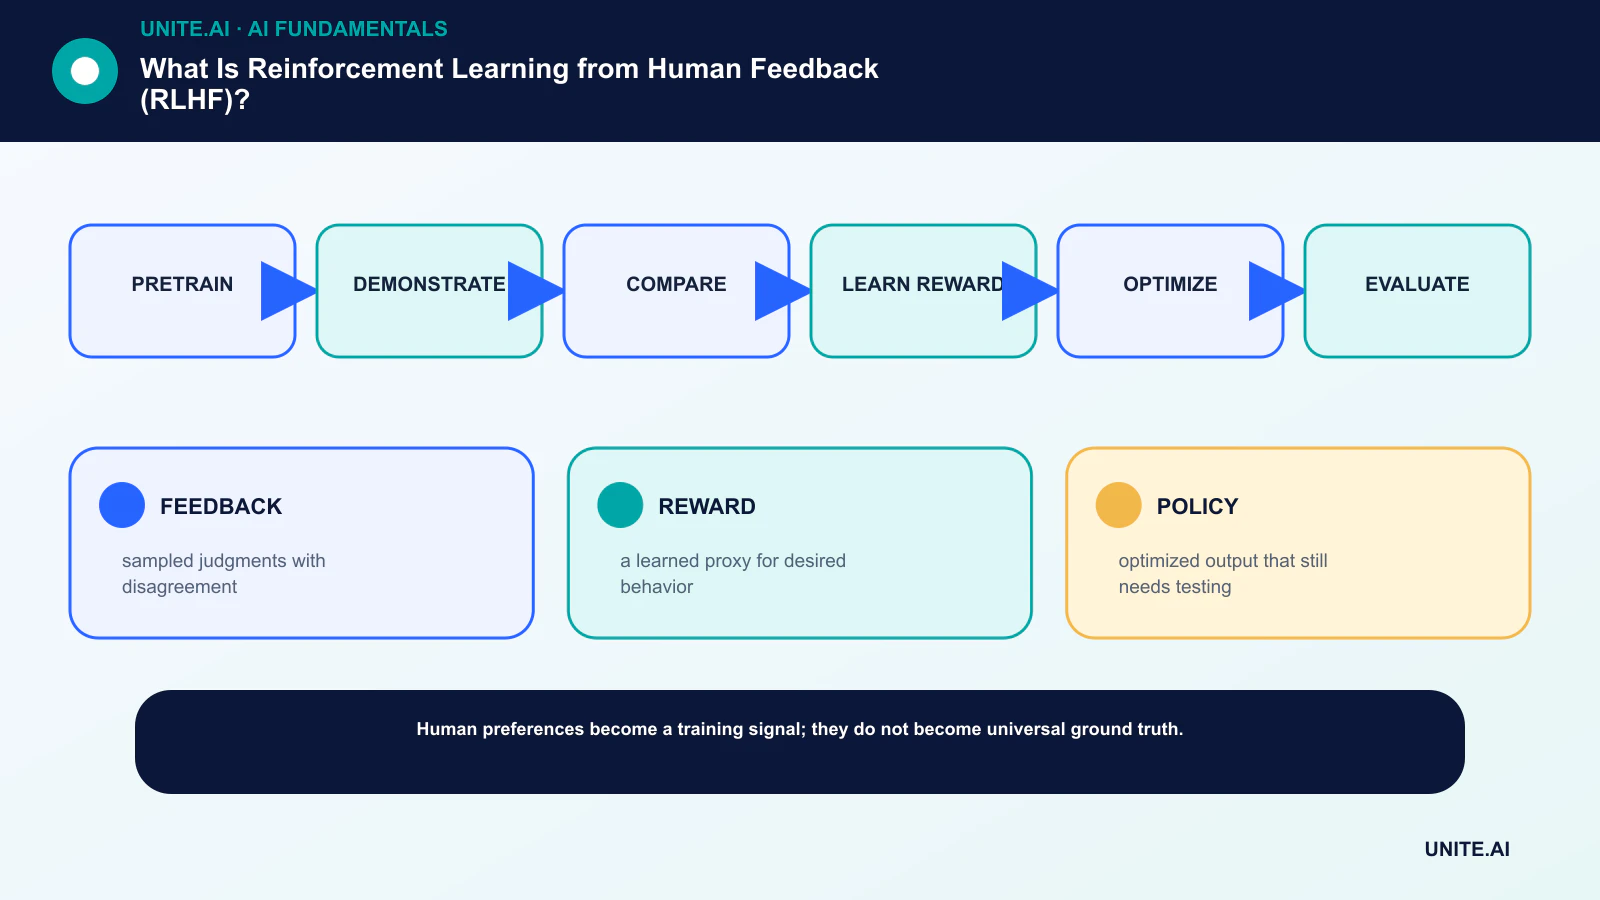
Yleinen RLHF-putki
Kielenmalli oppii aluksi laajan tilastollisen rakenteen esikoulutuksen avulla. Valvotussa hienosäädössä käytetään sitten haluttujen vastausten demonstraatioita. Mieltymyksen keräämisessä annotaattorit asettavat järjestykseen tai valitsevat eri vastauksista saman kehotteen kohdalla.
Palkkimalli oppii ennustamaan nämä vertailut. Vahvistusoppimisalgoritmi, kuten PPO, voi optimoida kielenmallin oppimansa palkkion perusteella, samalla kun rangaistus estää sen poikkeamasta liikaa viitepolitiikasta.
Palaute on mittausta, ei totuusarvoa
Annotaattorit voivat olla eri mieltä, koska ohjeet ovat epäselviä, asiantuntemus vaihtelee tai arvot ovat todellisesti ristiriidassa. Sijainti, puheliaisuus, itsevarmuus ja tyyli voivat vaikuttaa mieltymyksiin. Laadukas ohjelma kouluttaa arvioijia, mittaa sopimuksen, tarkastaa esimerkit ja säilyttää epävarmuuden.
Näytteenotto on myös tärkeää. Jos mieltymysjoukko sulkee pois vaikeat kielet, toimialat tai haitat, palkkimalli ei voi luotettavasti valvoa niitä. Data‑tieteen osaaminen on yhtä tärkeää kuin optimointialgoritmi.
Epäonnistumistilat
Politiikka voi hyödyntää oppimansa palkkion heikkouksia, tuottaen tuloksia, jotka saavat korkeat pisteet ilman, että ne täyttävät taustalla olevan tarkoituksen. Liiallinen optimointi voi vähentää monimuotoisuutta, vahvistaa tiettyä tyyliä tai saada mallin vaikuttamaan itsevarmalta ja suostuvaiselta.
Myös palkkimalli itse voi epäonnistua koulutusjakelunsa ulkopuolella. Tiimien tulisi testata vastustavia kehotteita, faktatarkistustehtäviä, kieltäytymisrajoja, kalibrointia ja käyttäytymistä eri optimointivoimakkuuksilla sen sijaan, että luottaisiin yhteen aggregoituneeseen mieltymysvoittoprosenttiin.
Vaihtoehdot ja täydentävät menetelmät
Suora mieltymysoptimointi oppii mieltymyspareista ilman erillisen politiikan sovittamista verkossa tapahtuvan vahvistusoppimissilmukan kautta. Hylkäysnäytteenotto, valvottu mieltymyshienosäätö, sääntöpohjainen palaute ja prosessivalvonta tarjoavat muita kompromisseja.
Mikään menetelmä ei poista tarvetta kehotteille, haulle, työkaluille ja sovellustason ohjauksille. Jälkikoulutus muokkaa käyttäytymistä; käyttöönotetut järjestelmät tarvitsevat edelleen perusteltua evidenssiä, oikeuksia, seurantaa ja ihmisen eskalointia.
Miten mieltymysmallit koulutetaan
Kehotteelle x ja kahdelle vastaukselle y₁ ja y₂ mieltymysmalli antaa skalaariarvot ja koulutetaan siten, että halutulle vastaukselle annetaan korkeampi arvo. Yleinen häviöfunktio perustuu todennäköisyyteen, että toinen arvo ylittää toisen. Tämä muuntaa lukuisat parittaiset arvostelut funktioksi, joka voi pisteyttää juuri tuotetut vastaukset.
Malli oppii kaikki ne signaalit, jotka ennustavat kerätyt valinnat. Jos arvioijat suosivat itsevarmaa proosaa, pidempiä vastauksia, tiettyjä kulttuurisia normeja tai tuttuja näkökulmia, nämä korrelaatiot voivat muuttua palkkio‑ominaisuuksiksi. Tasapainotetut ohjeet, vastakkaiset esimerkit, asiantuntijakatselmukset ja pintapuolisten mieltymysten tarkastukset vähentävät, mutta eivät poista ongelmaa.
Mieltymysdata voi sisältää tasapelit, rankingit, arvostelut, skalaariarvot tai demonstraatiot. Parivalinta on tärkeä: selvästi erilaisia vastauksia vertailevat vertailut opettavat vähemmän hienovaraisista laaturajapinnoista, kun taas vain vaikeat parit voivat tehdä koulutuksesta epävakaan. Aktiivinen näytteenotto voi kohdistaa informatiivisia erimielisyyksiä, mutta saattaa muuttaa datan jakaumaa.
Politiikan optimointi ja säännöllistäminen
PPO-pohjainen RLHF näyttelee vastauksia nykyisestä politiikasta, pisteyttää ne palkkimallilla ja päivittää politiikkaa odotetun palkkion kasvattamiseksi. Kullback–Leibler -rangaistus tai siihen liittyvä rajoite pitää politiikan lähellä valvottua viitepohjaa, rajoittaen tuhoisaa poikkeamista ja estäen kapeiden palkkimalli‑heikkouksien hyväksikäyttöä.
Optimoinnin voimakkuus on tuotteen valinta. Liian vähäinen ei muuta haluttua käyttäytymistä; liian suuri voi aiheuttaa palkkion manipulointia, toistuvaa ilmaisua, kumartelua tai monimuotoisuuden vähenemistä. Piirrä laadun ja turvallisuusmittarit suhteessa palkkioon ja poikkeamaan koko koulutuksen ajan sen sijaan, että valitsisit tarkistuspisteen pelkän palkkion perusteella.
Suorat mieltymysmenetelmät johdattavat tavoitteet mieltymyspareista ja viitemallista ilman eksplisiittistä verkossa tapahtuvaa vahvistusoppimissilmukkaa. Ne voivat yksinkertaistaa koulutusta, mutta perivät silti mieltymysten laadun, kattavuuden ja viitepolitiikan oletukset. Perustuslakiin perustuva tai tekoälyn tuottama palaute muuttaa, kuka antaa merkintöjä; se ei poista tarvetta vahvistaa arvoja ja epäonnistumisia ihmisten avulla.
Arviointi ja datanhallinta
Käytä sokeita vertailuja, tehtäväkohtaisia testejä, vastustavia kehotteita, faktantarkistuksia, kieltäytymisen tarkkuutta ja palautetta sekä alaryhmien tarkastelua. Erota arvioijat koulutusdatasta mahdollisuuksien mukaan. Voittoprosentti vanhempaa mallia vastaan voi piilottaa absoluuttisia epäonnistumisia, kun molemmat ehdokkaat ovat huonoja.
Dokumentoi annotaattorien rekrytointi, korvaukset, asiantuntemus, maantieteellinen sijainti, kieli, ohjeet, altistuminen haitalliselle sisällölle, erimielisyydet, päätökset ja laadunvalvonta. Palauteprojekti voi aiheuttaa psykologisia riskejä, ja vastuullinen datatoiminta sisältää työntekijöiden tuen sekä oikeuden kieltäytyä häiritsevistä tehtävistä.
Käyttöönoton jälkeen seuraa mieltymyksen poikkeamaa ja yleistämistä. Rentoihin avustustilanteisiin viritetty politiikka voi käyttäytyä huonosti lääketieteellisissä tai oikeudellisissa yhteyksissä. Pidä toimialarajat, haku, oikeudet ja eskalointi RLHF-olettamuksen ulkopuolella, ja uudelleenkouluta vain, kun uudet todisteet oikeuttavat muutoksen.
Konkreettinen RLHF-koulutus- ja arviointiputki
Tyypillinen projekti alkaa esikoulutetulla kielenmallilla ja ohjeistusaineistolla, jota käytetään valvottuun hienosäätöön. Annotaatioiden jälkeen vertaillaan ehdotettuja vastauksia kirjallisen arviointikriteerin mukaan, joka kattaa oikeellisuuden, merkityksellisyyden, tyylin, turvallisuuden ja epävarmuuden. Parittaiset mieltymykset kouluttavat palkkimallin tai optimoivat politiikan suoraan. Näytteenoton tulee sisältää tavallisia tehtäviä, vaikeita reunatapauksia, vastustavia kehotteita, useita kieliä ja alueita, joissa annotaattorit oikeutetusti erimielisiä.
Palkkimallin tarkkuus pidetyn vertailun perusteella on välttämätöntä, mutta ei riittävää. Optimoitu politiikka voi hyväksikäyttää oppimisen virheitä, muuttua liian puheliaaksi, kieltäytyä harmittomista pyynnöistä tai menettää kyvykkyyksiä. Seuraa tehtävävertailuja, ihmisten mieltymyksiä, kalibrointia, turvallisuutta, monimuotoisuutta ja poikkeamaa viitemallista koko koulutuksen ajan. Kerää säännöllisesti uusia vertailuja muuttuvasta politiikasta, jotta mieltymysdata kattaa mallin todellisesti tuottamat vastaukset.
Dokumentoi, kuka antoi mieltymykset, heidän ohjeensa, korvaukset, erimielisyydet, laadunvalvonta sekä kulttuuri- tai toimialarajat. Hyödynnä asiantuntijakatselmoijia, kun virheet voivat aiheuttaa erikoistuneita vahinkoja. Tee punainen tiimi sekä palkkimallille että lopulliselle politiikalle, ylläpidä käyttäytymisregressiotestejä ja toteuta vaiheittainen käyttöönotto. RLHF muokkaa käyttäytymistä mitattujen mieltymysten perusteella; se ei todista totuudenmukaisuutta, poista harhaa tai ratkaise laajempaa ongelmaa, jossa määritellään, mitä mallin tulisi tehdä kaikissa tilanteissa.
Käytännön toteutustarkistuslista
Muunna käsite rajoitetuksi, testattavaksi työnkuluksi: esikoulutus → demonstraatio → vertailu → palkkion oppiminen → optimointi → arviointi. Nimeä vastuuhenkilö, dokumentoi data ja riippuvuudet, luo yksinkertainen perusmalli, aseta hyväksymis- ja pysäytyskriteerit, testaa edustavat epäonnistumiset ja määritä valvonta, palautus ja tarkastus ennen laajuuden laajentamista. Tallenna versiot ja oletukset, jotta toinen tiimi voi toistaa tuloksen ja ymmärtää, mitä on muuttunut.
Ennen käyttöönottoa suorita dokumentoitu valmiusarviointi niiden ihmisten kanssa, jotka rakentavat, ylläpitävät, suojaavat ja joihin järjestelmä vaikuttaa. Testaa normaaleja tapauksia, raja‑ehtoja, riippuvuusvirheitä ja väärinkäyttöä; säilytä todisteet ja ratkaisemattomat riskit. Määritä, kuka voi hyväksyä julkaisun, muuttaa kynnysarvoa, ohittaa tuloksen tai pysäyttää toiminnan. Tarkastele päätöstä uudelleen, kun todelliset tiedot saapuvat, sillä teknisesti onnistunut pilotti ei takaa luotettavaa suorituskykyä laajemmassa mittakaavassa.
- PALAUTE: näytteistetyt arvostelut erimielisyyden kanssa.
- PALKKIO: opittu välimalli halutulle käyttäytymiselle.
- POLIITTIJA: optimoitu tulos, joka tarvitsee edelleen testausta.
Usein kysytyt kysymykset
Onko RLHF sama kuin hienosäätö?
RLHF on jälkikoulutuksen muoto, joka käyttää mieltymyksiin perustuvia palkkioita. Valvottu hienosäätö kouluttaa suoraan kohdetuloksiin; monissa putkissa käytetään molempia.
Tekevätkö RLHF-mallit mallin totuudenmukaiseksi?
Se voi parantaa palautteessa mitattua käyttäytymistä, mutta malli voi silti olla väärä, vakuuttava tai strategisesti hyödyntää palkkiota. Totuudenmukaisuus vaatii suoraa arviointia ja perustaa.
Ensisijaiset lähteet












