
Andersonin kulma
UniTune: Googlen vaihtoehtoinen neuroverkkopohjainen kuvanmuokkaustekniikka

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Keskeiset kohdatUniTune hienosäätää diffuusiomallin yhdellä kuvalla mahdollistaakseen tarkat…
Näytä lisää
- UniTune hienosäätää diffuusiomallin yhdellä kuvalla mahdollistaakseen tarkat tekstiohjatut muokkaukset.
- Toisin kuin DreamBooth tai Textual Inversion, UniTune hylkää molemmat lähestymistavat paremman yksityiskohtien säilyttämisen vuoksi.
- Menetelmä saavuttaa korkean semanttisen erottelun pitäen kasvot ehjinä radikaalien taustamuutosten aikana.
Google Research näyttää lähestyvän tekstipohjaista kuvanmuokkausta useasta suunnasta ja oletettavasti odottaa, mikä lähestymistapa osoittautuu toimivaksi. Heti tämän viikon julkaisun jälkeen heidän Imagic-tutkimuksesta, hakukonejätti on ehdottanut toista latenttiin diffuusioon perustuvaa menetelmää suorittamaan muissa tapauksissa mahdottomia AI-pohjaisia muokkauksia kuvissa tekstikomennoilla, tällä kertaa kutsutaan UniTune.
Pohjautuen esimerkkeihin, jotka on annettu projektin uudessa tutkimuksessa, UniTune on saavuttanut poikkeuksellisen korkean asteen semanttisen asennon ja idean erottamista todellisesta kuvan sisällöstä:

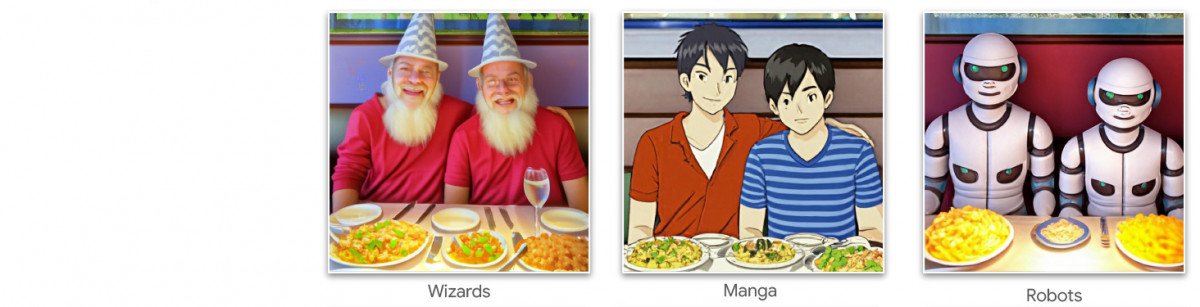

UniTune:n hallinta semanttisesta koostumisesta on erinomainen. Huomaa, miten ylemmässä rivissä kuvissa, kahden henkilön kasvot eivät ole vääristyneet, vaikka lähdekuvan muu sisältö on muuttunut poikkeuksellisen voimakkaasti (oikealla). Lähde: https://arxiv.org/pdf/2210.09477.pdf
Kuten Stable Diffusionin käyttäjät ovat jo huomanneet, kuvan osien muokkaaminen muuttamatta haitallisesti sen muita alueita voi olla vaikeaa, joskus mahdotonta. Vaikka suositut jakelut, kuten AUTOMATIC1111, voivat luoda maskeja paikallisille ja rajoitettujen muokkausten tekemiseksi, prosessi on monimutkainen ja usein epävarmainen.
Ilmeinen vastaus, ainakin konenäön asiantuntijan näkökulmasta, on asettaa välikerros semanttista segmentointia, joka pystyy tunnistamaan ja erottamaan objekteja kuvasta ilman käyttäjän väliintuloa, ja tosiaan on ollut useita uusia aloitteita viime aikoina tämän ajattelutavan mukaisesti.
Toinen mahdollisuus lukitsemaan epäjohdonmukaiset ja sekavat neuronimuokkaustoiminnot on hyödyntää OpenAI:n vaikutusvaltaista Contrastive Language-Image Pre-training (CLIP) -moduulia, joka on latentti-diffuusiomallien, kuten DALL-E 2 ja Stable Diffusion, sydämessä, toimimaan suodattimena siinä vaiheessa, kun tekstistä kuvan tuottava malli on lähettämässä tulkittua kuvaa käyttäjälle. Tässä yhteydessä CLIP toimisi vartijana ja laadunvalvontamoduulina, joka hylkää virheelliset tai muuten sopimattomat renderöinnit. Tämä on tulossa käyttöön (Discord-linkki) Stability.ai:n DreamStudio-portaalissa, joka toimii API:n kautta.
Kuitenkin, koska CLIP on kiistatta sekä syyllinen että ratkaisu tässä skenaariossa (koska se myös kertoi, miten kuva evoluoitui), ja koska laitteiston vaatimukset voivat ylittää, mitä on todennäköisesti saatavilla loppukäyttäjälle, tämä lähestymistapa ei välttämättä ole ihanteellinen.
Pakattu Kieli
Ehdotettu UniTune sen sijaan hienosäätää olemassa olevaa diffuusiomallia – tässä tapauksessa Google:n omaa Imagenia, vaikka tutkijat toteavat, että menetelmä on yhteensopiva muiden latentti-diffuusioiden kanssa – niin, että yksilöivä token injektoitiin siihen, jota voidaan kutsua sisällyttämällä se tekstiprompttiin.
Ensimmäisellä silmäyksellä tämä kuulostaa Googlen DreamBoothilta, joka kiehtoo tällä hetkellä Stable Diffusionin käyttäjiä ja kehittäjiä. Se voi lisätä uusia hahmoja tai esineitä olemassa olevaan mallin tarkistuspisteeseen usein alle tunnissa vain muutaman lähdekuvan pohjalta; tai kuin Tekstuaalinen Inversio, joka luo “sivuvaunutiedostot” mallille, jotka käsitellään niin, kuin ne olisivat alun perin koulutettu malliin, ja voivat hyödyntää mallin omia laajoja resursseja muokkaamalla sen tekstiluokittelijaa, mikä johtaa pieniin tiedostoihin (vertailussa DreamBoothin vähintään 2 GB pruned checkpointeihin).
Todella, tutkijat väittävät, että UniTune hylkäsi molemmat lähestymistavat. He löysivät, että Tekstuaalinen Inversio jätti liian monta tärkeää yksityiskohtaa, kun taas DreamBooth “suoritti huonommin ja kesti kauemmin” kuin ratkaisu, johon he lopulta päätyivät.
Kuitenkin UniTune käyttää samaa kapseloitua semanttista “metaprompt”-lähestymistapaa kuin DreamBooth, jossa koulutetut muutokset kutsutaan yksilöivillä sanoilla, jotka valitaan kouluttajalla, eivätkä ne voi ristiriidassa olemassaolevien termejen kanssa, jotka ovat jo koulutettu julkaistuun malliin.
‘Muokkaustoiminnon suorittamiseksi otamme näyte hienosäädetystä mallista komennolla “[rare_tokens] edit_prompt” (esim. “beikkpic kaksi koiraa ravintolassa” tai “beikkpic minioni”).’
Prosessi
Vaikka on hämärää, miksi kaksi lähes identtistä tutkimusta, joilla on sama lopputoiminto, tulisi Googlelta samalla viikolla, on, vaikka on suuri määrä yhtäläisyyksiä kahden aloitteen välillä, ainakin yksi selkeä ero UniTune ja Imagic välillä – jälkimmäinen käyttää “pakkaamattomia” luonnollisia kieliä ohjaamaan kuvanmuokkaustoimintoja, kun taas UniTune kouluttaa yksilöiviä tokenia DreamBooth-tyylissä.
Jos haluat muokata Imagic:lla ja haluat tehdä muodonmuutoksen tällä tavalla…

UniTune-tutkimuksesta – UniTune asettaa itsensä Google:n suosikkivastustajan neuronimuokkauskehyksen, SDEdit, vastaan. UniTune:n tulokset ovat oikealla, kun taas arvioitu maski on toinen kuva vasemmasta.
… Imagic:ssä syötät ‘kolmas henkilö, istuva taustalla, söpö karvainen hirviö’.
Vastava UniTune-komento olisi ‘Mies takana kuin [x]’, jossa x on outo ja yksilöivä sana, joka on sitoutunut hienosäädettyyn käsitteeseen, joka liittyy karvaiseen hirviöön.
DreamBoothiin tai Textual Inversioniin syötetään useita kuvia, jotta voidaan luoda deepfake-tyylinen abstraktio, joka voidaan ohjata moniin asentoihin. UniTune ja Imagic sen sijaan syöttävät järjestelmään yhden kuvan: alkuperäisen, koskemattoman kuvan.
Tämä on samanlainen kuin monien viime vuosien GAN-pohjaisilla muokkaustyökaluilla, jotka toimivat muuttamalla syötekuvan latenttikoodiksi GANin latentissa avaruudessa ja lähettämällä ne muualle latenttiin avaruuteen muokkauksia varten (esim. syöttämällä nuoren tummatukkaisen henkilön kuvan ja projisoimalla sen “vanha” tai “vaalea” latenttikoodien kautta).
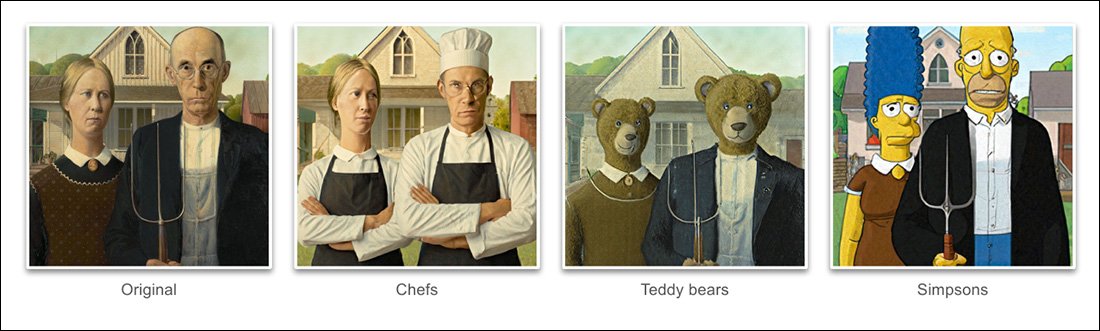
Kuitenkin tulokset, diffuusiomallissa ja tällä menetelmällä, ovat melko hämmästyttävän tarkat vertailussa:
Hienosäätöprosessi
UniTune-menetelmä lähettää alkuperäisen kuvan diffuusiomallin kautta joukon ohjeita, miten se tulisi muuttaa, käyttäen laajoja saatavilla olevia koulutettuja tietoja malliin. Vaikka voit tehdä tämän jo nyt Stable Diffusionin img2img-toiminnallisuuden avulla, mutta et ilman, että myös säilytettäviksi tarkoitetut kuvan osat vääristyvät tai muuttuvat jollakin tavoin.
UniTune-prosessin aikana järjestelmä on hienosäädetty, eli UniTune pakottaa mallin jatkamaan koulutusta, jossa useimmat sen kerrokset on vapautettu jäädytyksestä (ks. alla). Useimmissa tapauksissa hienosäätö laskee mallin yleisiä tappioarvoja korkean suorituskyvyn mallissa, jotta voidaan injektoida tai parantaa jotain toivottua asiaa.
Kuitenkin UniTune:ssa näyttää siltä, että mallin kopio, jota käytetään, vaikka se voi painaa useita gigatavua tai enemmän, kohdellaan kuin hävitettävää “kuorta”, joka hävitetään prosessin lopussa, sen jälkeen, kun se on palvellut yhtä tarkoitusta. Tämänkaltaista data-tonnia on muodostumassa jokapäiväiseksi varastokriisiksi DreamBooth-faneille, joiden omat mallit, jopa leikattuina, ovat vähintään 2 Gt kohdetta kohti.
Kuten Imagic:ssä, pääasiallinen säätö UniTune:ssa tapahtuu kahdella alimmalla kolmesta kerroksesta Imagenissa (perus 64px, 64px>256px ja 256px>1024px). Toisin kuin Imagic, tutkijat näkevät jonkin potentiaalisen arvon säätämiseen myös tämän viimeisen ja suurimman yläresoluutio-kerroksen (vaikka he eivät ole vielä yrittäneet sitä).
Alimmassa 64px-kerroksessa malli on harjoitettu alkuperäisen kuvan kanssa koulutuksen aikana, useita kopioita kuvasta ja tekstistä syötetään järjestelmään 128 iteraation ajan eräkoon ollessa 4, ja Adafactor toimii tappiofunktiona, joka toimii oppimisnopeudella 0,0001. Vaikka T5-koodari on ainoa jäädytetty osa tämän hienosäädön aikana, se on myös jäädytetty Imagenin ensisijaisessa koulutuksessa.
Yllä oleva toiminto toistetaan 64>256px-kerrokselle, käyttäen samaa melun vahvistusmenetelmää, jota käytettiin Imagenin alkuperäisessä koulutuksessa.
Näytteenotto
On olemassa useita mahdollisia näytteenottomenetelmiä, joilla voidaan hakea tehtyjä muutoksia hienosäädetystä mallista, mukaan lukien Classifier Free Guidance (CFG), joka on myös Stable Diffusionin keskeinen osa. CFG määrittää, kuinka paljon malli on vapaa “seuraamaan mielikuvitustaan” ja tutkimaan renderöintimahdollisuuksia – tai toisaalta, matalammilla asetuksilla sitä, kuinka tarkasti sen tulisi noudattaa syötekuvaa ja tehdä vähemmän laajoja tai dramaattisia muutoksia.

Kuten Tekstuaalinen Inversio (vähemmän DreamBooth), UniTune on sovellettavissa eri graafisiin tyyleihin alkuperäisille kuville, sekä fotorealistisiin muokkauksiin.
Tutkijat kokeilivat myös SDEdit:n “myöhäisen aloituksen” tekniikkaa, jossa järjestelmä rohkaistaan säilyttämään alkuperäisiä yksityiskohtia olemalla vain osittain “meluisa” alusta alkaen, mutta säilyttämällä sen olennaiset ominaisuudet. Vaikka tutkijat käyttivät tätä vain alimmassa kerroksessa (64px), he uskovat, että se voisi olla hyödyllinen lisätekniikka tulevaisuudessa.
Tutkijat hyödynsivät myös prompt-to-prompt-tekniikkaa tekstipohjaisena tekniikkana, mallin ehdollistamiseen:
‘Prompt-to-prompt-asetuksessa havaittiin, että tekniikka, jota kutsumme nimellä Prompt Guidance, on erityisen hyödyllinen tarkkuuden ja ilmaisukyvyn säätämisessä.
‘Prompt Guidance on samanlainen kuin Classifier Free Guidance, mutta vertailukohtana on eri kehote ehdollistamattoman mallin sijaan. Tämä ohjaa mallia deltaan kahden promptin välillä.’

Prompt-to-prompt UniTune:ssa, joka eristää alueita muokattaviksi.
Kuitenkin prompt-ohjaus, jonka tutkijat toteavat, tarvittiin vain silloin tällöin, kun CFG epäonnistui saavuttamaan toivottu tulos.
Toinen uusi näytteenottotekniikka, jota kehitettiin UniTune:n kehityksen aikana, oli interpolointi, jossa kuvan alueet ovat tarpeeksi erillisiä, jotta sekä alkuperäinen että muokattu kuva ovat hyvin samanlaisia koostumukseltaan, mikä mahdollistaa “naiivimman” interpoloinnin käytön.

Interpolointi voi tehdä UniTune:n korkeampien ponnistelujen tarpeettomiksi tapauksissa, joissa muokattavat alueet ovat erillisiä ja hyvin rajattuja.
Tutkijat ehdottavat, että interpolointi voi toimia niin hyvin, että se voisi olla oletusasetuksena, ja huomauttavat myös, että se voi aiheuttaa poikkeuksellisia muodonmuutoksia tapauksissa, joissa monimutkaiset peittämiset eivät vaadi intensiivisempiä menetelmiä.
UniTune voi suorittaa paikallisia muokkauksia ilman tai muokkausmaskien kanssa, ja se voi myös päättää yksipuolisesti, minne muokkaukset sijoitetaan, epätavallisen yhdistelmän tulkinnan voimaa ja perusdatan vahvaa esittämistä:

Ylimmässä kuvassa toisessa sarakkeessa UniTune on tehtäväksi “punainen juna taustalla” ja asettanut sen soveliaaseen ja aitoon asemaan. Huomaa, miten muissa esimerkeissä semanttinen eheys säilyy alkuperäisessä kuvassa, vaikka kuvan sisältö ja ydin tyylit muuttuvat tavalla, joka on poikkeuksellinen.
Viive
Vaikka ensimmäinen iterointi uudesta järjestelmästä on aina hidas, ja vaikka on mahdollista, että joko yhteisön osallistuminen tai yrityksen sitoutuminen (se ei yleensä ole molempia) voi lopulta nopeuttaa ja optimoida resursseja vaativan prosessin, sekä UniTune että Imagic suorittavat joitakin melko suuria koneoppimisen manööverejä luodakseen nämä upean muokkaukset, ja on epävarmaa, kuinka paljon tällainen resursseja vaativa prosessi voisi koskaan olla skaalattavissa kotikäyttöön, sen sijaan kuin API-ohjattuun käyttöön (vaikka jälkimmäinen voi olla Googlelle mieluisampi).
Tällä hetkellä koko prosessi syötteestä tulokseen on noin 3 minuuttia T4-grafiikkaprosessorilla, ja noin 30 sekuntia lisää inferencea varten (kuten minkä tahansa inference-rutiinin kohdalla). Tutkijat myöntävät, että tämä on korkea viive, ja tuskin kelpaa “interaktiiviseksi”, mutta he myös huomauttavat, että malli säilyy käytettävissä muokkausten tekemiseen kerran, kun se on alun perin säädetty, kunnes käyttäjä on valmis prosessin kanssa, mikä vähentää kunkin muokkauksen aikaa.
Julkaistu ensimmäisen kerran 21. lokakuuta 2022.


