
Andersonin kulma
Tekoälyavusteinen objektin muokkaus Googlen Imagicilla ja Runwayn ‘Erase and Replace’ -toiminnolla

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa

Tällä viikolla kaksi uutta, mutta erilaista tekoälypohjaista grafiikka-algoritmia tarjoavat uusia tapoja loppukäyttäjille tehdä erittäin hienojakoisia ja tehokkaita muutoksia valokuvien objekteihin.
Ensimmäinen on Imagic, Google Researchin projekti yhteistyössä Israelin Teknillisen instituutin ja Weizmannin tiedeinstituutin kanssa. Imagic tarjoaa tekstin perusteella tapahtuvaa, hienojakoista objektin muokkausta diffuusiomallien hienosäätämisen avulla.

Muuta mitä haluat ja jätä loput – Imagic lupaa hienojakoista muokkausta vain niihin osiin, jotka haluat muuttaa. Lähde: https://arxiv.org/pdf/2210.09276.pdf
Kuka tahansa, joka on yrittänyt muuttaa vain yhtä elementtiä Stable Diffusion -uudelleenrenderöinnissä, tietää liian hyvin, että jokaisen onnistuneen muokkauksen yhteydessä järjestelmä muuttaa viisi asiaa, joista pidit juuri sellaisina kuin ne olivat. Tämä puute saa tällä hetkellä monet lahjakkaat SD-harrastajat jatkuvasti vaihtamaan Stable Diffusionin ja Photoshopin välillä korjatakseen tällaisen ‘sivuvaikutuksen’. Pelkästään tästä näkökulmasta Imagicin saavutukset vaikuttavat merkittäviltä.
Kirjoitushetkellä Imagicilla ei vielä ole edes promootiovideota, ja ottaen huomioon Googlen varovainen asenne rajoittamattomien kuvageneraattorityökalujen julkaisemiseen, on epävarmaa, missä määrin, jos lainkaan, saamme mahdollisuuden testata järjestelmää.
Toinen tarjonta on Runway ML:n melko helpommin lähestyttävä Erase and Replace -toiminto, uusi ominaisuus sen täysin verkossa toimivan koneoppimiseen perustuvan visuaalisten tehosteiden työkalupakin ‘AI Magic Tools’ -osiossa.
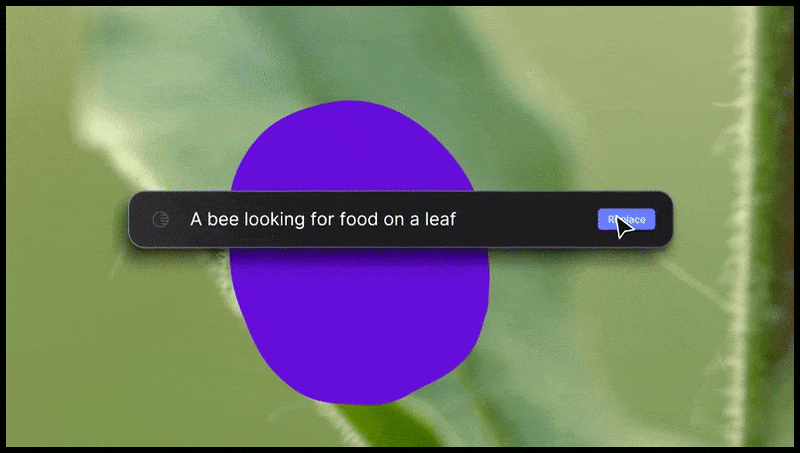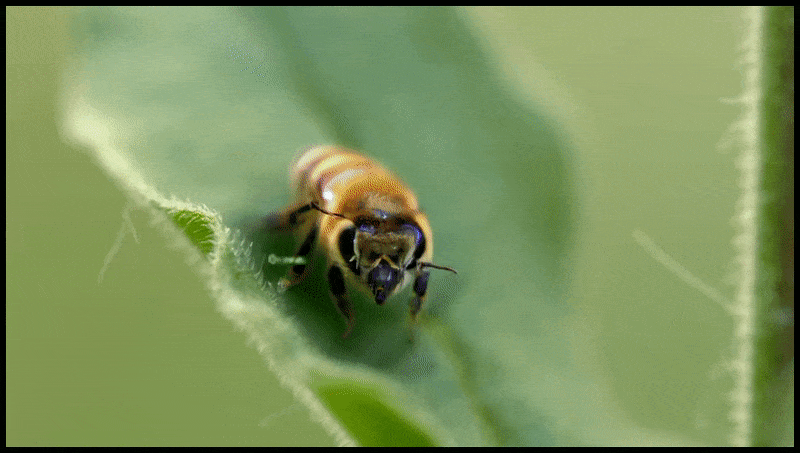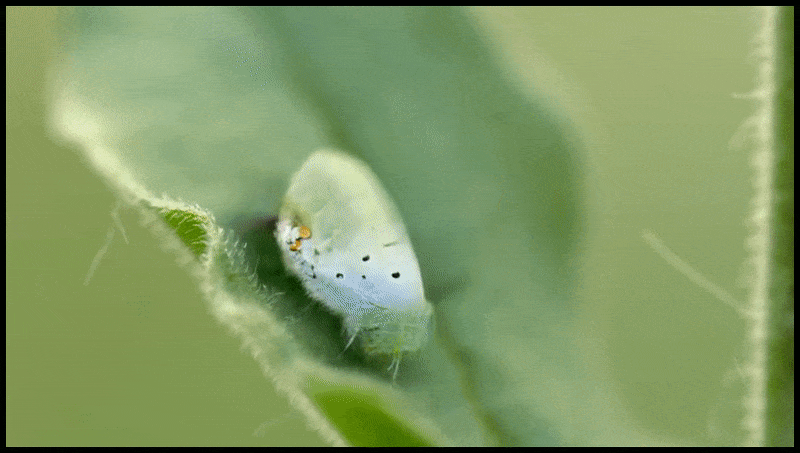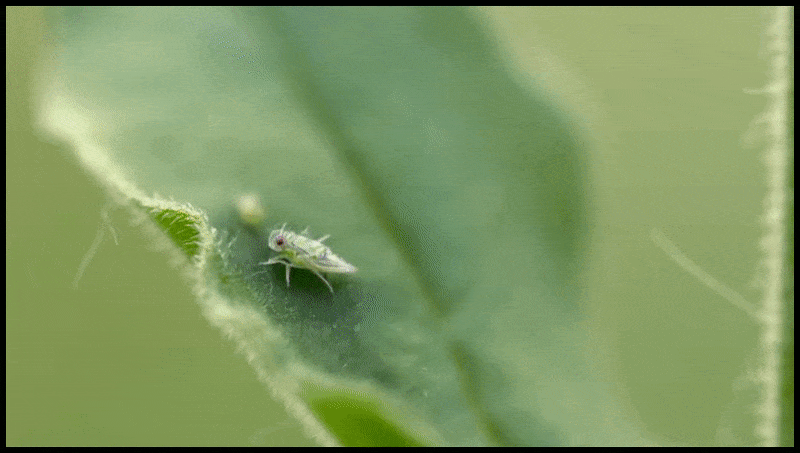
Runway ML:n Erase and Replace -toiminto, joka on jo nähty esikatselussa tekstistä videoon -muokkausjärjestelmälle.
Katsotaanpa ensin Runwayn esittelyä.
Poista ja korvaa
Kuten Imagic, Poista ja korvaa käsittelee yksinomaan staattisia kuvia, vaikka Runway on esikatsellut samaa toiminnallisuutta tekstistä videoon -muokkausratkaisussa, jota ei ole vielä julkaistu:
Vaikka kuka tahansa voi testata uutta Poista ja korvaa -toimintoa kuvissa, videoversio ei ole vielä julkisesti saatavilla. Lähde: https://twitter.com/runwayml/status/1568220303808991232
Vaikka Runway ML ei ole julkaissut tietoja Poista ja korvaa -toiminnon taustalla olevista teknologioista, nopeus, jolla voit korvata huonekasvin melko vakuuttavalla Ronald Reaganin patsaan, viittaa siihen, että diffuusiomalli kuten Stable Diffusion (tai paljon epätodennäköisemmin lisensoitu DALL-E 2) on se moottori, joka uudelleenluo valitsemasi objektin Poista ja korvaa -toiminnossa.

Huonekasvin korvaaminen The Gipperin patsaan ei ole aivan yhtä nopeaa kuin tämä, mutta se on melko nopeaa. Lähde: https://app.runwayml.com/
Järjestelmällä on joitakin DALL-E 2 -tyyppisiä rajoituksia – kuvat tai teksti, jotka merkitsevät Poista ja korvaa -suodattimia, laukaisevat varoituksen mahdollisesta tilin keskeytyksestä, jos rikkomuksia jatkuu – käytännössä OpenAI:n DALL-E 2:lle suunnattujen käytäntöjen perusmallin.
Monet tulokset puuttuvat tyypillisiltä Stable Diffusionin karheilta reunoilta. Runway ML on sijoittajia ja tutkimuskumppaneita SD:ssä, ja on mahdollista, että he ovat kouluttaneet omaehtoisen mallin, joka on parempi kuin avoimen lähdekoodin 1.4 tarkistuspistepainot, joiden kanssa me muut tällä hetkellä kamppailemme (koska monet muut kehitysryhmät, harrastajat ja ammattilaiset, kouluttavat tai hienosäätävät parhaillaan Stable Diffusion -malleja).
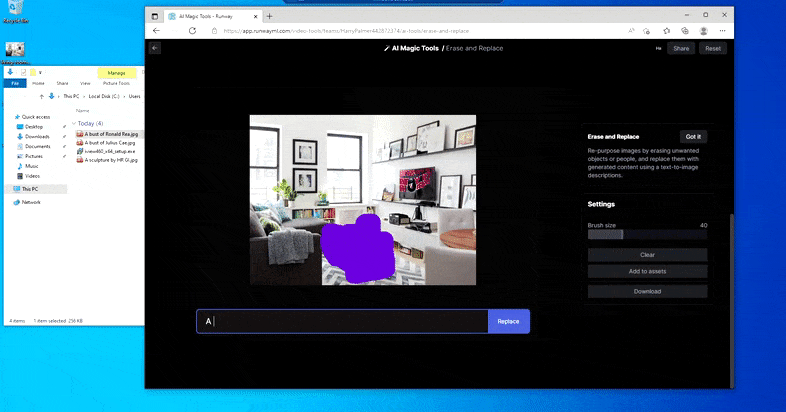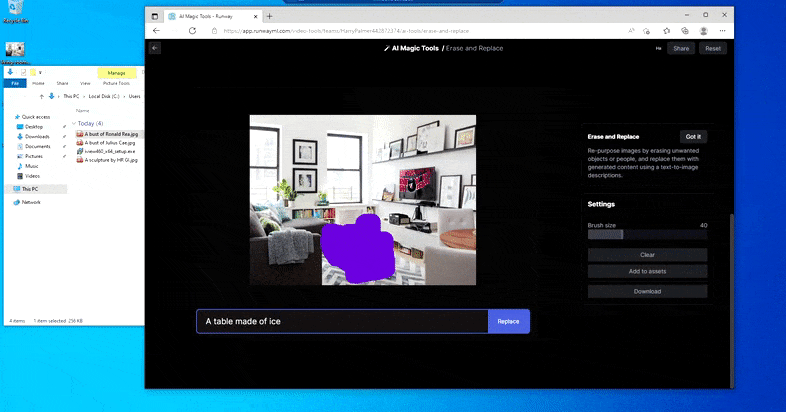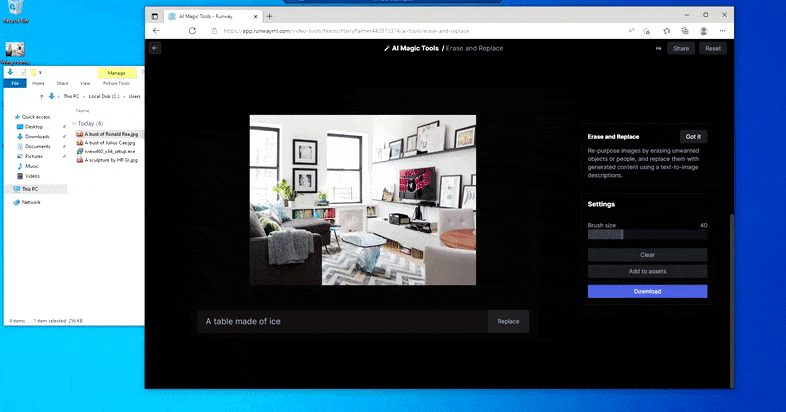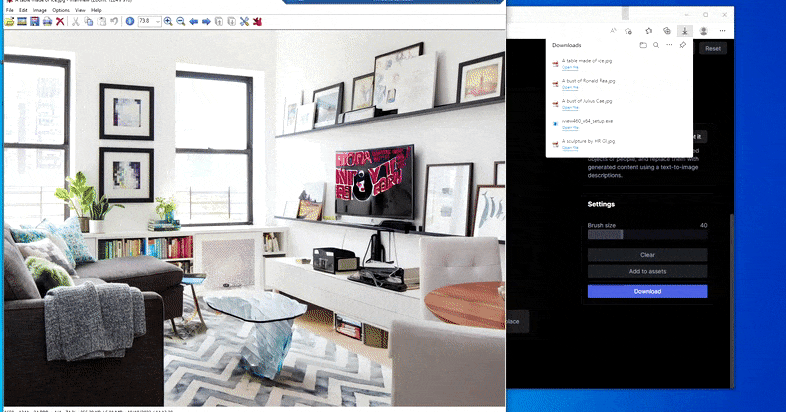
Kotipöydän korvaaminen ‘jääpöydällä’ Runway ML:n Poista ja korvaa -toiminnossa.
Kuten Imagic (katso alapuolelta), Poista ja korvaa on ikään kuin ‘objekti-orientoitu’ – et voi vain poistaa ‘tyhjää’ osaa kuvasta ja täyttää sitä tekstikomentosi tuloksella; tällöin järjestelmä piirtää yksinkertaisesti lähimmän näkyvän objektin maskin näkökentän mukaan (kuten seinän tai television) ja soveltaa muunnosta sinne.
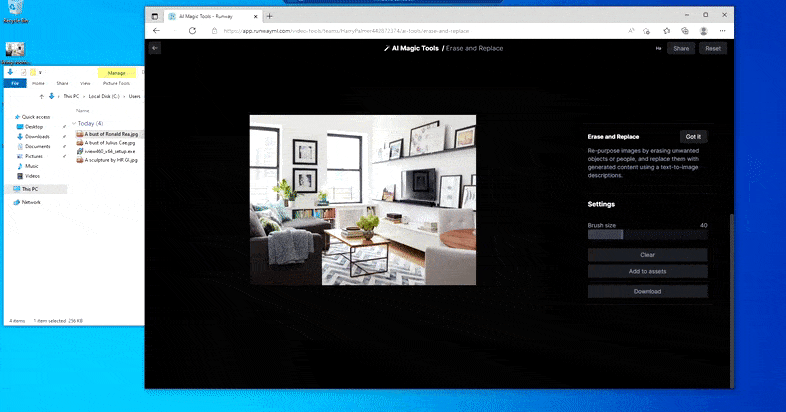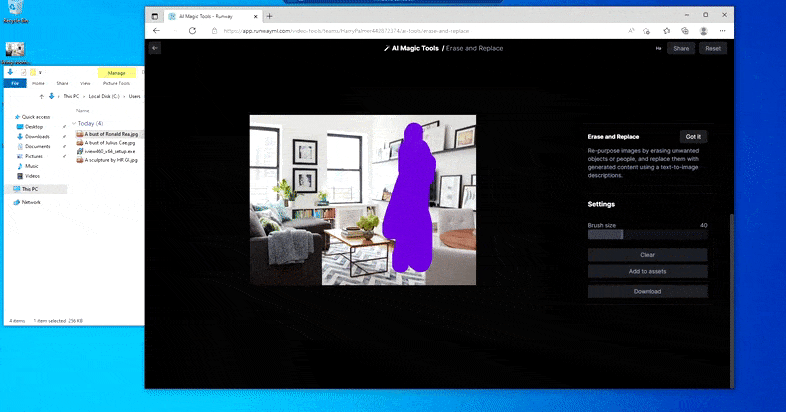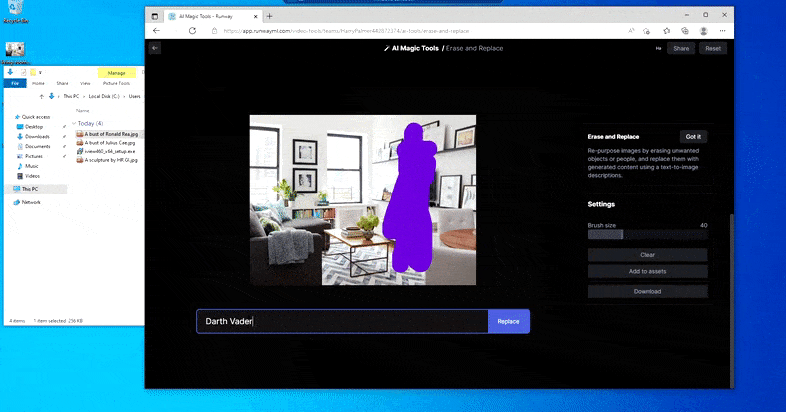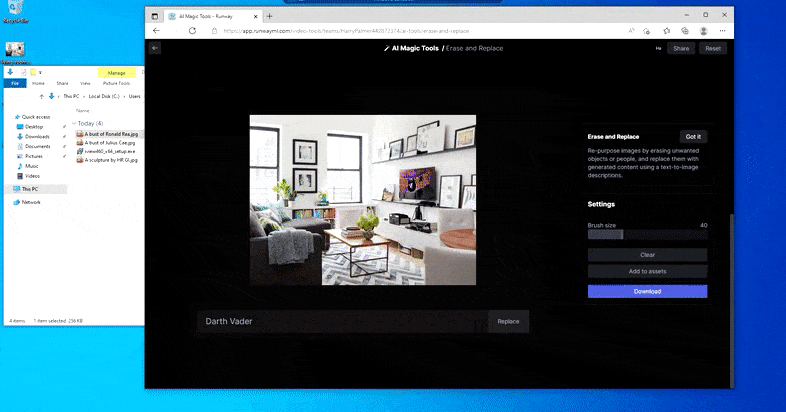
Kuten nimi kertoo, et voi injektoida objekteja tyhjään tilaan Poista ja korvaa -toiminnossa. Tässä yritys kutsua kuuluisinta Sith-hallitsijaa johtaa outoon Vaderiin liittyvään maalaustauluun televisiossa, suunnilleen siellä missä ‘korvaa’-area piirrettiin.
On vaikea sanoa, vältteleekö Poista ja korvaa tekijänoikeudellisesti suojattujen kuvien käyttöä (jotka ovat edelleen suurelta osin estettyjä, vaikka menestys vaihtelee, DALL-E 2:ssa), vai onko taustassa käytettävä renderöintimoottorin malli yksinkertaisesti optimoimaton tällaista varten.

Hieman NSFW ‘Nicole Kidman -maalaus’ osoittaa, että (oletettavasti) diffuusioon perustuva malli ei sisällä DALL-E 2:n aiempaa järjestelmällistä kieltäytymistä realististen kasvojen tai seksuaalisen sisällön renderöinnistä, kun taas tekijänoikeudellisesti suojattujen teosten esittämisen yritykset vaihtelevat epämääräisestä (‘xenomorph’) absurdimpaan (‘rautasatama’). Alareunassa oikealla on lähdekuva.
Olisi mielenkiintoista tietää, mitä menetelmiä Poista ja korvaa käyttää eristääkseen objektit, joita se pystyy korvaamaan. Oletettavasti kuva käydään läpi jonkinlaisella CLIP-johdannaisella, jossa erilliset kohteet tunnistetaan objektintunnistuksen ja myöhemmän semanttisen segmentoinnin avulla. Mikään näistä toiminnoista ei toimi lähelläkään yhtä hyvin tavallisessa Stable Diffusion -asennuksessa.
Mutta mikään ei ole täydellistä – joskus järjestelmä näyttää poistavan eikä korvaavan, vaikka (kuten yllä olevassa kuvassa näimme) taustalla oleva renderöintimekanismi varmasti tietää, mitä tekstikomento tarkoittaa. Tässä tapauksessa on mahdotonta muuttaa kahvipöytää xenomorphiksi – pöytä vain katoaa.
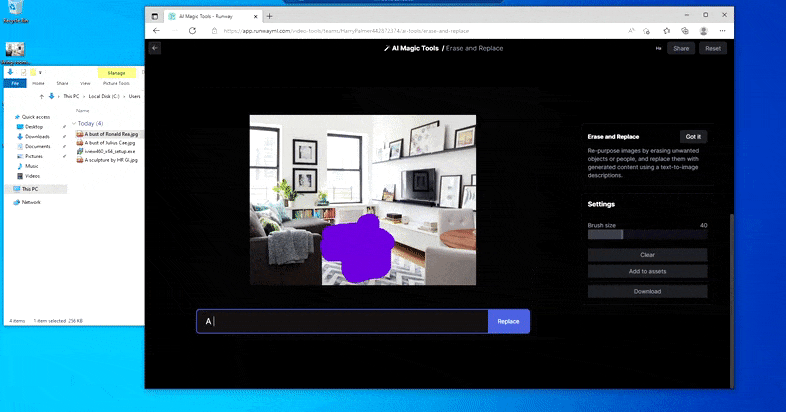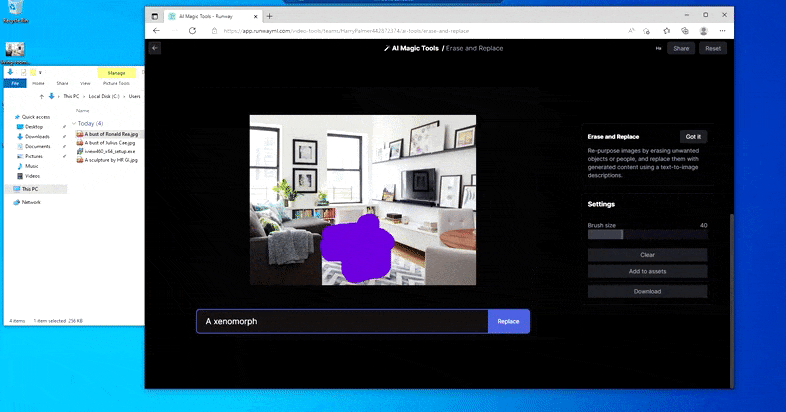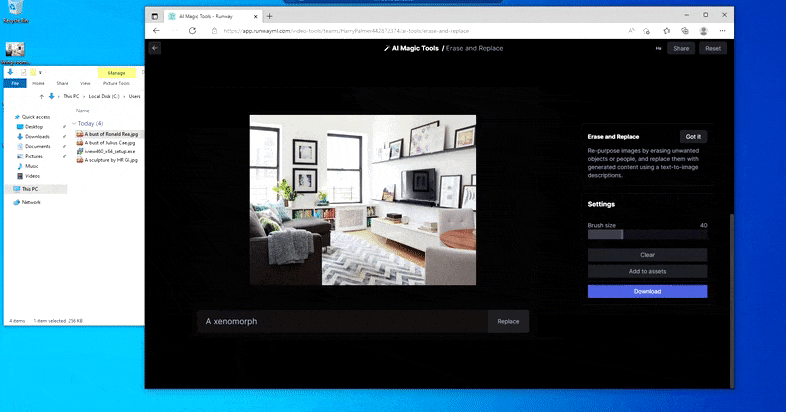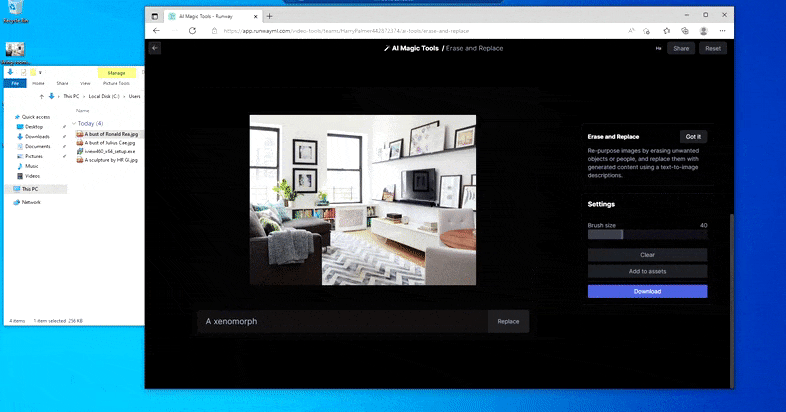
Kauhempi versio ‘Missä on Waldo’, kun Poista ja korvaa ei onnistu tuottamaan alienia.
Poista ja korvaa vaikuttaa tehokkaalta objektin korvausjärjestelmältä, jossa on erinomainen täyte (inpainting). Kuitenkin se ei pysty muokkaamaan olemassa olevia havaittuja objekteja, vaan vain korvaamaan ne. Olemassa olevan kuvasisällön muokkaaminen ilman ympäröivän materiaalin heikentämistä on kiistatta paljon vaikeampi tehtävä, joka liittyy tietokonenäön tutkimussektorin pitkään kamppailuun kohti erottelua suosittujen kehysten eri latenttialoissa.
Imagic
Se on tehtävä, johon Imagic vastaa. Uusi julkaisu tarjoaa lukuisia esimerkkejä muokkauksista, jotka onnistuneesti korjaavat valokuvan yksittäisiä osia jättämättä muuta kuvaa koskematta.

Imagicissa muokatut kuvat eivät kärsi tyypillisestä venymisestä, vääristymisestä ja ‘peittokyvyn arvaamisesta’, jotka ovat syvävalokuvien nukke-tekniikan ominaisia ja jotka hyödyntävät rajoitettuja ennakkotietoja yhdestä kuvasta.
Järjestelmä käyttää kolmen vaiheen prosessia – tekstin upotuksen optimointi; mallin hienosäätö; ja lopuksi muokattujen kuvien generointi.

Imagic koodaa kohdetekstikomenton saadakseen alkuperäisen tekstin upotuksen, ja sitten optimoi tuloksen saadakseen syötekuvan. Tämän jälkeen generatiivinen malli hienosäädetään lähdekuvaan, lisäten joukon parametreja, ennen kuin sitä sovelletaan pyydettyyn interpolointiin.
Ei ole yllättävää, että kehys perustuu Googlen Imagen-tekstistä videoon -arkkitehtuuriin, vaikka tutkijat toteavat, että järjestelmän periaatteet ovat laajasti sovellettavissa latentteihin diffuusiomalleihin.
Imagen käyttää kolmitasoinen arkkitehtuuria, toisin kuin yrityksen äskettäin tekstistä videoon -versiossa käytetty seitsemänkerroksinen järjestelmä. Kolme erillistä moduulia koostuvat generatiivisesta diffuusiomallista, joka toimii 64×64 pikselin resoluutiolla; superresoluutiomallista, joka skaalaa tämän tuloksen 256×256 pikseliin; ja lisäsuperresoluutiomallista, joka nostaa tuloksen 1024×1024 pikseliin.
Imagic puuttuu tähän prosessin varhaisimpaan vaiheeseen optimoimalla pyydetyn tekstin upotuksen 64px-vaiheessa Adam-optimointialgoritmilla, jonka vakio oppimisnopeus on 0,0001.

Mestari erottelussa: ne loppukäyttäjät, jotka ovat yrittäneet muuttaa jotain niin yksinkertaista kuin renderöidyn objektin väriä diffuusio-, GAN- tai NeRF-mallissa, tietävät, kuinka merkittävää on, että Imagic pystyy suorittamaan tällaisia muunnoksia rikkomatta kuvan muun sisällön johdonmukaisuutta.
Hienosäätö tapahtuu sitten Imagenin perusmallilla, 1500 askeleen ajan per syötekuva, ehdollistettuna tarkistetulla upotuksella. Samanaikaisesti toissijaista 64px>256px-kerrosta optimoidaan rinnakkain ehdollisella kuvalla. Tutkijat huomauttavat, että vastaava optimointi lopulliselle 256px>1024px-kerrokselle ei vaikuta lainkaan lopputulokseen, eikä sitä siten ole toteutettu.
Julkaisussa todetaan, että optimointiprosessi kestää noin kahdeksan minuuttia jokaiselle kuvalle kahdella TPUV4-sirulla. Lopullinen renderöinti tapahtuu Imagenin ytimessä DDIM-näytteenottokaavion mukaisesti.
Samankaltaisten Googlen DreamBooth-hienosäätöprosessien kanssa, syntyneitä upotuksia voidaan lisäksi käyttää tyylittelyyn sekä valokuvarealistisiin muokkauksiin, jotka sisältävät tietoa Imagenin laajemmasta taustatietokannasta (koska, kuten alla oleva ensimmäinen sarake osoittaa, lähdekuvissa ei ole tarvittavaa sisältöä näiden muunnosten toteuttamiseksi).

Joustavaa valokuvarealistista liikettä ja muokkauksia voidaan saada Imagicin avulla, samalla kun prosessissa saatuja johdettuja ja eriytettyjä koodeja voidaan yhtä helposti käyttää tyyliteltyyn tuotokseen.
Tutkijat vertasivat Imagicia aikaisempiin töihin SDEdit, vuonna 2021 kehitettyyn GAN-pohjaiseen lähestymistapaan, jonka toteuttivat Stanford University ja Carnegie Mellon University; sekä Text2Live, huhtikuussa 2022 toteutettuun yhteistyöhön Weizmann Institute of Science:n ja NVIDIA:n välillä.

Visuaalinen vertailu Imagicin, SDEditin ja Text2Liven välillä.
On selvää, että aikaisemmat lähestymistavat kamppailevat, mutta alimmassa rivissä, jossa tapahtuu massiivinen asennon muutos, kilpailijat epäonnistuvat täysin lähdeaineiston uudelleenmuodostamisessa, kun taas Imagic saavuttaa merkittävän onnistumisen.
Imagicin resurssivaatimukset ja koulutusaika per kuva, vaikka lyhyet kyseisten tavoitteiden mittakaavassa, tekevät siitä epätodennäköisen lisäyksen paikalliseen kuvankäsittelysovellukseen henkilökohtaisilla tietokoneilla – eikä ole selvää, missä määrin hienosäätöprosessi voitaisiin skaalata kuluttajatason sovelluksiin.
Tällä hetkellä Imagic on vaikuttava ratkaisu, joka sopii paremmin API-rajapintoihin – ympäristöön, jossa Google Research, varovainen syvävalokuvien mahdollistamisesta aiheutuvan kritiikin suhteen, saattaa olla mukavampi.
Ensimmäinen julkaisu 18. lokakuuta 2022.


