
Andersonin kulma
RigNeRF: uusi neuraalisia säteilykenttiä käyttävä deepfake-menetelmä

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa

Keskeiset kohdatRigNeRF on ensimmäinen käyttökelpoinen deepfakes-menetelmä, joka käyttää Neural…
Näytä lisää
- RigNeRF on ensimmäinen käyttökelpoinen deepfakes-menetelmä, joka käyttää Neural Radiance Fields -tekniikkaa 3DMM-ohjauksella.
- Järjestelmä vaatii harjoitteluun vain 70 sekunnin älypuhelinvideon, toisin kuin työläät autoencoder-tietoaineistot.
- RigNeRF mahdollistaa koko kohtauksen synteesin, mukaan lukien vartalon ja taustan, eikä pelkästään kasvojen vaihtamisen.
Uusi tutkimus, joka on kehitetty Adobessa, tarjoaa ensimmäisen toimivan ja tehokkaan deepfake-menetelmän, joka perustuu neuraalisiin säteilykenttiin (NeRF) – ehkä ensimmäinen oikea innovaatio arkkitehtuurissa tai lähestymistavassa viiden vuoden aikana siitä, kun deepfakes ilmaantui vuonna 2017.
(ADBE )Menetelmä, joka on nimetty RigNeRF, käyttää 3D-muokattavia kasvomalleja (3DMM) välittävänä ohjauskerroksena halutun syötteen (ts. identiteetin, joka halutaan lisätä NeRF-renderiin) ja neuronaalisen avaruuden välillä, menetelmä, joka on laajalti hyväksytty viime vuosina Generative Adversarial Network (GAN) -kasvosynteesilähestymistavoissa, joista mikään ei ole vielä tuottanut toimivia ja hyödyllisiä kasvonkorvauskehyksiä videoille.
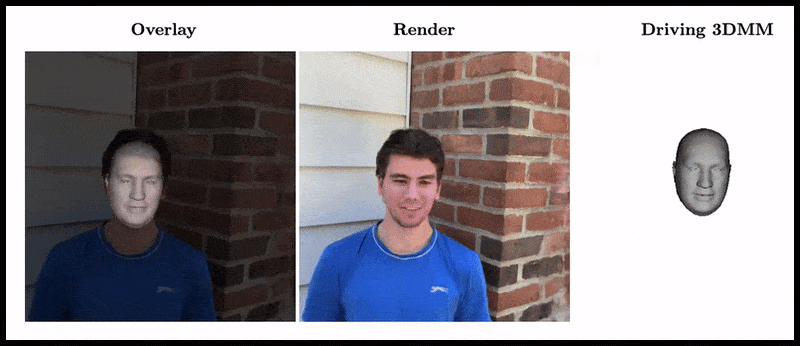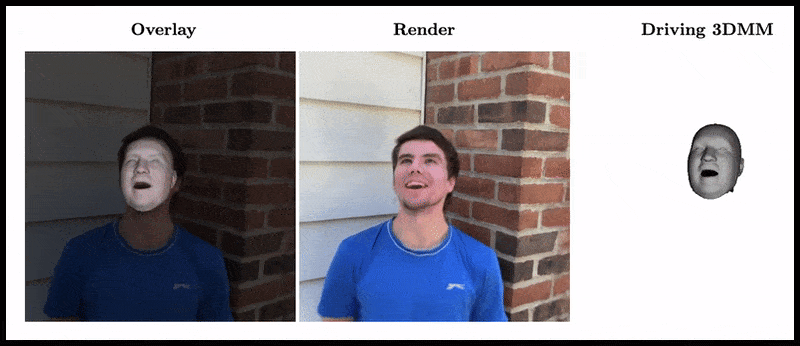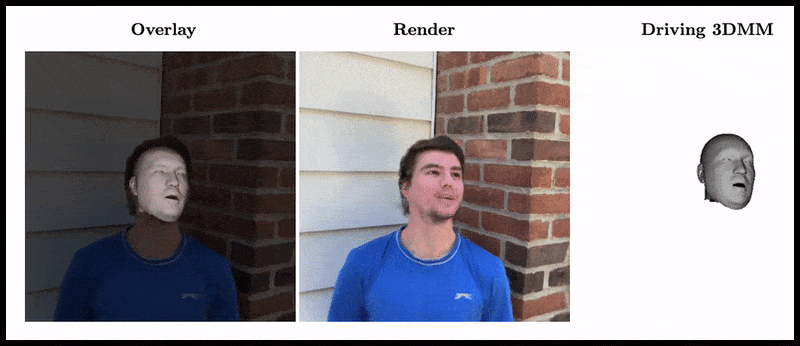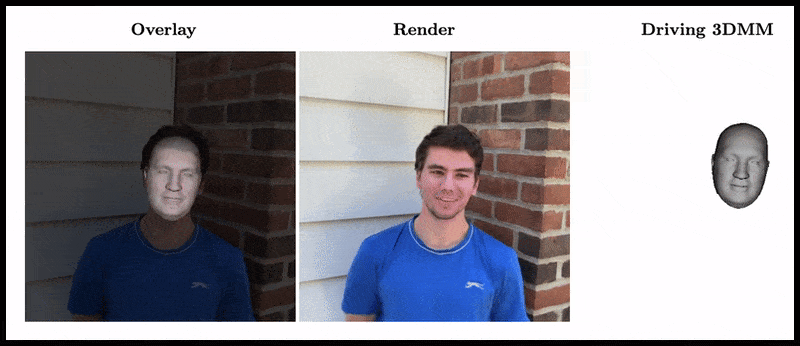
Toisin kuin perinteisissä deepfake-videoissa, mikään tässä näkyvä liikkuva sisältö ei ole oikeaa, vaan kyseessä on lyhyellä videolla koulutettu tutkittava neuraalinen avaruus. Oikealla 3D-muuntuva kasvomalli (3DMM) toimii rajapintana haluttujen muokkausten (hymyile, katso vasemmalle, katso ylös jne.) ja neuraalisen säteilykentän visualisoinnin tavallisesti vaikeasti hallittavien parametrien välillä. Tämän leikkeen tarkempi versio ja muita esimerkkejä löytyvät projektisivulta tai artikkelin lopun upotetuista videoista. Lähde: https://shahrukhathar.github.io/2022/06/06/RigNeRF.html
3D-muokattavat kasvomallit ovat käytännössä CGI-malleja, joiden parametreja voidaan sovittaa abstraktimpiin kuvasynteesijärjestelmiin, kuten NeRF ja GAN, jotka ovat muuten vaikeasti ohjattavissa.
Mitä näet yllä olevassa kuvassa (keskikuva, mies sinisessä paidassa), sekä alla olevassa kuvassa (vasen kuva, mies sinisessä paidassa), ei ole “oikeaa” videota, johon on lisätty “väärennös”-kasvo, vaan täysin syntetisoitu kohtaus, joka on olemassa ainoastaan volumetrinen neuronaalinen renderöinti – mukaan lukien keho ja tausta:
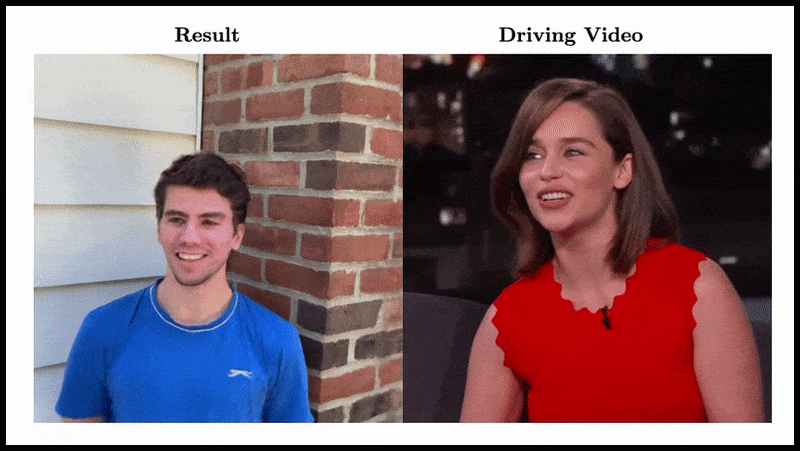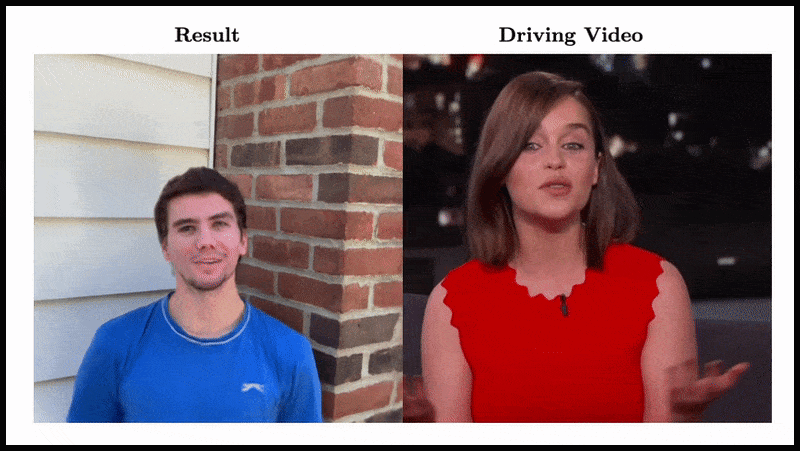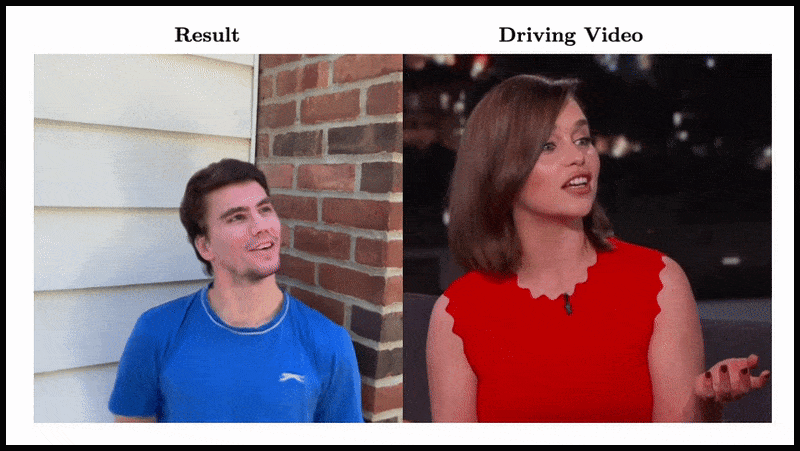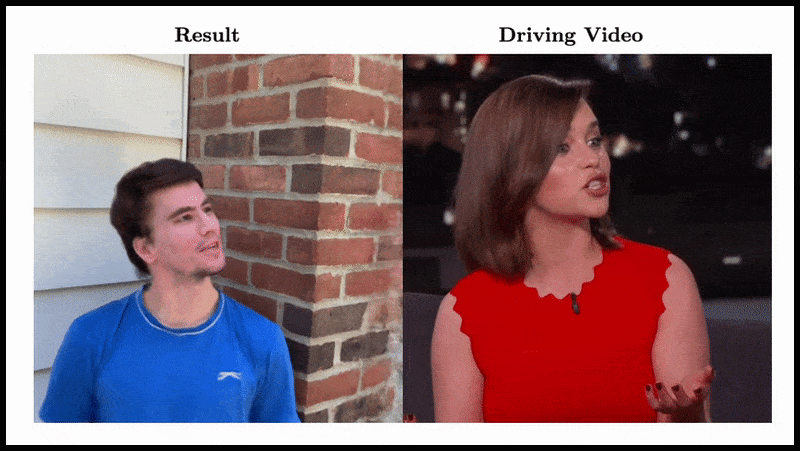
Yllä olevassa esimerkissä oikealla olevaa aitoa videota (nainen punaisessa mekossa) käytetään ohjaamaan vasemmalle tallennettua identiteettiä (mies sinisessä paidassa) RigNeRF:n avulla, joka (kirjoittajat väittävät) on ensimmäinen NeRF-pohjainen järjestelmä, joka saavuttaa asennon ja ilmeen erottamisen ja pystyy syntetisoimaan uusia näkymiä.
Miehen hahmo vasemmalla puolella yllä olevassa kuvassa “tallennettiin” 70 sekunnin mittaisesta älypuhelinvideosta, ja syöteaineisto (mukaan lukien koko kohtausinformaatio) koulutettiin neljällä V100-grafiikkaprosessorilla saadakseen kohtauksen.
Koska 3DMM-tyyppiset parametrinen kehykset ovat myös saatavilla kokonaisen kehon parametrinen CGI-välikappale (eikä ainoastaan kasvojen kehyksiä), RigNeRF voi avata mahdollisuuden koko kehon deepfake-videoihin, joissa oikean ihmisen liike, pintatekstuuri ja ilme siirretään CGI-pohjaiseen parametriseen kerrokseen, joka kääntäisi toiminnan ja ilmeen NeRF-ympäristöihin ja videoihin.
Mitä tulee RigNeRF:ään – onko se deepfake-menetelmä nykyisessä merkityksessä, jossa otsikot ymmärtävät termin? Vai onko se vain toinen puolivillainen, puutteellinen järjestelmä DeepFaceLabiin ja muihin vuonna 2017 kehitettyihin autoencoder-pohjaisiin deepfake-järjestelmiin?
Uuden tutkimuksen tutkijat ovat yksiselitteisiä tässä suhteessa:
‘Koska RigNeRF pystyy elävöittämään kasvoja, pahantahtoiset toimijat voivat käyttää sitä väärin deepfake-väärennösten luomiseen.’
Uusi artikkeli on nimeltään RigNeRF: Täysin ohjattavissa olevat neuronaaliset 3D-muotokuvat, ja se on peräisin ShahRukh Atharilta Stonybrookin yliopistosta, joka oli Adoben harjoittelija RigNeRF:n kehityksen aikana, ja neljältä muulta Adoben tutkijalta.
Autoencoder-pohjaisten deepfakeiden ulkopuolella
Useimmat laajalle levinneet deepfake-videot, jotka ovat saaneet otsikot viime vuosina, on tuottanut autoencoder-pohjaiset järjestelmät, jotka perustuvat koodiin, joka julkaistiin vuonna 2017 pian suljetussa r/deepfakes-subredditissä – mutta vasta sen jälkeen, kun se oli kopioitu GitHubiin, jossa se on forkattu yli tuhat kertaa, ei vähiten suositun (vaikka kiistanalaisen) DeepFaceLab-jakelun, ja myös FaceSwap-projektin.
Lisäksi GAN:in ja NeRF:in, autoencoder-kehykset ovat kokeilleet 3D-muokattavia kasvomalleja “opasteina” parannelle kasvosynteesikehyksille. Esimerkki tästä on HifiFace-projekti heinäkuulta 2021. Kuitenkaan mikään käytännöllinen tai suosittu aloite ei näytä kehittyneen tästä lähestymistavasta tähän asti.
RigNeRF:n kohtauksien tiedot hankitaan tallentamalla lyhyitä älypuhelinvideoita. Tutkijat käyttivät iPhone XR:ää tai iPhone 12:ta kaikissa kokeissa. Tallennuksen ensimmäisellä puoliskolla koehenkilöä pyydetään esittämään monenlaisia ilmeitä ja puhumaan pää paikallaan, samalla kun kamera liikkuu hänen ympärillään.
Tallennuksen toisella puoliskolla kamera pysyy paikallaan, kun koehenkilö liikuttaa päätään eri suuntiin ja esittää erilaisia ilmeitä. Tuloksena olevat 40-70 sekunnin mittaiset videomateriaalit (noin 1200-2100 kehystä) edustavat koko aineistoa, jota käytetään mallin kouluttamiseen.
Datakeruun vähentäminen
Toisin kuin autoencoder-järjestelmät, kuten DeepFaceLab, jotka vaativat suhteellisen työlään ja kohdennetun valokuvien keräämisen ja kuraation, useita tuhansia erilaisia valokuvia, usein otettuina YouTube-videoista ja muista sosiaalisen median kanavista, sekä elokuvista (julkkisten deepfake-kuvien tapauksessa).
Tuloksena olevat koulutetut autoencoder-mallit on usein tarkoitettu käytettäviksi monissa eri tilanteissa. Kuitenkin ahkerimmat “julkkis”-deepfake-käyttäjät voivat kouluttaa kokonaisia malleja alusta alkaen yhteen videoon, vaikka koulutus voi kestää viikon tai enemmän.
Vaikka uuden tutkimuksen tutkijat ovat varoittaneet, “mosaiikki”- ja laajasti kootuista aineistoista, jotka voimavat AI-pornoa ja suosittuja YouTube/TikTok-deepfake-uudelleenjärjestelyjä, näyttävät epätodennäköisiltä tuottavan hyväksyttäviä ja johdonmukaisia tuloksia RigNeRF-järjestelmässä, jolla on kohtauskohtainen menetelmä. Ottaen huomioon aineiston keräämisen rajoitukset uudessa tutkimuksessa, tämä voi olla jonkin verran lisäsuojaa vastaan identiteetin satunnaista luvatonta käyttöä vastaan.
NeRF:n sovittaminen deepfake-videolle
NeRF on fotogrammetria-pohjainen menetelmä, jossa pieni määrä lähdekuvia otetaan eri näkökulmista ja koostetaan exploroitavaksi 3D-neuronaaliseksi avaruudeksi. Tämä lähestymistapa tuli tunnetuksi aiemmin tänä vuonna, kun NVIDIA (NVDA ) julkaisi Instant NeRF-järjestelmän, joka pystyy lyhentämään NeRF:n valtavat koulutusajat muutamiin minuutteihin tai jopa sekunteihin:
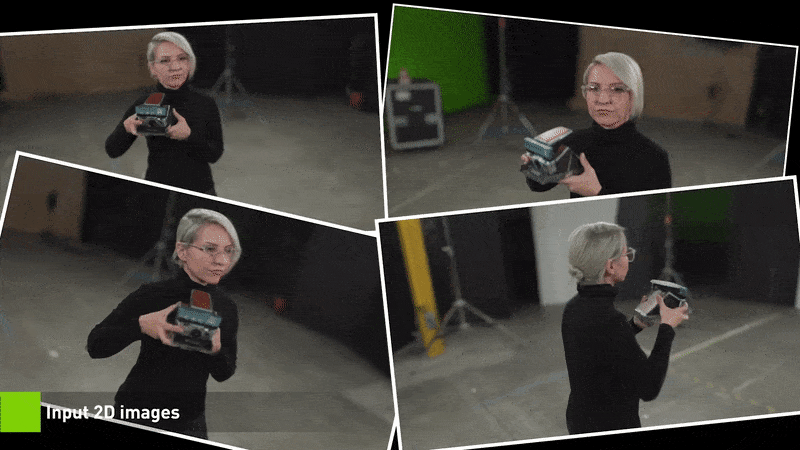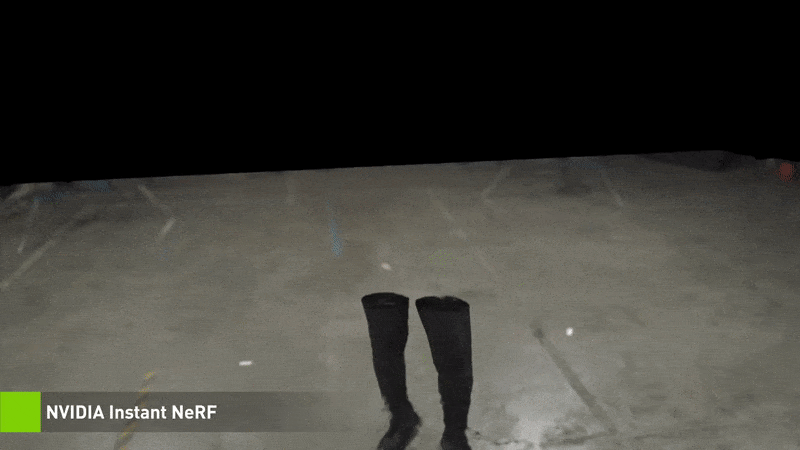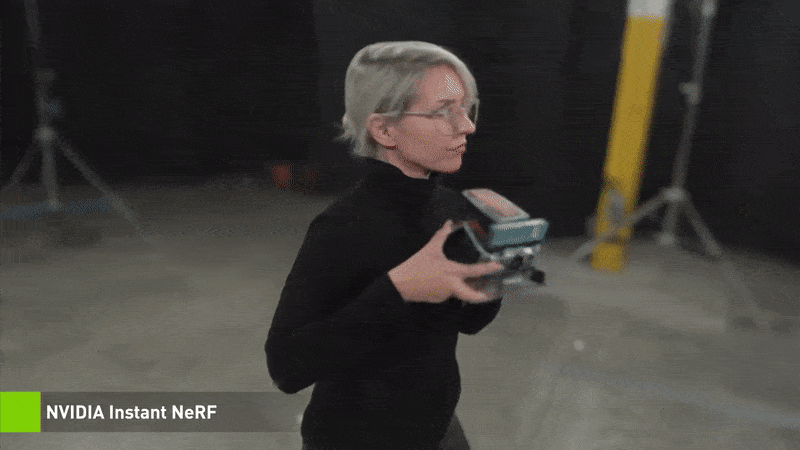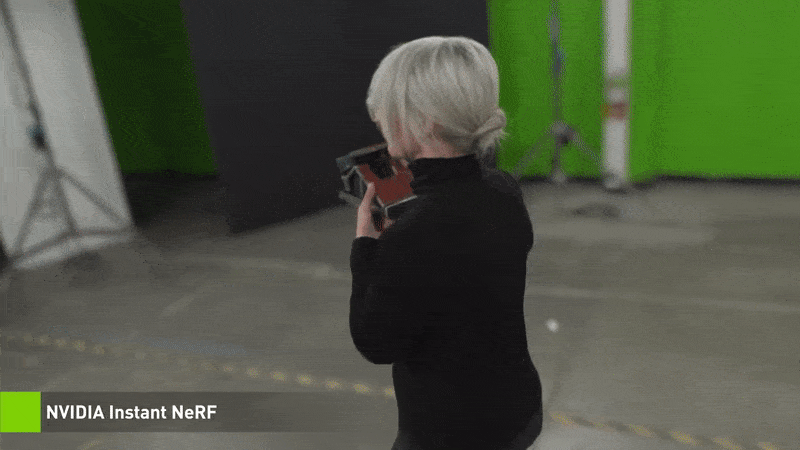
Instant NeRF. Lähde: https://www.youtube.com/watch?v=DJ2hcC1orc4
Tuloksena oleva neuraalinen säteilykenttä on käytännössä staattinen ympäristö, jota voidaan tutkia, mutta jota on vaikea muokata. Tutkijat toteavat, että kaksi aiempaa NeRF-pohjaista aloitetta – HyperNeRF + E/P ja NerFACE – ovat kokeilleet kasvojen videosynteesiä, ja (ilmeisesti täydellisyyden ja tarkkuuden vuoksi) asettaneet RigNeRF:n näiden kahden kehyksen rinnalle testikierrokselle:
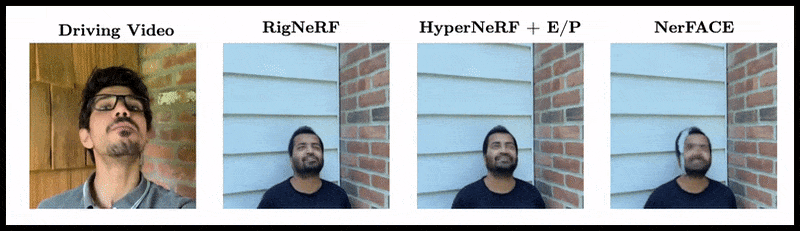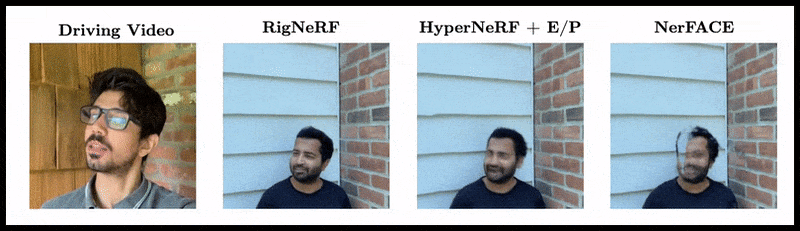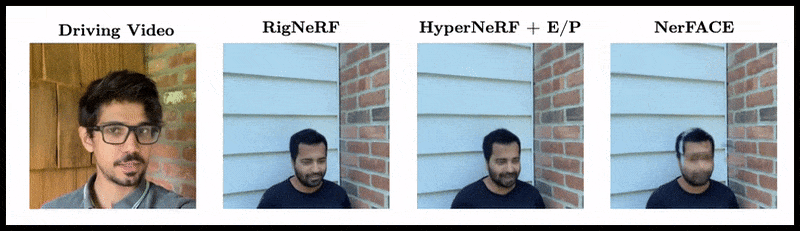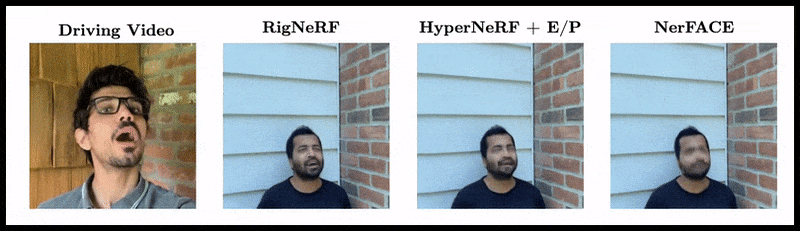
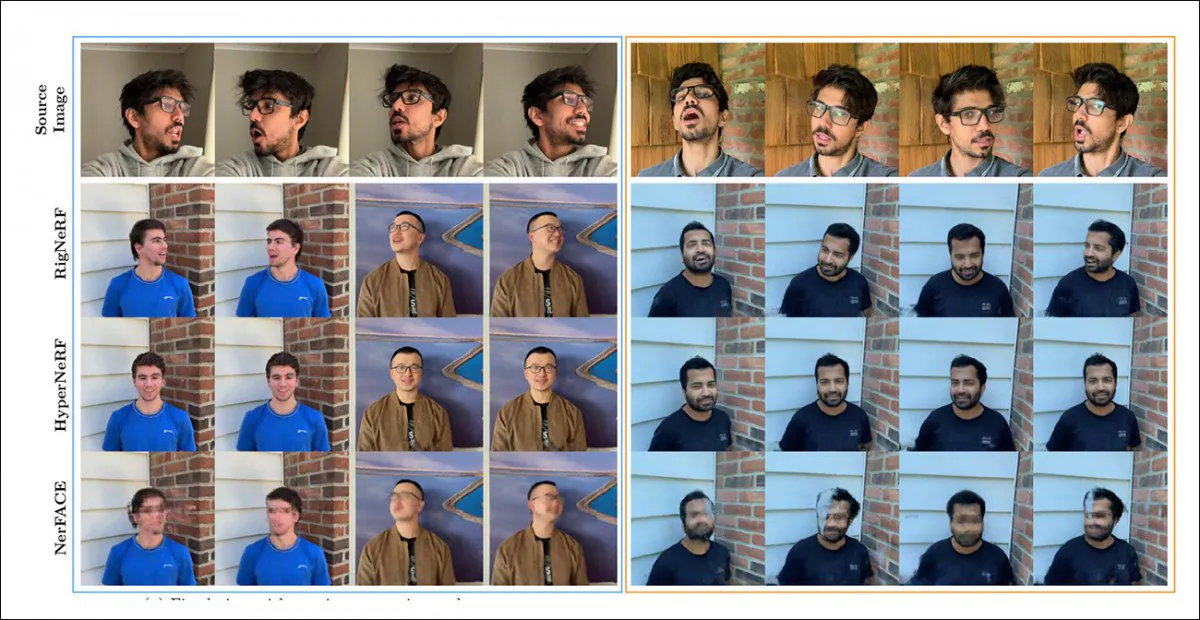
Laadullinen vertailu RigNeRF:n, HyperNeRF:n ja NerFACE:n välillä. Katso linkitetyt lähdevideot ja PDF-tiedostot korkeampilaatuisista versioista. Staattinen kuva: https://arxiv.org/pdf/2012.03065.pdf
Kuitenkin tässä tapauksessa tulokset, jotka suosivat RigNeRF:ää, ovat melko poikkeuksellisia, kahdesta syystä: ensinnäkin, kirjoittajat toteavat, että “ei ole olemassa oikeudenmukaista vertailua”; toiseksi, tämä on edellyttänyt RigNeRF:n kykyjen rajoittamista osittain vastaamaan edellisten järjestelmien rajoitettua toiminnallisuutta.
Koska tulokset eivät ole vain edellisten töiden parannusta, vaan edustavat “murrosta” NeRF:n muokattavuudessa ja hyödyllisyydessä, jätämme testikierroksen sivuun ja tarkastelemme, mitä RigNeRF tekee eri tavalla kuin edeltäjänsä.
Yhdistetyt vahvuudet
NerFACE:n pääasiallinen rajoitus, joka pystyy luomaan asento-/ilmeohjauksen NeRF-ympäristössä, on se, että se olettaa, että lähdemateriaali on tallennettu staattisella kameralla. Tämä tarkoittaa käytännössä, että se ei voi tuottaa uusia näkökulmia, jotka ylittävät sen tallennusrajat. Tämä tuottaa järjestelmän, joka voi luoda “liikkuvia muotokuvia”, mutta joka ei sovellu deepfake-tyyppisille videoille.
HyperNeRF, toisaalta, pystyy tuottamaan uusia ja hyperrealistisia näkökulmia, mutta sillä ei ole välineitä, joilla voidaan muuttaa pään asentoa tai kasvojen ilmeitä, mikä ei johda mihinkään kilpailijaan autoencoder-pohjaisiin deepfake-järjestelmiin.
RigNeRF pystyy yhdistämään nämä kaksi erillistä toiminnallisuutta luomalla “kanonisen avaruuden”, oletusarvon, josta poikkeamat ja muodonmuutokset voidaan suorittaa 3DMM-moduulin syötteen avulla.

Kanonisen avaruuden luominen (ei asentoa, ei ilmettä), johon 3DMM:llä tuotetut muodonmuutokset (ts. asennot ja ilmeet) voivat vaikuttaa.
Koska 3DMM-järjestelmä ei vastaa täysin tallennettua koehenkilöä, on tärkeää kompensoida tämä prosessissa. RigNeRF saavuttaa tämän muodonmuutoskentän ennakkotiedon avulla, joka lasketaan monikerroksisesta perceptronista (MLP) lähdemateriaalista.

Kameraparametrit, jotka tarvitaan deformaatioiden laskemiseen, hankitaan COLMAP:sta, kun taas ilmeen ja muodon parametreja hankitaan DECA:sta.
Asema optimoidaan edelleen kasvojen avainpisteiden sovittamisen ja COLMAP:n kameraparametrien kautta, ja lopullinen videotuotos on pienennetty 256×256-resoluutioon koulutusta varten (laitevaatimusten rajoittama prosessi, joka vaivaa myös autoencoder-pohjaista deepfake-koulutusta).
Tämän jälkeen deformaatioverkko koulutetaan neljällä V100:lla – vaikuttavalla laitteistolla, joka ei todennäköisesti ole saatavilla harrastelijoiden ulottuvilla (vaikka koneoppimisen koulutuksessa on usein mahdollista käyttää vähemmän laskentatehoa pidemmän koulutusajan kustannuksella ja hyväksyä, että mallin koulutus kestää päiviä tai jopa viikkoja).
Johtopäätöksessään tutkijat toteavat:
‘Toisin kuin muut menetelmät, RigNeRF, 3DMM-ohjatun deformaatiomoduulin ansiosta, pystyy mallintamaan pään asennon, kasvojen ilmeitä ja koko 3D-muotokuvan korkealla uskottavuudella, mikä johtaa parempiin rekonstruktioihin terävillä yksityiskohdilla.’
Katso alla olevat upotetut videot lisätietojen ja tuloksien kuvamateriaalin vuoksi.
Julkaistu ensimmäisen kerran 15. kesäkuuta 2022.


