
IAG e IA del futuro
¿Qué es la prueba de Turing y por qué es importante?

 Añade Unite.AI a tus fuentes preferidas en Google
La prueba de Turing surgió del artículo de Alan Turing de 1950 “Computing Machinery and Intelligence”. En lugar de intentar definir el pensamiento, Turing propuso un juego de imitación: un interrogador humano intercambia mensajes escritos con participantes invisibles y juzga cuál es humano y cuál es una máquina.
La prueba sigue siendo influyente porque convierte una cuestión filosófica abstracta en una interacción observable. También tiene limitaciones: aparentar ser humano en una conversación no equivale a ser veraz, estar bien informado, ser seguro, consciente o generalmente inteligente.
Conclusiones clave
- El juego de imitación original de Turing es una prueba conductual basada en texto, no una lista de verificación de propiedades cognitivas internas.
- Los resultados dependen del evaluador, el prompt, la duración, las instrucciones a los participantes y la regla de puntuación.
- Un modelo puede imitar la conversación humana mientras alucina hechos o falla en pruebas simples de robustez.
- La evaluación moderna necesita métricas de tarea, pruebas adversarias, revisión humana y evidencia específica de riesgo además de la conversación.
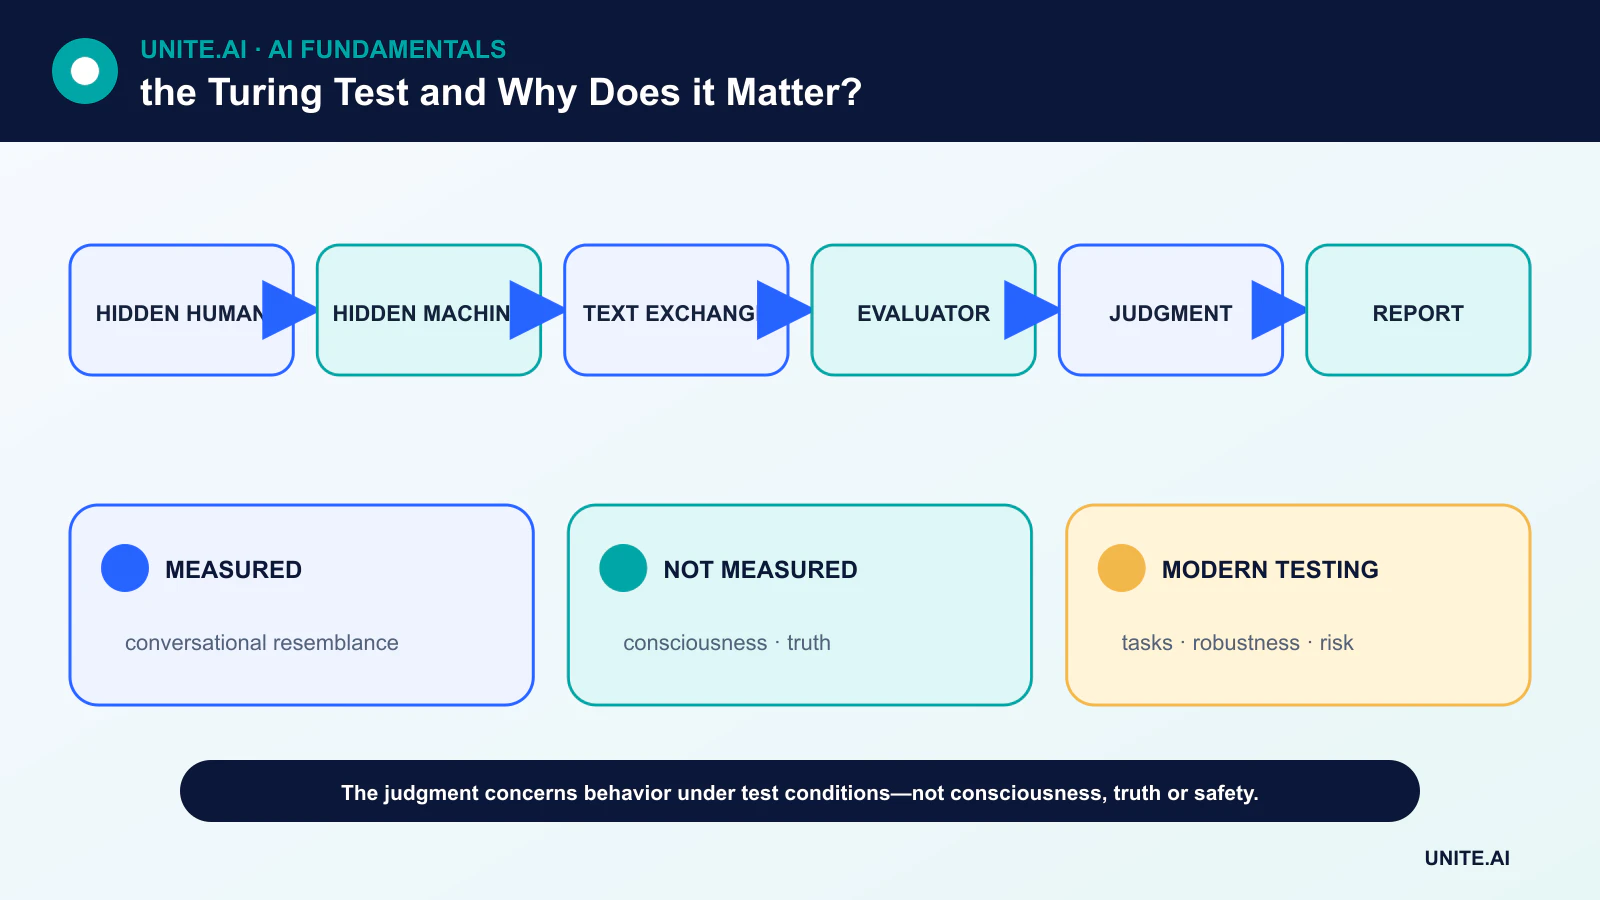
El juego de imitación de Turing
En la configuración original, un interrogador se comunicaba a distancia para que la voz y la apariencia no revelaran la identidad. Turing preguntó si una máquina podría desempeñarse lo suficientemente bien en el juego como para que un evaluador no pudiera distinguirla de manera fiable de una persona.
Este encuadre operativo evitó la necesidad de establecer una única definición de pensamiento. No afirmaba que cada intercambio convincente demostrara inteligencia, ni especificaba un umbral universal de aprobación aplicable a cualquier demostración posterior de chatbot.
Lo que realmente mide un resultado
Una prueba mide la indistinguibilidad conductual bajo condiciones definidas. Conversaciones breves, jueces inexpertos o prompts elegidos por el creador del sistema pueden facilitar la tarea. Un informe riguroso debe revelar la selección de transcripciones, el número y la experiencia de los jueces, los humanos de comparación, el límite de tiempo y el método estadístico.
Un sistema también puede explotar expectativas: la evasión, el humor, los errores tipográficos y la interpretación de roles pueden parecer humanos sin demostrar razonamiento fiable. Por el contrario, una respuesta humana inusualmente formal puede ser clasificada erróneamente como generada por máquina.
Lo que la prueba de Turing no establece
La prueba no mide directamente la conciencia, la experiencia subjetiva, la exactitud factual, la comprensión causal o la agencia moral. No revela los datos de entrenamiento, la arquitectura del modelo ni los modos de falla fuera de la conversación. Tampoco dice mucho sobre la inteligencia no lingüística, como la manipulación física.
Los sistemas de lenguaje modernos se construyen con redes neuronales transformer y aprendizaje profundo, pero sus salidas fluidas aún pueden generarse a partir de una estructura estadística aprendida en lugar de un modelo del mundo verificado.
Cómo la evaluación moderna de IA amplía la cuestión
La evaluación contemporánea utiliza conjuntos de tareas reservados, incertidumbre calibrada, pruebas de robustez, pruebas de adversarios (red teaming), verificaciones de factualidad y estudios de preferencias humanas. Una métrica de clasificación de texto puede probar un comportamiento definido, mientras que la evaluación basada en escenarios puede probar si un sistema sigue la política bajo presión.
Ningún benchmark único captura cada despliegue. La contaminación de pruebas puede inflar las puntuaciones, y los benchmarks estáticos fomentan el sobreajuste. La evaluación debe repetirse a medida que cambian los modelos, los datos, los prompts, las herramientas y las poblaciones de usuarios.
Por qué la prueba sigue siendo importante
La prueba de Turing anticipó una lección central de la evaluación de IA: evaluar la capacidad observable en lugar de confiar en afirmaciones sobre una esencia interna. También nos obliga a preguntar qué comportamientos humanos cuentan como evidencia y cómo un diseño experimental moldea una conclusión.
Su mejor uso moderno es como una referencia histórica y conceptual. Aprobar un juego de imitación puede ser interesante, pero las decisiones de despliegue requieren evidencia vinculada a la tarea real, a los usuarios afectados y a los daños previsibles.
Lo que mide la prueba de Turing
El juego de imitación de Alan Turing preguntó si un interrogador que se comunica mediante texto podría distinguir de manera fiable una máquina de una persona. Reformuló un debate abstracto sobre si las máquinas piensan en un experimento conversacional observable. La prueba depende de los participantes, la duración, el protocolo, los temas y la regla de juicio; no existe una puntuación universal única. Aprobar significa producir respuestas similares a las humanas bajo ese escenario. No mide directamente la exactitud factual, el razonamiento, la conciencia, la autonomía, la percepción, la encarnación, la fiabilidad o el comportamiento beneficioso en el mundo real.
La imitación humana puede premiar la evasión, la personalidad, los errores, el humor o la manipulación. Un juez puede confundir a un humano con una máquina o verse influenciado por expectativas, idioma y contexto cultural. Las conversaciones breves permiten trucos que fallan en interacciones prolongadas. Por el contrario, un sistema muy útil para matemáticas, traducción o modelado de proteínas podría fallar porque no pretende ser humano. Por lo tanto, la prueba mide una capacidad social y lingüística moldeada por el evaluador, no una clasificación completa de la inteligencia.
Modelos de lenguaje modernos y evaluación más rigurosa
Los grandes modelos de lenguaje pueden mantener diálogos fluidos al predecir secuencias a partir de amplios datos de entrenamiento y afinamiento posterior, pero la fluidez es una evidencia débil de verdad o comprensión. Los patrones memorizados, el acceso a herramientas, los prompts ocultos, la latencia y los ajustes de muestreo afectan los resultados. Las evaluaciones controladas deben revelar el modelo y el protocolo, evitar fugas de información, incluir preguntas adversarias y de dominio, y puntuar la incertidumbre y la citación. Una demostración seleccionada de conversaciones exitosas no puede estimar la fiabilidad en toda la distribución de uso.
La evaluación moderna es multidimensional: precisión en la tarea, calibración, robustez, consistencia a largo plazo, seguridad, sesgo, privacidad, seguridad, eficiencia y resultados humanos. Las pruebas conductuales deben complementarse con evidencia de proceso, pruebas de adversarios, benchmarks reproducibles y monitoreo en el mundo real. Los benchmarks pueden saturarse o incorporarse a los datos de entrenamiento, por lo que se necesitan conjuntos de pruebas privados y actualizados. Para los sistemas que actúan, se debe evaluar los permisos de herramientas, la recuperación y las consecuencias por separado de la calidad de la conversación.
Por qué la prueba sigue siendo importante
La prueba de Turing sigue siendo históricamente importante porque se centra en el comportamiento y en la dificultad de definir la inteligencia. También plantea preguntas continuas sobre el antropomorfismo y el engaño. Las interfaces deben identificar a los agentes sintéticos en lugar de considerar el error de identidad como éxito, especialmente en entornos con consecuencias. Use la prueba como una lente filosófica y una evaluación conversacional, no como una certificación de inteligencia general o de personalidad. La cuestión clave en el despliegue es qué puede hacer el sistema de manera fiable, con qué evidencia y límites, y quién es responsable cuando falla.
Ejemplo práctico: una evaluación conversacional controlada
Los evaluadores comparan a humanos y varios sistemas de IA en conversaciones de texto con duración, temas, idioma e identidades ocultas fijos. Los jueces registran si creen que cada participante es humano y también puntúan la factualidad, la consistencia, la utilidad, la incertidumbre y la manipulación. Múltiples jueces y conversaciones estiman la variación, y el protocolo impide que los desarrolladores del modelo seleccionen transcripciones favorables. La clasificación errónea de humanos proporciona una línea base necesaria para interpretar el resultado.
Un sistema que engaña a los jueces pero inventa hechos no se declara generalmente inteligente, mientras que un modelo especializado claramente divulgado puede ser muy útil a pesar de fallar en la imitación. Los resultados incluyen el prompt, el modelo, el muestreador, el acceso a herramientas y las características del juez. El experimento se enmarca como una prueba de conversación similar a la humana. Las decisiones de despliegue utilizan evidencia separada para la corrección de la tarea, la seguridad, la privacidad y la recuperación, y la interfaz identifica al agente en lugar de convertir el engaño en el objetivo del producto.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes del ajuste. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, fallos de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retrocesos y retiro. Utilice un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien las fuentes de datos, los usuarios, los modelos, los proveedores, las políticas, el hardware o los objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿Alguna IA ha superado definitivamente la prueba de Turing?
No existe una autoridad oficial única para la prueba ni un protocolo universalmente aceptado. Las demostraciones públicas utilizan reglas diferentes, por lo que las afirmaciones de “superado” no son directamente comparables.
¿Fallar la prueba demuestra que un sistema es poco inteligente?
No. Un sistema especializado puede ser altamente capaz sin imitar el estilo conversacional humano.
Referencias principales












