Fundamentos de la IA
¿Qué es la ciencia de datos?

 Añade Unite.AI a tus fuentes preferidas en Google
Data science es la práctica de convertir datos en conocimiento defendible, predicciones o decisiones. Combina experiencia de dominio, estadística, computación, ingeniería de datos, visualización y comunicación. Un modelo puede ser parte del trabajo, pero la disciplina comienza antes del modelado y continúa después del despliegue.
La pregunta más importante no es “¿Qué algoritmo debemos usar?” Sino “¿Qué decisión estamos respaldando, qué evidencia la respondería y cómo sabremos que el resultado sigue siendo útil?”
Conclusiones clave
- La ciencia de datos es un flujo de trabajo de evidencia de extremo a extremo, no sinónimo de aprendizaje automático.
- La definición del problema, la medición y la gobernanza de datos a menudo determinan el éxito más que la complejidad del modelo.
- Las preguntas predictivas y causales requieren supuestos y diseños de evaluación diferentes.
- Un análisis desplegado necesita monitoreo, documentación y comunicación adecuados a sus usuarios.
Comience con una decisión y un estimando
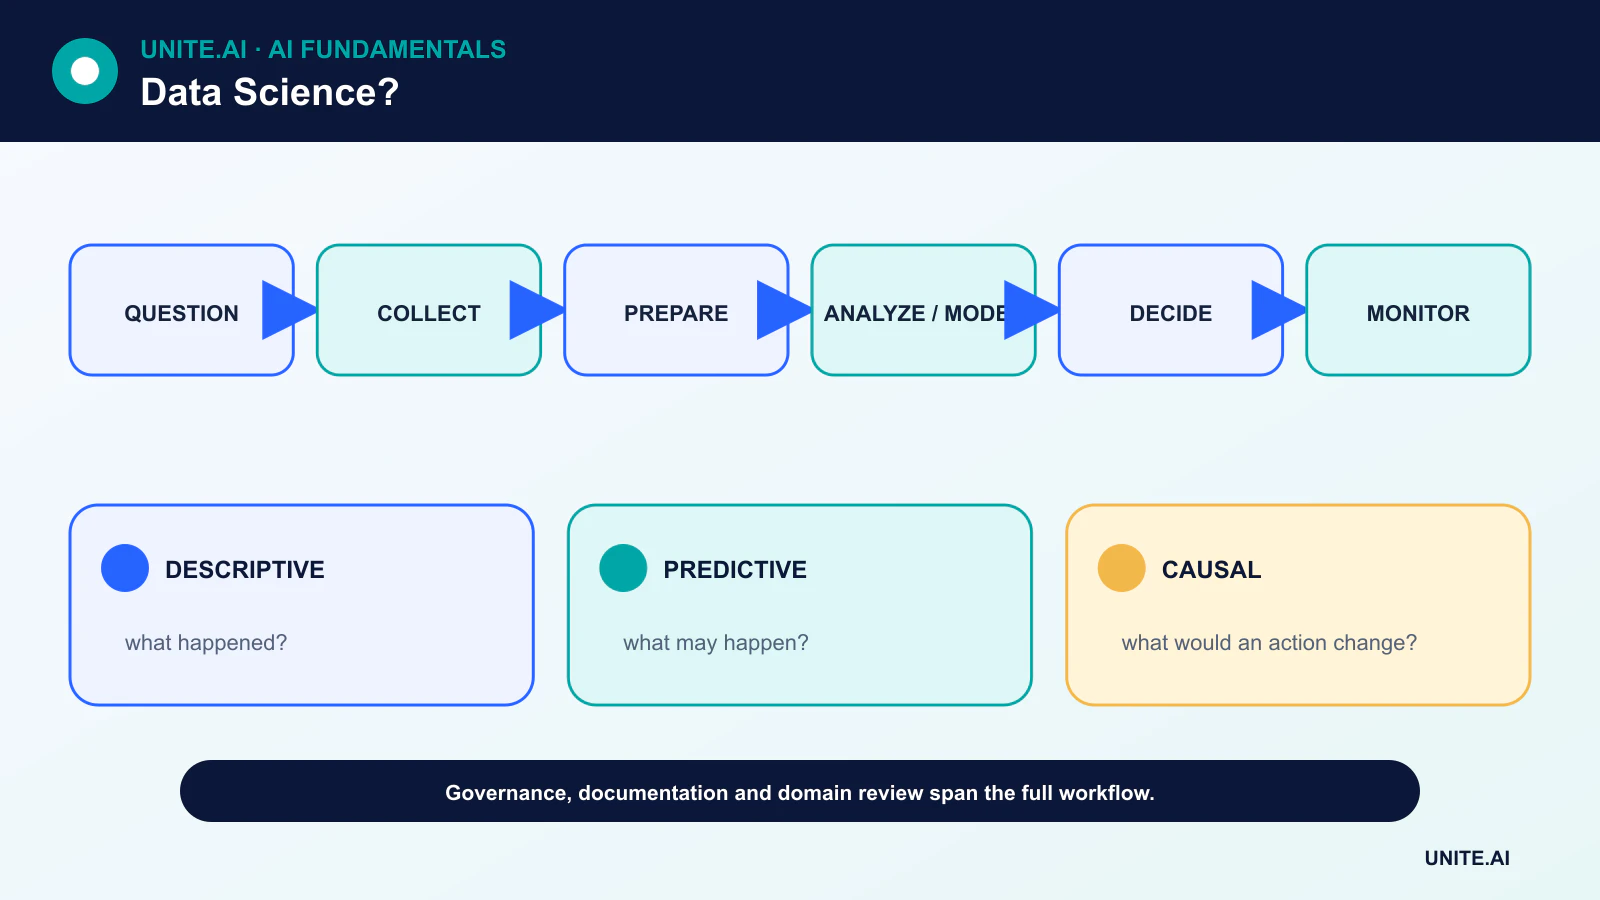
Un proyecto debe identificar al usuario, la decisión, la intervención y el costo del error. Para una pregunta descriptiva, el objetivo puede ser una tasa o tendencia. Para la predicción, puede ser la demanda futura o el riesgo. Para una pregunta causal, el estimando describe el efecto de una intervención definida bajo los supuestos establecidos.
Objetivos vagos como “encontrar ideas” hacen imposible la evaluación. Un objetivo medible crea un límite para la recopilación de datos y evita que el análisis se expanda a todos los campos disponibles.
Recopilar, gobernar y comprender los datos
Los equipos inventarían fuentes, propiedad, consentimiento, retención, linaje y acceso. Distinguen structured and unstructured data, definen unidades y marcas de tiempo, y examinan si los registros representan la población y el período de tiempo de interés.
La limpieza no consiste solo en eliminar filas con datos faltantes. Incluye resolver duplicados, valores imposibles, ambigüedad de etiquetas, deriva de esquemas, censura y uniones que cambian la unidad de análisis. Cada transformación debe ser reproducible y documentada.
Explorar antes de modelar
El análisis exploratorio estudia distribuciones, ausencias, relaciones y posibles artefactos de medición. La visualización puede revelar valores atípicos y diferencias de subgrupos que un promedio resumido oculta. La exploración debe informar hipótesis sin ser confundida con evidencia confirmatoria.
La ingeniería de características, la reducción de dimensionalidad y el aprendizaje de representaciones pueden mejorar el modelado, pero las transformaciones deben ajustarse solo con los datos de entrenamiento para evitar fugas.
Elija métodos según la pregunta
La estimación estadística cuantifica la incertidumbre alrededor de las cantidades de interés. Machine learning es útil cuando el objetivo principal es el rendimiento predictivo en datos nuevos. Se requieren experimentos y métodos de inferencia causal cuando el objetivo es el efecto de una intervención.
Una línea base debe ser lo suficientemente simple para entenderse. Los modelos más complejos deben justificar su costo adicional mediante un mejor rendimiento en datos de prueba, incertidumbre calibrada, valor operativo o una capacidad necesaria como procesamiento de imágenes o de lenguaje.
Evaluar, comunicar y monitorear
La evaluación debe coincidir con la decisión. Un clasificador puede requerir precisión, exhaustividad, calibración y análisis de subgrupos en lugar de solo exactitud; un sistema de pronóstico necesita pruebas retrospectivas conscientes del tiempo. El sobreajuste y la fuga son fallas del proceso, no solo propiedades del modelo.
La comunicación incluye supuestos, incertidumbre, limitaciones y acciones recomendadas. Una vez que se utiliza un modelo o panel, los equipos monitorean la calidad de los datos de entrada, la deriva de resultados, el comportamiento de los usuarios y el impacto posterior. Un proceso de decisión retirado necesita un archivo y una propiedad clara, al igual que uno desplegado necesita un operador.
El ciclo de vida de la ciencia de datos y las preguntas analíticas
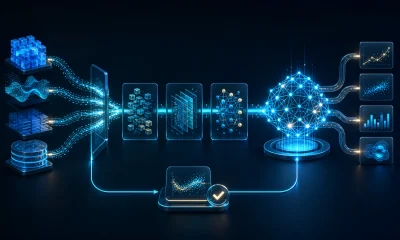
La ciencia de datos combina conocimiento de dominio, estadística, computación y comunicación para convertir datos en evidencia para decisiones. Comience distinguiendo descripción, diagnóstico, predicción e inferencia causal. Un panel que informa lo que ocurrió, un modelo que predice quién abandonará y un experimento que estima si una intervención cambia la tasa de abandono responden a preguntas diferentes. Defina la unidad, población, ventana temporal, resultado, acción y costo de los errores antes de extraer los datos. Muchos proyectos fallidos resuelven un proxy medible que no puede respaldar la decisión prevista.
La adquisición requiere procedencia, permisos, diseño de muestreo y un contrato de datos. La exploración verifica distribuciones, ausencias, duplicados, valores atípicos, relaciones, cambios de medición y posibles fugas. Las decisiones de limpieza son supuestos analíticos: eliminar filas con datos faltantes, imputar valores o limitar valores atípicos pueden cambiar la población y la conclusión. Versione los datos crudos de forma inmutable y las transformaciones como código, y cree un diccionario de datos con unidades y significado. Divida los datos de evaluación antes de aprender transformaciones o probar hipótesis repetidamente.
Modelado, inferencia y reproducibilidad
La inferencia estadística cuantifica la incertidumbre bajo supuestos; el modelado predictivo estima el rendimiento fuera de muestra; el análisis causal requiere identificación mediante diseño o supuestos defendibles. Seleccione métodos que coincidan con la pregunta y el proceso generador de datos. Compare con líneas base simples, use validación agrupada o consciente del tiempo, y reporte incertidumbre y sensibilidad. Una alta correlación o importancia de características no establece causalidad. Las pruebas múltiples, la libertad de grados del investigador y la publicación selectiva pueden fabricar patrones convincentes, por lo que el preregistro o una etapa confirmatoria claramente separada pueden ayudar.
La reproducibilidad incluye código, entorno, instantánea de datos, semillas aleatorias, definiciones de consultas y un registro de decisiones manuales. Las pruebas automatizadas deben cubrir esquemas, invariantes de negocio, transformaciones y métricas. Los cuadernos son valiosos para la exploración, pero el trabajo de producción necesita canalizaciones modulares y revisables. La revisión por pares debe cuestionar supuestos, fugas, validez del objetivo y si los resultados se generalizan. Comunicar tamaños de efecto, incertidumbre, limitaciones y evidencia contraria en lugar de solo la significancia estadística o una puntuación del modelo.
Despliegue e impacto de la decisión
Si el análisis impulsa un proceso recurrente, asigne responsables, monitoree la frescura de los datos y la calidad de los resultados, y defina retroceso o retiro. Proteja la información personal y confidencial mediante minimización, control de acceso, retención y salidas seguras. Evalúe los efectos en subgrupos y cómo los usuarios responden al modelo; los bucles de retroalimentación pueden cambiar los datos futuros. Mida si la decisión mejoró el objetivo real, no solo si se desplegó un modelo. La ciencia de datos tiene éxito cuando la evidencia cambia la acción de manera fiable y transparente, no cuando una organización acumula paneles, características o experimentos sin responsabilidad.
Ejemplo práctico: medir una intervención de retención
Un equipo de producto observa una menor retención y define un usuario activo, cohorte, ventana, exclusiones y decisión. Los analistas auditan la instrumentación, eventos faltantes y la mezcla de adquisición antes del modelado. Las cohortes descriptivas identifican dónde ocurre el descenso, un modelo predictivo prioriza a los participantes de la investigación, y un experimento aleatorio de incorporación estima si el cambio propuesto mejora la retención. Estos son tres análisis distintos con supuestos y resultados separados.
El cuaderno, las consultas, la instantánea de datos, la definición de métricas y el plan del experimento están versionados y revisados por pares. Los resultados informan el tamaño del efecto y la incertidumbre con límites de seguridad para la demanda de soporte y la accesibilidad. Un panel monitorea el experimento pero no sustituye al análisis predeclarado. Si la intervención tiene éxito, el despliegue se mantiene escalonado y verifica el comportamiento a largo plazo. El trabajo se considera valioso solo si respalda una decisión reproducible, no porque se haya producido un modelo complejo o un gráfico visualmente atractivo.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o faltantes, desplazamiento de distribución, fallas de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Use un despliegue escalonado, preserve una alternativa segura y verifique la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿La ciencia de datos es lo mismo que la analítica de datos?
Los términos se solapan. La ciencia de datos a menudo incluye la construcción de productos de datos y sistemas predictivos, mientras que la analítica puede centrarse más en el soporte de decisiones descriptivo y diagnóstico. El uso organizacional varía.
¿Todos los proyectos de ciencia de datos necesitan IA?
No. Una consulta, gráfico, experimento o estimación estadística bien diseñados pueden ser más útiles y confiables que un modelo complejo.
Referencias principales