Fundamentos de la IA
¿Qué es un almacén de datos? Arquitectura, ETL y casos de uso

 Añade Unite.AI a tus fuentes preferidas en Google
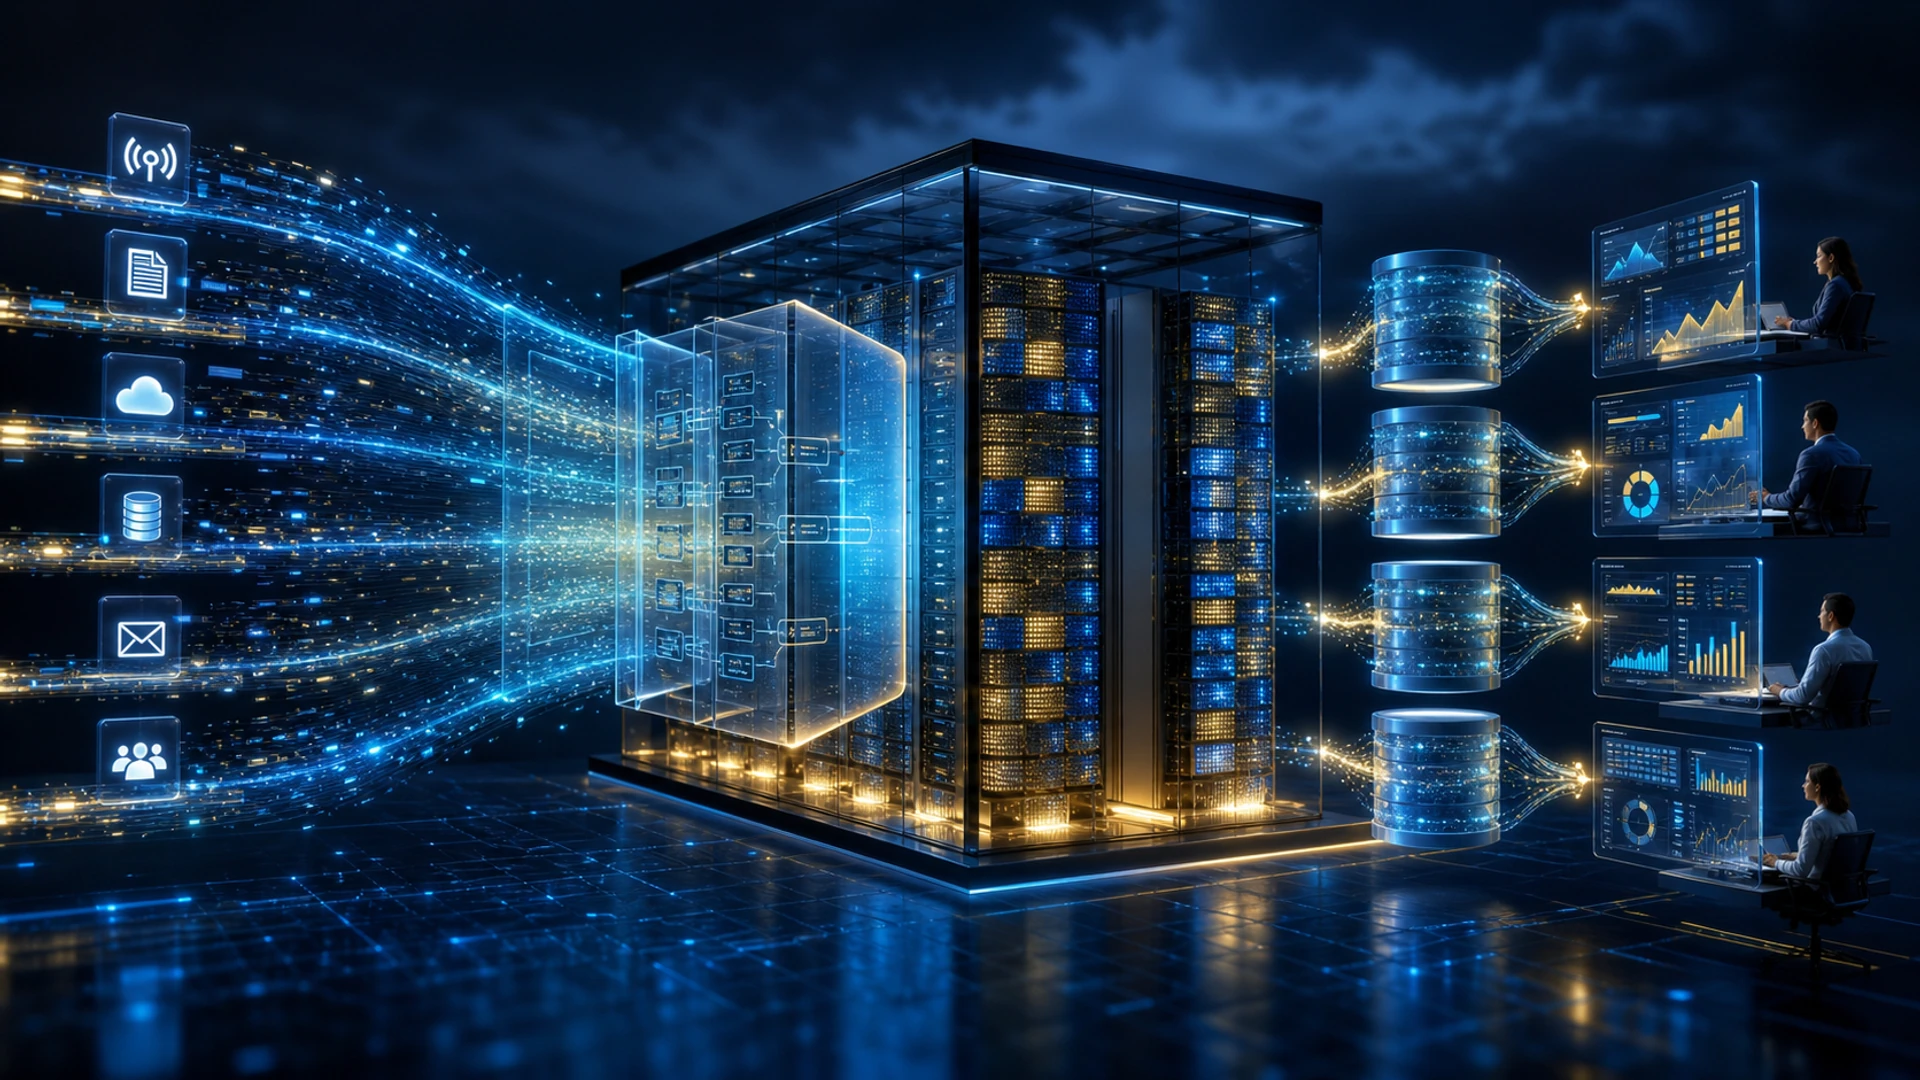
Un almacén de datos es un sistema analítico que integra información de fuentes operativas y la organiza para informes, inteligencia empresarial y análisis repetibles. Separa muchas cargas de trabajo analíticas de las aplicaciones que registran transacciones.
Los almacenes modernos pueden ser columnar, distribuidos, sin servidor o conectados al almacenamiento de objetos. El trabajo definitorio sigue siendo consistente: ingestión gobernada, significado modelado, historial, rendimiento de consultas, seguridad, calidad y entrega fiable a los usuarios.
Puntos clave
- Los sistemas operacionales optimizan las transacciones actuales; los almacenes optimizan el análisis histórico a través de fuentes.
- ETL transforma antes de cargar, mientras que ELT carga primero y transforma dentro de la plataforma analítica.
- Los modelos dimensionales, normalizados y de tablas anchas sirven a diferentes cargas de trabajo y necesidades de gobernanza.
- La confianza depende de la procedencia, pruebas, frescura, control de acceso, definiciones semánticas y monitoreo de costos.
Fuentes, ingestión y almacenamiento
Los datos pueden llegar mediante lotes, captura de cambios, flujos, archivos y API. Una capa de aterrizaje preserva el contexto de origen; las transformaciones estandarizan tipos, deduplican registros, manejan eventos tardíos y crean entidades analíticas reutilizables.
Esto amplía el flujo de trabajo de ETL. ELT utiliza el cómputo del almacén para la transformación, mientras que ETL puede reducir o validar los datos antes de cargarlos. La elección adecuada depende de la latencia, la privacidad, la escala y la cadena de herramientas.
Modelar datos para preguntas
Los modelos dimensionales organizan hechos medibles alrededor de dimensiones descriptivas como cliente, producto y tiempo. Los modelos centrales normalizados pueden preservar las relaciones empresariales, mientras que los marts desnormalizados simplifican consultas comunes.
Una capa semántica brinda definiciones consistentes a las métricas. Sin ella, los equipos pueden producir varias cifras de ingresos o retención que parecen válidas a partir de las mismas filas. Los datos estructurados aún requieren un significado acordado.
Almacén, lago de datos y lakehouse
Un lago de datos típicamente almacena archivos y datos crudos o procesados diversos en almacenamiento de objetos. Un almacén proporciona tablas analíticas gestionadas y servicios de consulta. Los diseños de lakehouse añaden metadatos de tablas, transacciones y gobernanza al almacenamiento del lago.
Estos son patrones arquitectónicos, no garantías. Las organizaciones a menudo los combinan mediante un data fabric o una capa de gobernanza compartida. La carga de trabajo, la habilidad, la interoperabilidad y el costo del ciclo de vida importan más que la etiqueta.
Calidad, seguridad y operaciones
Defina propietarios, contratos, objetivos de frescura, procedencia, pruebas, retención y acceso a filas o columnas. Separe los datos de identificación personal, utilice el principio de menor privilegio y audite las consultas sensibles. Los retrocargas y los cambios de esquema requieren procedimientos controlados y observables.
Mida las actualizaciones exitosas, el retraso de los datos, los fallos de pruebas, el rendimiento de consultas, la adopción, el impacto de incidentes y el costo por carga de trabajo. Un almacén es útil cuando las personas pueden rastrear una métrica hasta datos gobernados y reproducir el resultado.
Modelado dimensional y semántica
Una tabla de hechos registra eventos o mediciones periódicas con un nivel de granularidad declarado, como una línea de pedido o un dispositivo por hora. Las dimensiones proporcionan contexto descriptivo. Declarar la granularidad antes de seleccionar columnas evita mezclar niveles que causan doble contabilización. Las medidas aditivas pueden sumarse a través de todas las dimensiones; las medidas semi‑aditivas requieren cuidado a lo largo del tiempo.
Las claves sustitutas desacoplan el historial del almacén de los identificadores cambiantes de origen. Las dimensiones que cambian lentamente definen cómo se manejan los cambios de atributos: sobrescribir, preservar una nueva fila histórica o mantener valores anteriores limitados. El método correcto sigue la pregunta analítica y las obligaciones de retención.
Una métrica semántica debe definir fórmula, filtros, comportamiento temporal, moneda, exclusiones, propietario y pruebas. Las definiciones centrales reducen la inconsistencia, pero la gobernanza debe permitir cambios propuestos y versionado. Una única capa semántica se convierte en un cuello de botella si los usuarios no pueden inspeccionarla o ampliarla de manera responsable.
Almacenamiento moderno y arquitectura de consultas
El almacenamiento columnar mantiene los valores de una columna juntos, mejorando la compresión y el escaneo solo de los campos necesarios. La partición recorta grandes secciones por fecha u otra clave; el clustering agrupa valores relacionados; las vistas materializadas y cachés reutilizan resultados. Las malas decisiones de partición generan archivos diminutos, sesgo o escaneos completos costosos.
Los motores de consultas masivamente paralelos dividen escaneos, uniones y agregaciones entre los trabajadores. El movimiento de datos durante las uniones puede dominar el tiempo de ejecución, por lo que la distribución, las estadísticas y el orden de las uniones son importantes. El autoescalado y los servicios sin servidor simplifican la capacidad pero requieren controles de costos, prioridades de carga de trabajo y límites a consultas descontroladas.
Los formatos de tabla lakehouse añaden metadatos, instantáneas, evolución de esquemas y semántica de transacciones sobre archivos de objetos. Mejoran la interoperabilidad pero introducen responsabilidades de catálogo y mantenimiento. Los formatos abiertos reducen el bloqueo solo cuando los motores de cómputo, la gobernanza y los procedimientos operativos pueden utilizarlos efectivamente.
Pipelines fiables y productos de datos
Los pipelines deben ser idempotentes o capaces de reconciliar duplicados. Las marcas de agua y el tiempo de evento manejan llegadas tardías; los retrocargas reproducen transformaciones históricas; los contratos de esquema definen cambios compatibles. Las pruebas de datos cubren unicidad, integridad, valores aceptados, relaciones e invariantes de negocio, no solo si se ejecutó un trabajo.
Trate los conjuntos de datos importantes como productos con propietarios, documentación, expectativas de servicio, descubribilidad, soporte y usuarios. La procedencia conecta los campos de origen a través de transformaciones hasta los informes, haciendo que el impacto de cambios y la investigación de incidentes sean más rápidos. Las políticas de acceso deben propagarse o reevaluarse cuando los datos se copian.
Un programa de almacén tiene éxito cuando las decisiones se vuelven más fiables y rápidas, no cuando el volumen de almacenamiento crece. Retire tablas no utilizadas, exponga el costo de consultas y almacenamiento, revise el acceso sensible y mida si los equipos confían y reutilizan métricas gobernadas en lugar de mantener hojas de cálculo privadas.
Ejemplo práctico: diseñando un almacén de análisis de ventas
Defina la granularidad del hecho como una línea de pedido completada, y luego vincule las dimensiones de producto, cliente, canal, promoción, geografía y fecha mediante claves sustitutas. Mantenga los eventos de estado de pedido en una tabla de hechos separada en lugar de mezclar instantáneas y transacciones. Los ingresos, la cantidad, el descuento, el impuesto y el costo requieren reglas explícitas de moneda, devolución, cancelación y reconocimiento. La definición de la métrica debe producir la misma respuesta en paneles, cuadernos y conciliaciones financieras.
La ingestión captura los cambios de origen, deposita datos crudos inmutables, valida el esquema y los transforma en modelos de staging y dimensionales probados. Las actualizaciones tardías deben corregir el período histórico correspondiente sin duplicar hechos. Compare el recuento de filas y los totales monetarios con los sistemas de origen, pruebe la unicidad y relaciones, y registre la procedencia del campo del informe al origen. Los retrocargas utilizan código versionado y validación aislada antes de reemplazar tablas confiables.
El acceso separa los identificadores de cliente de los agregados ampliamente disponibles y aplica el principio de menor privilegio por rol y propósito. La gestión de carga de trabajo mantiene los paneles ejecutivos responsivos mientras los analistas ejecutan consultas exploratorias. Monitoree la frescura, pruebas fallidas, costo de consultas, tablas no utilizadas y cambios semánticos. Un almacén es exitoso cuando las métricas gobernadas respaldan decisiones repetibles; simplemente centralizar los datos puede centralizar la confusión si la propiedad, la calidad y las definiciones permanecen sin resolver.
La recuperación ante desastres debe especificar la cobertura de copias de seguridad, copias entre regiones, restauración de catálogos y permisos, pérdida de datos aceptable y tiempo de recuperación. Pruebe la restauración en un entorno aislado y verifique las métricas, no solo los archivos. Las claves de cifrado, la configuración de identidad, el código de orquestación y las definiciones semánticas forman parte del sistema recuperable. Un almacén que puede restaurar petabytes pero no puede reproducir la política de acceso o los cálculos confiables no ha recuperado su servicio analítico.
Lista de verificación de implementación práctica
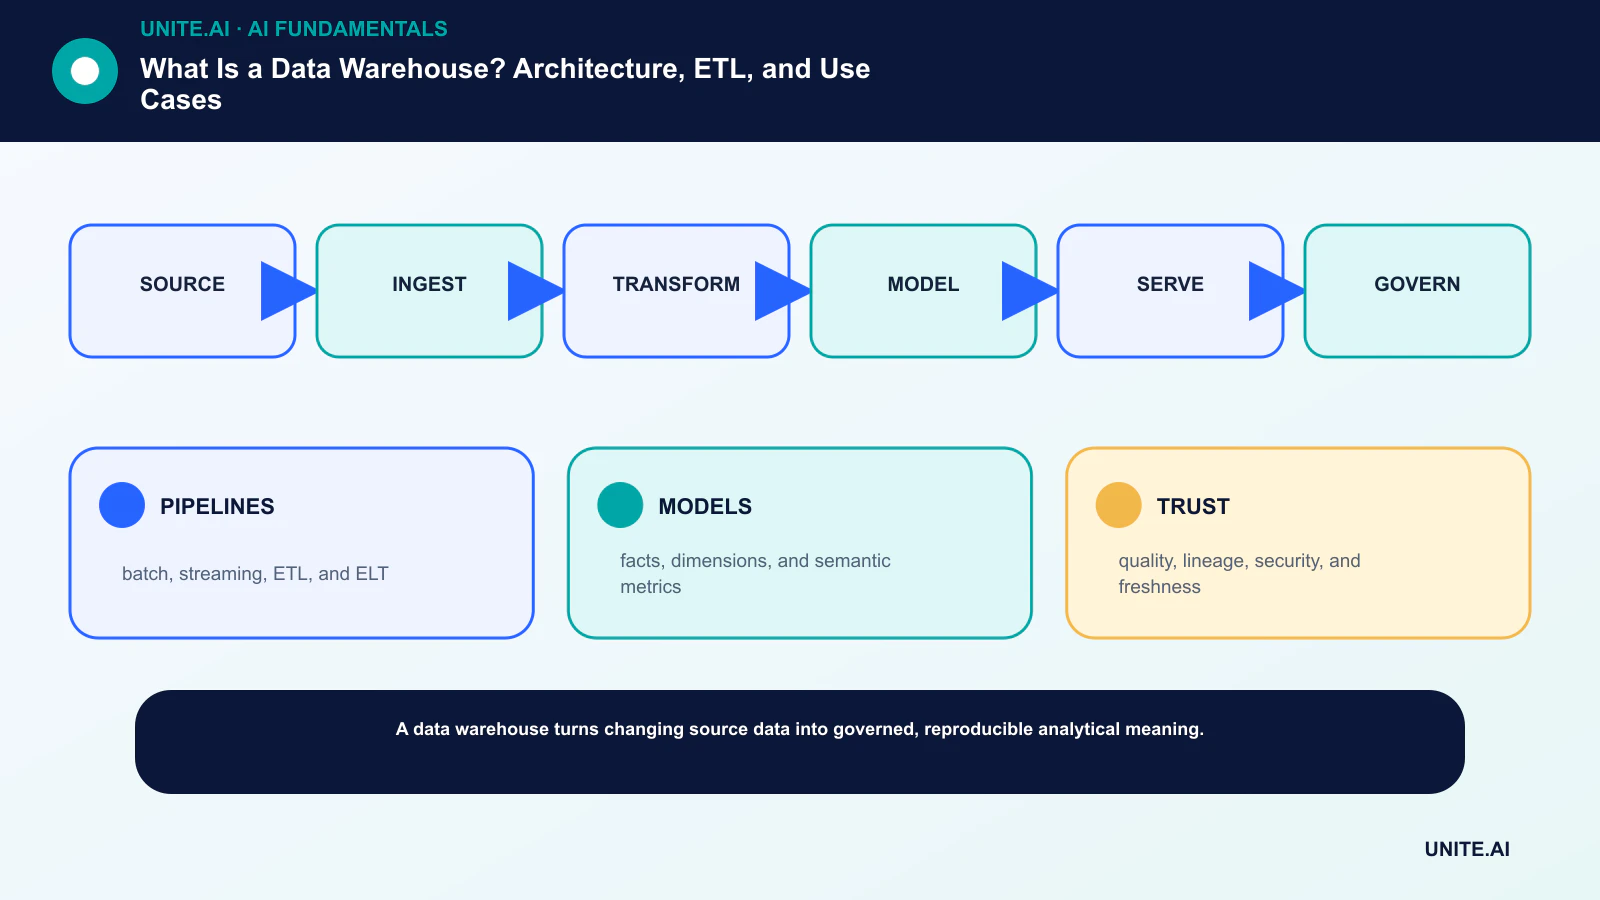
Convierta el concepto en un flujo de trabajo delimitado y comprobable: source → ingest → transform → model → serve → govern. Asigne un propietario responsable, documente los datos y dependencias, establezca una línea base simple, defina criterios de aceptación y detención, pruebe fallas representativas y establezca monitoreo, reversión y revisión antes de ampliar el alcance. Registre versiones y suposiciones para que otro equipo pueda reproducir el resultado y entender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y son afectadas por el sistema. Pruebe casos normales, condiciones límite, fallas de dependencias y usos indebidos; preserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar el lanzamiento, cambiar un umbral, sobrescribir una salida o detener la operación. Revise la decisión después de que lleguen datos del mundo real, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- PIPELINES: por lotes, streaming, ETL y ELT.
- MODELS: hechos, dimensiones y métricas semánticas.
- TRUST: calidad, procedencia, seguridad y frescura.
Preguntas frecuentes
¿Es un almacén de datos solo una base de datos grande?
Es una base de datos o plataforma analítica diseñada en torno al análisis histórico e integrado. Su modelado, ingestión, gobernanza y patrones de carga de trabajo difieren de una base de datos de aplicación transaccional.
¿Debería una empresa usar ETL o ELT?
Muchas utilizan ambos. Transformar temprano cuando la privacidad, la validación o el ancho de banda lo requieren; transformar después de cargar cuando el cómputo del almacén y la iteración rápida son ventajosos.
Referencias principales