
Fundamentos de la IA
¿Qué es ETL? Extracción, Transformación y Carga explicadas

 Añade Unite.AI a tus fuentes preferidas en Google
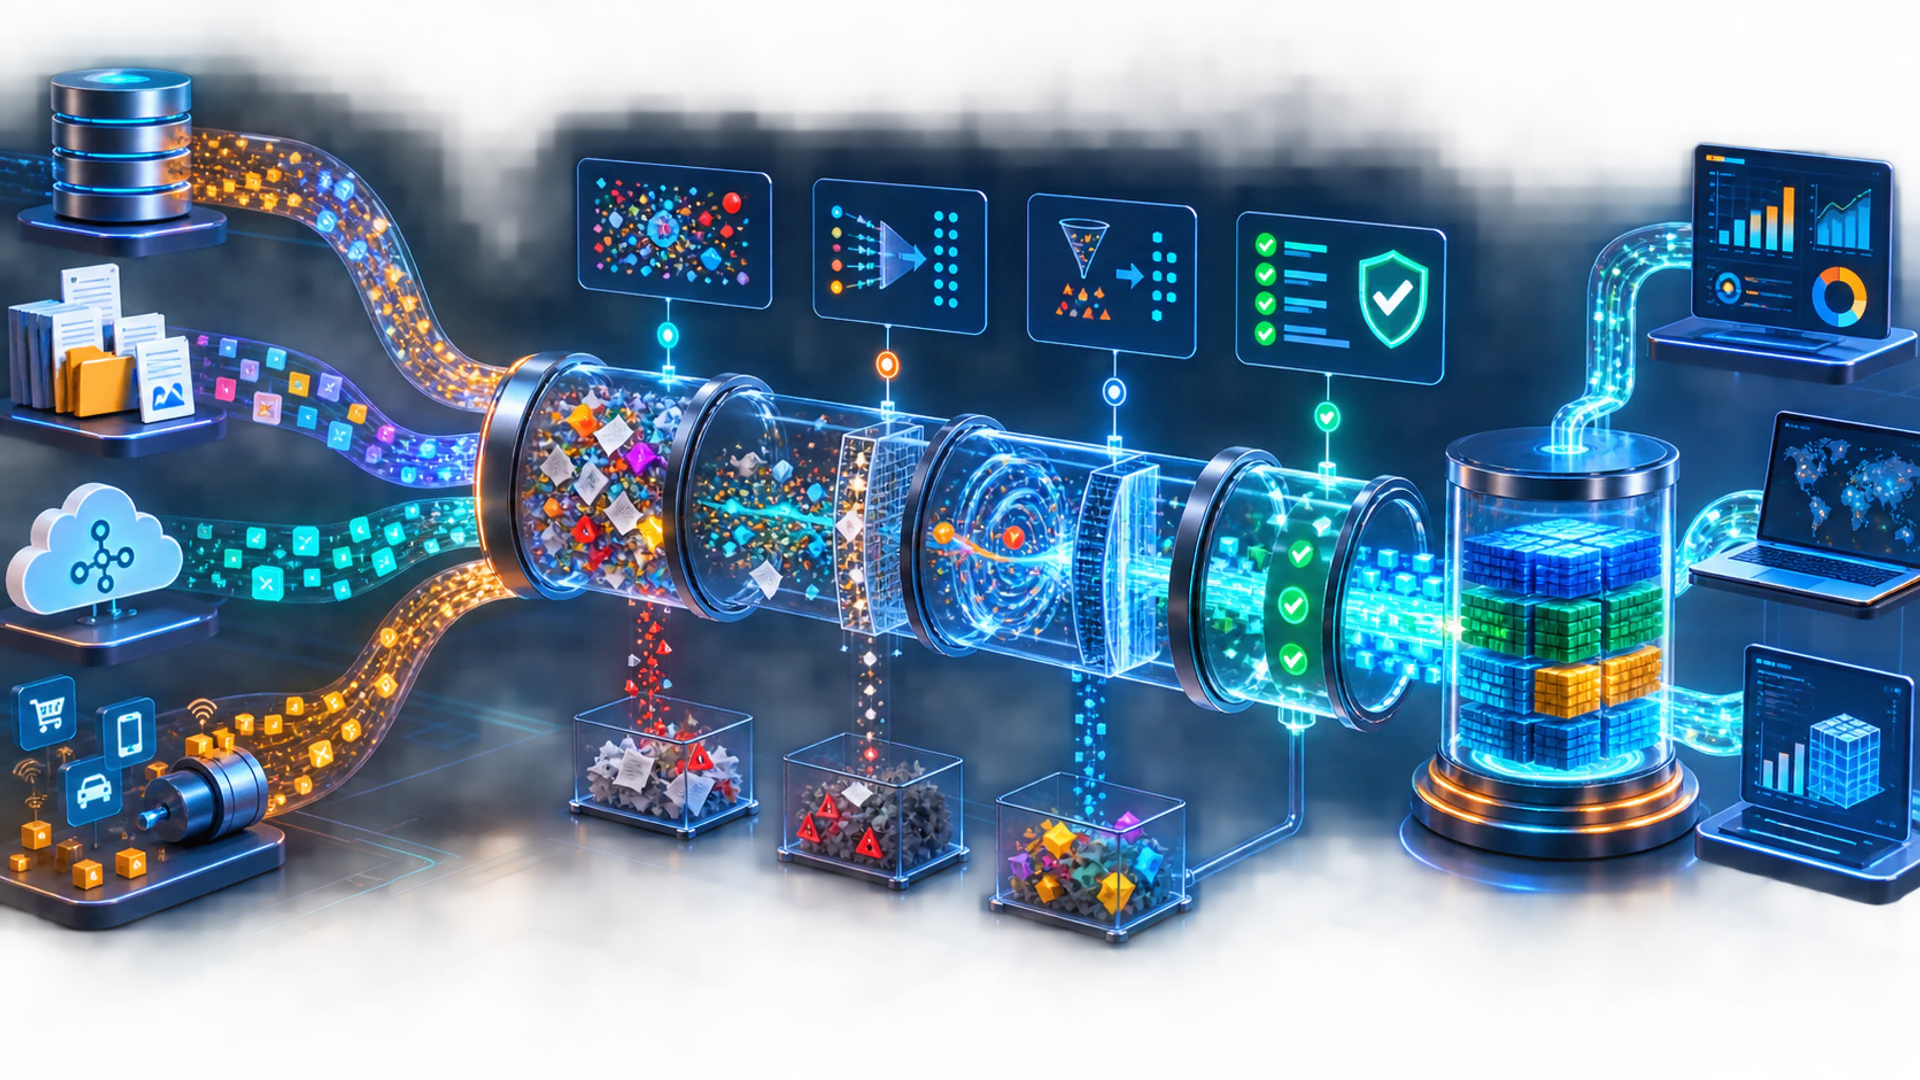
ETL—extracción, transformación, carga—es un patrón de integración de datos que lee datos de los sistemas de origen, los valida y los remodela, y luego los escribe en un destino adecuado para análisis, informes, aprendizaje automático o operaciones.
Una canalización ETL de producción es más que tres componentes. Necesita ejecución repetible, controles de esquema y calidad, linaje, orquestación, observabilidad, seguridad y una forma segura de retroalimentar o reproducir datos cuando la lógica cambia.
Puntos clave
- La extracción debe minimizar el impacto en la fuente y registrar qué intervalo o conjunto de cambios se capturó.
- Las transformaciones codifican el significado empresarial, por lo que necesitan control de versiones, pruebas y propiedad.
- Las cargas deben ser idempotentes o, de otro modo, proteger contra duplicados y fallos parciales.
- ETL frente a ELT se trata principalmente de dónde se ejecuta la transformación; los sistemas modernos a menudo usan ambos.
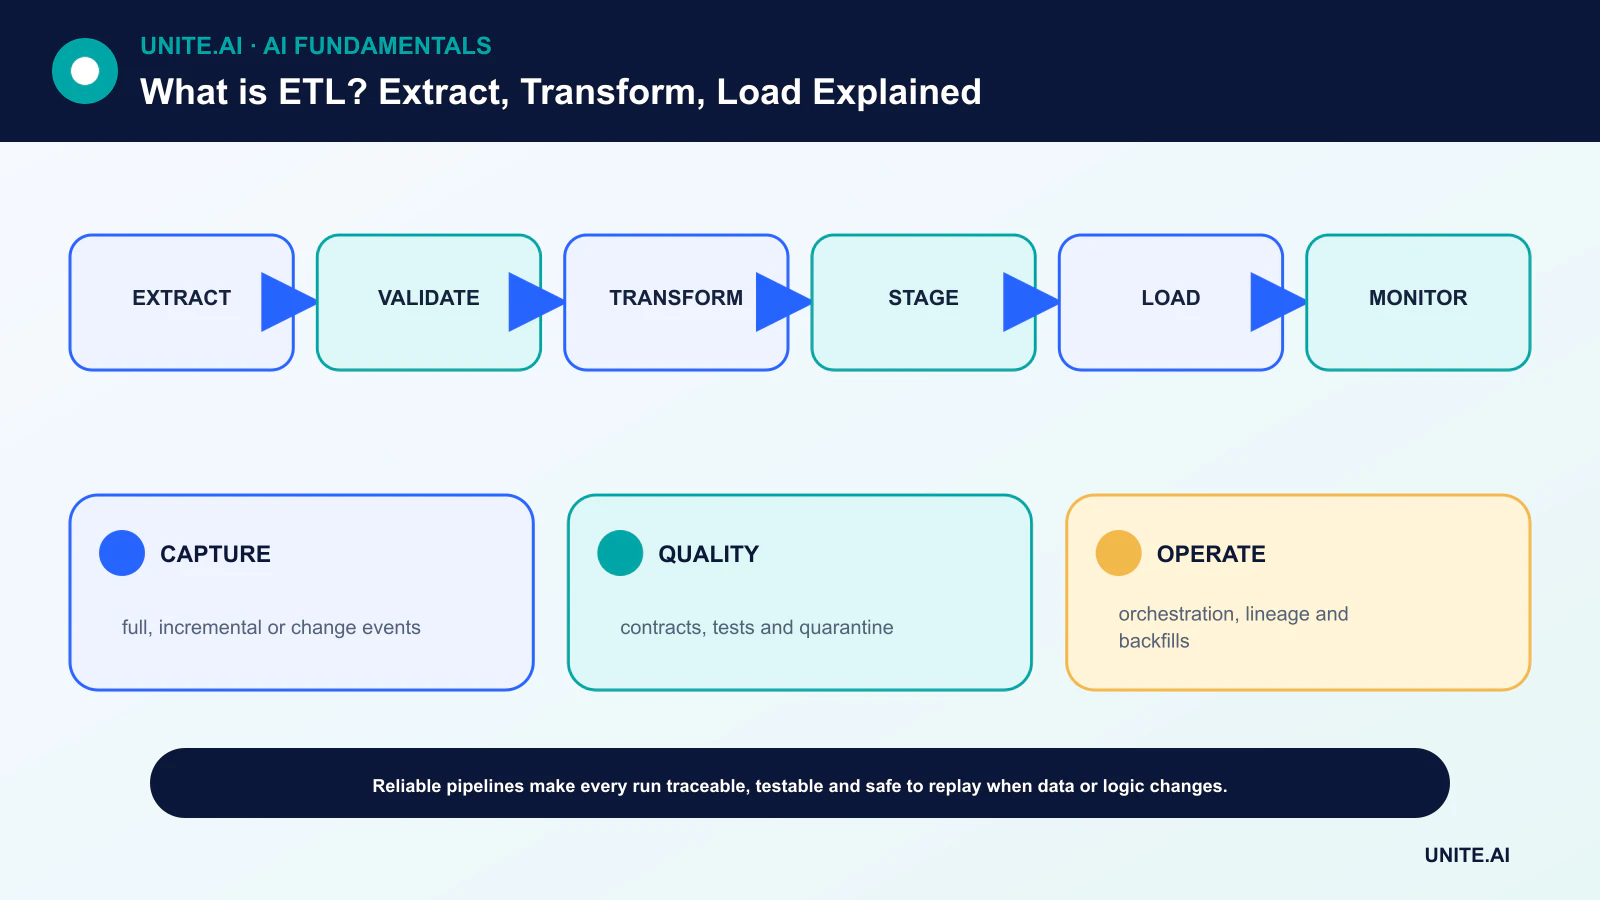
Extraer datos de manera fiable
Las fuentes pueden incluir bases de datos, archivos, API, flujos de eventos y aplicaciones. Una extracción completa copia un conjunto completo; una extracción incremental lee los registros modificados desde un punto de control. La captura de cambios de datos consume los registros o eventos de la base de datos para reducir escaneos repetidos.
Registre los identificadores de origen, los límites de tiempo y los puntos de control. Respete los límites de velocidad y la semántica de transacciones. Si una fuente cambia el esquema silenciosamente, falle de forma segura o ponga en cuarentena los registros en lugar de cargar datos ambiguos como si nada hubiera ocurrido.
Transformar con contratos explícitos
Las transformaciones estandarizan tipos y unidades, analizan registros, unen fuentes, eliminan o marcan duplicados, aplican reglas de negocio y calculan características. Separe los datos inválidos de los datos ausentes pero aceptables, y conserve suficiente evidencia para rastrear una salida hasta sus entradas.
Versione las transformaciones de la misma manera disciplinada que la entrega de software. Las pruebas deben cubrir esquema, rangos, integridad referencial, distribuciones esperadas y ejemplos conocidos. Un contrato de datos define las expectativas entre productor y consumidor.
Cargar de forma segura y repetible
Una carga puede añadir eventos, fusionar registros modificados, reemplazar una partición o reconstruir una tabla. La idempotencia significa que volver a ejecutar la misma entrada produce el mismo estado del destino. Las transacciones, tablas de preparación e intercambios atómicos reducen la exposición a actualizaciones parciales.
El particionamiento y la indexación deben coincidir con los patrones de consumo. Proteja los campos sensibles y aplique permisos de destino antes de que los datos sean consultables. Los requisitos de retención y eliminación deben acompañar a los datos.
ETL, ELT, por lotes y streaming
El ETL tradicional transforma en un motor separado antes de cargar. ELT carga datos crudos o ligeramente procesados primero, y luego usa el cómputo del destino para la transformación. Un almacén o lakehouse en la nube puede hacer que ELT sea conveniente, pero no elimina el trabajo de calidad o gobernanza.
Los pipelines por lotes procesan intervalos delimitados; los pipelines de streaming procesan eventos continuos con semánticas de tiempo y orden definidas. Muchas arquitecturas usan ingestión en streaming seguida de reconciliación periódica, porque los datos tardíos o corregidos son normales.
Orquestación, linaje y observabilidad
Un orquestador programa tareas, respeta dependencias, reintenta fallos definidos y registra el estado. Los reintentos necesitan límites y tareas idempotentes. Las retroalimentaciones deben estar aisladas y ser conscientes de la capacidad para que la reparación histórica no interrumpa los datos actuales.
Monitoree frescura, volumen, esquema, calidad, duración y costo. El linaje y la capa de metadatos de una data fabric ayudan a los consumidores a entender qué versión produjo un conjunto de datos y qué falló aguas arriba.
Extracción: fuentes, contratos y captura incremental
ETL traslada datos de los sistemas de origen, los transforma en estructuras gobernadas y carga un destino. La extracción puede usar archivos, consultas a bases de datos, API, registros, flujos o captura de cambios de datos. Defina la propiedad de la fuente, esquema, claves, marcas de tiempo, zona horaria, unidades, semántica de eliminación y carga permitida. Las extracciones completas son simples pero costosas; la captura incremental reduce el volumen pero necesita marcas de agua, posiciones de registro o campos de versión y una estrategia para registros tardíos y corregidos.
No asuma que el éxito de una API significa una extracción completa. Registre recuentos, sumas de verificación, brechas de secuencia, paginación, límites de velocidad, reintentos y capturas de pantalla de la fuente. Almacene datos crudos inmutables donde la política lo permita para que las transformaciones puedan reproducirse. Proteja credenciales y campos sensibles, y haga que los reintentos sean idempotentes. Los cambios de esquema deben clasificarse como compatibles o rupturistas mediante contratos, en lugar de descubrirse cuando un panel descendente cambia silenciosamente.
Transformar y cargar con semánticas reproducibles
Las transformaciones analizan tipos, estandarizan unidades, deduplican, unen, aplican reglas de negocio, gestionan historial y derivan hechos y dimensiones. Cada regla necesita pruebas y linaje. Ajuste el preprocesamiento estadístico solo en datos de entrenamiento apropiados cuando ETL alimenta ML. Las dimensiones que cambian lentamente determinan si los cambios de atributos sobrescriben o conservan el historial. Declare el nivel de granularidad del hecho antes de unir; los errores de muchos a muchos crean medidas duplicadas que pueden sobrevivir a verificaciones básicas de filas.
La carga puede añadir, fusionar, reemplazar particiones o actualizar registros. Use tablas de preparación e intercambios atómicos cuando sea posible para que los lectores no vean un estado parcial. Implemente unicidad, relaciones, valores aceptados, completitud e invariantes de negocio. Maneje eventos tardíos y retroalimentaciones con tiempo de evento y código versionado. La reconciliación contra los totales de origen es esencial para datos financieros y operacionales. ELT carga datos crudos antes de la transformación en el destino; los requisitos de gobernanza y corrección permanecen.
Operaciones y recuperación
La orquestación gestiona dependencias, programaciones, reintentos, concurrencia y alertas. Monitoree frescura, volumen, calidad, duración, costo e impacto descendente. Un trabajo fallido debe reanudarse o reproducirse sin duplicación. Versione el código y los esquemas, mantenga el linaje y pruebe las retroalimentaciones en aislamiento. La recuperación ante desastres incluye datos crudos, catálogos, permisos, estado de orquestación y definiciones semánticas. ETL es confiable cuando un usuario puede rastrear una métrica a sus fuentes y reproducirla después de un cambio, no solo cuando una canalización verde se completó.
Ejemplo práctico: una canalización de pedidos incremental
Un trabajo ETL lee los registros de cambios de la base de datos para pedidos y artículos, almacena eventos inmutables, valida la secuencia y el esquema, y los fusiona en una tabla de hechos del almacén con una granularidad de línea de pedido. El tiempo del evento y la versión de actualización manejan correcciones tardías; las claves determinísticas hacen que la reproducción sea idempotente. Las dimensiones conservan el historial seleccionado de clientes y productos mediante claves sustitutas. Los recuentos de filas, totales de pedidos, impuestos, devoluciones y cancelaciones se reconcilian con los períodos de origen.
Un cambio de campo de origen que rompe la compatibilidad detiene la promoción a tablas de confianza y alerta a los propietarios con el linaje descendente. Las retroalimentaciones se ejecutan con código versionado en aislamiento y se comparan antes de un intercambio atómico. La política de acceso restringe los identificadores de clientes, y la eliminación se propaga a copias derivadas permitidas. El monitoreo cubre frescura, volumen, calidad, costo e impacto en los paneles. Las pruebas de recuperación reconstruyen un período a partir de eventos crudos y restauran el estado de orquestación. Un programador verde es insuficiente a menos que los números de negocio permanezcan reproducibles y conciliados.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, interrupciones de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Use un despliegue por etapas, preserve una alternativa segura y verifique el monitoreo con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento fuera de línea persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Es ETL obsoleto en plataformas de datos en la nube?
No. Algunas plataformas favorecen ELT, pero las responsabilidades de extracción, transformación y carga siguen existiendo. Los equipos a menudo combinan ambos patrones.
¿Qué hace que una canalización ETL sea idempotente?
Puede procesar de forma segura la misma entrada nuevamente sin crear un estado de destino duplicado o inconsistente, generalmente mediante claves estables, puntos de control y escrituras transaccionales.
Referencias principales












