
Συνεντεύξεις
Xavier Conort, Συνιδρυτής και Επικεφαλής Προϊόντος της FeatureByte – Σειρά συνεντεύξεων

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
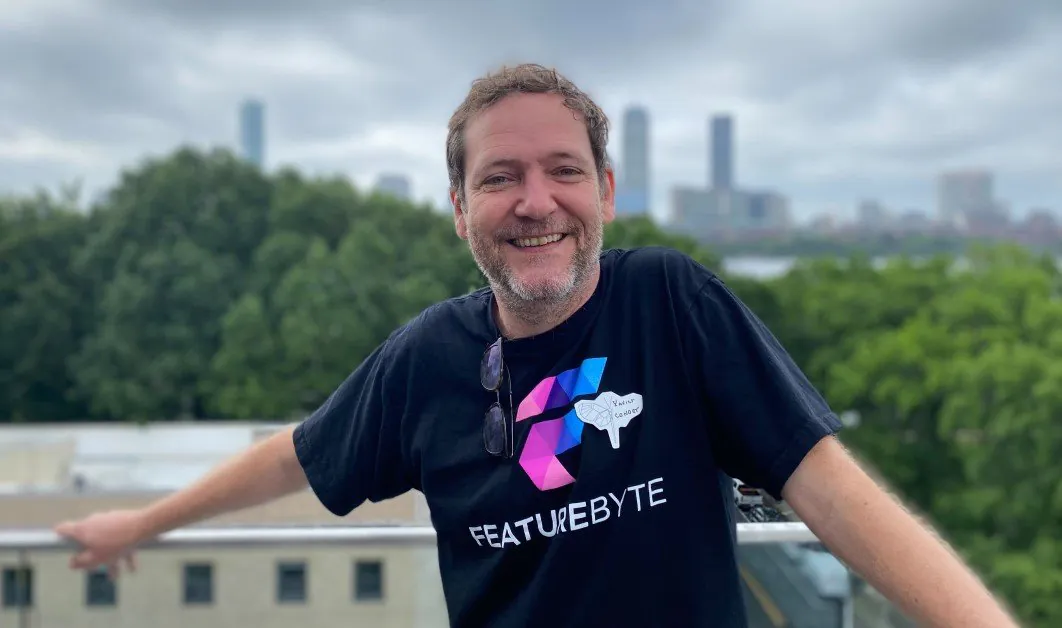
Ο Xavier Conort είναι ένας οραματιστής επιστήμονας δεδομένων με περισσότερα από 25 χρόνια εμπειρίας στα δεδομένα. Ξεκίνησε την καριέρα του ως αναλογιστής στην ασφαλιστική βιομηχανία πριν μεταπηδήσει στην επιστήμη των δεδομένων. Είναι ένας κορυφαίος διαγωνιζόμενος στο Kaggle και ήταν ο Chief Data Scientist στη DataRobot πριν συνιδρύσει την FeatureByte.
Η FeatureByte έχει ως αποστολή την κλιμάκωση της AI στις επιχειρήσεις, απλοποιώντας ριζικά και βιομηχανοποιώντας τα δεδομένα της AI. Η πλατφόρμα feature engineering και διαχείρισης ενδυναμώνει τους επιστήμονες δεδομένων να δημιουργούν και να μοιράζονται χαρακτηριστικά αιχμής και αγωγούς δεδομένων έτοιμους για παραγωγική λειτουργία σε λίγα λεπτά – αντί για εβδομάδες ή μήνες.
Ξεκινήσατε την καριέρα σας ως αναλογιστής στην ασφαλιστική βιομηχανία πριν μεταπηδήσετε στην επιστήμη των δεδομένων, τι προκάλεσε αυτή την αλλαγή;
Ένα καθοριστικό σημείο ήταν η νίκη στο GE Flight Quest, έναν διαγωνισμό που διοργανώθηκε από την GE με ένα βραβείο 250.000 δολαρίων, όπου οι συμμετέχοντες έπρεπε να προβλέψουν τις καθυστερήσεις των εσωτερικών πτήσεων στις Ηνωμένες Πολιτείες. Οφείλω μέρος αυτής της επιτυχίας σε μια πολύτιμη πρακτική του ασφαλιστικού κλάδου: τη μοντελοποίηση δύο σταδίων. Αυτή η προσέγγιση βοηθά στον έλεγχο της μεροληψίας σε χαρακτηριστικά που δεν εκπροσωπούνται επαρκώς στα διαθέσιμα δεδομένα εκπαίδευσης. Μαζί με άλλες νίκες στο Kaggle, αυτή η επιτυχία με πείστησε ότι η αναλογιστική μου εμπειρία μου έδωσε ένα ανταγωνιστικό πλεονέκτημα στον τομέα της επιστήμης των δεδομένων.
Κατά τη διάρκεια του ταξιδιού μου στο Kaggle, είχα επίσης την τιμή να συνδεθώ με άλλους ενθουσιώδεις επιστήμονες δεδομένων, συμπεριλαμβανομένων των Jeremy Achin και Tom De Godoy, οι οποίοι αργότερα έγιναν οι συνιδρυτές της DataRobot. Μοιραζόμαστε ένα κοινό υπόβαθρο στην ασφάλιση και είχαμε επιτύχει αξιοσημείωτες επιτυχίες στο Kaggle. Όταν τελικά ξεκίνησαν την DataRobot, μια εταιρεία που ειδικεύεται στην AutoML, με προσκάλεσαν να ενταχθώ στην ομάδα τους ως ο Chief Data Scientist. Το όραμά τους να συνδυάσουν τις καλύτερες πρακτικές από την ασφαλιστική βιομηχανία με την δύναμη της μηχανικής μάθησης με ενθουσίασε, παρουσιάζοντας μια ευκαιρία να δημιουργήσουμε κάτι καινοτόμο και με ουσιαστικό αντίκτυπο.
Στη DataRobot συμβάλατε καθοριστικά στη διαμόρφωση του οδικού χάρτη της επιστήμης των δεδομένων. Ποιοι τύποι προκλήσεων δεδομένων αντιμετωπίσατε;
Η πιο σημαντική πρόκληση που αντιμετωπίσαμε ήταν η ποικιλία της ποιότητας των δεδομένων που παρέχονταν ως είσοδος στην λύση AutoML μας. Αυτό το ζήτημα συχνά οδηγούσε είτε σε χρονοβόρες συνεργασίες μεταξύ της ομάδας μας και των πελατών μας, είτε σε απογοητευτικά αποτελέσματα στην παραγωγή εάν δεν αντιμετωπιστούν σωστά. Τα ζητήματα ποιότητας προέρχονταν από πολλές πηγές που απαιτούσαν την προσοχή μας.
Μια από τις βασικές προκλήσεις προέκυψε από τη γενική χρήση εργαλείων επιχειρηματικής ευφυΐας για την προετοιμασία και διαχείριση δεδομένων. Ενώ αυτά τα εργαλεία είναι πολύτιμα για την εξαγωγή χρήσιμων πληροφοριών, δεν διαθέτουν τις δυνατότητες που απαιτούνται για να διασφαλίσουν τη χρονική ορθότητα των δεδομένων (point-in-time correctness) για την προετοιμασία δεδομένων της μηχανικής μάθησης. Ως αποτέλεσμα, διαρροές στα δεδομένα εκπαίδευσης θα μπορούσαν να συμβούν, οδηγώντας σε υπερπροσαρμογή και ανακριβή απόδοση του μοντέλου.
Η κακοσυνεννόηση μεταξύ των επιστημόνων δεδομένων και των μηχανικών δεδομένων ήταν μια άλλη πρόκληση που επηρέασε την ακρίβεια των μοντέλων κατά την παραγωγή. Οι ασυνέπειες μεταξύ των φάσεων εκπαίδευσης και παραγωγής, που προέρχονται από την αποσύνδεση μεταξύ αυτών των δύο ομάδων, θα μπορούσαν να επηρεάσουν την απόδοση του μοντέλου σε ένα πραγματικό περιβάλλον.
Τι ήταν κάποια από τα βασικά συμπεράσματα από αυτήν την εμπειρία;
Η εμπειρία μου στη DataRobot τόνισε τη σημασία της προετοιμασίας δεδομένων στη μηχανική μάθηση. Αντιμετωπίζοντας τις προκλήσεις της δημιουργίας δεδομένων εκπαίδευσης μοντέλων, όπως η χρονική ορθότητα των δεδομένων (point-in-time correctness), τα κενά εμπειρογνωσίας, η γνώση τομέα, οι περιορισμοί εργαλείων και η κλιμάκωση, μπορούμε να βελτιώσουμε την ακρίβεια και την αξιοπιστία των μοντέλων μηχανικής μάθησης. Έφτασα στο συμπέρασμα ότι η απλοποίηση της διαδικασίας προετοιμασίας δεδομένων και η ενσωμάτωση καινοτόμων τεχνολογιών θα είναι ουσιαστικές για το ξεκλείδωμα του πλήρους δυναμικού της AI και την εκπλήρωση των υποσχέσεών της.
Ακούσαμε από τον συνιδρυτή σας Razi Raziuddin για την ιστορία ίδρυσης της FeatureByte, θα μπορούσατε να μας δώσετε την εκδοχή σας για τα γεγονότα;
Όταν συζήτησα τις παρατηρήσεις και τις εντυπώσεις μου με τον συνιδρυτή μου Razi Raziuddin, συνειδητοποιήσαμε ότι μοιραζόμαστε μια κοινή κατανόηση των προκλήσεων στην προετοιμασία δεδομένων για τη μηχανική μάθηση. Κατά τη διάρκεια των συζητήσεων, μοιράστηκα με τον Razi τις εντυπώσεις μου για τις πρόσφατες προόδους στην κοινότητα MLOps. Μπορούσα να παρατηρήσω την εμφάνιση των feature stores και των πλατφορμών χαρακτηριστικών που οι εταιρείες AI-first τοποθετούν για να μειώσουν την καθυστέρηση στην παροχή χαρακτηριστικών, να ενθαρρύνουν την επαναχρησιμοποίηση χαρακτηριστικών ή να απλοποιήσουν την υλοποίηση και αποθήκευση υπολογισμένων χαρακτηριστικών σε δεδομένα εκπαίδευσης ενώ διασφαλίζουν τη συνέπεια μεταξύ εκπαίδευσης και παροχής χαρακτηριστικών. Ωστόσο, ήταν σαφές σε εμάς ότι υπήρχε ακόμη ένα κενό στην ικανοποίηση των αναγκών των επιστημόνων δεδομένων. Ο Razi μοιράστηκε μαζί μου τις εντυπώσεις του για το πώς η σύγχρονη στοίβα δεδομένων έχει μεταμορφώσει την επιχειρηματική ευφυΐα και την ανάλυση, αλλά δεν αξιοποιείται πλήρως για την AI.
Έγινε σαφές και στους δύο ότι είχαμε την ευκαιρία να κάνουμε μια σημαντική επίδραση απλοποιώντας δραματικά τη διαδικασία feature engineering και παρέχοντας στους επιστήμονες δεδομένων και τους μηχανικούς ML τα σωστά εργαλεία και την εμπειρία χρήστη για απρόσκοπτο πειραματισμό και παροχή χαρακτηριστικών.
Τι ήταν κάποια από τα μεγαλύτερα προβλήματα σας στην μετάβαση από επιστήμονα δεδομένων σε επιχειρηματία;
Η μετάβαση από επιστήμονα δεδομένων σε επιχειρηματία απαιτούσε από εμένα να αλλάξω από μια τεχνική προοπτική σε μια ευρύτερη επιχειρηματική προοπτική. Ενώ είχα μια ισχυρή βάση στην κατανόηση των προβλημάτων, τη δημιουργία ενός οδικού χάρτη, την εκτέλεση σχεδίων, την κατασκευή μιας ομάδας και τη διαχείριση προϋπολογισμών, βρήκα ότι η δημιουργία του σωστού μηνύματος που πραγματικά είχε απήχηση στο κοινό στο οποίο απευθυνόμασταν ήταν ένα από τα μεγαλύτερα εμπόδια μου.
Ως επιστήμονας δεδομένων, το κύριο μέλημά μου ήταν πάντα η ανάλυση και την ερμηνεία δεδομένων για την εξαγωγή πολύτιμων πληροφοριών. Ωστόσο, ως επιχειρηματίας, έπρεπε να στρέψω την σκέψη μου προς την αγορά, τους πελάτες και την συνολική επιχείρηση.
Ευτυχώς, μπόρεσα να ξεπεράσω αυτήν την πρόκληση αξιοποιώντας την εμπειρία κάποιου σαν τον συνιδρυτή μου Razi.
Ακούσαμε από τον Razi γιατί η feature engineering είναι τόσο δύσκολη, κατά την άποψή σας τι την κάνει τόσο προκλητική;
Η feature engineering έχει δύο βασικές προκλήσεις:
- Μετατροπή υφιστάμενων στηλών: Αυτό περιλαμβάνει τη μετατροπή δεδομένων σε έναν κατάλληλο μορφότυπο για αλγορίθμους μηχανικής μάθησης. Τεχνικές όπως η one-hot κωδικοποίηση, η κλιμάκωση χαρακτηριστικών και προηγμένες μέθοδοι όπως οι μετασχηματισμοί κειμένου και εικόνας χρησιμοποιούνται. Η δημιουργία νέων χαρακτηριστικών από υφιστάμενα, όπως χαρακτηριστικά αλληλεπίδρασης, μπορεί να βελτιώσει σημαντικά την απόδοση του μοντέλου. Δημοφιλείς βιβλιοθήκες όπως η scikit-learn και η Hugging Face παρέχουν εκτεταμένη υποστήριξη για αυτόν τον τύπο feature engineering. Λύσεις AutoML στοχεύουν να απλοποιήσουν τη διαδικασία.
- Εξαγωγή νέων στηλών από ιστορικά δεδομένα: Τα ιστορικά δεδομένα είναι κρίσιμα σε τομείς όπως τα συστήματα σύστασης, το μάρκετινγκ, η ανίχνευση απάτης, η τιμολόγηση ασφαλίστρων, η πιστωτική αξιολόγηση, η πρόβλεψη ζήτησης και η επεξεργασία δεδομένων αισθητήρων. Η εξαγωγή στηλών που παρέχουν χρήσιμη πληροφορία από αυτά τα δεδομένα είναι προκλητική. Παραδείγματα περιλαμβάνουν τον χρόνο από το τελευταίο γεγονός, τις συναθροίσεις πρόσφατων γεγονότων και τις ενσωματώσεις από ακολουθίες γεγονότων. Αυτός ο τύπος feature engineering απαιτεί γνώση τομέα, πειραματισμό, ισχυρές δεξιότητες κωδικοποίησης και μηχανικής δεδομένων, και βαθιά γνώση επιστήμης δεδομένων. Παράγοντες όπως η χρονική διαρροή δεδομένων, η αντιμετώπιση μεγάλων συνόλων δεδομένων και η αποτελεσματική εκτέλεση κώδικα επίσης απαιτούν προσοχή.
Συνολικά, η feature engineering απαιτεί εμπειρογνωσία, πειραματισμό και κατασκευή σύνθετων αγωγών δεδομένων κατά περίπτωση στην απουσία εργαλείων που σχεδιάζονται ειδικά για αυτό.
Μπορείτε να μοιραστείτε πώς η FeatureByte ενδυναμώνει τους επαγγελματίες επιστήμης δεδομένων ενώ απλοποιεί τους αγωγούς χαρακτηριστικών;
Η FeatureByte ενδυναμώνει τους επαγγελματίες επιστήμης δεδομένων απλοποιώντας όλη τη διαδικασία feature engineering. Με ένα εύχρηστο Python SDK, επιτρέπει τη γρήγορη δημιουργία και εξαγωγή χαρακτηριστικών από XLarge Event και Item Tables. Η υπολογιστική επεξεργασία εκτελείται αποτελεσματικά αξιοποιώντας την κλιμάκωση των πλατφορμών δεδομένων όπως η Snowflake, DataBricks και Spark. Τα σημειωματάρια διευκολύνουν τον πειραματισμό, ενώ η κοινή χρήση και η επαναχρησιμοποίηση χαρακτηριστικών εξοικονομούν χρόνο. Ο έλεγχος εξασφαλίζει την ακρίβεια χαρακτηριστικών, ενώ η άμεση ανάπτυξη εξαλείφει τα προβλήματα διαχείρισης pipelines.
Εκτός από τις ικανότητες που προσφέρονται από τη βιβλιοθήκη ανοιχτού κώδικα, η λύση μας για επιχειρήσεις παρέχει ένα ολοκληρωμένο πλαίσιο για τη διαχείριση και την οργάνωση των λειτουργιών AI σε κλίμακα, συμπεριλαμβανομένων διαδικασιών διακυβέρνησης και μιας διεπαφής χρήστη για τον κατάλογο χαρακτηριστικών.
Ποιο είναι το όραμά σας για το μέλλον της FeatureByte;
Το τελικό μας όραμα για την FeatureByte είναι να μεταμορφώσει τον τομέα της επιστήμης δεδομένων και της μηχανικής μάθησης, ενδυναμώνοντας τους χρήστες να απελευθερώσουν το πλήρες δημιουργικό δυναμικό τους και να εξαγάγουν άνευ προηγουμένου αξία από τα περιουσιακά στοιχεία δεδομένων τους.
Είμαστε ιδιαίτερα ενθουσιασμένοι για την ταχεία πρόοδο στη Παραγωγική AI και στα μοντέλα Transformer, οι οποίοι ανοίγουν έναν κόσμο δυνατοτήτων για τους χρήστες μας. Επιπλέον, είμαστε αφοσιωμένοι στη δημοκρατικοποίηση της feature engineering. Η Παραγωγική AI έχει τη δυνατότητα να μειώσει τα εμπόδια εισόδου για τη δημιουργική feature engineering, καθιστώντας την πιο προσιτή σε ένα ευρύτερο κοινό.
Συνολικά, το όραμά μας για το μέλλον της FeatureByte περιστρέφεται γύρω από τη συνεχή καινοτομία, την αξιοποίηση της δύναμης της Παραγωγικής AI και τη δημοκρατικοποίηση της feature engineering. Στόχος μας είναι να γίνουμε η πλατφόρμα που επιτρέπει στους επαγγελματίες δεδομένων να μετατρέψουν τα ακατέργαστα δεδομένα σε αξιοποιήσιμα δεδομένα εισόδου για τη μηχανική μάθηση, οδηγώντας σε καινοτομίες και προόδους σε όλους τους τομείς.
Έχετε κάποια συμβουλή για τους επίδοξους επιχειρηματίες AI;
Ορίστε τον χώρο σας, μείνετε εστιασμένοι και καλωσορίστε την καινοτομία.
Ορίζοντας τον χώρο που θέλετε να κατέχετε, μπορείτε να διαφοροποιηθείτε και να καθιερώσετε μια ισχυρή παρουσία σε εκείνη την περιοχή. Ερευνήστε την αγορά, κατανοήστε τις ανάγκες και τα προβλήματα των δυνητικών πελατών σας, και προσπαθήστε να παρέχετε μια μοναδική λύση που αντιμετωπίζει αποτελεσματικά αυτές τις προκλήσεις.
Ορίστε το μακροπρόθεσμο όραμά σας και θέστε σαφείς βραχυπρόθεσμους στόχους που ευθυγραμμίζονται με αυτό το όραμα. Εστιαστείτε στην κατασκευή μιας ισχυρής βάσης και στην παροχή αξίας στον καθορισμένο χώρο σας.
Τέλος, ενώ είναι σημαντικό να μείνετε εστιασμένοι, μην φοβηθείτε να ενστερνιστείτε την καινοτομία και να εξερευνήσετε νέες ιδέες μέσα στον καθορισμένο χώρο σας. Ο τομέας της AI εξελίσσεται συνεχώς, και οι καινοτόμες προσεγγίσεις μπορούν να ανοίξουν νέες ευκαιρίες.
Ευχαριστούμε για την εξαιρετική συνέντευξη, οι αναγνώστες που επιθυμούν να μάθουν περισσότερα μπορούν να επισκεφθούν την FeatureByte.








