
Βασικές αρχές της AI
Τι είναι η Ενισχυτική Μάθηση από Ανθρώπινη Ανατροφοδότηση (RLHF);

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Η ενισχυτική μάθηση από ανθρώπινη ανατροφοδότηση (RLHF) είναι μια οικογένεια μεθόδων που χρησιμοποιεί ανθρώπινες κρίσεις για να βοηθήσει στη βελτιστοποίηση ενός μοντέλου όταν η επιθυμητή συμπεριφορά είναι δύσκολο να οριστεί με ένα απλό αυτόματο ανταμοιβή. Για τα γλωσσικά μοντέλα, οι άνθρωποι συνήθως συγκρίνουν υποψήφιες απαντήσεις και ένα εκπαιδευμένο μοντέλο προτιμήσεων μετατρέπει αυτές τις συγκρίσεις σε σήμα εκπαίδευσης.
Το RLHF μπορεί να κάνει ένα προεκπαιδευμένο μοντέλο πιο χρήσιμο ή καλύτερα ευθυγραμμισμένο με μια γραπτή πολιτική, αλλά δεν αποδεικνύει την αλήθεια ή την ευθυγράμμιση με κάθε χρήστη. Το αποτέλεσμα εξαρτάται από το ποιος παρέχει την ανατροφοδότηση, πώς επιλέγονται τα prompts, τι μπορεί να αντιπροσωπεύσει το μοντέλο ανταμοιβής και πώς περιορίζεται η βελτιστοποίηση.
Σημαντικά Σημεία
- Το RLHF συνήθως ακολουθεί την προεκπαίδευση και τη εποπτευόμενη ρύθμιση οδηγιών.
- Οι ζεύγες προτιμήσεων εκπαιδεύουν ένα μοντέλο ανταμοιβής ή προτίμησης· η βελτιστοποίηση πολιτικής στη συνέχεια προτιμά εξόδους με υψηλότερη βαθμολογία.
- Η παραβίαση της ανταμοιβής, η διαφωνία των αξιολογητών, η μετατόπιση κατανομής και η υπερβολική βελτιστοποίηση παραμένουν σημαντικοί κίνδυνοι.
- Αξιολογήστε την τελική πολιτική άμεσα για την ποιότητα της εργασίας, την ασφάλεια, την βαθμονόμηση και τις επιδράσεις σε υποομάδες.
Το κοινό pipeline RLHF
Ένα γλωσσικό μοντέλο αρχικά μαθαίνει τη γενική στατιστική δομή μέσω προεκπαίδευσης. Η εποπτευόμενη λεπτοκατάρτιση στη συνέχεια χρησιμοποιεί παραδείγματα επιθυμητών απαντήσεων. Για τη συλλογή προτιμήσεων, οι αξιολογητές ταξινομούν ή επιλέγουν μεταξύ εξόδων για το ίδιο prompt.
Ένα μοντέλο ανταμοιβής μαθαίνει να προβλέπει αυτές τις συγκρίσεις. Ένας αλγόριθμος reinforcement-learning όπως το PPO μπορεί να βελτιστοποιήσει το γλωσσικό μοντέλο απέναντι σε αυτήν την εκπαιδευμένη ανταμοιβή, ενώ μια ποινή το αποτρέπει από το να απομακρυνθεί πολύ από την αναφορά πολιτικής.
Η ανατροφοδότηση είναι μέτρηση, όχι αλήθεια
Οι αξιολογητές μπορεί να διαφωνούν επειδή οι οδηγίες είναι ασαφείς, η εξειδίκευση διαφέρει ή οι αξίες συγκρούονται πραγματικά. Η θέση, η πολυπλοκότητα, η αυτοπεποίθηση και το στυλ μπορούν να προκαλέσουν μεροληψία στις προτιμήσεις. Ένα πρόγραμμα υψηλής ποιότητας εκπαιδεύει τους κριτές, μετρά τη συμφωνία, ελέγχει παραδείγματα και διατηρεί την αβεβαιότητα.
Η δειγματοληψία επίσης μετρά. Εάν το σύνολο προτιμήσεων εξαιρεί δύσκολες γλώσσες, τομείς ή βλαβερές περιπτώσεις, το μοντέλο ανταμοιβής δεν μπορεί να τα εποπτεύσει αξιόπιστα. Η πειθαρχία της Data-science είναι εξίσου σημαντική με τον βελτιστοποιητή.
Καταστάσεις αποτυχίας
Η πολιτική μπορεί να εκμεταλλευτεί αδυναμίες στην εκπαιδευμένη ανταμοιβή, παράγοντας εξόδους που βαθμολογούνται υψηλά χωρίς να ικανοποιούν την υποκείμενη πρόθεση. Η υπερβολική βελτιστοποίηση μπορεί να μειώσει την ποικιλία, να ενισχύσει ένα προτιμώμενο στυλ ή να κάνει το μοντέλο υπερβολικά συμφωνικό.
Το ίδιο το μοντέλο ανταμοιβής μπορεί να αποτύχει εκτός της κατανομής εκπαίδευσής του. Οι ομάδες πρέπει να δοκιμάζουν αντιπαραθετικά prompts, πραγματικά καθήκοντα, όρια άρνησης, βαθμονόμηση και συμπεριφορά σε διαφορετικά επίπεδα βελτιστοποίησης, αντί να βασίζονται σε ένα ενιαίο ποσοστό νίκης προτιμήσεων.
Εναλλακτικές και συμπληρωματικά
Η Άμεση Βελτιστοποίηση Προτιμήσεων μαθαίνει από ζεύγη προτιμήσεων χωρίς να προσαρμόζει ξεχωριστή πολιτική μέσω ενός διαδικτυακού βρόχου ενισχυτικής μάθησης. Η απορριπτική δειγματοληψία, η εποπτευόμενη λεπτοκατάρτιση προτιμήσεων, η ανατροφοδότηση βάσει κανόνων και η εποπτεία διαδικασίας προσφέρουν άλλες ανταλλαγές.
Καμία μέθοδος δεν αφαιρεί την ανάγκη για prompt, ανάκτηση, εργαλεία και ελέγχους σε επίπεδο εφαρμογής. Η μετα‑εκπαίδευση διαμορφώνει τη συμπεριφορά· τα συστήματα σε παραγωγή εξακολουθούν να απαιτούν τεκμηριωμένα αποδεικτικά στοιχεία, άδειες, παρακολούθηση και ανθρώπινη κλιμάκωση.
Πώς εκπαιδεύονται τα μοντέλα προτιμήσεων
Για ένα prompt x και δύο απαντήσεις y₁ και y₂, ένα μοντέλο προτιμήσεων εκχωρεί βαθμολογίες σε κλίμακα και εκπαιδεύεται έτσι ώστε η προτιμώμενη απάντηση να λαμβάνει τη μεγαλύτερη βαθμολογία. Μια κοινή συνάρτηση απώλειας βασίζεται στην πιθανότητα μια βαθμολογία να υπερβαίνει την άλλη. Αυτό μετατρέπει πολλές ζεύγες κριτικών σε μια συνάρτηση που μπορεί να βαθμολογήσει νέες παραγόμενες εξόδους.
Το μοντέλο μαθαίνει ό,τι σήματα προβλέπουν τις συλλεγμένες επιλογές. Εάν οι κριτές προτιμούν σίγουρο κείμενο, πιο μακρές απαντήσεις, συγκεκριμένα πολιτισμικά πρότυπα ή οικεία οπτικά σημεία, αυτές οι συσχετίσεις μπορούν να γίνουν χαρακτηριστικά ανταμοιβής. Ισορροπημένες οδηγίες, αντιπαραδείγματα, εξειδικευμένη αξιολόγηση και έλεγχοι για επιφανειακές προτιμήσεις μειώνουν, αλλά δεν εξαλείφουν, το πρόβλημα.
Τα δεδομένα προτιμήσεων μπορούν να περιλαμβάνουν ισοπαλίες, κατατάξεις, κριτικές, κλίμακες ετικετών ή παραδείγματα. Η επιλογή ζεύγους μετρά: συγκρίσεις μεταξύ προφανώς διαφορετικών απαντήσεων διδάσκουν λιγότερο για λεπτές ορίσεις ποιότητας, ενώ μόνο δύσκολα ζεύγη μπορούν να κάνουν την εκπαίδευση ασταθή. Η ενεργή δειγματοληψία μπορεί να στοχεύσει σε ενημερωτικές διαφωνίες, αλλά μπορεί να αλλάξει τη διανομή των δεδομένων.
Βελτιστοποίηση πολιτικής και τακτοποίηση
Το RLHF βασισμένο σε PPO δειγματοληπτεί απαντήσεις από την τρέχουσα πολιτική, τις βαθμολογεί με το μοντέλο ανταμοιβής και ενημερώνει την πολιτική ώστε να αυξήσει την αναμενόμενη ανταμοιβή. Μια ποινή Kullback–Leibler ή σχετικός περιορισμός διατηρεί την πολιτική κοντά στην εποπτευόμενη αναφορά, περιορίζοντας την καταστροφική μετατόπιση και αποτρέποντας την εκμετάλλευση στενών αδυναμιών του μοντέλου ανταμοιβής.
Η ένταση της βελτιστοποίησης είναι επιλογή προϊόντος. Πολύ μικρή αφήνει την επιθυμητή συμπεριφορά αμετάβλητη· πολύ μεγάλη μπορεί να προκαλέσει παραβίαση ανταμοιβής, επαναλαμβανόμενη διατύπωση, υποταγή ή μειωμένη ποικιλία. Παρακολουθήστε τις μετρικές ποιότητας και ασφάλειας σε σχέση με την ανταμοιβή και τη διαφορά κατά τη διάρκεια της εκπαίδευσης, αντί να επιλέγετε σημείο ελέγχου μόνο με βάση την ανταμοιβή.
Οι μέθοδοι άμεσης προτίμησης προέρχονται από ένα στόχο που βασίζεται σε ζεύγη προτιμήσεων και ένα μοντέλο αναφοράς χωρίς ρητό διαδικτυακό βρόχο RL. Μπορούν να απλοποιήσουν την εκπαίδευση, αλλά εξακολουθούν να κληρονομούν την ποιότητα των προτιμήσεων, την κάλυψη και τις υποθέσεις της πολιτικής αναφοράς. Η συνταγματική ή η AI‑γεννημένη ανατροφοδότηση αλλάζει ποιος παρέχει τις ετικέτες· δεν αφαιρεί την ανάγκη επικύρωσης των αξιών και των αποτυχιών με ανθρώπους.
Αξιολόγηση και διακυβέρνηση δεδομένων
Χρησιμοποιήστε τυφλές συγκρίσεις, δοκιμές ειδικές για εργασίες, αντιπαραθετικά prompts, ελέγχους πραγματικότητας, ακρίβεια και ανάκληση άρνησης, και ανασκόπηση υποομάδων. Διαχωρίστε τους αξιολογητές από τα δεδομένα εκπαίδευσης όπου είναι δυνατόν. Ένα ποσοστό νίκης έναντι ενός παλαιότερου μοντέλου μπορεί να κρύβει απόλυτες αποτυχίες όταν και οι δύο υποψήφιοι είναι κακοί.
Καταγράψτε την πρόσληψη αξιολογητών, την αποζημίωση, την εξειδίκευση, τη γεωγραφία, τη γλώσσα, τις οδηγίες, την έκθεση σε επιβλαβές περιεχόμενο, τις διαφωνίες, τη διαιτησία και τους ελέγχους ποιότητας. Η εργασία ανατροφοδότησης μπορεί να ενέχει ψυχολογικό κίνδυνο, και οι υπεύθυνες λειτουργίες δεδομένων περιλαμβάνουν υποστήριξη των εργαζομένων και το δικαίωμα άρνησης ενοχλητικών εργασιών.
Μετά την υλοποίηση, παρακολουθήστε τη μετατόπιση προτιμήσεων και την υπεργενίκευση. Μια πολιτική προσαρμοσμένη για ανεπίσημη βοήθεια μπορεί να συμπεριφέρεται άσχημα σε ιατρικά ή νομικά πλαίσια. Διατηρήστε τα όρια τομέα, την ανάκτηση, τις άδειες και την κλιμάκωση εκτός της υπόθεσης RLHF, και επανεκπαιδεύστε μόνο όταν νέα αποδεικτικά στοιχεία δικαιολογούν την αλλαγή.
Ένα συγκεκριμένο pipeline εκπαίδευσης και αξιολόγησης RLHF
Ένα τυπικό έργο ξεκινά με ένα προεκπαιδευμένο γλωσσικό μοντέλο και ένα σύνολο δεδομένων οδηγιών που χρησιμοποιείται για εποπτευόμενη λεπτοκατάρτιση. Οι αξιολογητές στη συνέχεια συγκρίνουν υποψήφιες απαντήσεις βάσει ενός γραπτού ρυθμιστικού πλαισίου που καλύπτει ορθότητα, συνάφεια, στυλ, ασφάλεια και αβεβαιότητα. Οι ζεύγες προτιμήσεων εκπαιδεύουν ένα μοντέλο ανταμοιβής ή βελτιστοποιούν άμεσα την πολιτική. Η δειγματοληψία πρέπει να περιλαμβάνει συνηθισμένες εργασίες, δύσκολες άκρες περιπτώσεις, αντιπαραθετικά prompts, πολλαπλές γλώσσες και περιοχές όπου οι αξιολογητές διαφωνούν νόμιμα.
Η ακρίβεια του μοντέλου ανταμοιβής σε συγκρίσεις εκτός δείγματος είναι απαραίτητη αλλά όχι επαρκής. Η βελτιστοποιημένη πολιτική μπορεί να εκμεταλλευτεί σφάλματα στην εκπαιδευμένη ανταμοιβή, να γίνει υπερβολικά πολυλογική, να αρνείται αβλαβείς αιτήσεις ή να χάσει δυνατότητες. Παρακολουθήστε τα benchmarks εργασιών, τις ανθρώπινες προτιμήσεις, τη βαθμονόμηση, την ασφάλεια, την ποικιλία και τη διαφορά από το μοντέλο αναφοράς κατά τη διάρκεια της εκπαίδευσης. Συλλέξτε περιοδικά νέες συγκρίσεις από την εξελισσόμενη πολιτική ώστε τα δεδομένα προτιμήσεων να καλύπτουν τις εξόδους που το μοντέλο παράγει πραγματικά.
Καταγράψτε ποιος παρείχε τις προτιμήσεις, τις οδηγίες τους, την αποζημίωση, τις διαφωνίες, τους ελέγχους ποιότητας και τα πολιτισμικά ή τομεακά όρια. Χρησιμοποιήστε εξειδικευμένους κριτές όπου τα λάθη ενέχουν ειδική βλάβη. Διενεργήστε red‑team τόσο στο μοντέλο ανταμοιβής όσο και στην τελική πολιτική, διατηρήστε δοκιμές παλινδρόμησης συμπεριφοράς και προετοιμάστε την υλοποίηση. Το RLHF διαμορφώνει τη συμπεριφορά σύμφωνα με τις μετρημένες προτιμήσεις· δεν αποδεικνύει την αλήθεια, δεν εξαλείφει τις προκαταλήψεις και δεν λύνει το ευρύτερο πρόβλημα του καθορισμού του τι πρέπει να κάνει ένα μοντέλο σε κάθε πλαίσιο.
Λίστα ελέγχου πρακτικής υλοποίησης
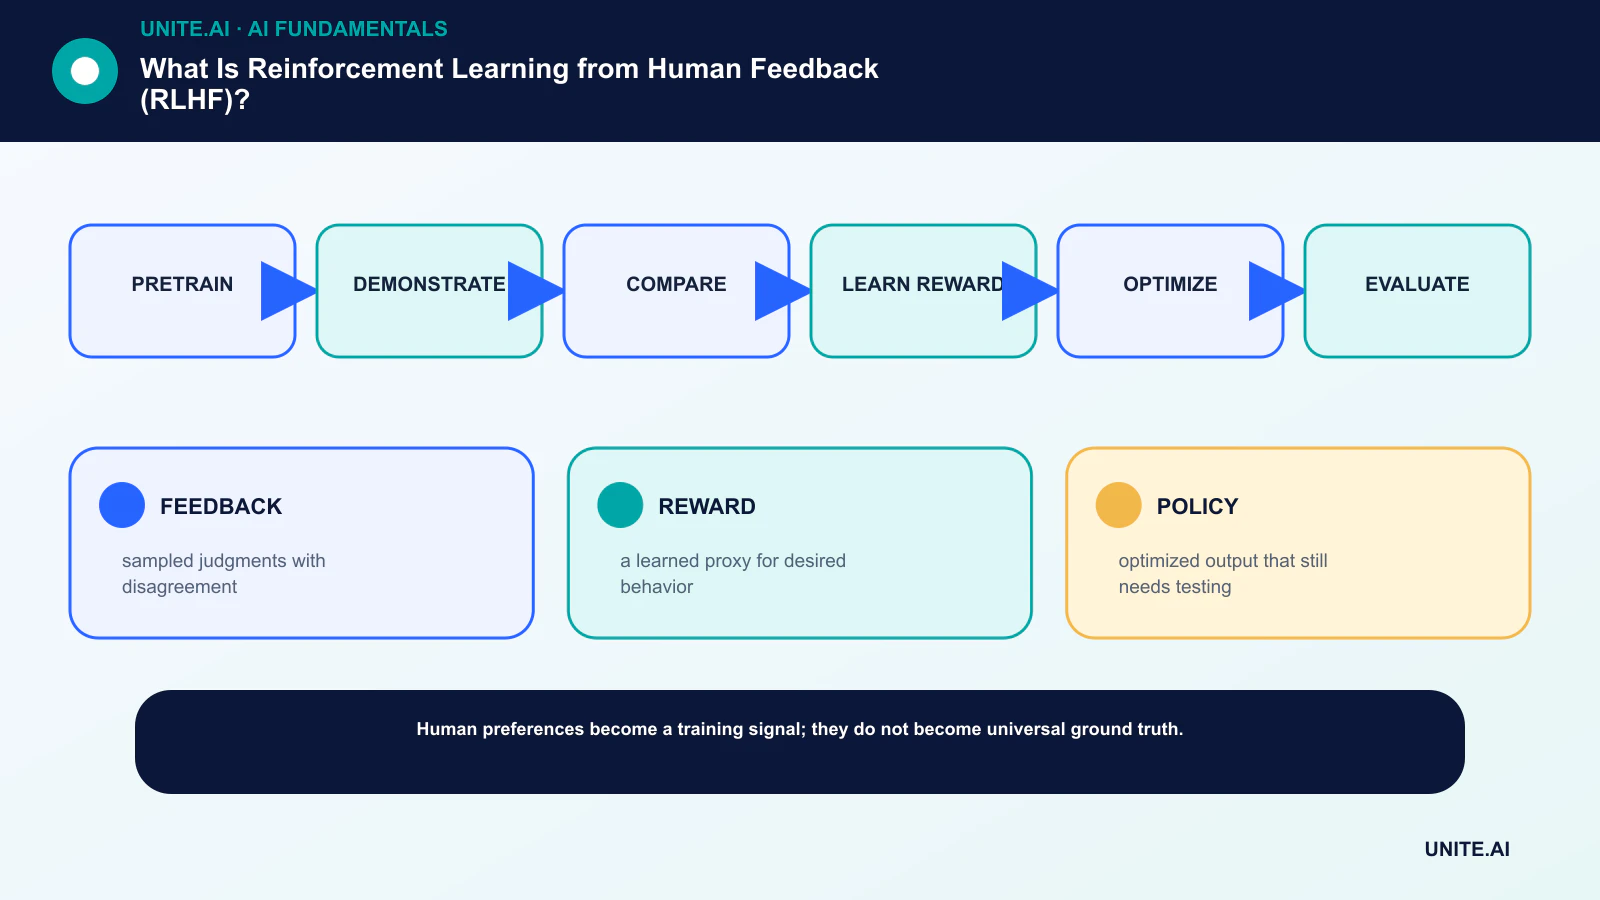
Μετατρέψτε την έννοια σε ένα περιορισμένο, ελεγχόμενο ροή εργασίας: προεκπαίδευση → επίδειξη → σύγκριση → εκμάθηση ανταμοιβής → βελτιστοποίηση → αξιολόγηση. Ορίστε έναν υπεύθυνο ιδιοκτήτη, καταγράψτε τα δεδομένα και τις εξαρτήσεις, θέστε μια απλή βάση, ορίστε κριτήρια αποδοχής και διακοπής, δοκιμάστε αντιπροσωπευτικές αποτυχίες και ορίστε παρακολούθηση, επαναφορά και ανασκόπηση πριν επεκτείνετε το πεδίο. Καταγράψτε εκδόσεις και υποθέσεις ώστε μια άλλη ομάδα να μπορεί να αναπαράγει το αποτέλεσμα και να καταλάβει τι άλλαξε.
Πριν την κυκλοφορία, εκτελέστε μια τεκμηριωμένη αξιολόγηση ετοιμότητας με τα άτομα που κατασκευάζουν, λειτουργούν, ασφαλίζουν και επηρεάζονται από το σύστημα. Δοκιμάστε κανονικές περιπτώσεις, όρια, αποτυχίες εξαρτήσεων και κακή χρήση· διατηρήστε τα αποδεικτικά στοιχεία και τους αδιευκρινείς κινδύνους. Ορίστε ποιος μπορεί να εγκρίνει την κυκλοφορία, να αλλάξει ένα όριο, να παρακάμψει μια έξοδο ή να σταματήσει τη λειτουργία. Επανεξετάστε την απόφαση μετά την άφιξη πραγματικών δεδομένων, επειδή ένα τεχνικά επιτυχημένο πιλότ δεν εγγυάται αξιόπιστη απόδοση σε μεγαλύτερη κλίμακα.
- FEEDBACK: δειγματοληπτικές κρίσεις με διαφωνίες.
- REWARD: μια εκπαιδευμένη εναλλακτική για την επιθυμητή συμπεριφορά.
- POLICY: βελτιστοποιημένη έξοδος που εξακολουθεί να χρειάζεται δοκιμή.
Συχνές ερωτήσεις
Το RLHF είναι το ίδιο με τη λεπτοκατάρτιση;
Το RLHF είναι μια μορφή μετα‑εκπαίδευσης που χρησιμοποιεί ανταμοιβές προεξαχθείσες από προτιμήσεις. Η εποπτευόμενη λεπτοκατάρτιση εκπαιδεύει άμεσα στα επιθυμητά αποτελέσματα· πολλά pipelines χρησιμοποιούν και τα δύο.
Το RLHF κάνει ένα μοντέλο αληθινό;
Μπορεί να βελτιώσει τη συμπεριφορά που μετράται από τη διαδικασία ανατροφοδότησης, αλλά ένα μοντέλο μπορεί ακόμη να είναι λανθασμένο, πειστικό ή να εκμεταλλεύεται στρατηγικά την ανταμοιβή. Η αλήθεια απαιτεί άμεση αξιολόγηση και τεκμηρίωση.
Κύριες αναφορές












