
AGI και το μέλλον της AI
Ο ρόλος των διανυσματικών βάσεων δεδομένων στις σύγχρονες εφαρμογές παραγωγικής AI

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google

Βασικά σημείαΟι διανυσματικές βάσεις δεδομένων επιτρέπουν γρήγορες αναζητήσεις ομοιότητας για…
Δείτε περισσότερα
- Οι διανυσματικές βάσεις δεδομένων επιτρέπουν γρήγορες αναζητήσεις ομοιότητας για δεδομένα υψηλών διαστάσεων, όπως οι ενσωματώσεις, μια βασική απαίτηση για αποτελεσματικές εφαρμογές Γενετικής Τεχνητής Νοημοσύνης.
- Μεγάλες τεχνολογικές εταιρείες, όπως η Microsoft και η Oracle, επενδύουν στις δυνατότητες διανυσματικών βάσεων δεδομένων για την τροφοδοσία εργαλείων ΤΝ και της Ενισχυμένης Ανάκτησης Γενετικού Περιεχομένου.
- Οι διανυσματικές βάσεις δεδομένων μετασχηματίζουν την αναζήτηση από αντιστοίχιση λέξεων-κλειδιών σε σημασιολογική ανάκτηση, κατανοώντας την πρόθεση του χρήστη σε κείμενο, εικόνες και ήχο.
Για να λειτουργούν αποτελεσματικά οι μεγάλης κλίμακας εφαρμογές παραγωγικής τεχνητής νοημοσύνης, χρειάζονται καλό σύστημα για να χειριστούν πολλά δεδομένα. Ένα τέτοιο σημαντικό σύστημα είναι η βάση δεδομένων διανυσμάτων. Αυτό που διακρίνει αυτή τη βάση δεδομένων είναι η ικανότητά της να χειρίζεται πολλά είδη δεδομένων, όπως κείμενο, ήχο, εικόνες και βίντεο, σε μορφή διανύσματος.
Τι είναι οι Βάσεις Δεδομένων Διανυσμάτων;
Η βάση δεδομένων διανυσμάτων είναι ένα εξειδικευμένο σύστημα αποθήκευσης που σχεδιάστηκε για να χειρίζεται αποτελεσματικά διανύσματα υψηλής διάστασης. Αυτά τα διανύσματα, τα οποία μπορούν να θεωρηθούν ως σημεία σε ένα πολυδιάστατο χώρο, συχνά αντιπροσωπεύουν ενσωματώσεις ή συμπιεσμένες αναπαραστάσεις πιο σύνθετων δεδομένων, όπως εικόνες, κείμενο ή ήχος.
Οι βάσεις δεδομένων διανυσμάτων επιτρέπουν γρήγορες αναζητήσεις ομοιότητας μεταξύ αυτών των διανυσμάτων, επιτρέποντας τη γρήγορη ανάκτηση των πιο παρόμοιων στοιχείων από ένα τεράστιο σύνολο δεδομένων.
Παραδοσιακές Βάσεις Δεδομένων vs. Βάσεις Δεδομένων Διανυσμάτων
Βάσεις Δεδομένων Διανυσμάτων:
- Χειρίζονται Δεδομένα Υψηλής Διαστάσεως: Οι βάσεις δεδομένων διανυσμάτων σχεδιάστηκαν για να διαχειρίζονται και να αποθηκεύουν δεδομένα σε χώρους υψηλής διάστασης. Αυτό είναι ιδιαίτερα χρήσιμο για εφαρμογές όπως η μηχανική μάθηση, όπου τα δεδομένα μπορούν να αντιπροσωπεύονται ως διανύσματα σε πολυδιάστατους χώρους.
- Βελτιστοποιημένες για Αναζητήσεις Ομοιότητας: Ένα από τα εξαιρετικά χαρακτηριστικά των βάσεων δεδομένων διανυσμάτων είναι η ικανότητά τους να πραγματοποιούν αναζητήσεις ομοιότητας. Αντί να αναζητούν δεδομένα με βάση ακριβείς αντιστοιχίες, αυτές οι βάσεις δεδομένων επιτρέπουν την ανάκτηση δεδομένων που είναι “παρόμοια” με μια δεδομένη ερώτηση, καθιστώντας τις απαραίτητες για εργασίες όπως η ανάκτηση εικόνων ή κειμένου.
- Κλιμακωτές για Μεγάλες Συλλογές Δεδομένων: Όσο οι εφαρμογές της τεχνητής νοημοσύνης και της μηχανικής μάθησης συνεχίζουν να αυξάνονται, αυξάνεται και η ποσότητα των δεδομένων που επεξεργάζονται. Οι βάσεις δεδομένων διανυσμάτων είναι κατασκευασμένες για να κλιμακωθούν, εξασφαλίζοντας ότι μπορούν να χειριστούν τεράστιες ποσότητες δεδομένων χωρίς να επηρεάσουν την απόδοσή τους.
Παραδοσιακές Βάσεις Δεδομένων:
- Αποθήκευση Δεδομένων με Δομή: Οι παραδοσιακές βάσεις δεδομένων, όπως οι σχεσιακές βάσεις δεδομένων, σχεδιάστηκαν για να αποθηκεύουν δεδομένα με δομή. Αυτό σημαίνει ότι τα δεδομένα οργανώνονται σε προκαθορισμένους πίνακες, γραμμές και στήλες, εξασφαλίζοντας την ακεραιότητα και τη συνέπεια των δεδομένων.
- Βελτιστοποιημένες για CRUD Operations: Οι παραδοσιακές βάσεις δεδομένων είναι κυρίως βελτιστοποιημένες για CRUD operations. Αυτό σημαίνει ότι είναι σχεδιασμένες για να δημιουργούν, να διαβάζουν, να ενημερώνουν και να διαγράφουν αποτελεσματικά τις εγγραφές δεδομένων, καθιστώντας τις κατάλληλες για μια ευρεία γκάμα εφαρμογών, από υπηρεσίες web έως λογισμικό επιχείρησης.
- Σταθερό Σχήμα: Ένα από τα οριστικά χαρακτηριστικά πολλών παραδοσιακών βάσεων δεδομένων είναι το σταθερό σχήμα. Μόλις οριστεί η δομή της βάσης δεδομένων, η αλλαγή της μπορεί να είναι σύνθετη και χρονοβόρα. Αυτή η αυστηρότητα εξασφαλίζει την ακεραιότητα των δεδομένων, αλλά μπορεί να είναι λιγότερο ευέλικτη από τη δυνατότητα λειτουργίας χωρίς σταθερό σχήμα ή με δυναμικό σχήμα ορισμένων σύγχρονων βάσεων δεδομένων.
Οι παραδοσιακές βάσεις δεδομένων συχνά αγωνίζονται με τη σύνθετη φύση των ενσωματώσεων, μια πρόκληση που αντιμετωπίζεται εύκολα από τις βάσεις δεδομένων διανυσμάτων.
Αναπαραστάσεις Διανυσμάτων
Κεντρικό στη λειτουργία των βάσεων δεδομένων διανυσμάτων είναι η θεμελιώδης έννοια της αναπαράστασης διαφορετικών μορφών δεδομένων χρησιμοποιώντας αριθμητικά διανύσματα. Ας πάρουμε ως παράδειγμα μια εικόνα. Όταν βλέπετε μια εικόνα ενός γατιού, ενώ μπορεί να είναι απλώς μια εικόνα για εμάς, για μια μηχανή μπορεί να μετατραπεί σε ένα μοναδικό 512-διάστατο διανύσμα, όπως:
[0.23, 0.54, 0.32, …, 0.12, 0.45, 0.90]
Με τις βάσεις δεδομένων διανυσμάτων, οι εφαρμογές της παραγωγικής τεχνητής νοημοσύνης μπορούν να κάνουν πολλά περισσότερα. Μπορούν να αναζητήσουν πληροφορίες με βάση τη σημασία και να θυμηθούν πράγματα για πολύ καιρό. Αυτή η μέθοδος δεν περιορίζεται μόνο στις εικόνες. Τα κείμενα, με πληροφορίες συμφραζομένων και σημασιολογικό περιεχόμενο, μπορούν επίσης να μετατραπούν σε μορφή διανύσματος.
Παραγωγική τεχνητή νοημοσύνη και η Ανάγκη για Βάσεις Δεδομένων Διανυσμάτων
Η παραγωγική τεχνητή νοημοσύνη συχνά εμπλέκει ενσωματώσεις. Πάρτε, για παράδειγμα, τις ενσωματώσεις λέξεων στην επεξεργασία φυσικής γλώσσας (NLP). Οι λέξεις ή οι προτάσεις μετατρέπονται σε διανύσματα που καταγράφουν τη σημασιολογική σημασία. Όταν παράγουν ανθρώπινο κείμενο, τα μοντέλα χρειάζονται να συγκρίνουν και να ανακτήσουν γρήγορα τις σχετικές ενσωματώσεις, εξασφαλίζοντας ότι το παραγόμενο κείμενο διατηρεί τις πλαίσιολογικές σημασίες.
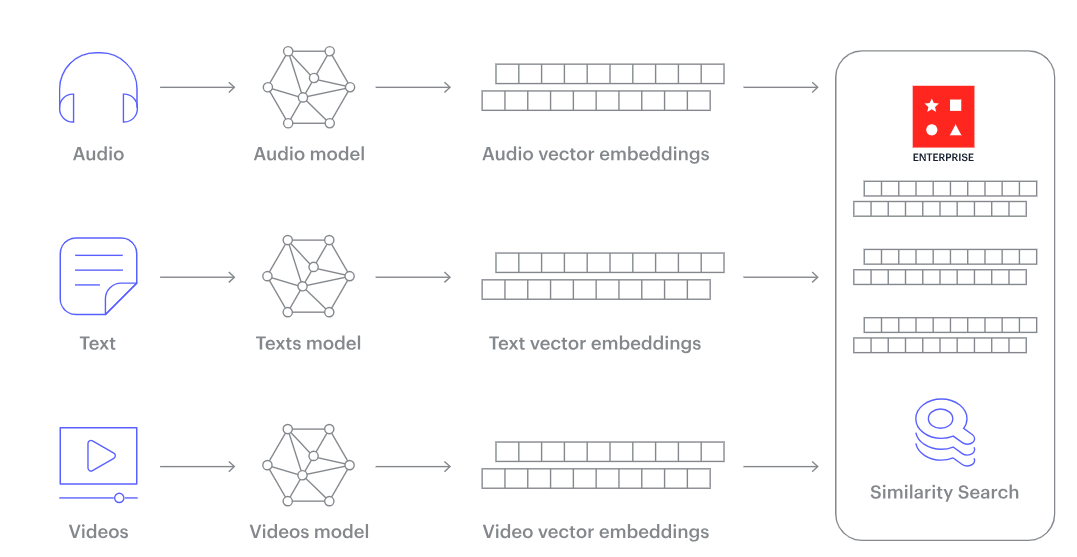
Ομοίως, στη δημιουργία εικόνας ή ήχου, οι ενσωματώσεις παίζουν κρίσιμο ρόλο στην κωδικοποίηση προτύπων και χαρακτηριστικών. Για αυτά τα μοντέλα να λειτουργούν βέλτιστα, χρειάζονται μια βάση δεδομένων που επιτρέπει την άμεση ανάκτηση παρόμοιων διανυσμάτων, καθιστώντας τις βάσεις δεδομένων διανυσμάτων ένα απαραίτητο στοιχείο του παζλ της παραγωγικής τεχνητής νοημοσύνης.
Η δημιουργία ενσωματώσεων για φυσική γλώσσα συνήθως εμπλέκει τη χρήση προ-εκπαιδευμένων μοντέλων όπως:
- GPT-3 και GPT-4: Το GPT-3 της OpenAI (Generative Pre-trained Transformer 3) υπήρξε ένα μοντέλο ορόσημο στην κοινότητα NLP με 175 δισεκατομμύρια παραμέτρους. Ακολουθώντας το, το GPT-4, με ακόμη περισσότερες παραμέτρους, συνεχίζει να διευρύνει τα όρια στην παραγωγή υψηλής ποιότητας ενσωματώσεων. Αυτά τα μοντέλα έχουν εκπαιδευτεί σε διάφορα σύνολα δεδομένων, επιτρέποντάς τους να δημιουργήσουν ενσωματώσεις που καταγράφουν μια ευρεία γκάμα γλωσσικών αποχρώσεων.
- BERT και οι παραλλαγές του: Το BERT (Bidirectional Encoder Representations from Transformers) της Google είναι ένα άλλο σημαντικό μοντέλο που έχει δει διάφορες ενημερώσεις και παραλλαγές όπως RoBERTa και DistillBERT. Η αμφίδρομη εκπαίδευση του BERT, η οποία διαβάζει το κείμενο και στις δύο κατευθύνσεις, είναι ιδιαίτερα αποτελεσματική στην κατανόηση του πλαισίουλογικού περιβάλλοντος μιας λέξης.
- ELECTRA: Ένα πιο πρόσφατο μοντέλο που είναι αποτελεσματικό και έχει παρόμοια απόδοση με μεγαλύτερα μοντέλα όπως το GPT-3 και το BERT, ενώ απαιτεί λιγότερους υπολογιστικούς πόρους. Το ELECTRA διακρίνει μεταξύ πραγματικών και ψευδών δεδομένων κατά την προ-εκπαίδευση, βοηθώντας στην παραγωγή πιο εξευγενισμένων ενσωματώσεων.

Κατανόηση της παραπάνω διαδικασίας:
Αρχικά, ένα μοντέλο ενσωμάτωσης χρησιμοποιείται για να μετατρέψει το επιθυμητό περιεχόμενο σε ενσωματώσεις διανυσμάτων. Μόλις δημιουργηθούν, αυτές οι ενσωματώσεις αποθηκεύονται μέσα σε μια βάση δεδομένων διανυσμάτων. Για εύκολη αναγνώριση και σχετικότητα, αυτές οι αποθηκευμένες ενσωματώσεις διατηρούν μια σύνδεση ή αναφορά στο αρχικό περιεχόμενο από το οποίο προέρχονται.
Αργότερα, όταν ένας χρήστης ή ένα σύστημα θέτει μια ερώτηση στην εφαρμογή, το ίδιο μοντέλο ενσωμάτωσης ενεργοποιείται. Μετατρέπει αυτή την ερώτηση σε αντίστοιχες ενσωματώσεις. Αυτές οι νέες ενσωματώσεις αναζητούν στη βάση δεδομένων διανυσμάτων, αναζητώντας παρόμοιες αναπαραστάσεις διανυσμάτων. Οι ενσωματώσεις που αναγνωρίζονται ως αντιστοιχίες έχουν μια άμεση σύνδεση με το αρχικό περιεχόμενο, εξασφαλίζοντας ότι η ερώτηση του χρήστη αντιμετωπίζεται με σχετικές και ακριβείς απαντήσεις.
Αύξηση Χρηματοδότησης για Νέους Εισερχόμενους στη Βάση Δεδομένων Διανυσμάτων
Με την αυξανόμενη δημοτικότητα της τεχνητής νοημοσύνης, πολλές εταιρείες επενδύουν περισσότερα χρήματα στις βάσεις δεδομένων διανυσμάτων για να βελτιώσουν τους αλγόριθμούς τους και να τα κάνουν πιο γρήγορους. Αυτό φαίνεται με τις πρόσφατες επενδύσεις σε νεοεισερχόμενους στη βάση δεδομένων διανυσμάτων όπως η Pinecone, η Chroma DB και η Weviate.

Μεγάλες εταιρείες όπως η Microsoft (MSFT ) έχουν επίσης τα δικά τους εργαλεία. Για παράδειγμα, η Azure Cognitive Search επιτρέπει στις επιχειρήσεις να δημιουργούν εργαλεία τεχνητής νοημοσύνης χρησιμοποιώντας βάσεις δεδομένων διανυσμάτων.
Oracle (ORCL ) επίσης ανακοίνωσε πρόσφατα νέες λειτουργίες για τη Database 23c, εισαγωγή μιας Ολοκληρωμένης Βάσης Δεδομένων Διανυσμάτων. Ονομάζεται “AI Vector Search”, θα έχει έναν νέο τύπο δεδομένων, ευρετήρια και εργαλεία αναζήτησης για να αποθηκεύσει και να αναζητήσει δεδομένα όπως έγγραφα και εικόνες χρησιμοποιώντας διανύσματα. Υποστηρίζει Retrieval Augmented Generation (RAG), που συνδυάζει μεγάλα γλωσσικά μοντέλα με επιχειρηματικά δεδομένα για καλύτερες απαντήσεις σε ερωτήσεις γλώσσας χωρίς να μοιράζονται ιδιωτικά δεδομένα.
Κύριες Σκέψεις για τις Βάσεις Δεδομένων Διανυσμάτων
Μέτρα Απόστασης
Η αποτελεσματικότητα μιας αναζήτησης ομοιότητας εξαρτάται από το επιλεγμένο μέτρο απόστασης. Κοινά μέτρα περιλαμβάνουν Ευκλείδεια απόσταση και ομοιότητα συνημιτόνου, κάθε ένα από τα οποία αντιμετωπίζει διαφορετικά είδη κατανομών διανυσμάτων.
Ευρετηρίαση
Λόγω της υψηλής διάστασης των διανυσμάτων, οι παραδοσιακές μέθοδοι ευρετηρίασης δεν είναι αποτελεσματικές. Οι βάσεις δεδομένων διανυσμάτων χρησιμοποιούν τεχνικές όπως Hierarchical Navigable Small World (HNSW) γράφους ή Δέντρα Annoy, επιτρέποντας την αποτελεσματική διαίρεση του χώρου διανυσμάτων και γρήγορες αναζητήσεις πλησιέστερου γείτονα.

Δέντρο Annoy (Πηγή)
Το Annoy είναι μια μέθοδος που χρησιμοποιεί δέντρα δυαδικής αναζήτησης. Διαχωρίζει τον χώρο δεδομένων μας πολλές φορές και εξετάζει μόνο ένα μέρος του για να βρει κοντινούς γείτονες.
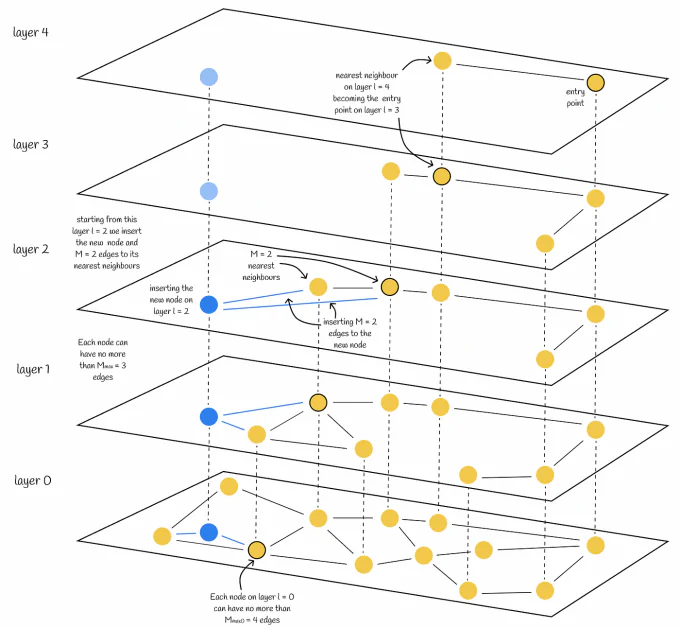
Γράφοι Hierarchical Navigable Small World (HNSW) (Πηγή)
Οι γράφοι HNSW, από την άλλη πλευρά, είναι σαν δίκτυα. Συνδέουν τα δεδομένα σε ιδιαίτερο τρόπο για να κάνουν την αναζήτηση πιο γρήγορη. Αυτοί οι γράφοι βοηθούν στην ταχεία εύρεση κοντινών σημείων στα δεδομένα.
Κλιμακωσιμότητα
Όσο οι συλλογές δεδομένων αυξάνονται, τόσο και η πρόκληση της διατήρησης γρήγορων χρόνων ανάκτησης. Κατανεμημένα συστήματα, επιτάχυνση GPU και βελτιστοποιημένη διαχείριση μνήμης είναι μερικοί τρόποι με τους οποίους οι βάσεις δεδομένων διανυσμάτων αντιμετωπίζουν την κλιμακωσιμότητα.
Ρόλος των Βάσεων Δεδομένων Διανυσμάτων: Επιπτώσεις και ευκαιρίες
1. Δεδομένα Εκπαίδευσης για Προηγμένα Μοντέλα Παραγωγικής τεχνητής νοημοσύνης: Τα μοντέλα παραγωγικής τεχνητής νοημοσύνης, όπως το DALL-E και το GPT-3, εκπαιδεύονται χρησιμοποιώντας τεράστιες ποσότητες δεδομένων. Αυτά τα δεδομένα συχνά αποτελούνται από διανύσματα που εξάγονται από διάφορες πηγές, συμπεριλαμβανομένων εικόνων, κειμένων, κώδικα και άλλων τομέων. Οι βάσεις δεδομένων διανυσμάτων φροντίζουν να διαχειριστούν και να αναλύσουν αυτά τα σύνολα δεδομένων, επιτρέποντας στα μοντέλα να αναπτύξουν και να αναλύσουν τις γνώσεις του κόσμου αναγνωρίζοντας μοτίβα και σχέσεις μέσα σε αυτά τα διανύσματα.
2. Προώθηση της Μάθησης με Λίγα Παραδείγματα: Η μάθηση με λίγα παραδείγματα είναι μια τεχνική εκπαίδευσης όπου τα μοντέλα εκπαιδεύονται με περιορισμένα δεδομένα. Οι βάσεις δεδομένων διανυσμάτων ενισχύουν αυτήν την προσέγγιση διατηρώντας έναν αξιόπιστο ευρετήριο διανυσμάτων. Όταν ένα μοντέλο εκτεθεί σε μόνο λίγα διανύσματα – π.χ. μερικές εικόνες πουλιών – μπορεί να εξαγάγει γρήγορα την ευρύτερη έννοια των πουλιών αναγνωρίζοντας ομοιότητες και σχέσεις μεταξύ αυτών των διανυσμάτων.
3. Βελτίωση Συστημάτων Συνιστώσεων: Τα συστήματα συνιστώσεων χρησιμοποιούν βάσεις δεδομένων διανυσμάτων για να προτείνουν περιεχόμενο που είναι στενά συνδεδεμένο με τις προτιμήσεις του χρήστη. Αναλύοντας τη συμπεριφορά, το προφίλ και τις ερωτήσεις του χρήστη, εξάγονται διανύσματα που υποδεικνύουν τα ενδιαφέροντά του. Το σύστημα αναζητά στη βάση δεδομένων διανυσμάτων για να βρει διανύσματα περιεχομένου που μοιάζουν πολύ με αυτά τα διανύσματα ενδιαφέροντος, εξασφαλίζοντας ακριβείς προτάσεις.
4. Σημασιολογική Ανάκτηση Πληροφοριών: Οι παραδοσιακές μέθοδοι αναζήτησης βασίζονται σε ακριβείς αντιστοιχίες λέξεων-κλειδιών. Ωστόσο, οι βάσεις δεδομένων διανυσμάτων επιτρέπουν στα συστήματα να κατανοούν και να ανακτούν περιεχόμενο με βάση τη σημασιολογική ομοιότητα. Αυτό σημαίνει ότι οι αναζητήσεις γίνονται πιο διαισθητικές, εστιάζοντας στην υποκείμενη σημασία της ερώτησης αντί να περιορίζονται στην αντιστοίχιση λέξεων. Για παράδειγμα, το διάνυσμα ενός ερωτήματος συγκρίνεται με τα διανύσματα της βάσης, ώστε να βρεθεί περιεχόμενο που αντιστοιχεί στην πρόθεση του χρήστη και όχι μόνο στη διατύπωσή του.
5. Πολυμεσική Αναζήτηση: Η πολυμεσική αναζήτηση είναι μια αναδυόμενη τεχνική που ενσωματώνει δεδομένα από πολλές πηγές, όπως κείμενο, εικόνες, ήχο και βίντεο. Οι βάσεις δεδομένων διανυσμάτων χρησιμεύουν ως η ραχοκοκαλιά αυτής της προσέγγισης, επιτρέποντας την ολοκληρωμένη ανάλυση διανυσμάτων από διαφορετικές μορφές δεδομένων. Αυτό οδηγεί σε μια ολιστική εμπειρία αναζήτησης, όπου οι χρήστες μπορούν να ανακτήσουν πληροφορίες από ποικίλες πηγές με βάση μια μόνο ερώτηση, οδηγώντας σε πλουσιότερες γνώσεις και πιο ολοκληρωμένα αποτελέσματα.
Συμπέρασμα
Ο κόσμος της τεχνητής νοημοσύνης αλλάζει γρήγορα. Επηρεάζει πολλές βιομηχανίες, φέρνοντας καινούργια πράγματα και νέες προκλήσεις. Οι ταχείες πρόοδοι στη παραγωγική τεχνητή νοημοσύνη υπογραμμίζουν τον κρίσιμο ρόλο των βάσεων δεδομένων διανυσμάτων στη διαχείριση και ανάλυση πολυδιάστατων δεδομένων.
Αυτά τα εξειδικευμένα συστήματα αποθήκευσης, ικανά να χειρίζονται διανύσματα υψηλής διάστασης από διάφορες μορφές δεδομένων, όπως εικόνες, κείμενο ή ήχο, είναι κρίσιμα για τη λειτουργία των σύγχρονων εφαρμογών της τεχνητής νοημοσύνης, ιδιαίτερα στις αναζητήσεις ομοιότητας.


