
Prompt engineering
ChatGPT & Προηγμένη Μηχανική Προτροπών: Οδηγώντας την Εξέλιξη της AI

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google

Βασικά σημείαΠροηγμένες τεχνικές μηχανικής προτροπών, όπως το ReAct και η αλυσίδα σκέψης, είναι…
Δείτε περισσότερα
- Προηγμένες τεχνικές μηχανικής προτροπών, όπως το ReAct και η αλυσίδα σκέψης, είναι καθοριστικής σημασίας για τη μείωση των παραισθήσεων της τεχνητής νοημοσύνης και τη βελτίωση της λογικής.
- Καλά καθορισμένες προτροπές είναι απαραίτητες για τον έλεγχο της ποιότητας της εξόδου του ChatGPT και τη διασφάλιση σχετικών και φιλικών προς τον χρήστη αποκρίσεων.
- Η μάθηση με λίγα παραδείγματα επιτρέπει σε μοντέλα όπως το GPT-3 να προσαρμόζονται σε νέες εργασίες χωρίς δαπανηρή εξειδίκευση ή προσαρμοσμένα σύνολα δεδομένων.
Η OpenAI έχει παίξει καθοριστικό ρόλο στην ανάπτυξη επαναστατικών εργαλείων όπως το OpenAI Gym, που σχεδιάστηκε για την εκπαίδευση αλγορίθμων ενισχυτικής μάθησης, και τα μοντέλα GPT-n. Στο επίκεντρο βρίσκεται επίσης το DALL-E, ένα μοντέλο AI που δημιουργεί εικόνες από εισόδους κειμένου. Ένα τέτοιο μοντέλο που έχει προσελκύσει σημαντική προσοχή είναι το ChatGPT της OpenAI, ένα λαμπρό παράδειγμα στον κόσμο των Μεγάλων Μοντέλων Γλώσσας.
GPT-4: Μηχανική Προτροπών
Το ChatGPT έχει μεταμορφώσει το τοπίο των chatbot, προσφέροντας απαντήσεις παρόμοιες με τις ανθρώπινες σε εισόδους χρήστη και επεκτείνοντας τις εφαρμογές του σε διάφορους τομείς – από την ανάπτυξη λογισμικού και τον έλεγχο μέχρι την επιχειρηματική επικοινωνία και ακόμη και τη δημιουργία ποίησης.
Στα χέρια επιχειρήσεων και ατόμων, το GPT-4, για παράδειγμα, θα μπορούσε να χρησιμεύσει ως ανεξάντλητη δεξαμενή γνώσεων, ικανός σε θέματα που κυμαίνονται από τα Μαθηματικά και τη Βιολογία μέχρι τις Νομικές Σπουδές. Τέτοια εξελιγμένα και προσιτά μοντέλα AI είναι έτοιμα να επαναπροσδιορίσουν το μέλλον της εργασίας, της μάθησης και της δημιουργικότητας.

Παραγωγικά μοντέλα όπως το GPT-4 μπορούν να παράγουν νέα δεδομένα με βάση τις υφιστάμενες εισόδους. Αυτό το διακριτό χαρακτηριστικό τους επιτρέπει να αναλάβουν διάφορες εργασίες, συμπεριλαμβανομένης της παραγωγής κειμένου, εικόνων, μουσικής και βίντεο.
Στο πλαίσιο του ChatGPT και των μοντέλων της OpenAI, μια προτροπή είναι η είσοδος που παρέχουν οι χρήστες στα μοντέλα, συνήθως υπό μορφή κειμένου. Οι προτροπές χρησιμεύουν ως ο πρωταρχικός μηχανισμός ελέγχου της εξόδου που παράγουν αυτά τα μοντέλα, καθιστώντας τις κρίσιμες για επιτυχημένες και σχετικές συζητήσεις.
Η Επίδραση της Ποιότητας της Προτροπής
Η χρήση καλά ορισμένων προτροπών είναι το κλειδί για την εμπλοκή σε χρήσιμες και σημαντικές συζητήσεις με συστήματα AI. Οι κακοορισμένες προτροπές μπορούν να οδηγήσουν σε έξοδο που δεν είναι χρήσιμη για τον χρήστη και μπορεί ακόμη να οδηγήσει σε παραπλανητικό περιεχόμενο.
Για να δείξουμε την επίδραση της ποιότητας της διατύπωσης προτροπών, ας συγκριθούν δύο διαφορετικές προτροπές που δόθηκαν στο ChatGPT. Η πρώτη προτροπή, που είναι κακοορισμένη και υποθέτει προηγούμενη γνώση, παράγει μια πιθανώς μη χρήσιμη απάντηση για τον χρήστη. Από την άλλη πλευρά, η δεύτερη προτροπή παρέχει περισσότερα συμφραζόμενα και παραδείγματα, εξασφαλίζοντας μια πιο σχετική και κατανοητή απάντηση.
Προτροπή 1: “Πες μου για τα Συνελικτικά Νευρωνικά Δίκτυα.”
Απάντηση 1: “Τα Συνελικτικά Νευρωνικά Δίκτυα (CNNs) είναι δίκτυα πολλαπλών στρωμάτων που αποτελούνται από πλήρως συνδεδεμένα στρώματα και επίπεδα συγκέντρωσης. Χρησιμοποιούνται συνήθως σε εργασίες αναγνώρισης εικόνων. Η διαδικασία περιλαμβάνει την εφαρμογή φίλτρων στις εισόδους εικόνων και τη μείωση της ανάλυσής τους χρησιμοποιώντας επίπεδα συγκέντρωσης.”
Προτροπή 2: “Θέλω να μάθω για τα Συνελικτικά Νευρωνικά Δίκτυα, αλλά δεν έχω προηγούμενη γνώση για τα Τεχνητά Νευρωνικά Δίκτυα. Μπορείτε να μου παρέχετε μια εξήγηση κατάλληλη για αρχαρίους και ένα παράδειγμα για το πώς τα CNNs χρησιμοποιούνται στην αναγνώριση εικόνων;”
Απάντηση 2: “Τα Συνελικτικά Νευρωνικά Δίκτυα (CNNs) είναι ένα είδος νευρωνικού δικτύου που χρησιμοποιείται κυρίως για εργασίες αναγνώρισης εικόνων. Σε αντίθεση με άλλα νευρωνικά δίκτυα, αυτά αξιοποιούν συνελικτικά επίπεδα και επίπεδα συγκέντρωσης για την επεξεργασία εικόνων. Φανταστείτε ότι έχετε μια εικόνα μιας γάτας. Τα CNNs μπορούν να αναγνωρίσουν διαφορετικά χαρακτηριστικά στην εικόνα, όπως τα μουστάκια, τα αυτιά και την ουρά, εφαρμόζοντας φίλτρα και μειώνοντας την ανάλυση της εικόνας χρησιμοποιώντας επίπεδα συγκέντρωσης. Αυτή η διαδικασία καθιστά τα CNNs εξαιρετικά αποτελεσματικά για την αναγνώριση αντικειμένων σε εικόνες.”
Συγκρίνοντας τις δύο απαντήσεις, είναι σαφές ότι μια καλά ορισμένη προτροπή οδηγεί σε μια πιο σχετική και χρήσιμη απάντηση. Η σχεδίαση και η μηχανική προτροπών είναι αναπτυσσόμενες επιστήμες που στοχεύουν στη βελτίωση της ποιότητας της εξόδου των μοντέλων AI όπως το ChatGPT.
Στις επόμενες ενότητες αυτού του άρθρου, θα εμβαθύνουμε στον κόσμο των προηγμένων μεθοδολογιών που στοχεύουν στη βελτίωση των Μεγάλων Μοντέλων Γλώσσας (LLMs), όπως τεχνικές μηχανικής προτροπών και τακτικές. Αυτές περιλαμβάνουν τη μάθηση με λίγα παραδείγματα, ReAct, αλυσίδα σκέψης, RAG, και πολλά άλλα.
Προηγμένες Τεχνικές Μηχανικής
Πριν προχωρήσουμε, είναι σημαντικό να κατανοήσουμε έναν κρίσιμο περιορισμό των LLMs, που ονομάζεται “hallucination”. Στο πλαίσιο των LLMs, η “hallucination” σημαίνει την τάση αυτών των μοντέλων να παράγουν εξόδους που μπορεί να φαίνονται λογικές αλλά δεν βασίζονται σε πραγματικά γεγονότα ή στα δοσμένα συμφραζόμενα.
Αυτό το πρόβλημα ήταν εμφανές σε μια πρόσφατη δικαστική υπόθεση όπου ένας δικηγόρος άμυνας χρησιμοποίησε το ChatGPT για νομική έρευνα. Το εργαλείο AI, που απέτυχε λόγω του προβλήματος hallucination, ανέφερε ανύπαρκτες δικαστικές υποθέσεις. Αυτό το λάθος είχε σημαντικές επιπτώσεις, προκαλώντας σύγχυση και υπονομεύοντας την αξιοπιστία κατά τη διάρκεια της διαδικασίας. Αυτό το περιστατικό λειτουργεί ως μια σοβαρή υπενθύμιση της επείγουσας ανάγκης να αντιμετωπίσουμε το πρόβλημα της “hallucination” στα συστήματα AI.
Η εξερεύνησή μας στις τεχνικές μηχανικής προτροπών στοχεύει να βελτιώσει αυτές τις πτυχές των LLMs. Βελτιώνοντας την αποτελεσματικότητά τους και την ασφάλεια, ανοίγουμε το δρόμο για καινοτόμες εφαρμογές όπως η εξαγωγή πληροφοριών. Επιπλέον, ανοίγουμε τις πόρτες για την ομαλή ενσωμάτωση των LLMs με εξωτερικά εργαλεία και πηγές δεδομένων, διευρύνοντας το φάσμα των πιθανών εφαρμογών τους.
Μάθηση με Μηδέν και Λίγα Παραδείγματα: Βελτιστοποίηση με Παραδείγματα
Οι Παραγωγικοί Προεκπαιδευμένοι Μετασχηματιστές (GPT-3) σημάδεψαν έναν σημαντικό σταθμό στην ανάπτυξη των Παραγωγικών Μοντέλων AI, εισάγοντας την έννοια της “μάθησης με λίγα παραδείγματα”. Αυτή η μέθοδος ήταν καθοριστική αλλαγή λόγω της ικανότητάς της να λειτουργεί αποτελεσματικά χωρίς την ανάγκη για εκτεταμένη περαιτέρω προσαρμογή. Το πλαίσιο GPT-3 συζητείται στο έγγραφο “Language Models are Few Shot Learners“, όπου οι συγγραφείς δείχνουν πώς το μοντέλο διαπρέπει σε διάφορες εφαρμογές χωρίς να απαιτούνται προσαρμοσμένα σύνολα δεδομένων ή κώδικας.
Σε αντίθεση με την περαιτέρω προσαρμογή, η οποία απαιτεί συνεχείς προσπάθειες για την επίλυση διαφορετικών περιπτώσεων, τα μοντέλα με λίγα παραδείγματα δείχνουν μεγαλύτερη ευελιξία σε ένα ευρύ φάσμα εφαρμογών. Ενώ η περαιτέρω προσαρμογή μπορεί να παρέχει ισχυρές λύσεις σε ορισμένες περιπτώσεις, μπορεί να είναι δαπανηρή σε κλίμακα, καθιστώντας τη χρήση μοντέλων με λίγα παραδείγματα μια πιο πρακτική προσέγγιση, ιδιαίτερα όταν συνδυάζεται με τη μηχανική προτροπών.
Φανταστείτε ότι προσπαθείτε να μεταφράσετε Αγγλικά σε Γαλλικά. Στη μάθηση με λίγα παραδείγματα, θα παρέχετε στο GPT-3 λίγα παραδείγματα μετάφρασης όπως “sea otter -> loutre de mer”. Το GPT-3, ως ένα προηγμένο μοντέλο, είναι τότε σε θέση να συνεχίσει να παρέχει ακριβείς μεταφράσεις. Στη μάθηση με μηδέν παραδείγματα, δεν θα παρέχετε κανένα παράδειγμα, και το GPT-3 θα ήταν ακόμη σε θέση να μεταφράσει Αγγλικά σε Γαλλικά αποτελεσματικά.
Ο όρος “μάθηση με λίγα παραδείγματα” προέρχεται από την ιδέα ότι το μοντέλο λαμβάνει έναν περιορισμένο αριθμό παραδειγμάτων για να “μάθει” από αυτά. Είναι σημαντικό να σημειωθεί ότι “μάθηση” σε αυτά τα συμφραζόμενα δεν περιλαμβάνει την ενημέρωση των παραμέτρων ή των βαρών του μοντέλου, αλλά επηρεάζει την απόδοσή του.

Μάθηση με Λίγα Παραδείγματα όπως Παρουσιάζεται στο Έγγραφο GPT-3
Η μάθηση με μηδέν παραδείγματα μεταφέρει αυτήν την έννοια ένα βήμα παραπέρα. Στη μάθηση με μηδέν παραδείγματα, δεν παρέχονται παραδείγματα ολοκλήρωσης της εργασίας στο μοντέλο. Το μοντέλο αναμένεται να εκτελέσει καλά με βάση την αρχική του εκπαίδευση, καθιστώντας αυτήν τη μεθοδολογία ιδανική για σενάρια ερωτήσεων ανοιχτού τομέα όπως το ChatGPT.
Σε πολλές περιπτώσεις, ένα μοντέλο ικανό στη μάθηση με μηδέν παραδείγματα μπορεί να εκτελέσει καλά όταν παρέχονται λίγα ή ακόμη και ένα μόνο παράδειγμα. Αυτή η ικανότητα να μεταβαίνει μεταξύ μηδέν, ενός και λίγων παραδειγμάτων υπογραμμίζει την προσαρμοστικότητα των μεγάλων μοντέλων, ενισχύοντας τις πιθανές εφαρμογές τους σε διάφορους τομείς.
Οι μέθοδοι μάθησης με μηδέν παραδείγματα γίνονται ολοένα και πιο δημοφιλείς. Αυτές οι μέθοδοι χαρακτηρίζονται από την ικανότητά τους να αναγνωρίσουν αντικείμενα που δεν είδαν κατά την εκπαίδευση. Εδώ είναι ένα πρακτικό παράδειγμα μιας Προτροπής με Λίγα Παραδείγματα:
Μεταφράστε τις ακόλουθες Αγγλικές φράσεις σε Γαλλικά:
'sea otter' μεταφράζεται σε 'loutre de mer'
'sky' μεταφράζεται σε 'ciel'
Τι μεταφράζεται 'cloud' στα Γαλλικά;"
Παρέχοντας στο μοντέλο λίγα παραδείγματα και στη συνέχεια θέτοντας μια ερώτηση, μπορούμε να οδηγήσουμε αποτελεσματικά το μοντέλο να παράγει την επιθυμητή έξοδο. Σε αυτήν την περίπτωση, το GPT-3 θα μεταφράσει σωστά ‘cloud’ σε ‘nuage’ στα Γαλλικά.
Θα εμβαθύνουμε περισσότερο στις διάφορες λεπτές αποχρώσεις της μηχανικής προτροπών και τον κρίσιμο ρόλο της στη βελτίωση της απόδοσης του μοντέλου κατά τον συμπερασμό. Θα εξετάσουμε επίσης πώς μπορεί να χρησιμοποιηθεί αποτελεσματικά για τη δημιουργία οικονομικά αποδοτικών και κλιμακωτών λύσεων σε ένα ευρύ φάσμα εφαρμογών.
Καθώς εξερευνούμε την πολυπλοκότητα της μηχανικής προτροπών στα μοντέλα GPT, είναι σημαντικό να τονίσουμε την προηγούμενή μας ανάρτηση ‘Ο Οδηγός για τη Μηχανική Προτροπών στο ChatGPT‘. Αυτός ο οδηγός παρέχει γνώσεις στις στρατηγικές για την αποτελεσματική καθοδήγηση των μοντέλων AI αποτελεσματικά σε διάφορες εφαρμογές.
Στις προηγούμενες συζητήσεις μας, εξετάσαμε τις βασικές μεθόδους διατύπωσης προτροπών για τα μεγάλα μοντέλα γλώσσας (LLMs) όπως η μάθηση με μηδέν και λίγα παραδείγματα, καθώς και η προτροπή οδηγίας. Η κατοχή αυτών των τεχνικών είναι κρίσιμη για την αντιμετώπιση των πιο σύνθετων προκλήσεων της μηχανικής προτροπών που θα εξετάσουμε εδώ.
Η μάθηση με λίγα παραδείγματα μπορεί να είναι περιορισμένη λόγω του περιορισμένου παραθύρου συμφραζομένων των περισσότερων LLMs. Επιπλέον, χωρίς τις κατάλληλες προφυλάξεις, τα LLMs μπορούν να παραπλανηθούν και να παράγουν ενδεχομένως επιβλαβή έξοδο. Και πολλά μοντέλα δυσκολεύονται με εργασίες συλλογισμού ή την εκτέλεση πολύπλοκων οδηγιών.
Δεδομένων αυτών των περιορισμών, η πρόκληση έγκειται στην αξιοποίηση των LLMs για την αντιμετώπιση σύνθετων εργασιών. Μια φανερή λύση θα ήταν η ανάπτυξη πιο προηγμένων LLMs ή η βελτίωση των υφιστάμενων, αλλά αυτό θα μπορούσε να απαιτήσει σημαντικές προσπάθειες. Έτσι, η ερώτηση που ανακύπτει είναι: πώς μπορούμε να βελτιστοποιήσουμε τα τρέχοντα μοντέλα για βελτιωμένη επίλυση προβλημάτων;
Ιδιαίτερα ενδιαφέρον είναι η εξερεύνηση του πώς αυτή η τεχνική συνδέεται με δημιουργικές εφαρμογές στο “Mastering AI Art: A Concise Guide to Midjourney and Prompt Engineering” της Unite AI, το οποίο περιγράφει πώς η σύντηξη της τέχνης και του AI μπορεί να οδηγήσει σε εκπληκτική τέχνη.
Διατύπωση Προτροπών με Αλυσίδα Σκέψης
Η προτροπή αλυσίδας σκέψης αξιοποιεί τις αυτοπαλινδρομικές ιδιότητες των μεγάλων μοντέλων γλώσσας (LLMs), τα οποία διαπρέπουν στην πρόβλεψη της επόμενης λέξης σε μια δεδομένη ακολουθία. Ζητώντας από το μοντέλο να εξηγήσει τη σκέψη του, προκαλεί μια πληρέστερη και πιο μεθοδική παραγωγή ιδεών, η οποία τείνει να ευθυγραμμιστεί στενά με ακριβείς πληροφορίες. Αυτή η ευθυγράμμιση προέρχεται από την τάση του μοντέλου να επεξεργάζεται και να παρέχει πληροφορίες με έναν σκεπτόμενο και οργανωμένο τρόπο, παρόμοιο με έναν ανθρώπινο εμπειρογνώμονα που οδηγεί έναν ακροατή μέσα από μια σύνθετη έννοια.
Μια απλή δήλωση όπως “εξηγήστε μου βήμα προς βήμα πώς να…” είναι συχνά αρκετή για να ενεργοποιήσει αυτήν την πιο εκτεταμένη και λεπτομερή έξοδο.
Προτροπή Αλυσίδας Σκέψης με Μηδέν Παραδείγματα
Ενώ η συμβατική προτροπή αλυσίδας σκέψης απαιτεί προ-εκπαίδευση με παραδείγματα, μια αναδυόμενη περιοχή είναι η προτροπή αλυσίδας σκέψης με μηδέν παραδείγματα. Αυτή η προσέγγιση, που εισήχθη από τους Kojima et al. (2022), καινοτομεί προσθέτοντας τη φράση “Ας σκεφτούμε βήμα προς βήμα” στην αρχική προτροπή.
Ας δημιουργήσουμε μια προηγμένη προτροπή όπου το ChatGPT αναλαμβάνει να συνοψίσει τα βασικά σημεία από έρευνα AI και NLP.
Σε αυτήν την επίδειξη, θα χρησιμοποιήσουμε την ικανότητα του μοντέλου να κατανοήσει και να συνοψίσει σύνθετες πληροφορίες από ακαδημαϊκά κείμενα. Χρησιμοποιώντας την προσέγγιση της μάθησης με λίγα παραδείγματα, θα διδάξουμε το ChatGPT να συνοψίσει τα βασικά σημεία από έρευνα AI και NLP:
1. Τίτλος Έρευνας: "Η Προσοχή Είναι Το Μόνο Που Χρειάζεστε"
Βασικό Σημείο: Εισήγαγε το μοντέλο μετασχηματιστή, τονίζοντας τη σημασία των μηχανισμών προσοχής έναντι των αναδρομικών στρωμάτων για εργασίες μετατροπής ακολουθιών.
2. Τίτλος Έρευνας: "BERT: Προ-εκπαίδευση Βαθιών Αμφίδρομων Μετασχηματιστών για Κατανόηση Γλώσσας"
Βασικό Σημείο: Εισήγαγε το BERT, δείχνοντας την αποτελεσματικότητα της προ-εκπαίδευσης βαθιών αμφίδρομων μοντέλων, επιτυγχάνοντας κορυφαία αποτελέσματα σε διάφορες εργασίες NLP.
Τώρα, με τα συμφραζόμενα αυτών των παραδειγμάτων, συνοψίστε τα βασικά σημεία από την ακόλουθη έρευνα:
Τίτλος Έρευνας: "Μηχανική Προτροπών σε Μεγάλα Μοντέλα Γλώσσας: Μια Εξέταση"
Αυτή η προτροπή όχι μόνο διατηρεί μια σαφή αλυσίδα σκέψης αλλά και αξιοποιεί την προσέγγιση της μάθησης με λίγα παραδείγματα για να οδηγήσει το μοντέλο. Συνδέεται με τις λέξεις-κλειδιά μας εστιάζοντας στους τομείς AI και NLP, ζητώντας από το ChatGPT να εκτελέσει μια σύνθετη εργασία που σχετίζεται με τη μηχανική προτροπών: τη σύνοψη ερευνών.
Προτροπή ReAct
Η ReAct, ή “Συλλογισμός και Δράση”, εισήχθη από την Google (GOOGL ) στο έγγραφο “ReAct: Synergizing Reasoning and Acting in Language Models“, και επαναπροσδιόρισε τον τρόπο με τον οποίο τα μοντέλα γλώσσας αλληλεπιδρούν με μια εργασία, ζητώντας από το μοντέλο να παράγει δυναμικά τόσο λεκτικά ίχνη συλλογισμού όσο και ενέργειες ειδικές για την εργασία.
Φανταστείτε έναν ανθρώπινο σεφ στην κουζίνα: δεν εκτελεί μόνο μια σειρά ενεργειών (κόβοντας λαχανικά, βάζοντας νερό να βράσει, ανακατεύοντας υλικά) αλλά και ασχολείται με την εσωτερική ομιλία (“τώρα που τα λαχανικά είναι κομμένα, πρέπει να βάλω τη κατσαρόλα στην κουζίνα”). Αυτή η συνεχής εσωτερική ομιλία βοηθά στον στρατηγικό σχεδιασμό της διαδικασίας, την προσαρμογή σε απρόβλεπτες αλλαγές (“μου τελείωσε το ελαιόλαδο, θα χρησιμοποιήσω βούτυρο αντί για αυτό”), και θυμάται τη σειρά των εργασιών. Η ReAct μιμείται αυτήν την ανθρώπινη ικανότητα, επιτρέποντας στο μοντέλο να μαθαίνει γρήγορα νέες εργασίες και να λαμβάνει αξιόπιστες αποφάσεις, όπως θα έκανε ένας άνθρωπος υπό νέες ή αβέβαιες συνθήκες.
Η ReAct μπορεί να αντιμετωπίσει το πρόβλημα της hallucination, ένα κοινό πρόβλημα με τα συστήματα Αλυσίδας Σκέψης (CoT). Η CoT, αν και αποτελεσματική τεχνική, δεν διαθέτει την ικανότητα να αλληλεπιδρά με τον εξωτερικό κόσμο, ο οποίος θα μπορούσε να οδηγήσει σε παραπλανητική πληροφορία και διάδοση σφαλμάτων. Η ReAct, ωστόσο, αντισταθμίζει αυτό το πρόβλημα αλληλεπιδρώντας με εξωτερικές πηγές πληροφοριών. Αυτή η αλληλεπίδραση επιτρέπει στο σύστημα να ελέγχει την συλλογιστική του και να ενημερώνει τις γνώσεις του με βάση τις πιο πρόσφατες πληροφορίες από τον εξωτερικό κόσμο.
Η βασική λειτουργία της ReAct μπορεί να εξηγηθεί μέσω ενός παραδείγματος από το HotpotQA, μια εργασία που απαιτεί συλλογισμό υψηλού επιπέδου. Λαμβάνοντας μια ερώτηση, το μοντέλο ReAct διασπά την ερώτηση σε διαχειρίσιμα μέρη και δημιουργεί ένα σχέδιο δράσης. Το μοντέλο παράγει ένα ίχνος συλλογισμού (σκέψη) και αναγνωρίζει μια σχετική δράση. Μπορεί να αποφασίσει να αναζητήσει πληροφορίες για το Apple (AAPL ) Remote σε μια εξωτερική πηγή, όπως η Βικιπαίδεια (δράση), και να ενημερώσει την κατανόησή του με βάση τις ληφθείσες πληροφορίες (παρατήρηση). Μέσω πολλών βημάτων σκέψης-δράσης-παρατήρησης, η ReAct μπορεί να ανακτήσει πληροφορίες για να υποστηρίξει την συλλογιστική της και να βελτιστοποιήσει ποιες πληροφορίες πρέπει να ανακτήσει στη συνέχεια.
Σημείωση:
HotpotQA είναι ένα σύνολο δεδομένων, που προέρχεται από τη Βικιπαίδεια, αποτελούμενο από 113k ζευγάρια ερωτήσεων-απαντήσεων που σχεδιάστηκαν για την εκπαίδευση συστημάτων AI σε σύνθετο συλλογισμό, καθώς οι ερωτήσεις απαιτούν συλλογισμό πάνω σε πολλά έγγραφα για να απαντηθούν. Από την άλλη πλευρά, CommonsenseQA 2.0, που κατασκευάστηκε μέσω gamification, περιλαμβάνει 14,343 ερωτήσεις ναι/όχι και σχεδιάστηκε για να προκαλέσει την κατανόηση του AI για την κοινή λογική, καθώς οι ερωτήσεις είναι σκόπιμα κατασκευασμένες για να παραπλανήσουν τα μοντέλα AI.
Η διαδικασία θα μπορούσε να φαίνεται κάπως έτσι:
- Σκέψη: “Χρειάζομαι να αναζητήσω το Apple Remote και τις συμβατές συσκευές.”
- Δράση: Αναζητά “Συσκευές συμβατές με το Apple Remote” σε μια εξωτερική πηγή.
- Παρατήρηση: Λαμβάνει μια λίστα συσκευών που είναι συμβατές με το Apple Remote από τα αποτελέσματα αναζήτησης.
- Σκέψη: “Βάσει των αποτελεσμάτων αναζήτησης, πολλές συσκευές, εκτός από το Apple Remote, μπορούν να ελέγχουν το πρόγραμμα που αρχικά σχεδιάστηκε να αλληλεπιδράσει.”
Το αποτέλεσμα είναι μια δυναμική διαδικασία βασισμένη σε συλλογισμό που μπορεί να εξελιχθεί με βάση τις πληροφορίες με τις οποίες αλληλεπιδρά, οδηγώντας σε πιο ακριβείς και αξιόπιστες απαντήσεις.

Συγκριτική οπτικοποίηση τεσσάρων μεθόδων διατύπωσης προτροπών – Standard, Chain-of-Thought, Act-Only, και ReAct, στην επίλυση HotpotQA και AlfWorld (https://arxiv.org/pdf/2210.03629.pdf)
Η σχεδίαση των πρακτόρων ReAct είναι ένας εξειδικευμένος ρόλος, δεδομένης της ικανότητάς τους να επιτύχουν σύνθετους στόχους. Για παράδειγμα, ένας πράκτορας συνομιλίας, που βασίζεται στο βασικό μοντέλο ReAct, ενσωματώνει μνήμη συνομιλίας για να παρέχει πλουσιότερες αλληλεπιδράσεις. Ωστόσο, η πολυπλοκότητα αυτής της εργασίας απλοποιείται από εργαλεία όπως το Langchain, το οποίο έχει γίνει το πρότυπο για τη σχεδίαση αυτών των πρακτόρων.
Διατύπωση Προτροπών με Πιστότητα στα Συμφραζόμενα
Το έγγραφο ‘Διατύπωση Προτροπών με Πιστότητα στα Συμφραζόμενα για Μεγάλα Μοντέλα Γλώσσας‘ υπογραμμίζει ότι ενώ τα LLMs έχουν δείξει σημαντική επιτυχία σε εργασίες NLP που βασίζονται στη γνώση, η υπερβολική εξάρτησή τους από παραμετρική γνώση μπορεί να τα οδηγήσει σε λάθος όταν αντιμετωπίζουν εργασίες που εξαρτώνται από τα συμφραζόμενα. Για παράδειγμα, όταν ένα γλωσσικό μοντέλο έχει εκπαιδευτεί με παρωχημένα δεδομένα, μπορεί να δώσει λανθασμένες απαντήσεις αν αγνοήσει τις ενδείξεις των συμφραζομένων. Το πρόβλημα εμφανίζεται σε περιπτώσεις σύγκρουσης γνώσης, όταν τα συμφραζόμενα περιέχουν γεγονότα που διαφέρουν από την προϋπάρχουσα γνώση του LLM. Ας εξετάσουμε ένα μοντέλο που έχει εκπαιδευτεί με δεδομένα πριν από το Παγκόσμιο Κύπελλο του 2022, και του δίνεται ένα πλαίσιο που υποδηλώνει ότι η Γαλλία κέρδισε το τουρνουά, το LLM, βασισμένο στην προεκπαίδευσή του, μπορεί να συνεχίσει να ισχυρίζεται ότι ο προηγούμενος νικητής, δηλαδή η ομάδα που κέρδισε το Παγκόσμιο Κύπελλο του 2018, είναι ακόμη ο κάτοχος του τίτλου. Αυτό δείχνει μια κλασική περίπτωση “συγκρούσεων γνώσης”.
Ουσιαστικά, η σύγκρουση γνώσης σε ένα LLM ανακύπτει όταν νέα πληροφορία που παρέχεται στα συμφραζόμενα αντιφάσκει με την προ-εκπαίδευσή του. Η τάση του μοντέλου να βασίζεται περισσότερο στην προηγούμενη εκπαίδευσή του παρά στα νέα συμφραζόμενα μπορεί να οδηγήσει σε λανθασμένες εξόδους. Από την άλλη πλευρά, η hallucination στα LLMs είναι η παραγωγή απαντήσεων που μπορεί να φαίνονται πιθανές αλλά δεν βασίζονται στα δεδομένα εκπαίδευσης του μοντέλου ή στα παρεχόμενα συμφραζόμενα.
Ένα άλλο πρόβλημα ανακύπτει όταν τα παρεχόμενα συμφραζόμενα δεν περιέχουν αρκετές πληροφορίες για να απαντήσει σωστά σε μια ερώτηση, μια κατάσταση που ονομάζεται “πρόβλεψη με δυνατότητα αποχής”. Για παράδειγμα, αν ένα LLM ζητηθεί να απαντήσει για το ιδρυτή της Microsoft (MSFT ) με βάση ένα πλαίσιο που δεν παρέχει αυτήν την πληροφορία, θα πρέπει ιδανικά να απέχει από την κίνηση να μαντέψει.
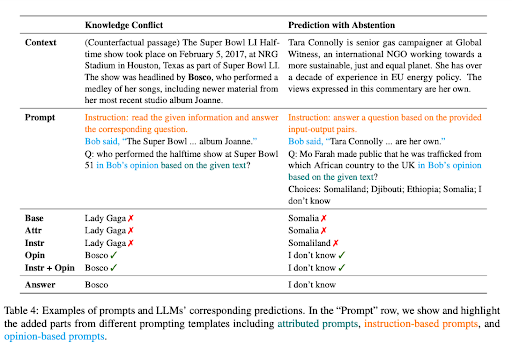
Περισσότερα Παραδείγματα Συγκρούσεων Γνώσης και της Δύναμης της Αποχής
Για να βελτιώσουμε την πιστότητα στα συμφραζόμενα των LLMs σε αυτές τις περιπτώσεις, οι ερευνητές πρότειναν μια σειρά στρατηγικών διατύπωσης προτροπών. Αυτές οι στρατηγικές στοχεύουν να κάνουν τις απαντήσεις των LLMs πιο ευαίσθητες στα συμφραζόμενα παρά να βασίζονται στην κωδικοποιημένη γνώση.
Μια τέτοια στρατηγική είναι να διατυπώσουμε τις προτροπές ως ερωτήσεις που βασίζονται σε γνώμη, όπου τα συμφραζόμενα ερμηνεύονται ως δήλωση αφηγητή, και η ερώτηση σχετίζεται με τη γνώμη αυτού του αφηγητή. Αυτή η προσέγγιση επανακατευθύνει την προσοχή του LLM στα παρεχόμενα συμφραζόμενα παρά να βασίζεται στην προ-εκπαίδευσή του.
Η προσθήκη αντιφατικών παραδειγμάτων στις προτροπές έχει επίσης αναγνωριστεί ως ένας αποτελεσματικός τρόπος για να αυξήσει την πιστότητα σε περιπτώσεις συγκρούσεων γνώσης. Αυτά τα παραδείγματα παρέχουν σενάρια με ψευδή γεγονότα, τα οποία οδηγούν το μοντέλο να προσέξει περισσότερο στα συμφραζόμενα για να παρέχει ακριβείς απαντήσεις.
Περαιτέρω Προσαρμογή με Οδηγίες
Η περαιτέρω προσαρμογή με οδηγίες είναι μια φάση επιβλεπόμενης εκπαίδευσης κατά την οποία παρέχονται στο μοντέλο συγκεκριμένες οδηγίες, για παράδειγμα, “Εξηγήστε τη διαφορά μεταξύ ανατολής και δύσης”. Η οδηγία συνοδεύεται από μια κατάλληλη απάντηση, κάτι σαν “Μια ανατολή αναφέρεται στη στιγμή που ο ήλιος εμφανίζεται πάνω από τον ορίζοντα το πρωί, ενώ η δύση σηματοδοτεί το σημείο που ο ήλιος εξαφανίζεται κάτω από τον ορίζοντα το βράδυ”. Μέσω αυτής της μεθόδου, το μοντέλο μαθαίνει πώς να ακολουθήσει και να εκτελέσει οδηγίες.
Αυτή η προσέγγιση επηρεάζει σημαντικά τη διαδικασία διατύπωσης προτροπών των LLMs, οδηγώντας σε μια ριζική αλλαγή στον τρόπο διατύπωσης προτροπών. Ένα LLM που έχει προσαρμοστεί περαιτέρω με οδηγίες επιτρέπει την άμεση εκτέλεση εργασιών χωρίς παραδείγματα (zero-shot), παρέχοντας ομαλή εκτέλεση εργασιών. Αν το LLM δεν έχει ακόμη προσαρμοστεί περαιτέρω, μπορεί να απαιτείται μια προσέγγιση μάθησης με λίγα παραδείγματα, ενσωματώνοντας κάποια παραδείγματα στην προτροπή σας για να οδηγήσετε το μοντέλο στην επιθυμητή απάντηση.
“Περαιτέρω Προσαρμογή με GPT-4′ συζητά την προσπάθεια να χρησιμοποιηθεί το GPT-4 για την παραγωγή δεδομένων για την περαιτέρω προσαρμογή LLMs. Χρησιμοποίησαν ένα πλούσιο σύνολο δεδομένων, που αποτελείται από 52,000 μοναδικές εγγραφές εκτέλεσης οδηγιών τόσο στα Αγγλικά όσο και στα Κινέζικα.
Το σύνολο δεδομένων παίζει έναν κρίσιμο ρόλο στην περαιτέρω προσαρμογή μοντέλων LLaMA, μια σειρά LLMs ανοικτού κώδικα, οδηγώντας σε βελτιωμένη απόδοση χωρίς παραδείγματα σε νέες εργασίες. Σημαντικά προγράμματα όπως Stanford Alpaca έχουν αποτελεσματικά χρησιμοποιήσει την αυτο-οδηγία, μια αποτελεσματική μέθοδο για την ευθυγράμμιση των LLMs με την ανθρώπινη πρόθεση, αξιοποιώντας δεδομένα που παράγονται από προηγμένα μοντέλα-δασκάλους προσαρμοσμένα με οδηγίες.

Ο πρωταρχικός στόχος της έρευνας για την περαιτέρω προσαρμογή με οδηγίες είναι να ενισχύσει τις ικανότητες γενίκευσης με μηδέν και λίγα παραδείγματα των LLMs. Η συλλογή περισσότερων δεδομένων και η κλιμάκωση των μοντέλων μπορεί να παρέχει πολύτιμες γνώσεις. Με το τρέχον μέγεθος δεδομένων του GPT-4 στα 52K και το βασικό μέγεθος μοντέλου LLaMA στα 7 δισεκατομμύρια παραμέτρους, υπάρχει τεράστιο δυναμικό για συλλογή περισσότερων δεδομένων GPT-4 και συνδυασμό τους με άλλες πηγές δεδομένων, οδηγώντας στην εκπαίδευση μεγαλύτερων μοντέλων LLaMA για ανώτερη απόδοση.
STaR: Επαναληπτική Βελτίωση Συλλογισμού με Συλλογισμό
Το δυναμικό των LLMs είναι ιδιαίτερα ορατό σε σύνθετες εργασίες συλλογισμού όπως τα μαθηματικά ή η κοινή λογική. Ωστόσο, η διαδικασία της παρότρυνσης ενός γλωσσικού μοντέλου να παράγει αιτιολογήσεις—μια σειρά αιτιολογήσεων βήμα προς βήμα ή «αλυσίδα σκέψης»— έχει τις δικές της προκλήσεις. Συχνά απαιτεί την κατασκευή μεγάλων συνόλων δεδομένων αιτιολογήσεις ή μια θυσία στην ακρίβεια λόγω της εξάρτησης από μόνο λίγα παραδείγματα.
“Ο Αυτοδίδακτος Συλλογιστής” (STaR) προσφέρει μια καινοτόμο λύση σε αυτές τις προκλήσεις. Χρησιμοποιεί έναν απλό βρόχο για τη συνεχή βελτίωση της συλλογιστικής ικανότητας του μοντέλου. Αυτή η επαναλαμβανόμενη διαδικασία αρχίζει με την παραγωγή αιτιολογήσεων για να απαντήσει σε πολλές ερωτήσεις χρησιμοποιώντας λίγα παραδείγματα αιτιολόγησης. Αν οι παραγμένες απαντήσεις είναι λανθασμένες, το μοντέλο προσπαθεί ξανά να παραγάγει μια αιτιολόγηση, αυτήν την φορά δίνοντας τη σωστή απάντηση. Το μοντέλο στη συνέχεια προσαρμόζεται περαιτέρω με όλες τις αιτιολογήσεις που οδήγησαν σε σωστές απαντήσεις, και η διαδικασία επαναλαμβάνεται.

STaR μεθοδολογία, δείχνοντας τον βρόχο περαιτέρω προσαρμογής και ένα δείγμα παραγωγής αιτιολόγησης στη βάση CommonsenseQA
Για να το παρουσιάσουμε με ένα πρακτικό παράδειγμα, σκεφτείτε την ερώτηση “Τι μπορεί να χρησιμοποιηθεί για να μεταφέρει έναν μικρό σκύλο;” με επιλογές απαντήσεων που κυμαίνονται από μια πισίνα έως ένα καλάθι. Το μοντέλο STaR παράγει μια αιτιολόγηση, αναγνωρίζοντας ότι η απάντηση πρέπει να είναι κάτι που μπορεί να μεταφέρει έναν μικρό σκύλο και καταλήγει στο συμπέρασμα ότι ένα καλάθι, που σχεδιάστηκε για να κρατάει πράγματα, είναι η σωστή απάντηση.
Η προσέγγιση του STaR είναι μοναδική στο ότι αξιοποιεί την προ-υπάρχουσα ικανότητα λογικής του μοντέλου. Χρησιμοποιεί μια διαδικασία παραγωγής και βελτίωσης δικών του αιτιολογήσεων, αυτο-εκπαιδεύοντας τη συλλογιστική ικανότητα του μοντέλου. Ωστόσο, ο βρόχος του STaR έχει τους δικούς του περιορισμούς. Το μοντέλο μπορεί να αποτύχει να λύσει νέα προβλήματα στο σύνολο εκπαίδευσης επειδή δεν λαμβάνει κανένα άμεσο σήμα εκπαίδευσης για προβλήματα που δεν μπορεί να λύσει. Για να αντιμετωπίσουμε αυτό το πρόβλημα, ο STaR εισάγει την εκ των υστέρων αιτιολόγηση. Για κάθε πρόβλημα που το μοντέλο δεν μπορεί να απαντήσει σωστά, παράγει μια νέα αιτιολόγηση παρέχοντας στο μοντέλο τη σωστή απάντηση, το οποίο επιτρέπει στο μοντέλο να σκέφτεται ανάποδα.
Ο STaR, επομένως, είναι μια κλιμακώσιμη μεθοδολογία αυτο-εκπαίδευσης που επιτρέπει στα μοντέλα να μαθαίνουν να παράγουν τα δικά τους αιτιολογήσεις ενώ μαθαίνουν να λύνουν ολοένα και πιο δύσκολα προβλήματα. Η εφαρμογή του STaR έχει δείξει υποσχόμενες επιτυχίες σε εργασίες που περιλαμβάνουν αριθμητική, μαθηματικά προβλήματα και κοινή λογική. Στη βάση CommonsenseQA, ο STaR βελτίωσε τόσο το μοντέλο αναφοράς με λίγα παραδείγματα όσο και το μοντέλο αναφοράς που προσαρμόστηκε περαιτέρω για να προβλέψει απευθείας απαντήσεις και απέδωσε συγκρίσιμα με ένα μοντέλο που είναι 30 φορές μεγαλύτερο.
Προτροπές με Ετικέτες Συμφραζομένων
Η ιδέα των “Προτροπών με Ετικέτες Συμφραζομένων” περιστρέφεται γύρω από την παροχή ενός επιπλέον επιπέδου συμφραζομένων στο μοντέλο AI, ετικετώνοντας ορισμένες πληροφορίες μέσα στην είσοδο. Αυτές οι ετικέτες λειτουργούν ως σηματοδότες για το AI, οδηγώντας το πώς να ερμηνεύσει τα συμφραζόμενα ακριβώς και να παράγει μια απάντηση που είναι και σχετική και πραγματική.
Φανταστείτε ότι έχετε μια συνομιλία με έναν φίλο για ένα συγκεκριμένο θέμα, π.χ. “σκάκι”. Κάνετε μια δήλωση και στη συνέχεια την ετικετεύετε με μια αναφορά, όπως “(πηγή: Βικιπαίδεια)”. Τώρα, ο φίλος σας, που σε αυτήν την περίπτωση είναι το μοντέλο AI, γνωρίζει ακριβώς από πού προέρχεται η πληροφορία σας. Αυτή η προσέγγιση στοχεύει να κάνει τις απαντήσεις του AI πιο αξιόπιστες, μειώνοντας τον κίνδυνο hallucination, ή την παραγωγή ψευδών γεγονότων.
Μια μοναδική πτυχή των προτροπών με ετικέτες συμφραζομένων είναι το δυναμικό τους να βελτιώσουν την “ευφυΐα ως προς τα συμφραζόμενα” του μοντέλου. Για παράδειγμα, το έγγραφο δείχνει αυτό χρησιμοποιώντας ένα διαφορετικό σύνολο ερωτήσεων που εξάγονται από πολλές πηγές, όπως συνοψισμένα άρθρα της Βικιπαίδειας σε διάφορα θέματα και ενότητες από ένα πρόσφατα δημοσιευμένο βιβλίο. Οι ερωτήσεις ετικετεύονται, παρέχοντας στο μοντέλο AI επιπλέον συμφραζόμενα σχετικά με την πηγή της πληροφορίας.
Αυτό το επιπλέον επίπεδο συμφραζομένων μπορεί να αποδειχθεί εξαιρετικά ωφέλιμο όταν πρόκειται για την παραγωγή απαντήσεων που δεν είναι μόνο ακριβείς αλλά και πιστές στα συμφραζόμενα που παρέχονται, καθιστώντας την έξοδο του AI πιο αξιόπιστη και άξια εμπιστοσύνης.
Συμπέρασμα: Μια Ματιά στις Υποσχόμενες Τεχνικές και Μελλοντικές Κατευθύνσεις
Το ChatGPT της OpenAI παρουσιάζει το ανεξερεύνητο δυναμικό των Μεγάλων Μοντέλων Γλώσσας (LLMs) στην αντιμετώπιση σύνθετων εργασιών με αξιοσημείωτη αποτελεσματικότητα. Προηγμένες τεχνικές όπως η μάθηση με λίγα παραδείγματα, η ReAct προτροπή, η αλυσίδα σκέψης, και ο STaR, μας επιτρέπουν να αξιοποιήσουμε αυτό το δυναμικό σε ένα πλήθος εφαρμογών. Καθώς εμβαθύνουμε στις ιδιαιτερότητες αυτών των μεθόδων, ανακαλύπτουμε πώς διαμορφώνουν το τοπίο της τεχνητής νοημοσύνης, προσφέροντας πλουσιότερες και ασφαλέστερες αλληλεπιδράσεις μεταξύ ανθρώπων και μηχανών.
Παρά τις προκλήσεις όπως η σύγκρουση γνώσης, η υπερβολική εξάρτηση από παραμετρική γνώση, και ο κίνδυνος hallucination, αυτά τα μοντέλα AI, με τη σωστή μηχανική προτροπών, έχουν αποδειχθεί μεταμορφωτικά εργαλεία. Η περαιτέρω προσαρμογή με οδηγίες, η διατύπωση προτροπών με πιστότητα στα συμφραζόμενα, και η ενσωμάτωση με εξωτερικές πηγές δεδομένων ενισχύουν περαιτέρω την ικανότητά τους να συλλογίζονται, να μάθουν, και να προσαρμοστούν.


