
Μοντέλα και πλατφόρμες AI
Η πολυτροπική τεχνητή νοημοσύνη εξελίσσεται καθώς το ChatGPT αποκτά όραση με το GPT-4V

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google

Βασικά σημείαΤο GPT-4V της OpenAI προσθέτει ανάλυση εικόνων στο ChatGPT, διευρύνοντας την τεχνητή…
Δείτε περισσότερα
- Το GPT-4V της OpenAI προσθέτει ανάλυση εικόνων στο ChatGPT, διευρύνοντας την τεχνητή νοημοσύνη πέρα από το κείμενο.
- Το GPT-4V δείχνει υποσχέσεις σε τεχνικές εργασίες αλλά έχει κρίσιμα ελαττώματα στην ιατρική χρήση.
- Πολυτροπικά μοντέλα όπως το Med-PaLM M προωθούν εξειδικευμένους τομείς όπως η υγειονομική περίθαλψη.
Στη συνεχιζόμενη προσπάθεια να κάνει την τεχνητή νοημοσύνη να μοιάζει με τους ανθρώπους, τα μοντέλα GPT της OpenAI έχουν συνεχώς διευρύνει τα όρια. Το GPT-4 είναι τώρα σε θέση να δέχεται προτροπές τόσο κειμένου όσο και εικόνων.
Η πολυτροπικότητα στην παραγωγική τεχνητή νοημοσύνη υποδηλώνει την ικανότητα του μοντέλου να παράγει ποικιλόμορφες εξόδους όπως κείμενο, εικόνες ή ήχο με βάση την είσοδο. Αυτά τα μοντέλα, εκπαιδευμένα σε συγκεκριμένα δεδομένα, μαθαίνουν τα υποκείμενα μοτίβα για να παράγουν παρόμοια νέα δεδομένα, εμπλουτίζοντας τις εφαρμογές της νοημοσύνης.
Πρόσφατες εξελίξεις στην πολυτροπική τεχνητή νοημοσύνη
Μια πρόσφατη σημαντική πρόοδος σε αυτό το πεδίο είναι την ενσωμάτωση του DALL-E 3 στο ChatGPT, μια σημαντική αναβάθμιση στην τεχνολογία κειμένου-εικόνας της OpenAI. Αυτή η σύντηξη επιτρέπει μια ομαλότερη αλληλεπίδραση όπου το ChatGPT βοηθά στην δημιουργία ακριβών προτροπών για το DALL-E 3, μετατρέποντας τις ιδέες του χρήστη σε ζωηρή AI-γεννημένη τέχνη. Έτσι, ενώ οι χρήστες μπορούν να αλληλεπιδράσουν απευθείας με το DALL-E 3, η παρουσία του ChatGPT στη διαδικασία καθιστά τη δημιουργία AI τέχνης πολύ πιο φιλική προς τον χρήστη.
Δείτε περισσότερα για το DALL-E 3 και την ενσωμάτωση του με το ChatGPT εδώ. Αυτή η συνεργασία δεν μόνο επιδεικνύει την πρόοδο στη πολυτροπική νοημοσύνη αλλά και καθιστά τη δημιουργία AI τέχνης μια ευχαρίστηση για τους χρήστες.

Το τμήμα Google Health από την άλλη πλευρά εισήγαγε το Med-PaLM M τον Ιούνιο του τρέχοντος έτους. Είναι ένα πολυτροπικό μοντέλο παραγωγικής τεχνητής νοημοσύνης ικανό να κωδικοποιεί και να ερμηνεύει ποικιλόμορφα βιοϊατρικά δεδομένα. Αυτό επιτεύχθηκε με την εκπαίδευση του PaLM-E, ενός γλωσσικού μοντέλου, για να εξυπηρετήσει ιατρικούς τομείς χρησιμοποιώντας ένα ανοιχτό benchmark, το MultiMedBench. Αυτό το benchmark αποτελείται από πάνω από 1 εκατομμύριο δείγματα σε 7 βιοϊατρικούς τύπους δεδομένων και 14 εργασίες όπως η ιατρική απάντηση σε ερωτήσεις και η παραγωγή ακτινολογικών αναφορών.
Διάφορες βιομηχανίες υιοθετούν καινοτόμα πολυτροπικά εργαλεία τεχνητής νοημοσύνης για να ενισχύσουν την επιχειρηματική επέκταση, να εξορθολογίσουν τις λειτουργίες και να αναβαθμίσουν την αλληλεπίδραση με τους πελάτες. Η πρόοδος στις ικανότητες φωνής, βίντεο και κειμένου της νοημοσύνης προωθεί την ανάπτυξη της πολυτροπικής νοημοσύνης.
Οι επιχειρήσεις αναζητούν εφαρμογές πολυτροπικής νοημοσύνης ικανές να ανατρέψουν τα επιχειρηματικά μοντέλα και τις διαδικασίες, ανοίγοντας δρόμους για την ανάπτυξη σε ολόκληρο το οικοσύστημα της παραγωγικής τεχνητής νοημοσύνης, από εργαλεία δεδομένων έως αναδυόμενες εφαρμογές νοημοσύνης.
Μετά την κυκλοφορία του GPT-4 τον Μάρτιο, κάποιοι χρήστες παρατήρησαν μια πτώση στην ποιότητα των απαντήσεων του με τον καιρό, μια ανησυχία που αντανακλούσε και από γνωστούς προγραμματιστές και στα φόρουμ της OpenAI. Αρχικά, η OpenAI απέρριψε αυτές τις ανησυχίες, αλλά μια μεταγενέστερη μελέτη ανέφερε, στην αρχική έκδοση του Ιουλίου 2023, πτώση από 97,6% τον Μάρτιο σε 2,4% τον Ιούνιο σε συγκεκριμένη δοκιμή αναγνώρισης πρώτων αριθμών. Τα ποσοστά αφορούν αυτή τη δοκιμή και όχι τη συνολική ακρίβεια του GPT-4.

ChatGPT (Μπλε) & Artificial intelligence (Κόκκινο) Google Search Trend
Το ενδιαφέρον γύρω από το OpenAI ChatGPT έχει αναζωπυρωθεί. Τώρα έρχεται με μια λειτουργία όρασης GPT-4V, επιτρέποντας στους χρήστες να έχουν το GPT-4 να αναλύει εικόνες που τους δίνονται. Αυτή είναι η πιο πρόσφατη λειτουργία που έχει ανοίξει στους χρήστες.
Η προσθήκη ανάλυσης εικόνας σε μεγάλα γλωσσικά μοντέλα (LLMs) όπως το GPT-4 θεωρείται από κάποιους ως ένα μεγάλο βήμα προς τα εμπρός στην έρευνα και ανάπτυξη της νοημοσύνης. Αυτού του είδους το πολυτροπικό LLM ανοίγει νέες δυνατότητες, μεταφέροντας τα γλωσσικά μοντέλα πέρα από το κείμενο για να προσφέρει νέες διεπαφές και να λύσει νέους τύπους εργασιών, δημιουργώντας νέες εμπειρίες για τους χρήστες.
Η εκπαίδευση του GPT-4V ολοκληρώθηκε το 2022, με την πρώιμη πρόσβαση να κυκλοφορεί τον Μάρτιο του 2023. Η οπτική λειτουργία στο GPT-4V είναι ενισχυμένη από την τεχνολογία του GPT-4. Η διαδικασία εκπαίδευσης παρέμεινε η ίδια. Αρχικά, το μοντέλο εκπαιδεύτηκε να προβλέψει την επόμενη λέξη σε ένα κείμενο χρησιμοποιώντας ένα τεράστιο σύνολο δεδομένων τόσο κειμένου όσο και εικόνων από διάφορες πηγές, συμπεριλαμβανομένου του διαδικτύου.
Αργότερα, αυτό το μοντέλο εξευγενίστηκε με περισσότερα δεδομένα, χρησιμοποιώντας μια μέθοδο που ονομάζεται ενισχυτική μάθηση από ανθρώπινη ανατροφοδότηση (RLHF), για να παράγει εξόδους που προτιμούν οι άνθρωποι.
Μηχανισμοί του GPT-4 Vision
Οι εξαιρετικές ικανότητες όρασης και γλώσσας του GPT-4, αν και εντυπωσιακές, έχουν υποκείμενες μεθόδους που παραμένουν στην επιφάνεια.
Για να εξερευνήσουμε αυτή την υπόθεση, ένα νέο μοντέλο όρασης-γλώσσας, MiniGPT-4, εισήχθη, χρησιμοποιώντας ένα προηγμένο LLM που ονομάζεται Vicuna. Αυτό το μοντέλο χρησιμοποιεί έναν κωδικοποιητή όρασης με προ-εκπαιδευμένα συστατικά για την οπτική αντίληψη, ευθυγραμμίζοντας τα κωδικοποιημένα οπτικά χαρακτηριστικά με το Vicuna γλωσσικό μοντέλο μέσω ενός μόνο στρώματος προβολής. Η αρχιτεκτονική του MiniGPT-4 είναι απλή αλλά αποτελεσματική, με έμφαση στην ευθυγράμμιση οπτικών και γλωσσικών χαρακτηριστικών για να βελτιώσει τις οπτικές συνομιλίες.
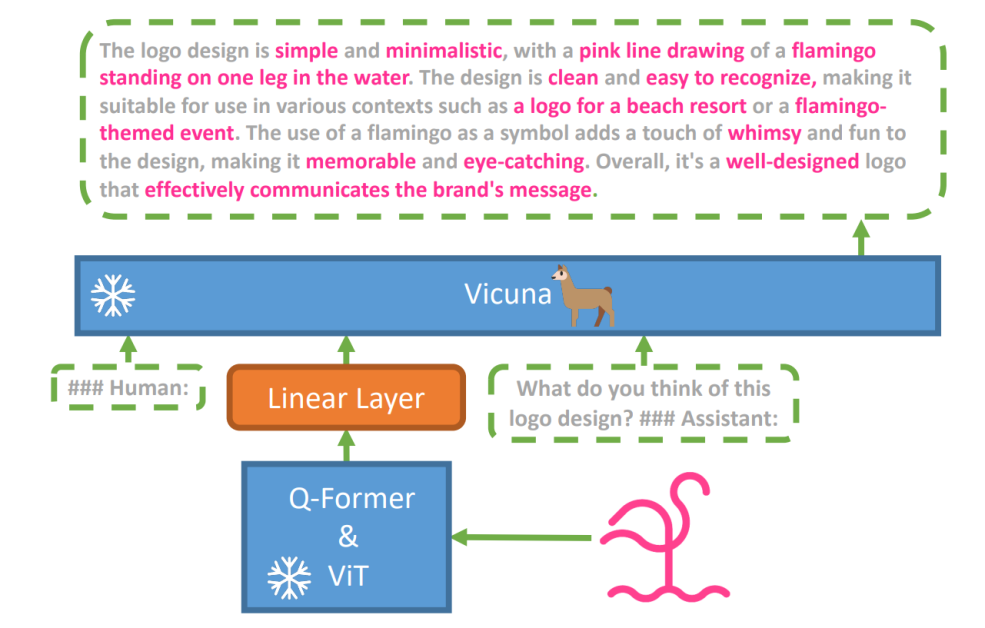
Η αρχιτεκτονική του MiniGPT-4 περιλαμβάνει έναν κωδικοποιητή όρασης με προ-εκπαιδευμένα ViT και Q-Former, ένα μονό προβολικό στρώμα, και ένα προηγμένο Vicuna γλωσσικό μοντέλο.
Η τάση των αυτοπαλινδρομικών γλωσσικών μοντέλων σε εργασίες όρασης-γλώσσας έχει επίσης αυξηθεί, εκμεταλλευόμενη την δια-τροπική μεταφορά για να μοιράζεται γνώσεις μεταξύ γλώσσας και πολυτροπικών τομέων.
Το MiniGPT-4 γεφυρώνει τους οπτικούς και γλωσσικούς τομείς ευθυγραμμίζοντας οπτικές πληροφορίες από έναν προ-εκπαιδευμένο κωδικοποιητή όρασης με ένα προηγμένο LLM. Το μοντέλο χρησιμοποιεί το Vicuna ως γλωσσικό αποκωδικοποιητή και ακολουθεί μια εκπαιδευτική προσέγγιση δύο σταδίων. Αρχικά, εκπαιδεύεται σε ένα μεγάλο σύνολο δεδομένων εικόνας-κειμένου για να κατανοήσει γνώσεις όρασης-γλώσσας, ακολουθούμενο από εξευγενισμό σε ένα μικρότερο, υψηλής ποιότητας σύνολο δεδομένων για να βελτιώσει την αξιοπιστία και την χρησιμότητα της παραγωγής.
Για να βελτιώσει την φυσικότητα και την χρησιμότητα της παραγόμενης γλώσσας στο MiniGPT-4, οι ερευνητές ανέπτυξαν μια διαδικασία ευθυγράμμισης δύο σταδίων, αντιμετωπίζοντας την έλλειψη επαρκούς ευθυγράμμιση όρασης-γλώσσας συνόλου δεδομένων. Δημιουργήθηκε ένα ειδικό σύνολο δεδομένων για αυτόν τον σκοπό.
Αρχικά, το μοντέλο παρήγαγε λεπτομερείς περιγραφές των εισαγώμενων εικόνων, εμπλουτίζοντας τις λεπτομέρειες χρησιμοποιώντας μια συνομιλιακή προτροπή ευθυγραμμισμένη με το Vicuna γλωσσικό μοντέλο. Αυτό το στάδιο είχε ως στόχο να παράγει πιο ολοκληρωμένες περιγραφές εικόνων.
Εξήγηση Εικόνας Προτροπή:
###Human: <Img><ImageFeature></Img>Περιγράψτε αυτή την εικόνα λεπτομερώς. Δώστε όσες περισσότερες λεπτομέρειες μπορείτε. Πείτε όλα όσα βλέπετε. ###Assistant:
Για την επεξεργασία δεδομένων μετά την εκπαίδευση, οποιαδήποτε ασυνέπεια ή λάθος στις γεννηθείσες περιγραφές διορθώθηκαν χρησιμοποιώντας το ChatGPT, ακολουθούμενο από χειροκίνητη επαλήθευση για να διασφαλιστεί η υψηλή ποιότητα.
Δεύτερη Φάση Ευθυγράμμιση Προτροπή:
###Human: <Img><ImageFeature></Img><Instruction>###Assistant:
Αυτή η εξέταση ανοίγει ένα παράθυρο για την κατανόηση των μηχανισμών της πολυτροπικής παραγωγικής τεχνητής νοημοσύνης όπως το GPT-4, ρίχνοντας φως σε πώς οι λειτουργίες όρασης και γλώσσας μπορούν να ενσωματωθούν αποτελεσματικά για να παράγουν συνεκτικές και πλούσιες εξόδους.
Εξερεύνηση του GPT-4 Vision
Καθορίζοντας την Προέλευση Εικόνων με το ChatGPT
Το GPT-4 Vision ενισχύει την ικανότητα του ChatGPT να αναλύει εικόνες και να καθορίζει τις γεωγραφικές τους προελεύσεις. Αυτή η λειτουργία μεταφέρει τις αλληλεπιδράσεις των χρηστών από το απλό κείμενο σε μια μίξη κειμένου και εικόνων, γίνοντας ένα χρήσιμο εργαλείο για εκείνους που είναι περίεργοι για διαφορετικά μέρη μέσω δεδομένων εικόνων.

Ρωτώντας το ChatGPT πού μια εικόνα είναι ληφθεί
Σύνθετες μαθηματικές έννοιες
Το GPT-4 Vision διακρίνεται για την ικανότητά του να εμβαθύνει σε σύνθετες μαθηματικές ιδέες αναλύοντας γραφικές ή χειρόγραφες εκφράσεις. Αυτή η λειτουργία ενεργεί ως ένα χρήσιμο εργαλείο για άτομα που αναζητούν να λύσουν σύνθετα μαθηματικά προβλήματα, σημειώνοντας το GPT-4 Vision ως έναν αξιοσημείωτο βοηθό στην εκπαίδευση και τα ακαδημαϊκά πεδία.

Ρωτώντας το ChatGPT να κατανοήσει μια σύνθετη μαθηματική έννοια
Μετατρέποντας Χειρόγραφη Είσοδο σε LaTeX Κώδικες
Μια από τις αξιοσημείωτες ικανότητες του GPT-4V είναι η δυνατότητά του να μετατρέψει χειρόγραφες εισόδους σε LaTeX κώδικες. Αυτή η λειτουργία είναι μια ευλογία για ερευνητές, ακαδημαϊκούς και φοιτητές που συχνά χρειάζονται να μετατρέψουν χειρόγραφες μαθηματικές εκφράσεις ή άλλες τεχνικές πληροφορίες σε ψηφιακή μορφή. Η μετατροπή από χειρόγραφη σε LaTeX επεκτείνει τον ορίζοντα της ψηφιοποίησης εγγράφων και απλοποιεί τη διαδικασία της τεχνικής γραφής.

Η ικανότητα του GPT-4V να μετατρέψει χειρόγραφη είσοδο σε LaTeX κώδικες
Εξαγωγή Λεπτομερειών Πίνακα
Το GPT-4V παρουσιάζει ικανότητα στην εξαγωγή λεπτομερειών από πίνακες και την απάντηση σε σχετικές ερωτήσεις, ένα ζωτικό εργαλείο για την ανάλυση δεδομένων. Οι χρήστες μπορούν να χρησιμοποιήσουν το GPT-4V για να διερευνήσουν πίνακες, να συλλέξουν κρίσιμες πληροφορίες και να λύσουν ερωτήσεις, καθιστώντας το ένα ισχυρό εργαλείο για ανάλυση δεδομένων και άλλους επαγγελματίες.

Το GPT-4V κατανοώντας λεπτομέρειες πίνακα και απαντώντας σε σχετικές ερωτήσεις
Κατανόηση Οπτικής Δείξης
Η μοναδική ικανότητα του GPT-4V να κατανοήσει οπτική δείξη προσθέτει μια νέα διάσταση στην αλληλεπίδραση του χρήστη. Κατανοώντας οπτικές ενδείξεις, το GPT-4V μπορεί να απαντήσει σε ερωτήσεις με μεγαλύτερη συμφραστική κατανόηση.

Το GPT-4V παρουσιάζει την μοναδική ικανότητα να κατανοήσει οπτική δείξη
Κατασκευή Απλών Mock-Up Ιστοσελίδων χρησιμοποιώντας μια σχεδίαση
Ενθαρρυμένος από αυτό το tweet, προσπάθησα να δημιουργήσω ένα mock-up για την ιστοσελίδα unite.ai.
Ενώ το αποτέλεσμα δεν ήταν ακριβώς όπως την αρχικό μου όραμα, εδώ είναι το αποτέλεσμα που κατάφερα να πετύχω.

Διεπαφή HTML που δημιουργήθηκε με το ChatGPT Vision
Περιορισμοί & Ελαττώματα του GPT-4V(ision)
Για να αναλύσει το GPT-4V, η ομάδα της Open AI πραγματοποίησε ποιοτικές και ποσοτικές αξιολογήσεις. Οι ποιοτικές αξιολογήσεις περιελάμβαναν εσωτερικές δοκιμές και εξωτερικές αξιολογήσεις από εμπειρογνώμονες, ενώ οι ποσοτικές αξιολογήσεις μετρούσαν τις απορρίψεις του μοντέλου και την ακρίβεια σε διάφορα σενάρια όπως η αναγνώριση επικίνδυνου περιεχομένου, η αναγνώριση δημογραφικών, οι ανησυχίες για την ιδιωτικότητα, η γεω-τοποθεσία, η κυβερνοασφάλεια και οι πολυτροπικές παρακάμψεις ασφαλείας.
Ωστόσο, το μοντέλο δεν είναι τέλειο.
Το έγγραφο υπογραμμίζει τους περιορισμούς του GPT-4V, όπως λανθασμένες εικασίες και λείψεις κειμένου ή χαρακτήρων σε εικόνες. Μπορεί να φαντασιώνεται ή να εφευρίσκει γεγονότα. Ιδιαίτερα, δεν είναι κατάλληλο για την αναγνώριση επικίνδυνων ουσιών σε εικόνες, συχνά τις αναγνωρίζοντας λανθασμένα.
Στην ιατρική απεικόνιση, το GPT-4V μπορεί να παρέχει ασυνεπείς απαντήσεις και λείπει της γνώσης των τυπικών πρακτικών, οδηγώντας σε πιθανές λανθασμένες διαγνώσεις.

Αναξιόπιστη απόδοση για ιατρικούς σκοπούς (Πηγή)
Επίσης, αποτυγχάνει να κατανοήσει τις λεπτές αποχρώσεις ορισμένων συμβόλων μίσους και μπορεί να παράγει ακατάλληλο περιεχόμενο με βάση τις οπτικές εισόδους. Η OpenAI συμβουλεύει ενάντια στην χρήση του GPT-4V για κρίσιμες ερμηνείες, ιδιαίτερα σε ιατρικούς ή ευαίσθητους τομείς.
Συμπέρασμα

Δημιουργήθηκε με το Fast Stable Diffusion XL https://huggingface.co/spaces/google/sdxl
Η άφιξη του GPT-4 Vision (GPT-4V) φέρνει μαζί της μια σειρά από ενδιαφέρουσες δυνατότητες και νέες προκλήσεις. Πριν από την κυκλοφορία του, έχει γίνει μεγάλη προσπάθεια για να διασφαλιστεί ότι οι κίνδυνοι, ιδιαίτερα όσον αφορά τις εικόνες ανθρώπων, έχουν μελετηθεί και μειωθεί. Είναι εντυπωσιακό να δούμε πώς το GPT-4V έχει προοδεύσει, δείχνοντας πολλές υποσχόμενες δυνατότητες σε δυσκόλους τομείς όπως η ιατρική και η επιστήμη.
Τώρα, υπάρχουν ορισμένα μεγάλα ερωτήματα στο τραπέζι. Για παράδειγμα, πρέπει αυτά τα μοντέλα να είναι σε θέση να αναγνωρίσουν διάσημους ανθρώπους από φωτογραφίες; Πρέπει να μαντέψουν το φύλο, τη φυλή ή τα συναισθήματα ενός ατόμου από μια εικόνα; Και, πρέπει να υπάρχουν ειδικές ρυθμίσεις για να βοηθήσουν άτομα με προβλήματα όρασης; Αυτές οι ερωτήσεις αναδεικνύουν ένα σύνολο περίπλοκων ζητημάτων σχετικά με την ιδιωτικότητα, την ισότητα και τον τρόπο με τον οποίο η νοημοσύνη πρέπει να ενταχθεί στη ζωή μας, ζητήματα για τα οποία κάθε άνθρωπος πρέπει να έχει λόγο.


