
Συνεντεύξεις
Φρανκ Λιού, Διευθυντής Επιχειρήσεων στην Zilliz – Σειρά Συνεντεύξεων

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
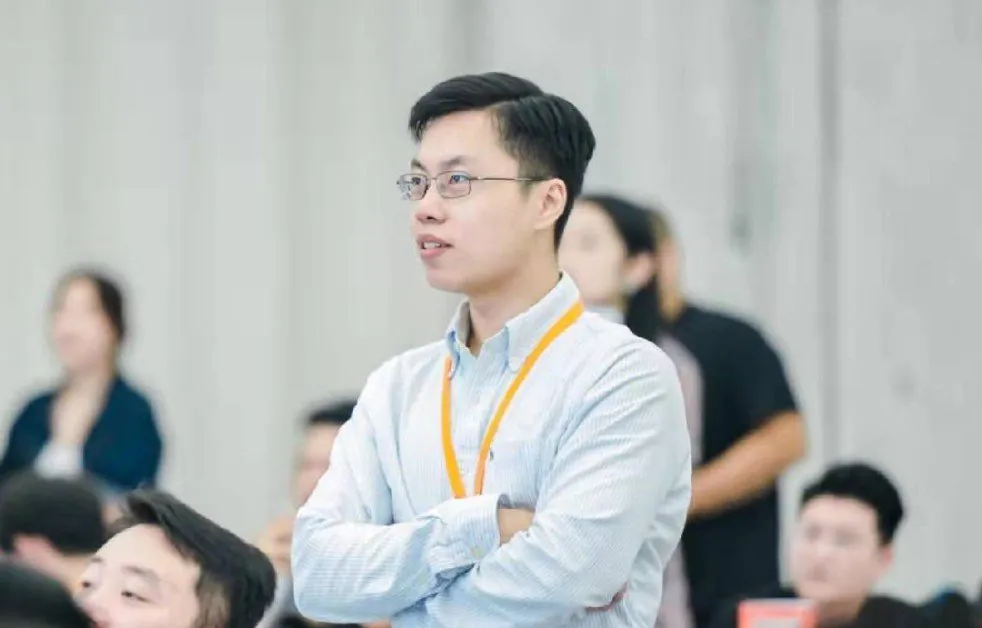
Ο Φρανκ Λιού είναι ο Διευθυντής Επιχειρήσεων στην Zilliz, μια ηγετική εταιρεία που παρέχει τεχνολογίες βάσεων δεδομένων διανυσμάτων και τεχνητής νοημοσύνης. Είναι επίσης οι μηχανικοί και επιστήμονες που δημιούργησαν το LF AI Milvus®, την πιο δημοφιλή ανοιχτή βάση δεδομένων διανυσμάτων στον κόσμο.
Τι σας έκανε να ενδιαφερθείτε αρχικά για την μηχανική μάθηση;
Η πρώτη μου επαφή με τη δύναμη της ML/ΑΙ ήταν ως φοιτητής στο Πανεπιστήμιο του Στάνφορντ, παρά το γεγονός ότι ήταν λίγο μακριά από το αντικείμενο σπουδών μου (Ηλεκτρολογική Μηχανική). Αρχικά, με έκανε να ενδιαφερθώ η ικανότητα να αναλύσω σύνθετα ηλεκτρικά και φυσικά συστήματα σε μαθηματικές προσεγγίσεις, και η στατιστική και η μηχανική μάθηση μου φάνηκαν το ίδιο ισχυρές. Κατέληξα να παρακολουθήσω περισσότερα μαθήματα υπολογιστικής όρασης και μηχανικής μάθησης κατά τη διάρκεια της μεταπτυχιακής μου εκπαίδευσης, και έγραψα τη διπλωματική μου εργασία για τη χρήση της ML για να βαθμολογήσω την αισθητική ομορφιά των εικόνων. Όλα αυτά οδήγησαν στην πρώτη μου δουλειά στην ομάδα Υπολογιστικής Όρασης και Μηχανικής Μάθησης της Yahoo, όπου είχα ένα υβριδικό ρόλο έρευνας και ανάπτυξης λογισμικού. Βρισκόμασταν ακόμη στην εποχή των AlexNet και VGG, πριν από τα μοντέλα Transformer, και το να δεις ολόκληρο το πεδίο και τη βιομηχανία να κινείται τόσο γρήγορα, από την προετοιμασία των δεδομένων μέχρι την μαζικά παράλληλη εκπαίδευση μοντέλων και τη θέση τους σε παραγωγική λειτουργία, ήταν απίστευτο. Σε πολλές περιπτώσεις, φαίνεται λίγο αστείο να χρησιμοποιήσω τη φράση “παλιά” για να αναφέρω σε κάτι που συνέβη λιγότερο από 10 χρόνια πριν, αλλά τέτοια είναι η πρόοδος που έχει γίνει σε αυτό το πεδίο.
Μετά την Yahoo, υπηρέτησα ως Τεχνικός Διευθυντής μιας εταιρείας που είχα συνιδρύσει, όπου χρησιμοποιήσαμε την ML για τον εντοπισμό θέσης σε εσωτερικούς χώρους. Εκεί, έπρεπε να βελτιστοποιήσουμε ακολουθιακά μοντέλα για πολύ μικρούς μικροελεγκτές – μια διαφορετική αλλά συναφής μηχανική πρόκληση με τα σημερινά μεγάλα LLMs και μοντέλα διάχυσης. Κατασκευάσαμε επίσης υλικό, πίνακες για οπτική αναπαράσταση και απλές εφαρμογές σχεδιασμένες εξαρχής για το cloud, αλλά η AI/ML ήταν πάντα το κεντρικό συστατικό του έργου μας.
Ακόμη και αν έχω εργαστεί στην ML ή σε συναφές πεδίο για το καλύτερο μέρος των 7 ή 8 ετών τώρα, ακόμη διατηρώ πολλή αγάπη για το σχεδιασμό κυκλωμάτων και τη ψηφιακή λογική. Έχοντας ένα υπόβαθρο στην Ηλεκτρολογική Μηχανική είναι, με πολλούς τρόπους, απίστευτα χρήσιμο για πολλή από την εργασία που είμαι εμπλεκόμενος αυτές τις μέρες. Πολλές σημαντικές έννοιες στο ψηφιακό σχεδιασμό, όπως η μεταφορική μνήμη, η πρόβλεψη κλάδου και η ταυτόχρονη εκτέλεση σε HDL, παρέχουν μια πλήρη άποψη σε πολλά από τα ML και τα σημερινά κατανεμημένα συστήματα. Ενώ καταλαβαίνω τον έλξη του CS, ελπίζω να δω μια αναβίωση σε πιο παραδοσιακά πεδία μηχανικής – Ηλεκτρολογική, Μηχανολογική, Χημική Μηχανική κ.λπ. – μέσα στα επόμενα χρόνια.
Για τους αναγνώστες που δεν είναι εξοικειωμένοι με τον όρο, τι είναι τα μη δομημένα δεδομένα;
Τα μη δομημένα δεδομένα αναφέρεται σε “σύνθετα” δεδομένα, τα οποία είναι ουσιαστικά δεδομένα που δεν μπορούν να αποθηκευτούν σε προκαθορισμένο μορφότυπο ή να ταιριάζουν σε υπάρχοντα μοντέλο δεδομένων. Για σύγκριση, τα δομημένα δεδομένα αναφέρονται σε οποιοδήποτε είδος δεδομένων που έχει προκαθορισμένη δομή – αριθμητικά δεδομένα, συμβολοσειρές, πίνακες, αντικείμενα και ζευγάρια κλειδιού-τιμής είναι όλα παραδείγματα δομημένων δεδομένων.
Για να κατανοήσετε πραγματικά τι είναι τα μη δομημένα δεδομένα και γιατί είναι παραδοσιακά δύσκολο να επεξεργαστούνται αυτά τα δεδομένα, βοηθά να τα συγκρίνετε με τα δομημένα δεδομένα. Σε απλούστερους όρους, τα παραδοσιακά δομημένα δεδομένα μπορούν να αποθηκευτούν μέσω ενός σχεσιακού μοντέλου. Πάρτε, για παράδειγμα, μια σχεσιακή βάση δεδομένων με έναν πίνακα για την αποθήκευση πληροφοριών βιβλίων: κάθε γραμμή στο πίνακα θα μπορούσε να αντιπροσωπεύει ένα συγκεκριμένο βιβλίο που ευρετηριάζεται από τον αριθμό ISBN, ενώ οι στήλες θα σήμαιναν την αντίστοιχη κατηγορία πληροφοριών, όπως τίτλος, συγγραφέας, ημερομηνία έκδοσης, κ.λπ. Σήμερα, υπάρχουν πολύ πιο ευέλικτα μοντέλα δεδομένων – αποθήκες wide-column, βάσεις δεδομένων αντικειμένων, βάσεις δεδομένων γράφου, κ.λπ. Αλλά η γενική ιδέα παραμένει η ίδια: αυτές οι βάσεις δεδομένων προορίζονται για την αποθήκευση δεδομένων που ταιριάζουν σε συγκεκριμένο μορφότυπο δεδομένων.
Τα μη δομημένα δεδομένα, από την άλλη πλευρά, μπορεί να θεωρηθεί ως ουσιαστικά ένα ψευδο-τυχαίο μπλοκ δυαδικών δεδομένων. Μπορεί να αντιπροσωπεύει οτιδήποτε, να είναι αυθαίρετα μεγάλο ή μικρό, και μπορεί να μετατραπεί και να διαβαστεί με έναν από τους αμέτρητους διαφορετικούς τρόπους. Αυτό το καθιστά αδύνατο να ταιριάζει σε οποιοδήποτε μοντέλο δεδομένων, ακόμη και σε έναν πίνακα μιας σχεσιακής βάσης δεδομένων.
Ποια είναι κάποια παραδείγματα αυτού του είδους δεδομένων;
Τα δεδομένα που παράγονται από ανθρώπους – εικόνες, βίντεο, ήχος, φυσική γλώσσα, κ.λπ. – είναι εξαιρετικά παραδείγματα μη δομημένων δεδομένων. Αλλά υπάρχουν πολλά άλλα λιγότερο συνηθισμένα παραδείγματα μη δομημένων δεδομένων. Τα προφίλ χρηστών, οι δομές πρωτεϊνών, οι ακολουθίες γονιδιώματος και ακόμη και ο κώδικας που είναι αναγνώσιμος από άνθρωπο είναι επίσης εξαιρετικά παραδείγματα μη δομημένων δεδομένων. Ο κύριος λόγος που τα μη δομημένα δεδομένα έχουν παραδοσιακά ήταν τόσο δύσκολο να διαχειριστούν είναι ότι τα μη δομημένα δεδομένα μπορούν να έχουν οποιαδήποτε μορφή και μπορεί να απαιτούν πολύ διαφορετικές χρόνους εκτέλεσης για την επεξεργασία.
Χρησιμοποιώντας τις εικόνες ως παράδειγμα, δύο φωτογραφίες της ίδιας σκηνής θα μπορούσαν να έχουν πολύ διαφορετικές τιμές pixel, αλλά και οι δύο έχουν παρόμοιο συνολικό περιεχόμενο. Η φυσική γλώσσα είναι ένα άλλο παράδειγμα μη δομημένων δεδομένων που μου αρέσει να αναφέρω. Οι φράσεις “Ηλεκτρολογική Μηχανική” και “Επιστήμη Υπολογιστών” είναι εξαιρετικά στενά συνδεδεμένες – τόσο πολύ, ώστε τα κτήρια Ηλεκτρολογικής Μηχανικής και Επιστήμης Υπολογιστών στο Στάνφορντ είναι δίπλα το ένα στο άλλο – αλλά χωρίς έναν τρόπο να κωδικοποιήσουμε τη σημασιολογική σημασία πίσω από αυτές τις δύο φράσεις, ένας υπολογιστής μπορεί να νομίσει ότι “Επιστήμη Υπολογιστών” και “Κοινωνική Επιστήμη” είναι πιο συναφείς.
Τι είναι μια βάση δεδομένων διανυσμάτων;
Για να κατανοήσετε μια βάση δεδομένων διανυσμάτων, πρώτα βοηθά να κατανοήσετε τι είναι μια ενσωμάτωση. Θα το εξηγήσω σε λίγο, αλλά η σύντομη εκδοχή είναι ότι μια ενσωμάτωση είναι ένα διάνυσμα πολλών διαστάσεων που μπορεί να αντιπροσωπεύει τη σημασιολογία των μη δομημένων δεδομένων. Γενικά, δύο ενσωματώσεις που είναι κοντά η μια στην άλλη σε σχέση με την απόσταση είναι πολύ πιθανό να αντιστοιχούν σε σημασιολογικά παρόμοια δεδομένα εισόδου. Με τη σύγχρονη ML, έχουμε τη δύναμη να κωδικοποιήσουμε και να μετατρέψουμε μια ποικιλία διαφορετικών τύπων μη δομημένων δεδομένων – εικόνες και κείμενο, για παράδειγμα – σε σημασιολογικά ισχυρά διανύσματα ενσωμάτωσης.
Από την πλευρά μιας οργάνωσης, τα μη δομημένα δεδομένα γίνονται απίστευτα δύσκολα να διαχειριστούν μια φορά που η ποσότητα ξεπεράσει ένα ορισμένο όριο. Εδώ είναι όπου μια βάση δεδομένων διανυσμάτων όπως η Zilliz Cloud έρχεται. Μια βάση δεδομένων διανυσμάτων είναι ειδικά σχεδιασμένη για την αποθήκευση, την ευρετηρίαση και την αναζήτηση σε τεράστιες ποσότητες μη δομημένων δεδομένων, χρησιμοποιώντας ενσωματώσεις ως την υποκείμενη αναπαράσταση. Η αναζήτηση σε μια βάση δεδομένων διανυσμάτων γίνεται συνήθως με διανυσματικές ερωτήσεις, και το αποτέλεσμα της ερωτήματος είναι τα top N πιο παρόμοια αποτελέσματα με βάση την απόσταση.
Οι καλύτερες βάσεις δεδομένων διανυσμάτων έχουν πολλές από τις λειτουργίες ευχρηστίας των παραδοσιακών σχεσιακών βάσεων δεδομένων: οριζόντια κλιμάκωση, προσωρινή αποθήκευση, αντιγραφή, αυτόματη μετάπτωση σε εφεδρικό σύστημα σε περίπτωση βλάβης, και εκτέλεση ερωτήματος είναι μόνο μερικές από τις πολλές λειτουργίες που μια αληθινή βάση δεδομένων διανυσμάτων πρέπει να εφαρμόσει. Ως ορισμός κατηγορίας, έχουμε δραστηριοποιηθεί σε ακαδημαϊκούς κύκλους, έχοντας δημοσιεύσει ερευνητικές εργασίες στο SIGMOD 2021 και VLDB 2022, τις δύο κορυφαίες συνέδρια βάσεων δεδομένων που υπάρχουν σήμερα.
Μπορείτε να συζητήσετε τι είναι μια ενσωμάτωση;
Γενικά, μια ενσωμάτωση είναι ένα διάνυσμα πολλών διαστάσεων που προέρχεται από τις ενεργοποιήσεις ενός ενδιάμεσου στρώματος σε ένα πολυστρώματο νευρωνικό δίκτυο. Πολλά νευρωνικά δίκτυα εκπαιδεύονται να εξάγουν ενσωματώσεις και ορισμένες εφαρμογές χρησιμοποιούν συνδεδεμένα διανύσματα από πολλαπλά ενδιάμεσα στρώματα ως την ενσωμάτωση, αλλά δεν θα το αναλύσω περισσότερο για τώρα. Ένας άλλος λιγότερο συνηθισμένος αλλά εξίσου σημαντικός τρόπος για τη δημιουργία ενσωματώσεων είναι μέσω χειροποίητων χαρακτηριστικών. Αντί να έχει ένα μοντέλο ML να μάθει τις σωστές αναπαραστάσεις για τα δεδομένα εισόδου, η καλή παλιά μηχανική χαρακτηριστικών μπορεί να λειτουργήσει για πολλές εφαρμογές επίσης. Ανεξάρτητα από τη βασική μέθοδο, οι ενσωματώσεις για σημασιολογικά παρόμοια αντικείμενα είναι κοντά η μια στην άλλη σε σχέση με την απόσταση, και αυτή η ιδιότητα είναι αυτή που δίνει τη δύναμη στις βάσεις δεδομένων διανυσμάτων.
Ποια είναι κάποια από τα πιο δημοφιλή παραδείγματα χρήσης αυτής της τεχνολογίας;
Οι βάσεις δεδομένων διανυσμάτων είναι ιδανικές για οποιαδήποτε εφαρμογή που απαιτεί κάποιο είδος σημασιολογικής αναζήτησης – συστάσεις προϊόντων, ανάλυση βίντεο, αναζήτηση εγγράφων, ανίχνευση απειλών και απάτης, και chatbots που βασίζονται σε AI είναι κάποια από τα πιο δημοφιλή παραδείγματα χρήσης για τις βάσεις δεδομένων διανυσμάτων σήμερα. Για να το εικονογραφήσω, η Milvus, η ανοιχτή βάση δεδομένων διανυσμάτων που δημιουργήθηκε από την Zilliz και το υποκείμενο πυρήνα της Zilliz Cloud, έχει χρησιμοποιηθεί από περισσότερους από χίλιους εταιρικούς χρήστες σε μια ποικιλία διαφορετικών παραδειγμάτων χρήσης.
Μου αρέσει πάντα να συζητάω αυτές τις εφαρμογές και να βοηθάω τους ανθρώπους να κατανοήσουν πώς λειτουργούν, αλλά σίγουρα απολαμβάνω επίσης να αναφέρω σε κάποια από τα λιγότερο γνωστά παραδείγματα χρήσης της βάσης δεδομένων διανυσμάτων. Η ανακάλυψη νέων φαρμάκων είναι ένα από τα αγαπημένα μου “νίς” παραδείγματα χρήσης της βάσης δεδομένων διανυσμάτων. Η πρόκληση για αυτήν την εφαρμογή είναι η αναζήτηση για πιθανές υποψήφιες ουσίες για την θεραπεία μιας συγκεκριμένης ασθένειας ή συμπτώματος μεταξύ μιας βάσης δεδομένων 800 εκατομμυρίων χημικών ενώσεων. Μια φαρμακευτική εταιρεία που επικοινωνήσαμε ήταν σε θέση να βελτιστοποιήσει σημαντικά τη διαδικασία ανακάλυψης φαρμάκων, καθώς και να μειώσει τους πόρους υλικού, συνδυάζοντας τη Milvus με μια βιβλιοθήκη χημειοπληροφορικής που ονομάζεται RDKit.
Το AI ArtLens του Μουσείου Τέχνης της Κλήβελαντ είναι ένα άλλο παράδειγμα που μου αρέσει να αναφέρω. Το AI ArtLens είναι ένα διαδραστικό εργαλείο που παίρνει μια εικόνα ερωτήματος ως εισόδου και τραβεί οπτικά παρόμοιες εικόνες από τη βάση δεδομένων του μουσείου. Αυτό συνήθως αναφέρεται ως αντίστροφη αναζήτηση εικόνων και είναι ένα αρκετά συνηθισμένο παράδειγμα χρήσης για τις βάσεις δεδομένων διανυσμάτων, αλλά η μοναδική αξία που παρέχει η Milvus στο CMA ήταν η ικανότητα να πάρει την εφαρμογή σε λειτουργία μέσα σε μια εβδομάδα με μια πολύ μικρή ομάδα.
Μπορείτε να συζητήσετε τι είναι η ανοιχτή πλατφόρμα Towhee;
Όταν επικοινωνούσαμε με ανθρώπους από την κοινότητα της Milvus, βρήκαμε ότι πολλοί από αυτούς ήθελαν να έχουν έναν ενιαίο τρόπο δημιουργίας ενσωματώσεων για τη Milvus. Αυτό ήταν αλήθεια για σχεδόν όλες τις διαφορετικές οργανώσεις που μιλήσαμε, αλλά ιδιαίτερα για τις εταιρείες που δεν είχαν πολλούς μηχανικούς ML. Με τη Towhee, στοχεύουμε να λύσουμε αυτό το κενό μέσω της “διαδικασίας ETL διανυσματικών δεδομένων”. Ενώ οι παραδοσιακές διαδικασίες ETL εστιάζουν στο συνδυασμό και τη μετατροπή δομημένων δεδομένων από πολλαπλά πηγές σε έναν μορφότυπο που μπορεί να χρησιμοποιηθεί, η Towhee προορίζεται για να εργαστεί με μη δομημένα δεδομένα και να περιλαμβάνει ρητά την ML στη διαδικασία ETL. Η Towhee επιτυγχάνει αυτό παρέχοντας εκατοντάδες μοντέλα, αλγόριθμους και μετασχηματισμούς που μπορούν να χρησιμοποιηθούν ως δομικά στοιχεία σε μια διαδικασία ETL διανυσματικών δεδομένων. Επιπλέον, η Towhee παρέχει επίσης μια εύχρηστη API Python που επιτρέπει στους προγραμματιστές να δημιουργήσουν και να δοκιμάσουν αυτές τις διαδικασίες ETL σε μια μόνη γραμμή κώδικα.
Ενώ η Towhee είναι ένα αυτόνομο έργο, είναι επίσης μέρος του ευρύτερου οικοσυστήματος βάσεων δεδομένων διανυσμάτων που επικεντρώνεται στη Milvus και δημιουργείται από την Zilliz. Ελπίζουμε ότι η Milvus και η Towhee θα είναι δύο έργα που συμπληρώνουν το ένα το άλλο, τα οποία, όταν χρησιμοποιούνται μαζί, μπορούν πραγματικά να δημοκρατικοποιήσουν την επεξεργασία μη δομημένων δεδομένων.
Η Zilliz πρόσφατα άντλησε 60 εκατομμύρια δολάρια σε γύρο Series B. Πώς θα επιταχύνει αυτό την αποστολή της;
Θα ήθελα πρώτα να ευχαριστήσω την Prosperity7 Ventures, Pavilion Capital, Hillhouse Capital, 5Y Capital, Yunqi Capital, και άλλους για την πίστη τους στην αποστολή της Zilliz και την υποστήριξή μας με αυτήν την επέκταση της σειράς B. Έχουμε τώρα συγκεντρώσει συνολικά 113 εκατομμύρια δολάρια, και αυτή η τελευταία γύρος χρηματοδότησης θα υποστηρίξει τις προσπάθειές μας να κλιμακωθούμε τις ομάδες μηχανικής και go-to-market. Συγκεκριμένα, θα βελτιώσουμε την διαχειριζόμενη cloud μας, η οποία είναιαυτή τη στιγμή σε πρώιμη πρόσβαση αλλά προγραμματισμένη να ανοίξει σε όλους αργότερα φέτος. Θα συνεχίσουμε επίσης να επενδύουμε σε πρωτοποριακή έρευνα βάσεων δεδομένων και AI, όπως έχουμε κάνει τα τελευταία 4 χρόνια.
Υπάρχει κάτι άλλο που θα ήθελε να μοιραστεί για την Zilliz;
Ως εταιρεία, μεγαλώνουμε γρήγορα, αλλά αυτό που πραγματικά διακρίνει την τρέχουσα ομάδα μας από άλλες εταιρείες στον χώρο βάσεων δεδομένων και ML είναι η μοναδική μας αγάπη για αυτό που χτίζουμε. Είμαστε σε μια αποστολή να δημοκρατικοποιήσουμε την επεξεργασία μη δομημένων δεδομένων, και είναι απίστευτα ενθαρρυντικό να βλέπω τόσο ταλαντούχους ανθρώπους στην Zilliz να εργάζονται προς ένα κοινό στόχο. Αν κάτι από αυτό που κάνουμε σας ενδιαφέρει, μην διστάσετε να συνδεθείτε μαζί μας. Θα ήμασταν χαρούμενοι να σας έχουμε στην ομάδα.
Εάν θέλετε να μάθετε λίγο περισσότερα, είμαι επίσης προσωπικά ανοιχτός στο να συζητήσω για την Zilliz, τις βάσεις δεδομένων διανυσμάτων ή τις εξελίξεις που σχετίζονται με ενσωματώσεις στην AI/ML. Η (μεταφορική) πόρτα μου είναι πάντα ανοιχτή, οπότε μην διστάσετε να με επικοινωνήσετε απευθείας στο Twitter/LinkedIn.
Τέλος, ευχαριστώ για την ανάγνωση!
Ευχαριστώ για τη μεγάλη συνέντευξη, οι αναγνώστες που θέλουν να μάθουν περισσότερα μπορούν να επισκεφθούν την Zilliz.



