
Andersons Blickwinkel
Wie sich Stable Diffusion zu einem Massenprodukt für Verbraucher entwickeln könnte

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Wichtige PunkteEine verbreitete Stable Diffusion-App muss ihre komplexen Kommandozeilen-Installationen…
Mehr anzeigen
- Eine verbreitete Stable Diffusion-App muss ihre komplexen Kommandozeilen-Installationen und Abhängigkeitsprobleme lösen.
- Kommerzielle Entwickler sehen sich rechtlichen Risiken durch Deepfake-Erzeugung und NSFW-Inhaltsfilter ausgesetzt.
- Fortgeschrittene Funktionen wie zeitliche Konsistenz und Textual Inversion erfordern cloudbasierte Verarbeitung für den Verbrauchereinsatz.
Ironischerweise ist Stable Diffusion, das neue KI-Bildsynthese-Framework, das die Welt im Sturm erobert hat, weder stabil noch wirklich weit verbreitet – zumindest noch nicht.
Die vollständige Bandbreite der Fähigkeiten des Systems ist auf eine Vielzahl von ständig mutierenden Angeboten von einer Handvoll Entwickler verteilt, die die neuesten Informationen und Theorien in verschiedenen Diskussionen auf Discord austauschen – und die meisten Installationsverfahren für die von ihnen erstellten oder modifizierten Pakete sind sehr weit von “plug and play” entfernt.
Stattdessen erfordern sie in der Regel eine Kommandozeilen- oder BAT-gesteuerte Installation über GIT, Conda, Python, Miniconda und andere hochmoderne Entwicklungsframeworks – Softwarepakete, die unter den allgemeinen Verbrauchern sehr selten sind, so dass ihre Installation häufig von Antivirus- und Anti-Malware-Anbietern als Beweis für ein kompromittiertes Host-System gekennzeichnet wird.

Nur eine kleine Auswahl der Stadien, die die Standard-Installation von Stable Diffusion derzeit erfordert. Viele der Distributionen erfordern auch spezifische Versionen von Python, die mit den auf dem Benutzergerät installierten Versionen in Konflikt geraten können – obwohl dies durch Docker-basierte Installationen und bis zu einem bestimmten Grad durch die Verwendung von Conda-Umgebungen vermieden werden kann.
Die Nachrichtenfäden in den SFW- und NSFW-Stable-Diffusion-Communities sind überfüllt mit Tipps und Tricks im Zusammenhang mit dem Hacken von Python-Skripten und Standardinstallationen, um eine verbesserte Funktionalität zu ermöglichen oder häufige Abhängigkeitsfehler und eine Reihe anderer Probleme zu lösen.
Dies lässt den durchschnittlichen Verbraucher, der an der Erstellung von außergewöhnlichen Bildern aus Textprompts interessiert ist, ziemlich der Gnade der wachsenden Zahl von kommerziellen API-Web-Schnittstellen ausgeliefert, die meisten davon bieten nur eine minimale Anzahl von kostenlosen Bildgenerierungen an, bevor sie den Kauf von Token erfordern.
Zusätzlich weigern sich fast alle dieser webbasierten Angebote, NSFW-Inhalte (die viel von nicht-pornografischen Themen allgemeinen Interesses wie “Krieg” umfassen können) auszugeben, was Stable Diffusion von den zensierten Diensten von OpenAI’s DALL-E 2 unterscheidet.
‘Photoshop für Stable Diffusion’
Von den fantastischen, gewagten oder außerweltlich wirkenden Bildern fasziniert, die täglich Twitters Hashtag #stablediffusion füllen, wartet die breite Öffentlichkeit auf ‘Photoshop für Stable Diffusion’ – eine plattformübergreifende installierbare Anwendung, die die besten und leistungsfähigsten Funktionen von Stability.ai’s Architektur sowie die verschiedenen genialen Innovationen der aufkommenden SD-Entwicklergemeinschaft umfasst, ohne aufpoppende Kommandozeilenfenster, unklare und ständig wechselnde Installations- und Update-Routinen oder fehlende Funktionen.
Was wir derzeit haben, ist in den meisten leistungsfähigen Installationen eine unterschiedlich aufwendig gestaltete Webseite neben einem separaten Kommandozeilenfenster, und deren URL ein localhost-Port ist:

Ähnlich wie CLI-gesteuerte Synthese-Apps wie FaceSwap und die BAT-zentrierte DeepFaceLab zeigt die ‘prepack’-Installation von Stable Diffusion ihre Kommandozeilenwurzeln, wobei die Schnittstelle über einen localhost-Port (siehe oberer Teil des Bildes) zugänglich ist, der mit der CLI-basierten Stable-Diffusion-Funktionalität kommuniziert.
Ohne Zweifel kommt eine benutzerfreundlichere Anwendung. Es gibt bereits mehrere Patreon-basierte integrierte Anwendungen, die heruntergeladen werden können, wie GRisk und NMKD (siehe Bild unten) – aber keine, die bisher den vollen Funktionsumfang bieten, den einige der fortschrittlicheren und weniger zugänglichen Implementierungen von Stable Diffusion anbieten können.

Frühe, Patreon-basierte Pakete von Stable Diffusion, erst teilweise zu vollständigen Apps ausgebaut. NMKD ist das erste, das die CLI-Ausgabe direkt in die GUI integriert.
Lassen Sie uns einen Blick darauf werfen, wie eine poliertere und integrierte Implementierung dieses erstaunlichen Open-Source-Wunders aussehen könnte – und welche Herausforderungen es möglicherweise zu bewältigen hat.
Rechtliche Überlegungen für eine vollständig finanzierte kommerzielle Stable-Diffusion-Anwendung
Der NSFW-Faktor
Der Stable-Diffusion-Quellcode wurde unter einer sehr permissiven Lizenz veröffentlicht, die kommerzielle Neuimplementierungen und abgeleitete Werke, die umfassend auf dem Quellcode aufbauen, nicht verbietet.
Neben der bereits erwähnten und wachsenden Zahl von Patreon-basierten Stable-Diffusion-Builds sowie der umfangreichen Anzahl von Anwendungs-Plugins, die für Figma, Krita, Photoshop, GIMP und Blender (unter anderen) entwickelt werden, gibt es keinen praktischen Grund, warum eine gut finanzierte Softwareentwicklungsfirma nicht eine viel anspruchsvollere und leistungsfähigere Stable-Diffusion-Anwendung entwickeln könnte. Aus marktorientierter Sicht gibt es jeden Grund zu der Annahme, dass mehrere solcher Initiativen bereits im Gange sind.
Hier stehen solche Bemühungen sofort vor dem Dilemma, ob die Anwendung, ähnlich wie die meisten Web-APIs für Stable Diffusion, das Abschalten des integrierten NSFW-Filters von Stable Diffusion (ein Fragment des Codes) erlaubt oder nicht.
‘Verstecken’ des NSFW-Schalters
Obwohl die offene Lizenz von Stability.ai für Stable Diffusion eine breit interpretierbare Liste von Anwendungen enthält, für die sie nicht verwendet werden darf (möglicherweise einschließlich pornografischen Inhalts und Deepfakes), ist die einzige Möglichkeit, wie ein Anbieter eine solche Nutzung wirksam verbieten könnte, indem er ihn in eine undurchsichtige ausführbare Datei statt in einen Parameter in einer Python-Datei kompiliert oder einen Prüfsummenvergleich auf die Python-Datei oder die DLL, die die NSFW-Anweisung enthält, erzwingt, sodass keine Bilder erzeugt werden können, wenn Benutzer diese Einstellung ändern.
Dies würde die Anwendung im Wesentlichen “entmannen”, ähnlich wie DALL-E 2 derzeit, und ihren kommerziellen Reiz verringern. Außerdem würden unweigerlich dekompilierte “veränderte” Versionen dieser Komponenten (entweder ursprüngliche Python-Laufzeit-Elemente oder kompilierte DLL-Dateien, wie sie in den Topaz-Linien von AI-Bildverbesserungstools verwendet werden) in der Torrent-/Hacker-Community auftauchen, um diese Einschränkungen aufzuheben, einfach indem sie die behindernden Elemente ersetzen und die Prüfsummenanforderungen negieren.
Am Ende kann der Anbieter sich entscheiden, einfach die Warnung von Stability.ai vor Missbrauch zu wiederholen, die den ersten Lauf vieler aktueller Stable-Diffusion-Distributionen kennzeichnet.
Jedoch haben die kleinen Open-Source-Entwickler, die derzeit solche Haftungsausschlüsse verwenden, wenig zu verlieren im Vergleich zu einem Software-Unternehmen, das erhebliche Zeit und Geld in die Erstellung einer vollständigen und benutzerfreundlichen Stable-Diffusion-Anwendung investiert hat – was eine tiefere Überlegung erfordert.
Deepfake-Haftung
Wie wir kürzlich festgestellt haben, enthält die LAION-Ästhetik-Datenbank, Teil der 4,2 Milliarden Bilder, auf denen die laufenden Modelle von Stable Diffusion trainiert wurden, eine große Anzahl von Prominentenbildern, wodurch Benutzer Deepfakes, einschließlich Deepfake-Pornos von Prominenten, effektiv erstellen können.

Aus unserem kürzlichen Artikel, vier Stadien von Jennifer Connelly über vier Jahrzehnte ihrer Karriere, abgeleitet aus Stable Diffusion.
Dies ist ein separates und umstritteneres Thema als die Erstellung von (in der Regel) legaler „abstrakter“ Pornografie, die keine “echten” Menschen darstellt (obwohl solche Bilder aus mehreren echten Fotos im Trainingsmaterial abgeleitet werden).
Da eine wachsende Anzahl von US-Bundesstaaten und Ländern Gesetze gegen Deepfake-Pornografie entwickelt oder erlassen hat, könnte die Fähigkeit von Stable Diffusion, Prominenten-Pornos zu erstellen, bedeuten, dass eine kommerzielle Anwendung, die nicht vollständig zensiert ist (d. h. die pornografische Materialien erstellen kann), möglicherweise eine Fähigkeit benötigt, wahrgenommene Prominentengesichter zu filtern.
Eine Methode wäre, eine integrierte “Schwarze Liste” von Begriffen bereitzustellen, die nicht in einem Benutzer-Prompt akzeptiert werden, in Bezug auf Prominentennamen und fiktive Charaktere, mit denen sie in Verbindung gebracht werden können. Vermutlich müssten solche Einstellungen in mehr Sprachen als nur Englisch implementiert werden, da die ursprünglichen Daten andere Sprachen aufweisen. Ein anderer Ansatz wäre die Einbindung von Systemen zur Erkennung von Prominenten, wie sie etwa Clarifai entwickelt.
Es kann notwendig sein, dass Softwarehersteller solche Methoden implementieren, möglicherweise zunächst deaktiviert, um zu verhindern, dass eine vollständige Stable-Diffusion-Anwendung Prominentengesichter erstellt, in Erwartung neuer Gesetze, die eine solche Funktionalität illegal machen könnten.
Wiederum jedoch könnte eine solche Funktionalität unweigerlich dekompiliert und umgekehrt werden, durch interessierte Dritte; jedoch könnte der Softwarehersteller in einem solchen Fall behaupten, dass dies effektiv nicht genehmigter Vandalismus ist – solange diese Art der Reverse-Engineering nicht übermäßig erleichtert wird.
Funktionen, die enthalten sein könnten
Die Kernfunktionen in jeder Verteilung von Stable Diffusion würden von jeder gut finanzierten kommerziellen Anwendung erwartet. Dazu gehören die Fähigkeit, Textprompts zu verwenden, um geeignete Bilder zu generieren (Text-Bild); die Fähigkeit, Skizzen oder andere Bilder als Richtlinien für neue generierte Bilder zu verwenden (Bild-Bild); die Möglichkeit, die “Kreativität” des Systems anzupassen; eine Möglichkeit, die Renderzeit gegen die Qualität abzuwägen; und andere “Grundfunktionen”, wie optionaler automatischer Bild-/Prompt-Archivierung und optionaler Routine-Vergrößerung über RealESRGAN sowie grundlegende “Gesichtsreparatur” mit GFPGAN oder CodeFormer.
Das ist eine ziemlich Standardinstallation. Lassen Sie uns einige der fortgeschritteneren Funktionen betrachten, die derzeit entwickelt oder erweitert werden und die in eine vollständige “traditionelle” Stable-Diffusion-Anwendung integriert werden könnten.
Stochastisches Einfrieren
Selbst wenn Sie einen Seed von einem erfolgreichen Rendern wiederverwenden, ist es furchtbar schwierig, Stable Diffusion dazu zu bringen, eine Transformation genau zu wiederholen, wenn irgendein Teil des Prompts oder des Quellbildes (oder beides) für einen nachfolgenden Rendervorgang geändert wird.
Dies ist ein Problem, wenn Sie EbSynth verwenden möchten, um Stable-Diffusion-Transformationen auf echte Videos in einer zeitlich kohärenten Weise aufzuprägen – obwohl die Technik sehr effektiv für einfache Kopf-und-Schulter-Aufnahmen sein kann:
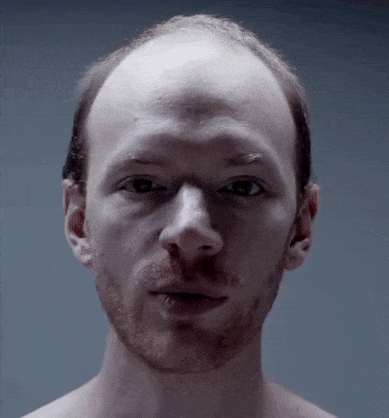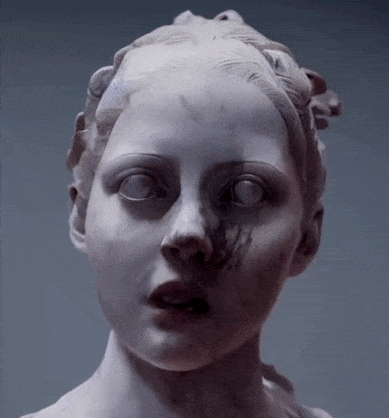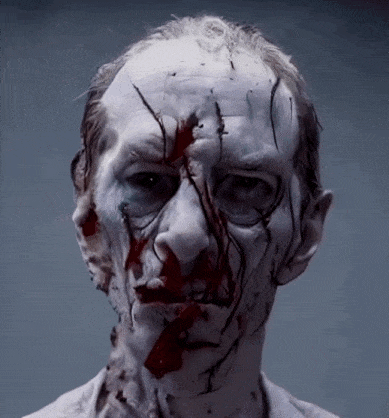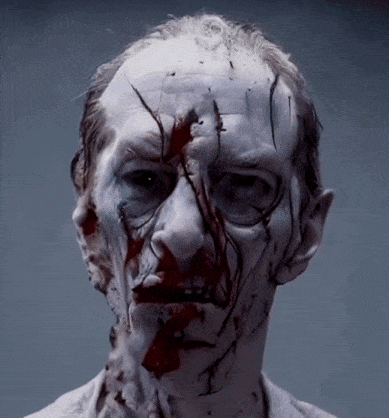
Begrenzte Bewegung kann EbSynth zu einem effektiven Medium machen, um Stable-Diffusion-Transformationen in realistische Videos umzuwandeln. Quelle: https://streamable.com/u0pgzd
EbSynth funktioniert, indem es eine kleine Auswahl von “veränderten” Schlüsselbildern in ein Video extrapoliert, das in eine Reihe von Bilddateien gerendert und später wieder in ein Video zusammengesetzt werden kann.

In diesem Beispiel von der EbSynth-Website wurden ein paar Frames aus einem Video in künstlerischer Weise bemalt. EbSynth verwendet diese Frames als Stilführer, um das gesamte Video so zu verändern, dass es dem gemalten Stil entspricht. Quelle: https://www.youtube.com/embed/eghGQtQhY38
Im folgenden Beispiel, das fast keine Bewegung von der (echten) blonden Yoga-Lehrerin auf der linken Seite aufweist, hat Stable Diffusion dennoch Schwierigkeiten, ein konsistentes Gesicht beizubehalten, da die drei als “Schlüsselbilder” transformierten Bilder nicht vollständig identisch sind, obwohl sie alle den gleichen numerischen Seed teilen.

Hier, selbst mit dem gleichen Prompt und Seed für alle drei Transformationen und sehr wenigen Änderungen zwischen den Quellbildern, variieren die Körpermuskeln in Größe und Form, aber wichtiger ist, dass das Gesicht inkonsistent ist, was die zeitliche Konsistenz in einem potenziellen EbSynth-Render behindert.
Obwohl das SD/EbSynth-Video unten sehr erfinderisch ist, wo die Finger des Benutzers in (jeweils) eine laufende Hose und eine Ente verwandelt werden, typifiziert die Inkonsistenz der Hose das Problem, das Stable Diffusion bei der Aufrechterhaltung der Konsistenz über verschiedene Schlüsselbilder hinweg hat, selbst wenn die Quellbilder ähnlich sind und der Seed konsistent ist.
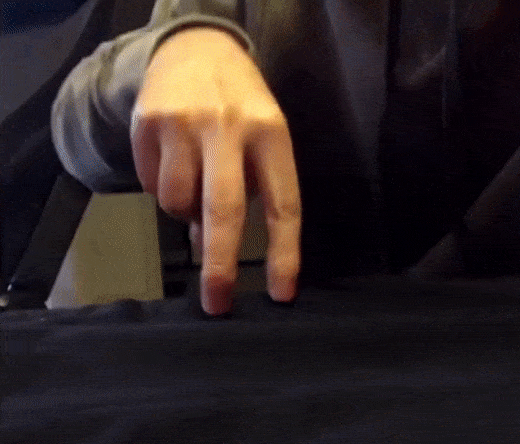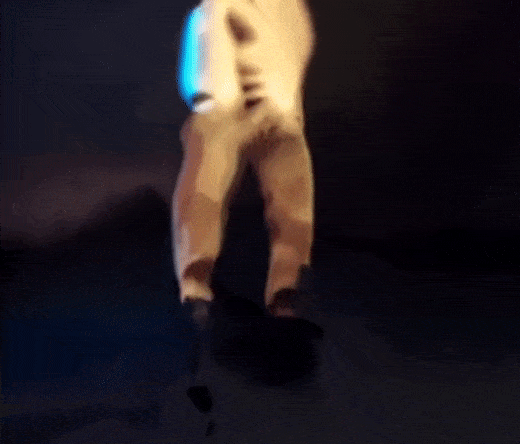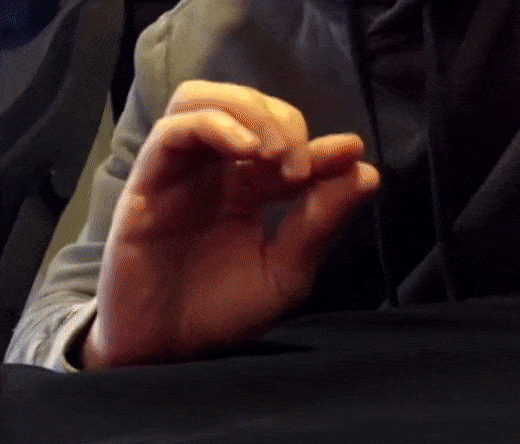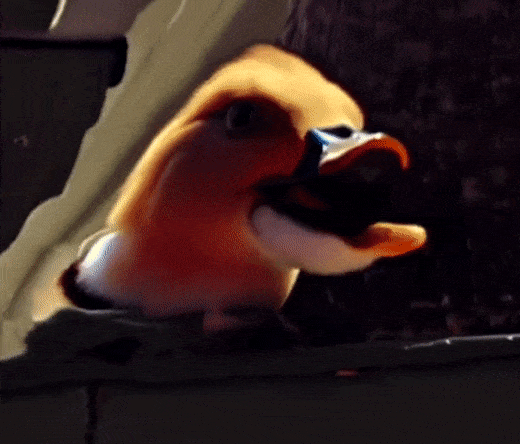
Die Finger eines Mannes werden zu einem gehenden Mann und einer Ente, über Stable Diffusion und EbSynth. Quelle: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
Der Benutzer, der dieses Video erstellte, kommentierte, dass die Ente-Transformation, die wohl die effektivere der beiden ist, wenn auch weniger eindrucksvoll und originell, nur ein transformiertes Schlüsselbild erforderte, während es notwendig war, 50 Stable-Diffusion-Bilder zu rendern, um die laufende Hose zu erstellen, die mehr zeitliche Inkonsistenz aufweist. Der Benutzer fügte auch hinzu, dass es fünf Versuche erforderte, um Konsistenz für jedes der 50 Schlüsselbilder zu erreichen.
Daher wäre es ein großer Vorteil für eine umfassende Stable-Diffusion-Anwendung, eine Funktionalität bereitzustellen, die Merkmale über Schlüsselbilder hinweg maximal beibehält.
Eine Möglichkeit besteht darin, die Anwendung so zu gestalten, dass der Benutzer die stochastische Kodierung für die Transformation auf jedem Frame “einfrieren” kann, was derzeit nur durch manuelle Änderung des Quellcodes erreicht werden kann. Wie das folgende Beispiel zeigt, hilft dies der zeitlichen Konsistenz, obwohl es sie nicht vollständig löst:
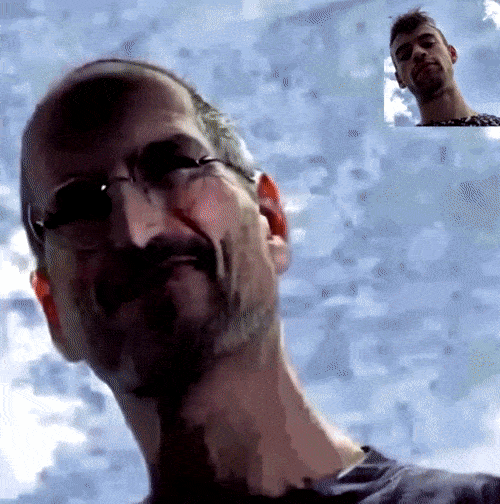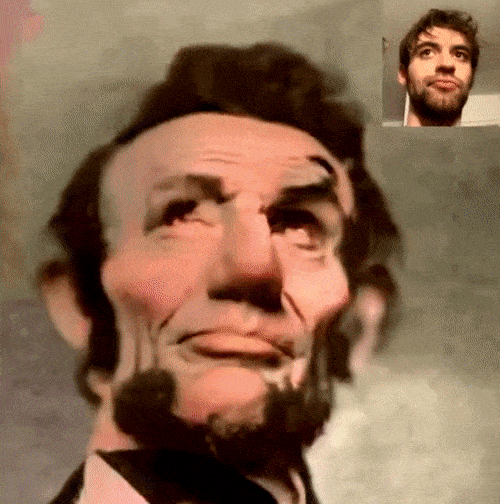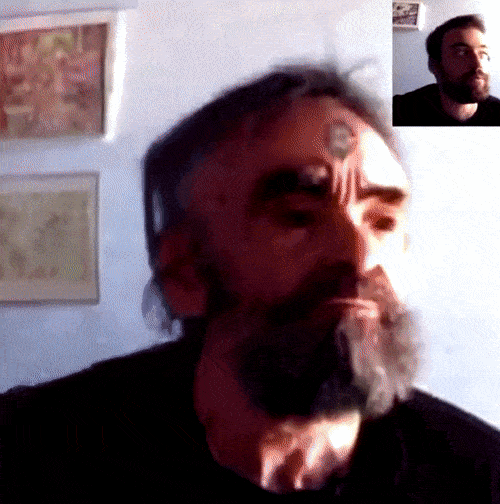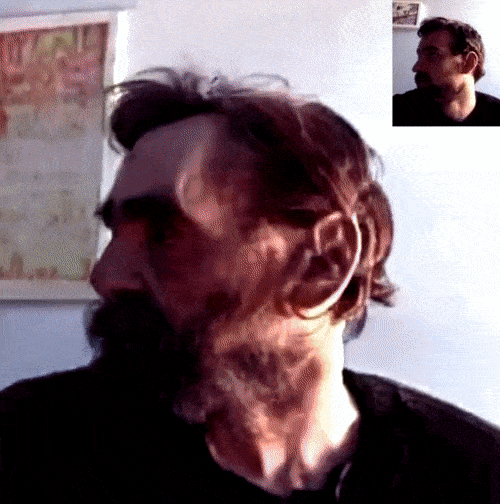
Ein Reddit-Benutzer transformierte Webcam-Aufnahmen von sich selbst in verschiedene berühmte Menschen, indem er nicht nur den Seed beibehielt (was jede Stable-Diffusion-Implementierung kann), sondern auch sicherstellte, dass der stochastic_encode()-Parameter in jeder Transformation identisch war. Dies wurde durch Änderung des Codes erreicht, könnte aber leicht zu einem für Benutzer zugänglichen Schalter werden. Offensichtlich löst es jedoch nicht alle zeitlichen Probleme. Quelle: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Cloud-basierte Textuelle Inversion
Eine bessere Lösung für die Erzielung zeitlich konsistenter Charaktere und Objekte besteht darin, sie in eine Textuelle Inversion einzubetten – eine 5-KB-Datei, die in wenigen Stunden auf der Grundlage von nur fünf annotierten Bildern trainiert werden kann, die dann durch ein spezielles ‘*’-Prompt abgerufen werden kann, wodurch beispielsweise die persistente Erscheinung neuer Charaktere in einer Erzählung ermöglicht wird.

Bilder, die mit geeigneten Tags verknüpft sind, können in separate Entitäten über eine Textuelle Inversion umgewandelt werden und ohne Ambiguität und im richtigen Kontext und Stil durch spezielle Token-Wörter abgerufen werden. Quelle: https://huggingface.co/docs/diffusers/training/text_inversion
Textuelle Inversionen sind Zusatzdateien zum sehr großen und vollständig trainierten Modell, das Stable Diffusion verwendet, und werden effektiv in den Abruf-/Prompt-Prozess “eingeschleust”, so dass sie an vom Modell erzeugten Szenen teilnehmen und von der enormen Datenbank des Modells über Objekte, Stile, Umgebungen und Interaktionen profitieren können.
Es ist jedoch zu beachten, dass eine Textuelle Inversion nicht lange dauert, um zu trainieren, aber eine große Menge an VRAM erfordert; laut verschiedenen aktuellen Anleitungen 12, 20 und sogar 40 GB.
Da die meisten Benutzer wahrscheinlich nicht über diese Art von GPU-Leistung verfügen, entstehen bereits Cloud-Dienste, die den Vorgang übernehmen, einschließlich einer Hugging-Face-Version. Obwohl es Google-Colab-Implementierungen gibt, die Textuelle Inversionen für Stable Diffusion erstellen können, können die erforderlichen VRAM- und Zeitanforderungen diese für kostenlose Colab-Benutzer herausfordernd machen.
Für eine potenzielle vollständige und gut finanzierte Stable-Diffusion-Anwendung (installiert) scheint es eine offensichtliche Monetarisierungsstrategie zu sein, diesen ressourcenintensiven Vorgang an die Cloud-Server des Unternehmens weiterzuleiten (unter der Annahme, dass eine kostenlose oder kostengünstige Stable-Diffusion-Anwendung mit solchen nicht kostenlosen Funktionen durchsetzt ist, was in vielen Anwendungen, die aus dieser Technologie in den nächsten 6-9 Monaten entstehen, wahrscheinlich der Fall sein wird).
Zusätzlich könnte der ziemlich komplizierte Prozess der Annotation und Formatierung der eingereichten Bilder und Texte von einer Automatisierung in einer integrierten Umgebung profitieren. Der potenzielle “Suchtfaktor” der Erstellung einzigartiger Elemente, die die weiten Welten von Stable Diffusion erkunden und mit ihnen interagieren können, wäre sowohl für allgemeine Enthusiasten als auch für jüngere Benutzer möglicherweise sehr überzeugend.
Vielseitige Prompt-Gewichtung
Es gibt viele aktuelle Implementierungen, die es dem Benutzer ermöglichen, größeren Nachdruck auf einen Abschnitt eines langen Textprompts zu legen, aber die Bedienung variiert stark zwischen diesen und ist häufig ungeschickt oder unintuitiv.
Die sehr beliebte Stable-Diffusion-Abspaltung von AUTOMATIC1111 kann beispielsweise den Wert eines Prompt-Worts durch Einschließen in eine oder mehrere runde Klammern (zur Abschwächung) oder eckige Klammern für Extra-Betonung senken oder heben.

Eckige Klammern und/oder Klammern können Ihr Frühstück in dieser Version von Stable-Diffusion-Prompt-Gewichten transformieren, aber es ist in jedem Fall ein Cholesterin-Albtraum.
Andere Iterationen von Stable Diffusion verwenden Ausrufezeichen für Betonung, während die vielseitigsten es den Benutzern ermöglichen, Gewichte für jedes Wort im Prompt über die Benutzeroberfläche zuzuweisen.
Das System sollte auch negative Prompt-Gewichte zulassen – nicht nur für Horror-Fans, sondern weil es möglicherweise weniger alarmierende und mehr aufschlussreiche Geheimnisse in Stable Diffusions latentem Raum gibt, als unsere begrenzte Verwendung von Sprache heraufbeschwören kann.
Outpainting
Kurz nach der sensationellen Open-Sourcing von Stable Diffusion versuchte OpenAI, größtenteils vergeblich, ein wenig der verlorenen Aufmerksamkeit für DALL-E 2 zurückzugewinnen, indem es “Outpainting” ankündigte, das es dem Benutzer ermöglicht, ein Bild über seine Grenzen hinaus mit semantischer Logik und visueller Kohärenz zu erweitern.
Natürlich wurde dies seitdem in verschiedenen Formen für Stable Diffusion implementiert, sowie in Krita und sollte sicherlich in einer umfassenden, Photoshop-ähnlichen Version von Stable Diffusion enthalten sein.
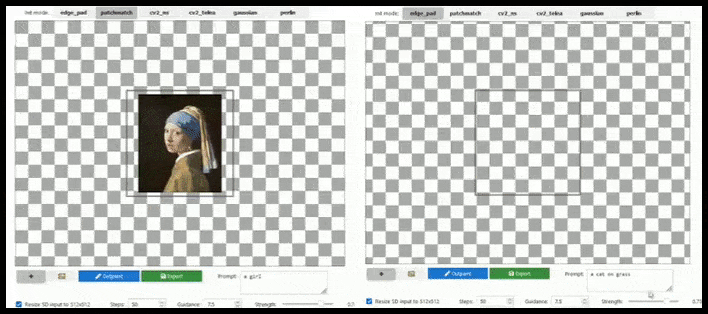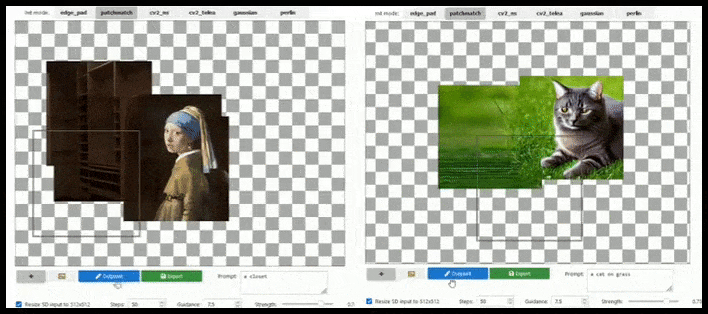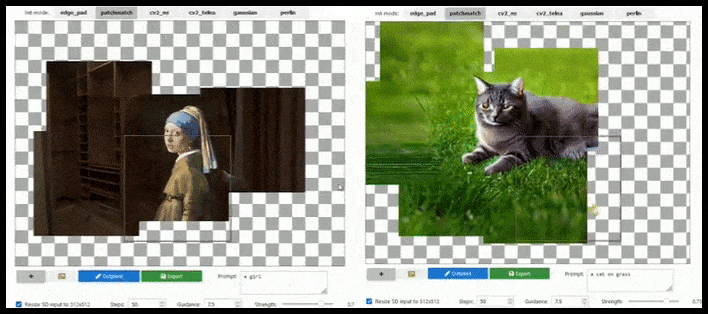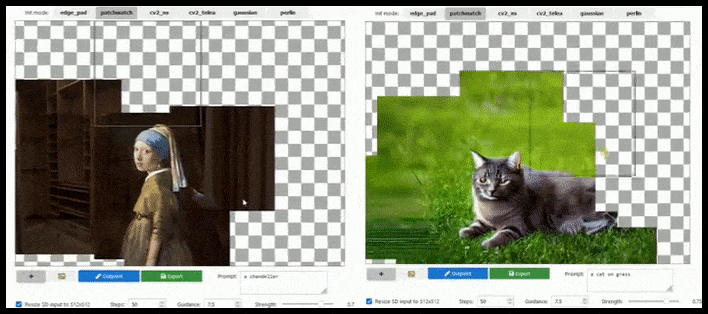
Kachelbasierte Erweiterung kann ein Standard-512×512-Render fast endlos erweitern, solange die Prompts, das vorhandene Bild und die semantische Logik es zulassen. Quelle: https://github.com/lkwq007/stablediffusion-infinity
Da Stable Diffusion auf 512x512px-Bildern trainiert wird (und aus einer Vielzahl von anderen Gründen), schneidet es häufig die Köpfe (oder andere wesentliche Körperteile) von menschlichen Subjekten ab, selbst wenn der Prompt eindeutig “Kopfbetonung” usw. angibt.

Typische Beispiele für Stable-Diffusion-“Enthauptung”; aber Outpainting könnte George wieder ins Bild bringen.
Jede Outpainting-Implementierung der in der animierten Abbildung oben dargestellten Art (die ausschließlich auf Unix-Bibliotheken basiert, aber unter Windows nachgebildet werden können sollte) sollte auch als ein-Klick-/Prompt-Wiederherstellungsverfahren für dieses Problem dienen.
Derzeit erweitern einige Benutzer die Leinwand von “enthaupteten” Darstellungen nach oben, füllen die Kopfregion ungefähr aus und verwenden img2img, um den fehlerhaften Render abzuschließen.
Effektives Maskieren, das Kontext versteht
Maskieren kann in Stable Diffusion eine sehr unzuverlässige Angelegenheit sein, abhängig von der verwendeten Abspaltung oder Version. Häufig endet die angegebene Fläche, wenn es möglich ist, eine kohärente Maske zu zeichnen, mit Inhalt, der den gesamten Kontext des Bildes nicht berücksichtigt.
Bei einer Gelegenheit maskierte ich die Hornhäute der Augen auf einem Gesichtsbild aus und gab den Prompt ‘blaue Augen’ als Maske ein, um nur zu entdecken, dass ich durch zwei ausgeschnittene menschliche Augen auf ein fernes Bild eines unheimlich aussehenden Wolfes schaute. Ich denke, ich bin froh, dass es nicht Frank Sinatra war.
Semantische Bearbeitung ist auch möglich, indem das Rauschen identifiziert wird, das das Bild ursprünglich konstruierte, was es dem Benutzer ermöglicht, spezifische strukturelle Elemente in einem Render anzusprechen, ohne den Rest des Bildes zu stören:

Ändern eines Elements in einem Bild, ohne traditionelles Maskieren und ohne Änderung des benachbarten Inhalts, indem das Rauschen identifiziert wird, das das Bild ursprünglich erzeugte, und die Teile davon angesprochen werden, die zum Zielbereich beigetragen haben. Quelle: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Diese Methode basiert auf dem K-Diffusion-Sampler.
Semantische Filter für physiologische Fehler
Wie wir bereits erwähnt haben, kann Stable Diffusion häufig Gliedmaßen hinzufügen oder entfernen, größtenteils aufgrund von Datenproblemen und Mängeln in den Annotationen, die die Bilder begleiten, die es trainiert haben.

Genau wie das unartige Kind, das seine Zunge in dem Schulgruppenfoto rausstreckte, sind Stable Diffusions biologische Gräueltaten nicht immer sofort offensichtlich, und Sie könnten Ihr neuestes AI-Meisterwerk auf Instagram geteilt haben, bevor Sie die zusätzlichen Hände oder geschmolzenen Gliedmaßen bemerken.
Es ist so schwierig, diese Arten von Fehlern zu beheben, dass es nützlich wäre, wenn eine vollständige Stable-Diffusion-Anwendung ein anatomisches Erkennungssystem enthielte, das semantische Segmentierung verwendet, um zu berechnen, ob das eingehende Bild schwere anatomische Mängel aufweist (wie im Bild oben), und es gegen einen neuen Render austauscht, bevor es dem Benutzer präsentiert.

Natürlich möchten Sie möglicherweise die Göttin Kali, Doctor Octopus oder sogar einen unversehrten Teil eines Bildes mit fehlerhaften Gliedmaßen retten, sodass diese Funktion als optionaler Schalter dienen sollte.
Wenn Benutzer den Telemetrie-Aspekt tolerieren könnten, könnten solche Fehlschüsse sogar anonym in einem kollektiven Bemühen um federatives Lernen übertragen werden, das möglicherweise dazu beitragen könnte, zukünftige Modelle in ihrem Verständnis der anatomischen Logik zu verbessern.
LAION-basierte automatische Gesichtsverbesserung
Wie ich in meinem früheren Blick auf drei Dinge, die Stable Diffusion in Zukunft angehen könnte, festgestellt habe, sollte es nicht allein bei einer Version von GFPGAN bleiben, die versucht, zuerst erzeugte Gesichter zu “verbessern”.
GFPGANs “Verbesserungen” sind furchtbar generisch, untergraben häufig die Identität der dargestellten Person und funktionieren ausschließlich auf einem Gesicht, das meist bereits schlecht erzeugt wurde, weil es nicht mehr Verarbeitungszeit oder Aufmerksamkeit erhalten hat als jeder andere Bildteil.
Daher sollte ein Programm auf professionellem Niveau für Stable Diffusion in der Lage sein, ein Gesicht zu erkennen (mit einer Standard- und relativ leichten Bibliothek wie YOLO), die volle Leistung der verfügbaren GPU zu nutzen, um es neu zu rendern, und das verbesserte Gesicht entweder in den ursprünglichen Kontext-Render einblenden oder es separat für manuelle Neukomposition speichern. Derzeit ist dies ein ziemlich “hands-on”-Vorgang.
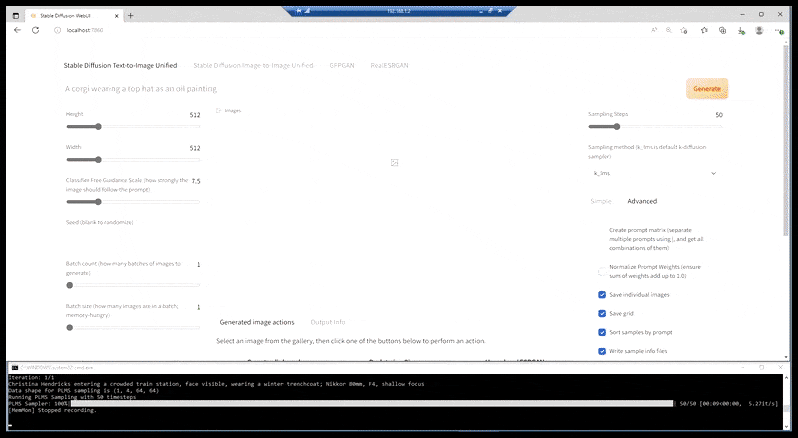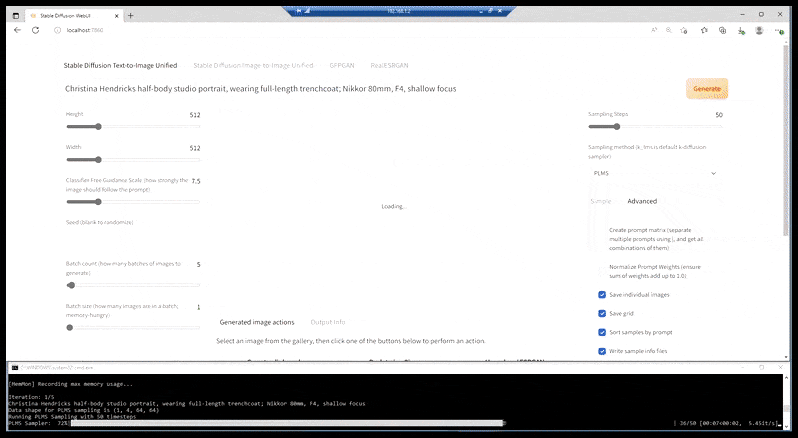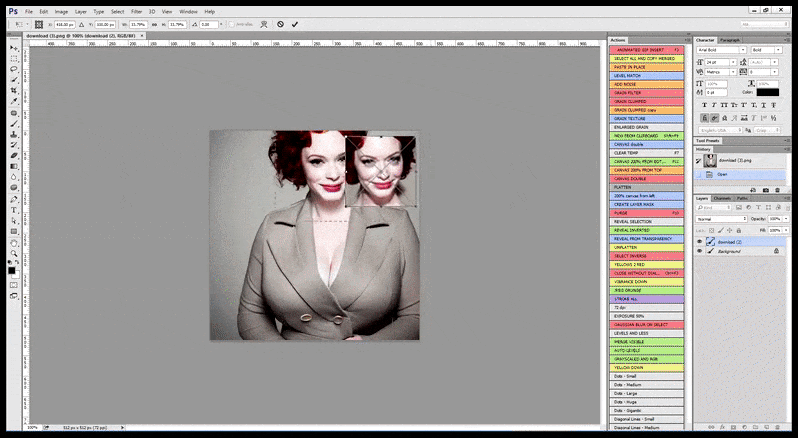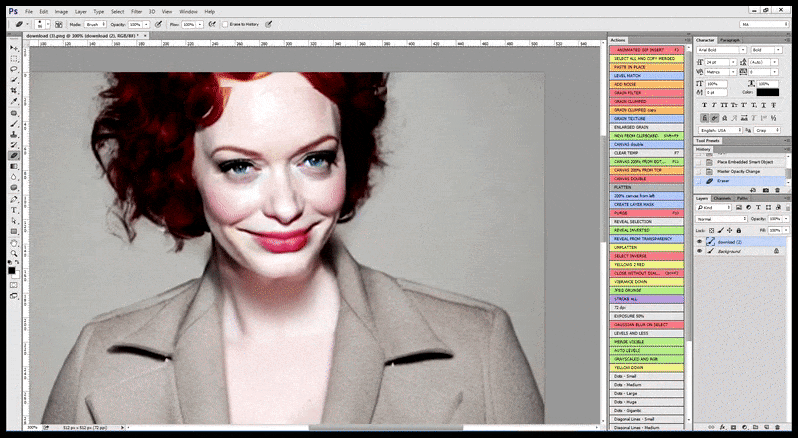
In Fällen, in denen Stable Diffusion auf einer angemessenen Anzahl von Bildern einer Prominenten trainiert wurde, ist es möglich, die gesamte GPU-Kapazität auf eine nachfolgende Renderung allein des Gesichts des gerenderten Bildes zu konzentrieren, was normalerweise eine bemerkenswerte Verbesserung ist – und im Gegensatz zu GFPGAN auf Informationen aus LAION-trainierten Daten und nicht nur auf die Anpassung der gerenderten Pixel zurückgreift.
In-App-LAION-Suchen
Seit Benutzer begannen, zu erkennen, dass die Suche in LAIONs Datenbank nach Konzepten, Personen und Themen eine Hilfe für die bessere Verwendung von Stable Diffusion sein könnte, wurden mehrere Online-LAION-Explorer erstellt, einschließlich haveibeentrained.com.

Die Suchfunktion bei haveibeentrained.com ermöglicht es Benutzern, die Bilder zu erkunden, die Stable Diffusion antreiben, und zu entdecken, ob Objekte, Personen oder Ideen, die sie möglicherweise aus dem System heraufbeschwören möchten, wahrscheinlich in es trainiert wurden. Solche Systeme sind auch nützlich, um benachbarte Entitäten zu entdecken, wie Prominente gruppiert sind oder die “nächste Idee”, die auf die aktuelle folgt. Quelle: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Obwohl solche webbasierten Datenbanken oft einige der Tags anzeigen, die die Bilder begleiten, bedeutet der Prozess der Verallgemeinerung, der während des Modelltrainings stattfindet, dass es unwahrscheinlich ist, dass ein bestimmtes Bild durch die Verwendung seines Tags als Prompt abgerufen werden kann.
Zusätzlich bedeutet die Entfernung von ‘Stoppwörtern’ und die Praxis des Stemming und Lemmatisierung in der natürlichen Sprachverarbeitung, dass viele der Phrasen, die in diesen Schnittstellen angezeigt werden, aufgeteilt oder weggelassen wurden, bevor sie in Stable Diffusion trainiert wurden.
Trotzdem kann die Art und Weise, wie ästhetische Gruppierungen in diesen Schnittstellen zusammenhängen, dem Endbenutzer viel über die Logik (oder die “Persönlichkeit”) von Stable Diffusion beibringen und eine Hilfe für die bessere Bildproduktion sein.
Schlussfolgerung
Es gibt viele andere Funktionen, die ich mir in einer vollständigen nativen Desktop-Implementierung von Stable Diffusion wünschen würde, wie native CLIP-basierte Bildanalyse, die den Standard-Stable-Diffusion-Prozess umkehrt und es dem Benutzer ermöglicht, Phrasen und Wörter abzurufen, die das System normalerweise mit dem Quellbild verbinden würde, oder das Render.
Zusätzlich wäre echte kachelbasierte Skalierung eine willkommene Ergänzung, da ESRGAN fast so ungeschickt ist wie GFPGAN. Glücklicherweise machen Pläne, die txt2imghd-Implementierung von GOBIG zu integrieren, dies schnell zu einer Realität über die Verteilungen hinweg, und es scheint eine offensichtliche Wahl für eine Desktop-Iteration.
Einige andere beliebte Anfragen aus den Discord-Communities interessieren mich weniger, wie integrierte Prompt-Wörterbücher und anwendbare Listen von Künstlern und Stilen, obwohl ein Notebook oder ein anpassbares Lexikon von Phrasen in der App eine logische Ergänzung wäre.
Ähnlich bleibt die aktuelle Einschränkung der menschlichen Animation in Stable Diffusion, obwohl sie durch CogVideo und verschiedene andere Projekte gestartet wurde, unglaublich im Entstehen und der Gnade von Upstream-Forschung in zeitlichen Vorannahmen im Zusammenhang mit authentischer menschlicher Bewegung ausgeliefert.
Für den Moment ist Stable-Diffusion-Video streng psychedelisch, obwohl es möglicherweise eine viel hellere nahe Zukunft bei der Steuerung von Deepfake-Figuren hat, über EbSynth und andere relativ neue Text-zu-Video-Initiativen (und es ist erwähnenswert, dass es im neuesten Werbevideo von Runway keine synthetisierten oder “veränderten” Menschen gibt).
Eine weitere wertvolle Funktionalität wäre ein nahtloser Bildaustausch mit Photoshop, die bereits in Cinema4Ds Textureditor und anderen ähnlichen Implementierungen etabliert ist. Damit kann man Bilder zwischen Anwendungen leicht umleiten und jede Anwendung verwenden, um die Transformationen durchzuführen, die sie am besten kann.
Schließlich und vielleicht am wichtigsten sollte ein vollständiges Desktop-Stable-Diffusion-Programm in der Lage sein, nicht nur leicht zwischen Checkpoints (d. h. Versionen des zugrunde liegenden Modells, das das System antreibt) zu wechseln, sondern auch benutzerdefinierte Textuelle Inversionen zu aktualisieren, die mit früheren offiziellen Modellversionen funktionierten, die ansonsten durch spätere Versionen des Modells gebrochen werden könnten (wie Entwickler im offiziellen Discord angegeben haben).
Ironischerweise hat sich Adobe, die Organisation mit den besten Voraussetzungen für ein solches leistungsfähiges und integriertes Werkzeug-Set für Stable Diffusion, so stark der Content-Authenticity-Initiative verschrieben, dass es ein rückwärtsgewandter PR-Schritt für das Unternehmen scheinen könnte – es sei denn, es würde Stable Diffusions generative Kräfte so gründlich behindern, wie OpenAI es mit DALL-E 2 getan hat, und es stattdessen als natürliche Evolution seiner erheblichen Beteiligungen an Stockfotografie positionieren.
Erstveröffentlicht am 15. September 2022.


