
Andersons vinkel
Neuralt rendering: Hvad er det laveste niveau af input, der kan bruges?

 Føj Unite.AI til dine foretrukne kilder på Google

I går fik nyt arbejde inden for neuralt billedsyn opmærksomhed og fantasi fra internettet, da Intel (INTC ) -forskere afslørede en ny metode til at forbedre realisme i syntetiske billeder.
Systemet, som demonstreres i en video fra Intel, griber direkte ind i billedpipeline for videospillet Grand Theft Auto V og forbedrer automatisk billederne gennem en billedsynsalgoritme trænet på en convolutional neuralt netværk (CNN), ved hjælp af virkelige billeder fra Mapillary-datasettet og udskifter mindre realistiske lys- og teksturering fra GTA-spilmotoren.
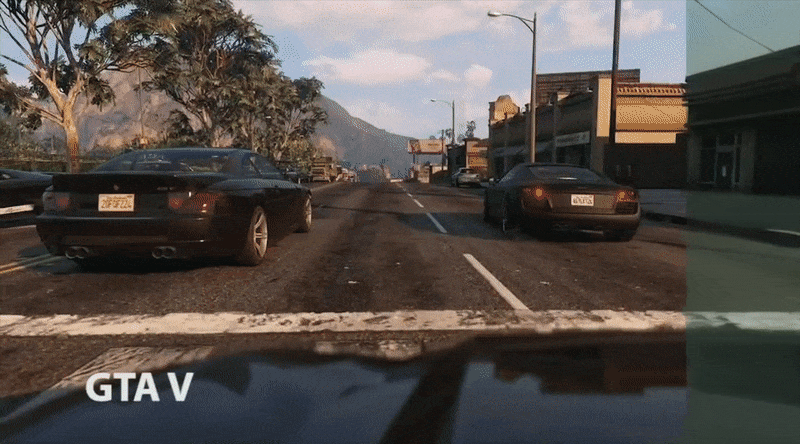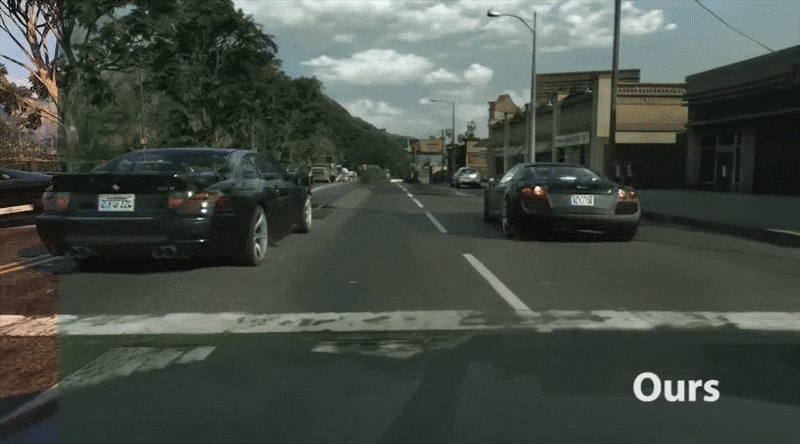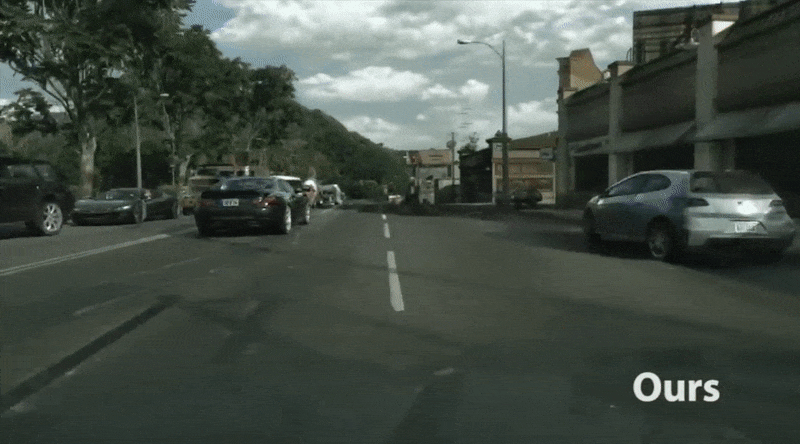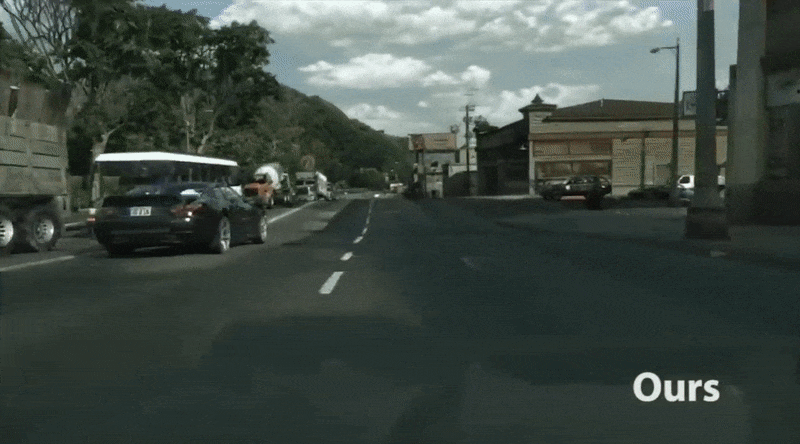
Kommentarerne, i en bred vifte af reaktioner i fællesskaber som Reddit og Hacker News, stiller ikke kun spørgsmål om, hvorvidt neuralt rendering af denne type kunne erstatter mindre fotorealistiske output fra traditionelle spilmotorer og VFX-niveau CGI, men også om dette kunne opnås med langt mere basis-input end det, der blev demonstreret i Intel GTA5-demonstrationen – effektivt skabende ‘dukke’-proxy-input med massivt realistiske output.
Parret datasets
Princippet er blevet eksemplificeret af en ny generation af GAN og encoder/decoder-systemer over de sidste tre år, såsom NVIDIA’s GauGAN, som genererer fotorealistiske landskabsbilleder fra grove skitser.

Effektivt flipper denne princip den konventionelle brug af semantisk segmentering i computer vision fra en passiv metode, der tillader maskinsystemer at identificere og isolere observerede objekter, til en kreativ input, hvor brugeren ‘maler’ en falsk semantisk segmenteringskort og systemet genererer billeder, der er konsistente med relationerne, det forstår fra at have klassificeret og segmenteret et bestemt domæne, såsom landskab.

En maskinlæringsramme anvender semantisk segmentering til forskellige ydre scener, og giver den arkitektoniske paradigme, der tillader udviklingen af interaktive systemer, hvor brugeren maler en semantisk segmenteringsblok, og systemet udfylder blokken med passende billeder fra et domænespecifikt dataset, såsom Tysklands Mapillary-gadesynsæt, brugt i Intels GTA5-neuralt renderingsdemo. Kilde: http://ais.informatik.uni-freiburg.de/publications/papers/valada17icra.pdf
Parret dataset billedsynssystemer arbejder ved at korrelere semantiske mærker på to datasets: et rigt og fuldt udviklet billedsæt, enten genereret fra virkelige billeder (såsom Mapillary-sættet, der bruges til at forbedre GTA5 i Intels demo i går) eller fra syntetiske billeder, såsom CGI-billeder.

Parret dataset eksempler til et billedsynssystem designet til at skabe neuralt-renderede karakterer fra klodsede skitser. Til venstre, eksempler fra CGI-datasettet. Midten, tilsvarende eksempler fra ‘skitse’-datasettet. Højre, neuralt-renderede billeder, der har oversat skitser tilbage til højkvalitetsbilleder. Kilde: https://www.youtube.com/watch?v=miLIwQ7yPkA
Ydre miljøer er relativt ukomplicerede, når det kommer til at skabe parret dataset-transformationer af denne type, fordi fremspring normalt er ret begrænsede, topografien har en begrænsende variation, der kan indfanges i et dataset, og vi behøver ikke at skabe kunstige mennesker eller forhandle den Uncanny Valley (endnu).
Invertering af segmenteringskort
Google har udviklet en animeret version af GauGAN-skemaet, kaldet Infinite Nature, der kan bevidst ‘hallucinere’ kontinuert og uendelige fiktive landskaber ved at oversætte falske semantiske kort til fotorealistiske billeder via NVIDIA’s SPADE-infill-system:
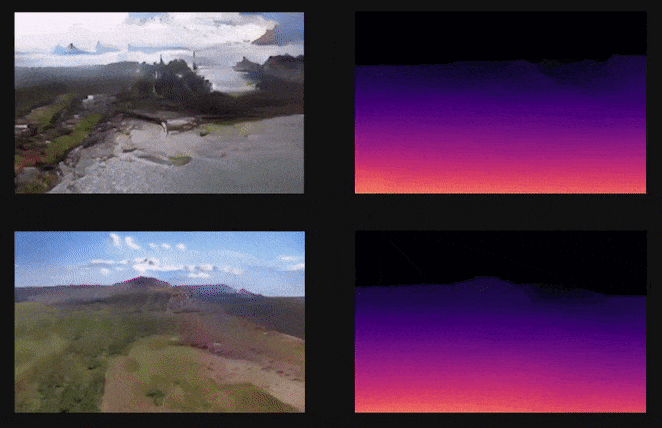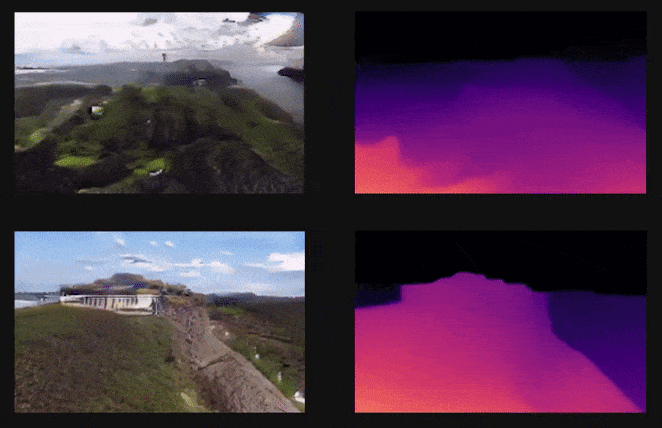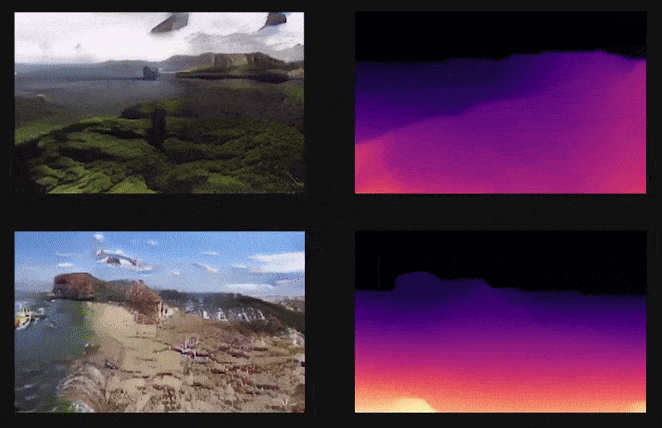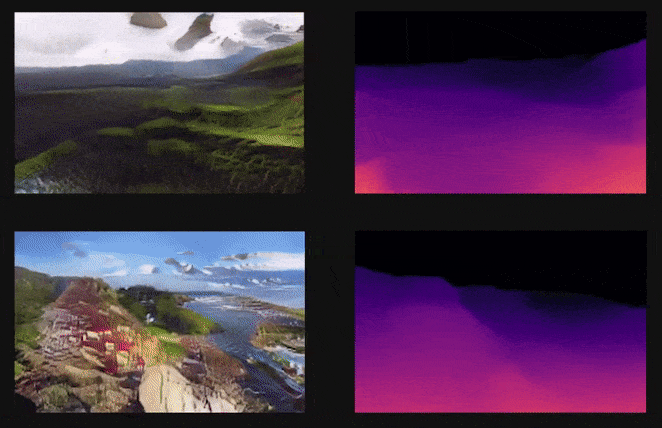
Kilde: https://www.youtube.com/watch?v=oXUf6anNAtc
Men Infinite Nature bruger et enkelt billede som udgangspunkt og bruger kun SPADE til at male i de manglende sektioner i efterfølgende billeder, hvorimod SPADE selv skaber billedtransformationer direkte fra segmenteringskort.

Kilde: https://nvlabs.github.io/SPADE/
Det er denne kapacitet, der synes at have været årsag til, at beundrere af Intels billedforbedringssystem har bemærket muligheden for at udlede meget højkvalitetsfotorealistiske billeder, selv i realtid (til sidst), fra ekstremt grove input.
Erstatning af teksturer og lys med neuralt rendering
I tilfældet med GTA5-input har nogen undret, om nogen af de beregningsmæssigt dyre procedurer og bitmap-teksturer og lys fra spilmotorens output virkelig er nødvendige i fremtidige neuralt renderingsystemer, eller om det måske er muligt at transformere lavopløselige, wireframe-niveau-input til fotorealistiske video, der overgår skygge-, tekstur- og lyskvaliteterne fra spilmotorer, og skaber hyperrealistiske scener fra ‘proxy’-input.
Det kan synes åbenlyst, at spilgenererede aspekter som refleksioner, teksturer og andre typer miljødetaljer er essentielle informationskilder for et neuralt renderingsystem af den type, der er demonstreret af Intel. Men det er nu flere år siden, NVIDIA’s UNIT (UNsupervised Image-to-image Translation Networks) demonstrerede, at kun domænet er vigtigt, og at selv omfattende aspekter som ‘nat eller dag’ i princippet er spørgsmål, der skal håndteres af stiloverføring:
I forhold til nødvendig input kan dette potentielt efterlade spilmotoren kun til at generere basegeometri og fysiksimuleringer, da neuralt renderingsmotoren kan overmale alle andre aspekter ved at syntetisere det ønskede billede fra det indfangede dataset, ved hjælp af semantiske kort som en fortolkningsskikt.

Intels system forbedrer en fuldt færdig og rendered billede fra GTA5, og tilføjer segmentering og vurderede dybdekort – to aspekter, der potentielt kan leveres direkte af en nedskaleret spilmotor. Kilde: https://www.youtube.com/watch?v=P1IcaBn3ej0
Intels neuralt renderingsapproach indebærer analyse af fuldt renderede billeder fra GTA5-buffere, og neuralt system har den ekstra byrde at skabe både dybdekort og segmenteringskort. Da dybdekort implicit er tilgængelige i traditionelle 3D-pipelines (og er mindre krævende at generere end tekstur, ray-tracing eller global illumination), kan det måske være en bedre brug af ressourcer at lade spilmotoren håndtere dem.
Nedskaleret input til et neuralt renderingsmotor
Den nuværende implementering af Intels billedforbedringsnetværk indebærer måske en stor mængde redundant beregning, da spilmotoren genererer beregningsmæssigt dyre teksturer og lys, som neuralt renderingsmotoren ikke virkelig har brug for. Systemet synes at være designet på denne måde, ikke fordi det nødvendigvis er en optimal tilgang, men fordi det er lettere at tilpasse et neuralt renderingsmotor til en eksisterende pipeline end at skabe en ny spilmotor, der er optimeret til en neuralt renderingsapproach.
Den mest økonomiske brug af ressourcer i et spilsystem af denne art kunne være fuldstændig overtagelse af GPU’en af neuralt renderingsmotoren, med den nedskalerede proxy-input håndteret af CPU’en.
Desuden kunne spilmotoren let producere repræsentative segmenteringskort selv, ved at slukke for alle skygge- og lys-effekter i dens output. Derudover kunne det leverer video i en langt lavere opløsning, end det normalt kræves af det, da videoen kun behøver at være bredt repræsentativ for indholdet, med høj opløsning detaljer håndteret af neuralt motoren, og yderligere frigør lokale beregningsressourcer.
Intel ISL’s tidligere arbejde med segmentering>billede
Den direkte oversættelse af segmentering til fotorealistiske video er langt fra hypotetisk. I 2017 udgav Intel ISL, skaberen af i går, initialt forskning, der kan udføre byvideo-syntese direkte fra semantisk segmentering.

Intel ISL’s segmentering til billede-arbejde fra 2017. Kilde: https://awesomeopensource.com/project/CQFIO/PhotographicImageSynthesis
I virkeligheden er det oprindelige pipeline fra 2017 blot blevet udvidet til at passe GTA5’s fuldt renderede output.
Neuralt rendering i VFX
Neuralt rendering fra kunstige segmenteringskort synes også at være en lovende teknologi til VFX, med muligheden for direkte at oversætte meget basisvideogrammer til færdige visuelle effekter, ved at generere domænespecifikke datasets fra modeller eller syntetiske (CGI)-billeder.

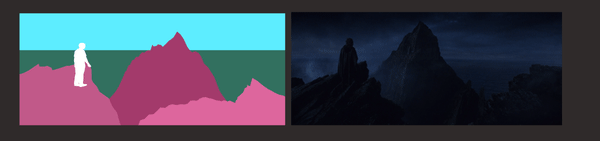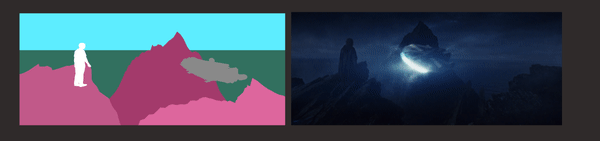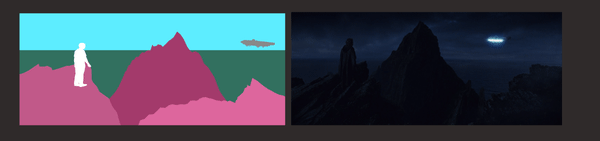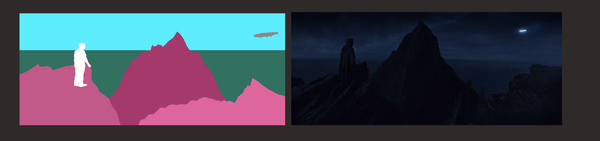
En hypotetisk neuralt renderingsmotor, hvor omfattende dækning af hvert mål-objekt er abstraheret til et bidragende dataset, og hvor kunstigt genererede segmenteringskort bruges som grundlag for fuldopløsningsfotorealistiske output. Kilde: https://rossdawson.com/futurist/implications-of-ai/comprehensive-guide-ai-artificial-intelligence-visual-effects-vfx/
Udviklingen og antagelsen af sådanne systemer ville flytte fokus for kunstnerisk indsats fra en fortolknings til en repræsentativ arbejdsgang, og ville hæve domæne-drevet dataindsamling fra en støttende til en central rolle i de visuelle kunstarter.
Artiklen er opdateret kl. 16:55 til at tilføje materiale om Intel ISL’s forskning fra 2017.


