AI-modeller og platforme
Hvad er Moores lov, og hvordan påvirker den AI?

 Føj Unite.AI til dine foretrukne kilder på Google
Moores lov er den historiske observation, at økonomisk nyttige integrerede kredsløb har haft en tendens til at få flere komponenter med en eksponentiel hastighed. Det er ikke en fysisk lov og siger ikke, at computere automatisk bliver dobbelt så hurtige efter en fast tidsplan.
For AI er transistor‑tætheden vigtig, fordi den muliggør flere aritmetiske enheder, mere hukommelse og flere forbindelser. Men den praktiske fremgang afhænger også af arkitektur, numerisk præcision, indkapsling, hukommelsesbåndbredde, algoritmer, software, energi, produktionsudbytte og mængden af brugbare data.
Vigtige pointer
- Moores oprindelige artikel fra 1965 beskrev en økonomisk og ingeniørmæssig tendens, ikke en fysisk garanti.
- Skaleringen af clock‑hastighed aftog; nutidige gevinster kommer i stigende grad fra parallelisme og specialiserede acceleratorer.
- AI‑ydeevne er ofte begrænset af hukommelsesbevægelse og energi, ikke kun aritmetik.
- Sammenlign systemer ud fra arbejdsbelastningens latenstid, gennemløb, kvalitet, strømforbrug og samlede omkostninger – ikke antallet af transistorer.
Hvad Moore faktisk observerede
Gordon Moore plottede antallet af komponenter i førende integrerede kredsløb og forudsagde fortsat hurtig vækst ved minimale omkostninger per komponent. Tempoet blev senere ofte opsummeret som en fordobling cirka hver anden år, men formuleringer og målte størrelser har varieret.
Mindre strukturer kan øge tætheden og reducere nogle skiftekostnader, men produktionskompleksitet og økonomi bestemmer, om tendensen forbliver brugbar. Nodnavne er markedsføringsbetegnelser, så de bør ikke betragtes som en direkte fysisk sammenligning mellem foundries.
Fra hurtigere kerner til heterogen beregning
Dennard‑lignende spændingsskalering tillod engang højere clock‑hastigheder uden proportional strømforøgelse, men dette forhold svækkedes. Designere skiftede mod multicore‑CPU‑er, GPU‑er, tensor‑enheder, chiplets, avanceret indkapsling og domænespecifikke acceleratorer.
Denne heterogenitet er central for deep learning. Tætte matrixoperationer kan køre effektivt på parallel hardware, mens CPU‑er koordinerer uregelmæssig logik og databevægelse. Den hurtigste komponent hjælper ikke, hvis pipeline‑en ikke kan holde den forsynet.
Hukommelse, præcision og algoritmer
Træning og inferens flytter gentagne gange vægte, aktiveringer og cache‑data gennem en hierarki af on‑chip‑ og off‑chip‑hukommelse. Båndbredde, kapacitet, lokalitet og kommunikation kan dominere omkostningerne. Lavere numerisk præcision og kvantisering reducerer bevægelse, når kvaliteten forbliver acceptabel.
Algoritmiske forbedringer kan sænke den beregning, der kræves for at nå et målresultat. Sparsomme modeller, transformer-effektivitetsmetoder, bedre optimeringsalgoritmer og data af højere kvalitet påvirker alle den faktiske fremgang, som brugerne oplever.
Hvordan man sammenligner AI‑hardware
Top‑operationer per sekund er teoretiske. Brug en repræsentativ model, batch‑størrelse, sekvenslængde, præcision, software‑stack og kvalitetsgrænse. Rapporter end‑to‑end‑latens, gennemløb, energi, hukommelsesfodaftryk, udnyttelse og omkostninger.
Edge‑systemer kan lægge større vægt på privatliv og lavt strømforbrug end maksimal gennemløb; datacentre kan prioritere samlede tokens eller prøver per watt. Edge AI gør tydeligt, hvorfor et enkelt overskrifts‑tal ikke kan beskrive ethvert brugbart system.
Hvorfor halvleder‑skalering ændrede sig
Den tidlige fremgang inden for integrerede kredsløb kombinerede mindre enheder, bedre fremstilling, lavere omkostninger per komponent og designforbedringer. I årevis understøttede reducerede transistor‑dimensioner også hurtigere skiftning og lavere energi per operation. Til sidst svækkede lækage, spændingsgrænser, varmetæthed, interconnect‑forsinkelse og produktionsomkostninger det simple forhold mellem en ny procesnode og hurtigere generelle kerner.
Den moderne fremgang er derfor multidimensional. FinFET‑ og gate‑all‑around‑enheder forbedrer elektrostatisk kontrol; ekstrem‑ultraviolet‑lithografi muliggør mindre mønstre; chiplets giver designere mulighed for at kombinere die fremstillet i forskellige processer; avanceret indkapsling placerer beregning og hukommelse tættere sammen. Udbytte og indkapsling bestemmer, om et teknisk imponerende design er økonomisk i stor skala.
Den langsommere udvikling af en skaleringsteknik betyder ikke, at hardware holdt op med at forbedre sig. Det betyder, at arkitekter skal bruge transistorer mere bevidst. Specialiserede enheder udveksler fleksibilitet for gennemløb eller effektivitet på udvalgte arbejdsbelastninger, mens større cache‑ og interconnect‑systemer forsøger at holde disse enheder forsynet.
Hvordan AI‑arbejdsbelastninger belaster hardware
Træning skifter mellem fremad‑beregning, backpropagation, optimerings‑opdateringer og kommunikation mellem acceleratorer. Inferens spænder fra batch‑scoring til interaktiv token‑generering. Matrix‑multiplikation er vigtig, men indlejringer, normalisering, aktiveringsfunktioner, attention, routing, cache‑adgang og vært‑orkestrering bidrager alle til den faktiske ydeevne.
Aritmetisk intensitet – mængden af beregning udført pr. byte flyttet – hjælper med at forklare, om en arbejdsbelastning er beregnings‑ eller båndbreddebegrænset. Små batch‑størrelser og autoregressiv dekodning efterlader ofte aritmetiske enheder underudnyttede, fordi vægte eller cache‑data skal hentes gentagne gange. Større batch‑størrelser øger udnyttelsen, men øger latens og hukommelsesforbrug.
Numerisk format ændrer afvejningen. FP32, BF16, FP16, FP8 og heltalsformater adskiller sig i interval, præcision, hardware‑understøttelse og fejl. Mixed‑precision‑træning bevarer følsomme operationer i højere præcision; kvantiseret inferens kræver kalibrering og kvalitetstest i stedet for et løfte om, at alle modeller tåler samme bit‑bredde.
Systemøkonomi og fremtidige retninger
Den samlede AI‑omkostning omfatter køb eller leje af acceleratorer, strømforsyning, køling, netværk, lagring, software‑udvikling, inaktiv kapacitet og mislykkede eksperimenter. En hurtigere chip kan koste mere samlet, hvis udnyttelsen er dårlig, eller hvis modellen kræver en dyr distribueret topologi. Mål nyttig output ved en defineret kvalitetsgrænse.
Skalering er også begrænset af data og algoritmer. Mere beregning kan ikke reparere forkert mærkede data eller en evaluering, der belønner genveje. Effektiv attention, bedre optimeringsalgoritmer, sparsitet, hentning, destillation og algoritmiske opdagelser kan forbedre resultater uden en proportional hardware‑forøgelse, selvom de kan flytte omkostningerne andre steder.
Fremtidige systemer vil kombinere proces‑fremskridt med tredimensionel stakning, høj‑båndbredde‑hukommelse, optiske eller avancerede elektriske interconnects, domænespecifik dataflow og med‑designet software. Moores lov forbliver en værdifuld historisk kontekst, men planlægning bør baseres på målte arbejdsbelastningskurver og realistiske forsynings‑, energi‑ og implementerings‑begrænsninger.
At læse Moores lov korrekt i AI‑systemdesign
En brugbar analyse adskiller transistor‑tæthed, generel CPU‑ydeevne, accelerator‑gennemløb, hukommelseskapacitet, hukommelsesbåndbredde, interconnect, energi, produktionsudbytte og omkostninger. Disse forbedres ikke med samme hastighed. En AI‑arbejdsbelastning, der domineres af flytning af modelvægte, kan få lidt udbytte af flere aritmetiske enheder, mens en lille on‑chip‑model kan drage betydelig fordel af specialiseret lav‑præcisions‑hardware. Angiv den præcise måling, præcision, arbejdsbelastning og strøm‑ramme i stedet for at betragte en procesnode som ydeevne.
Skalering af en AI‑model ændrer også software‑ og systemkrav. Større træningskørsler kræver parallelle algoritmer, pålidelig checkpoint‑tagning, højhastighedsnetværk, lagrings‑pipelines og nok data til at udnytte den ekstra kapacitet. Ved inferens afhænger latensen af prompt‑længde, genererede tokens, batch‑størrelse, cache‑hukommelse og service‑niveau mål. Algoritmiske forbedringer, sparsitet, kvantisering, hentning og bedre data kan give gevinster, der er uafhængige af transistor‑tendenser og nogle gange overstiger en hardware‑generation.
Til planlægning bør man benchmarke repræsentative modeller på udvalgte systemer og modellere de samlede omkostninger over implementerings‑livscyklussen: anskaffelse eller cloud‑pris, strøm, køling, udnyttelse, ingeniørarbejde, migration og forsynings‑risiko. Brug scenarier i stedet for én eksponentiel prognose. Moores lov forbliver en værdifuld historisk observation om integrations‑økonomi, men den garanterer ikke, at AI bliver proportionelt hurtigere, billigere, mere kapabel eller mere bæredygtig efter en fast tidsplan.
Praktisk implementerings‑tjekliste
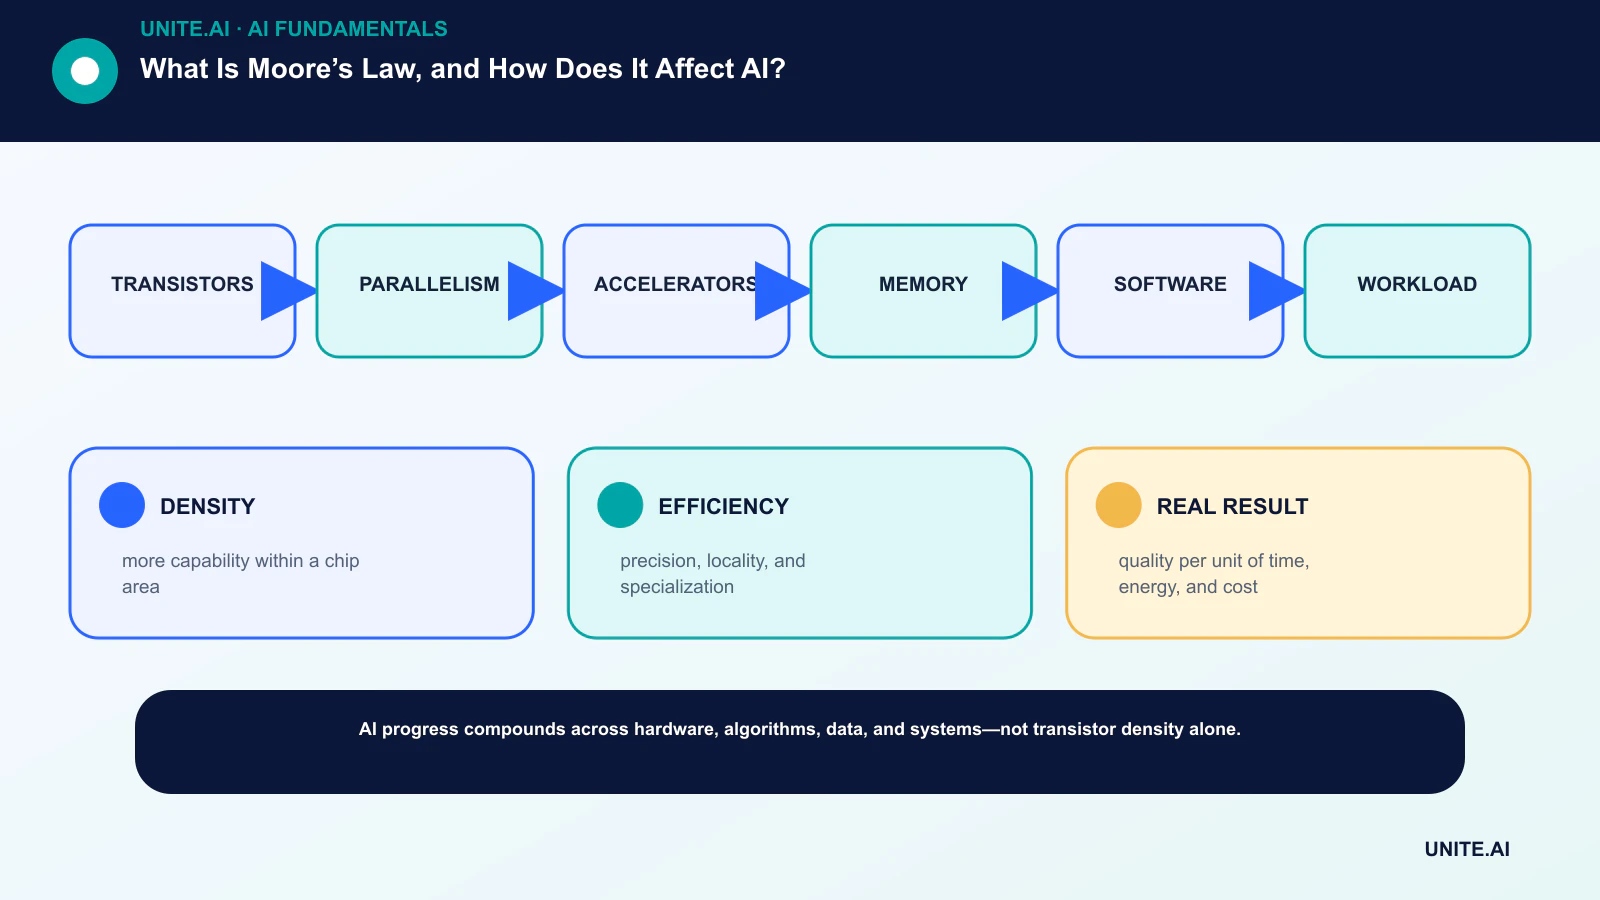
Omdan konceptet til en afgrænset, testbar arbejdsproces: transistorer → parallelisme → acceleratorer → hukommelse → software → arbejdsbelastning. Udpeg en ansvarlig ejer, dokumenter data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definer overvågning, rollback og gennemgang før udvidelse af omfanget. Registrer versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der er ændret.
Før lancering skal du gennemføre en dokumenteret beredskabsgennemgang med de personer, der bygger, driver, sikrer og berøres af systemet. Test normale tilfælde, randbetingelser, afhængigheds‑fejl og misbrug; bevar beviserne og uafklarede risici. Definér, hvem der kan godkende frigivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Gennemgå beslutningen igen, når data fra den virkelige verden ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- DENSITY: mere kapacitet inden for et chip‑område.
- EFFICIENCY: præcision, lokalitet og specialisering.
- REAL RESULT: kvalitet per enhed tid, energi og omkostning.
Ofte stillede spørgsmål
Er Moores lov forbi?
Den simple historiske tendens har aftaget og ændret karakter, men halvleder‑fremskridt fortsætter gennem enheder, arkitektur, indkapsling, hukommelse og software. Om udtrykket stadig passer, afhænger af målingen.
Betyder dobbelt så mange transistorer dobbelt AI‑ydeevne?
Nej. Ydeevnen afhænger af, hvordan transistorerne anvendes, samt af båndbredde, præcision, modelstruktur, software‑effektivitet, strømforbrug og arbejdsbelastnings‑begrænsninger.
Primære referencer