
Grundlæggende AI
Generative vs. diskriminative maskinlæringsmodeller

 Føj Unite.AI til dine foretrukne kilder på Google
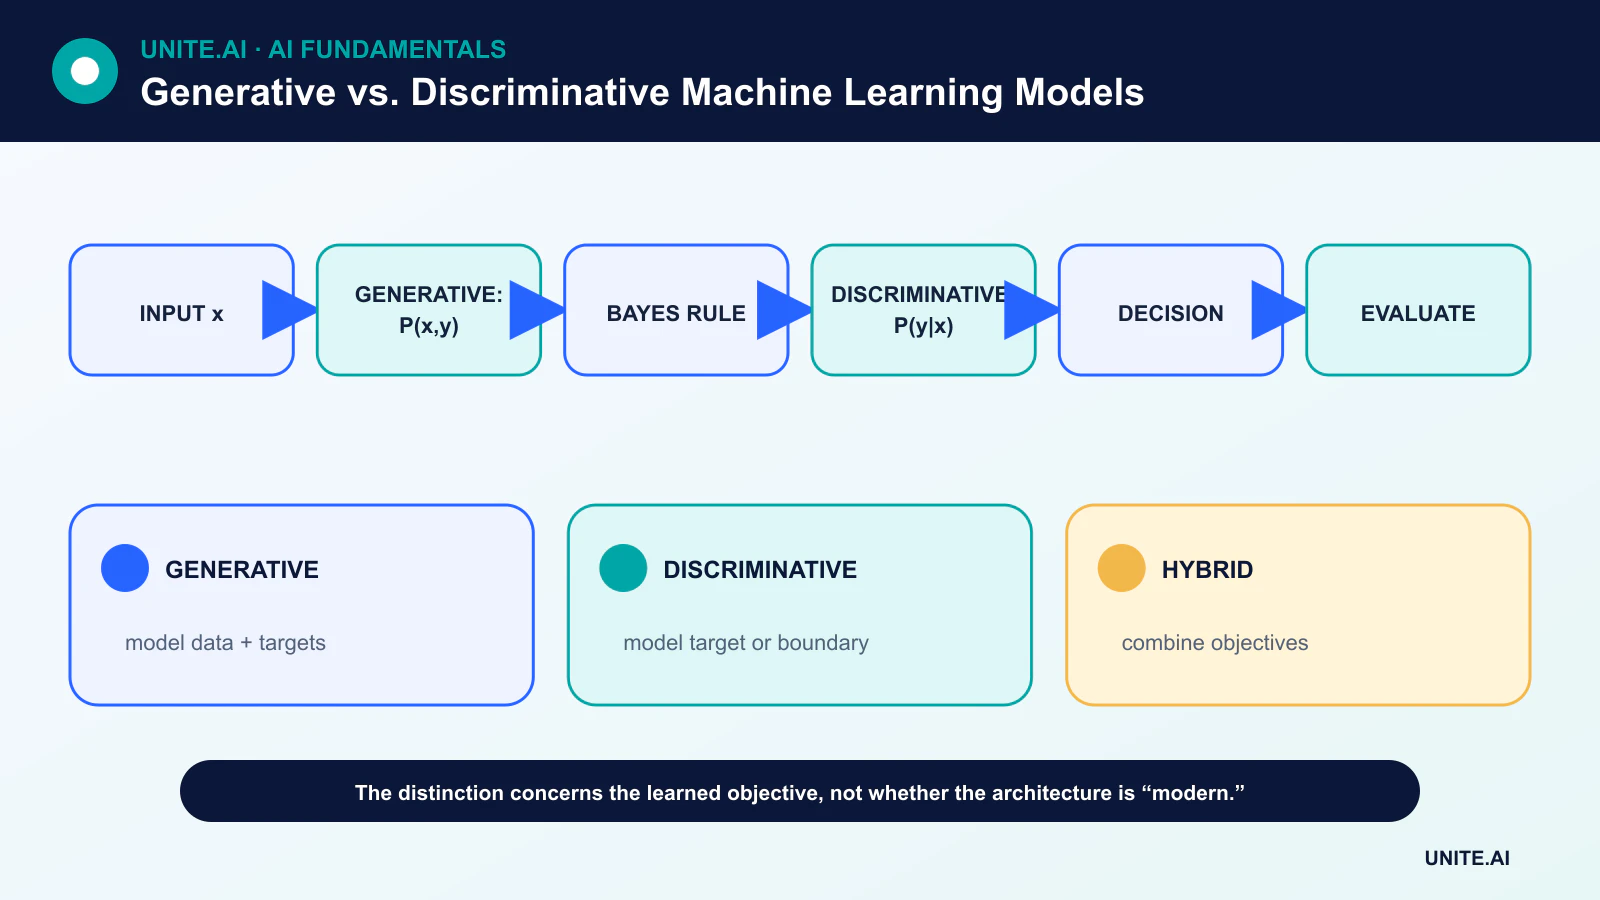
Generative og discriminative beskriver, hvad en model lærer om data og mål. I klassisk superviseret klassificering lærer en generativ model en fælles fordeling såsom P(x, y) eller klasse‑betinget P(x|y), mens en diskriminativ model lærer P(y|x) eller en direkte beslutningsgrænse.
Skelnen er nyttig, men moderne systemer kombinerer ofte mål. En model kan lære generative repræsentationer og senere finjusteres til diskriminativ forudsigelse, eller dele en fælles backbone mellem generering og klassificering.
Vigtige pointer
- Generative klassifikatorer modellerer, hvordan input og etiketter opstår; diskriminative klassifikatorer modellerer etiketten givet input eller en grænse.
- Generative antagelser kan hjælpe ved begrænset mærket data, men kan også være forkerte.
- Diskriminative metoder fokuserer ofte kapacitet på forudsigelsesopgaven og kan opnå lavere asymptotisk klassifikationsfejl.
- GAN‑er, VAE‑er og sprogmodeller er generative systemer, men “generativ” betyder ikke, at hver komponent er en generativ klassifikator.
Sandsynlighedsfaktorisering
En generativ klassifikator kan estimere P(x|y) og P(y) og derefter bruge Bayes’ sætning til at udlede P(y|x). Naiv Bayes er et klassisk eksempel. En diskriminativ klassifikator såsom logistisk regression estimerer P(y|x) direkte; en SVM lærer en separationsgrænse.
Modellering af P(x,y) er en bredere opgave end at forudsige y ud fra x. Den ekstra struktur kan understøtte sampling eller ræsonnement med manglende data, men den kræver også antagelser om inputfordelingen.
Dataproduktivitet og asymptotisk adfærd
Ng og Jordans sammenligning af Naiv Bayes og logistisk regression viste et nyttigt kompromis: under deres antagelser kan den generative model nå sin begrænsende ydeevne med færre eksempler, mens den diskriminative model kan opnå en lavere asymptotisk fejl.
Dette er ikke en universel rangering. Resultater afhænger af, om modelfamilien passer til dataene, dimensionen, regularisering, optimering og mærke‑kvalitet. Empirisk sammenligning på et repræsentativt valideringsdesign forbliver afgørende.
Repræsentative modelfamilier
Generative modeller omfatter klasse‑betingede fordelinger, skjulte Markov‑modeller, blandingsmodeller, variationale autoencodere, autoregressive sprogmodeller, diffusionsmodeller og GAN‑er.
Diskriminative modeller omfatter logistisk regression, beslutningstræer, betingede random fields, supportvektormaskiner og neurale klassifikatorer. Den samme neurale backbone kan deltage i begge kategorier afhængigt af træningsmålet og output.
Hybrid‑ og selv‑superviserede systemer
En forudtrænet sprog‑ eller visionsmodel kan lære fra ulabelerede data med et generativt eller selv‑superviseret mål, og derefter modtage et diskriminativt hoved til en mål‑opgave. Semi‑superviserede metoder kan optimere mærket klassifikation og et ulabeleret‑data‑mål samtidigt.
Hybridisering gør arkitektur‑etiketter mindre informative end den fulde trænings‑pipeline. Dokumentationen bør angive målet, data, output og tilsigtet inferens – ikke blot kalde en model generativ.
Valg mellem tilgange
Brug opgaven til at beslutte. Hvis målet er en kalibreret grænse med rigelige mærkater, er en diskriminativ model et naturligt grundlag. Hvis sampling, tæthedsestimering, manglende‑data‑struktur eller ulabelerede data er centrale, kan en generativ komponent hjælpe.
Sammenlign robusthed, prøve‑effektivitet, beregning, sandsynlighed eller kalibrering efter behov. En god genereret prøve beviser ikke en god klassifikator, og en høj‑nøjagtighed klassifikator indebærer ikke en realistisk model af inputfordelingen.
Retninger for sandsynlighed og modelleringsmål
En diskriminativ model lærer en grænse eller betinget fordeling P(y|x): givet funktioner x, forudsige label y. Logistisk regression, supportvektormaskiner, betingede random fields og mange klassifikatorer er diskriminative. En generativ model lærer en fælles fordeling P(x,y), en klasse‑betinget fordeling P(x|y) eller en ubetinget datafordeling, hvilket muliggør sampling eller sandsynligheds‑relaterede opgaver. Naiv Bayes og lineær diskriminantanalyse er generative klassifikatorer; GAN‑er, variationale autoencodere, diffusionsmodeller og autoregressive modeller genererer data gennem forskellige mål.
Skelnen vedrører, hvilken fordeling eller beslutningsregel der modelleres, ikke om et neuralt netværk anvendes. En generativ sprogmodel kan promptes til at klassificere, mens en diskriminativ reranker kan styre generering. Generative antagelser kan forbedre dataproduktivitet eller håndtere manglende variable, men skaber risiko for model‑mis‑specifikation. Diskriminative metoder udmærker sig ofte med rigelige mærkede data, fordi de fokuserer direkte på forudsigelsesgrænsen. Sammenlign familier under lige funktioner, data, tuning og beregning i stedet for at betragte én kategori som universelt overlegen.
Træning og evaluering efter anvendelsestilfælde
Klassifikations‑evaluering bruger præcision, recall, kalibrering, robusthed og fejl‑omkostning. Generativ evaluering skal tage højde for troværdighed, diversitet, dækning, sandsynlighed eller opgave‑nytte, memorisering og sikkerhed. En model kan producere attraktive prøver, mens den mister mode, eller opnå god sandsynlighed med dårlig perceptuel output. Nytten af syntetiske data bør testes ved at træne og evaluere efterfølgende modeller på uafhængige reelle data, inklusive sjældne grupper. Hold testdata uden for genererings‑prompter og udvælgelse.
I semi‑superviseret læring kan en generativ model udnytte ulabeleret struktur; i anomalidetektion kan sandsynlighed fejle, når out‑of‑distribution data får høj tæthed af irrelevante årsager. I retrieval‑forstærket generering danner en generativ svarmodel og en diskriminativ retriever eller reranker et hybrid. Diagnosticér faser separat, så flydende output ikke skjuler retrieval‑fejl. Vælg den opdeling, der gør beviser og kontrol observerbare.
Implementering og styring
Generative systemer tilføjer risici som indholds‑oprindelse, intellektuel ejendomsret, efterligning, prompt‑injektion og output‑moderation; diskriminative systemer tilføjer risici som tærskel, afvisning og ulige‑fejl. Begge kræver data‑rettigheder, sikre artefakter, versionering, repræsentative tests, overvågning og menneskelig myndighed proportional med konsekvensen. Spor det præcise mål og output‑semantik i dokumentationen. Generativ vs. diskriminativ er en nyttig statistisk skelnen, men reelle systemer kombinerer dem ofte, og pålidelighed afhænger af hele data‑ og beslutnings‑pipeline.
Praktisk eksempel: klassificering og generering af support‑svar
En support‑platform bruger en diskriminativ klassifikator til at identificere problemtype og hastighed samt en generativ model til at udforme et svar ud fra godkendte politikker. Klassifikatoren evalueres med klasse‑specifik recall og kalibrering; retrieveren med evidens‑recall; generatoren med forankring, korrekthed og afvisning. Hver fase har et ukendt udfald, og den generative model kan ikke ændre klassificering eller kundens ret gennem overbevisende tekst.
Agenter ser den forudsagte rute, kilder og udkast og godkender eller korrigerer før afsendelse. Tilladelses‑filtre anvendes før retrieval, og prompt‑injektion i kundetekst kan ikke autorisere værktøjer. Overvågning adskiller routing‑fejl, retrieval‑huller, ikke‑understøttede udsagn og agent‑redigeringer. En politikændring opdaterer kilderne straks og udløser regressions‑tests; tuning forbeholdes stabil adfærd. Det hybride design udnytter diskriminative og generative styrker, mens det bevarer beviser og menneskelig autoritet.
Implementeringsbeviser og operationel parathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før tuning. Test almindelige tilfælde, grænsetilstande, fejl‑ eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underbetjent. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operationel telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑status, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er en GAN‑s diskriminator en diskriminativ model?
Den udfører diskrimination under træning, men den samlede GAN er et generativt rammeværk, hvor output genereres af generatoren.
Er diskriminativ læring altid superviseret?
Nej. Udtrykket beskriver den modellerede relation eller grænse, mens supervision beskriver træningssignalet. Moderne mål kan udviske kategorierne.
Primære referencer












