
Rozhovory
Yaron Singer, generální ředitel Robust Intelligence a profesor informatiky na Harvardově univerzitě – série rozhovorů

 Přidejte Unite.AI mezi své preferované zdroje na Google
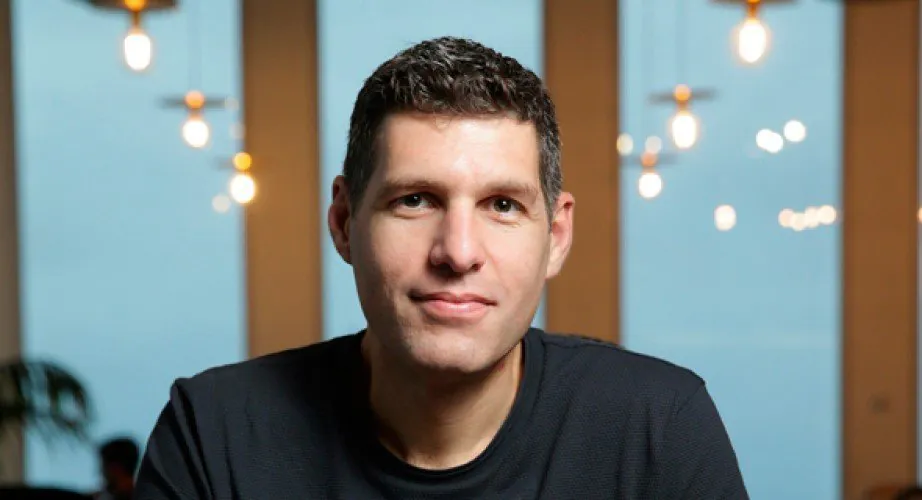
Yaron Singer je generálním ředitelem Robust Intelligence a profesorem počítačových věd a aplikované matematiky na Harvardu. Yaron je známý pro průlomové výsledky v oblasti strojového učení, algoritmů a optimalizace. Předtím pracoval v Google (GOOGL ) Research a získal doktorát na UC Berkeley.
Co vás původně přitáhlo k oboru počítačových věd a strojového učení?
Má cesta začala s matematikou, která mě vedla k počítačovým vědám, které mě nastartovaly k strojovému učení. Matematika mě zpočátku zajímala, protože její axiomatický systém mi umožnil vytvářet nové světy. S počítačovými vědami jsem se naučil o existenčních důkazech, ale také o algoritmech, které je podporují. Z tvůrčího hlediska jsou počítačové vědy kreslením hranic mezi tím, co můžeme a nemůžeme udělat.
Můj zájem o strojové učení vždy vycházel z zájmu o reálná data, téměř fyzickou stránku toho. Brát věci z reálného světa a modelovat je, aby něco smysluplného vytvořily. Mohli bychom doslova navrhnout lepší svět pomocí smysluplného modelování. Matematika mi poskytla základ pro dokázání věcí, počítačové vědy mi pomáhají vidět, co můžeme a nemůžeme udělat, a strojové učení mi umožňuje modelovat tyto koncepty ve světě.
Až donedávna jste byl profesorem informatiky a aplikované matematiky na Harvardově univerzitě. Jaké byly vaše hlavní poznatky z této zkušenosti?
Můj největší poznatek z působení jako člen fakulty na Harvardu je, že rozvíjí chuť dělat velké věci. Harvard tradičně má malou fakultu a očekávání od akademiků na cestě k trvalému profesorskému místu (tenure track) je, že se budou zabývat velkými problémy a vytvářet nové obory. Musíte být odvážní. To nakonec vede k velké přípravě na spuštění kategorie-tvořícího startupu, který definuje nový prostor. Nemusím nutně doporučovat jít touto cestou, ale pokud přežijete harvardskou cestu k trvalému profesorskému místu, budování startupu je snazší.
Můžete popsat svůj “aha” moment, kdy jste si uvědomil, že sofistikované systémy AI jsou zranitelné vůči špatným datům, s některými potenciálně daleko sahajícími důsledky?
Když jsem byl doktorandem na UC Berkeley, vzal jsem si čas na to, abych založil startup, který stavěl modely strojového učení pro marketing v sociálních sítích. To bylo v roce 2010. Měli jsme obrovské množství dat ze sociálních médií a kódovali jsme všechny modely od začátku. Finanční důsledky pro maloobchodníky byly poměrně významné, takže jsme sledovali výkon modelů velmi pečlivě. Protože jsme používali data ze sociálních médií, bylo tam mnoho chyb ve vstupu, stejně jako drift. Viděli jsme, že velmi malé chyby vedly k velkým změnám ve výstupu modelu a mohly vést k špatným finančním výsledkům pro maloobchodníky, kteří používali produkt.
Když jsem přešel do práce na Google+ (pro ty z nás, kteří si to pamatují), viděl jsem přesně stejné účinky. Více dramaticky, v systémech, jako je AdWords, které dělaly předpovědi o pravděpodobnosti, že lidé kliknou na reklamu pro klíčová slova, jsme si uvědomili, že malé chyby ve vstupu do modelu vedly k velmi špatným předpovědím. Když jste svědky tohoto problému v měřítku Google, uvědomíte si, že problém je univerzální.
Tyto zkušenosti silně ovlivnily můj výzkumný zájem a strávil jsem čas na Harvardu, zkoumající, proč modely AI dělají chyby a jak navrhnout algoritmy, které mohou zabránit chybám modelů. To samozřejmě vedlo k dalším “aha” momentům a nakonec k vytvoření Robust Intelligence.
Můžete sdílet příběh o vzniku Robust Intelligence?
Robust Intelligence začala s výzkumem toho, co bylo původně teoretickým problémem: jaké záruky můžeme mít pro rozhodnutí učiněná pomocí modelů AI. Kojin byl studentem na Harvardu a pracovali jsme spolu, zpočátku píšící výzkumné články. Takže to začíná psaním článků, které popisují, co je fundamentálně možné a nemožné, teoreticky. Tyto výsledky později pokračovaly k programu pro návrh algoritmů a modelů, které jsou odolné vůči chybám AI. Poté jsme postavili systémy, které mohou tyto algoritmy spouštět v praxi. Počínaje touto myšlenkou, založení společnosti, ve které organizace mohou použít takový systém, bylo přirozeným dalším krokem.
Mnohé z problémů, kterým Robust Intelligence čelí, jsou tiché chyby, co to jsou a co je dělá tak nebezpečnými?
Než dám technickou definici tichých chyb, stojí za to udělat krok zpět a pochopit, proč bychom se měli starat o chyby AI. Důvod, proč se staráme o chyby AI, je důsledky těchto chyb. Náš svět používá AI k automatizaci kritických rozhodnutí: kdo dostane obchodní půjčku a za jakou úrokovou sazbu, kdo dostane zdravotní pojištění a za jakou sazbu, které čtvrti by měly policie patrolovat, kdo má největší šanci být vynikajícím kandidátem na pracovní místo, jak bychom měli organizovat bezpečnost letišť a tak dále. Skutečnost, že modely AI jsou extrémně chybující, znamená, že při automatizaci těchto kritických rozhodnutí zdědíme velké riziko. V Robust Intelligence nazýváme toto “AI Riziko” a naše mise je eliminovat AI Riziko.
Tiché chyby jsou chyby modelů AI, kde model AI obdrží vstup a produkuje předpověď nebo rozhodnutí, které je špatné nebo zkreslené. Na povrchu vypadá všechno v pořádku, protože model AI dělá to, co má dělat z funkčního hlediska. Ale předpověď nebo rozhodnutí je chybné. Tyto chyby jsou tiché, protože systém neví, že chyba existuje. To může být mnohem horší než případ, kdy model AI neprodukuje výstup, protože to může trvat dlouho, než organizace uvědomí, že jejich systém AI je vadný. Pak se AI riziko stává AI selháním, které může mít katastrofální důsledky.
Robust Intelligence navrhla esenciálně AI Firewall, myšlenku, která byla dříve považována za nemožnou. Proč je to tak velká technická výzva?
Jedním z důvodů, proč je AI Firewall takovou výzvou, je, že jde proti paradigmatu, které zastávala komunita strojového učení. Předchozí paradigma komunity strojového učení bylo, že aby se chyby odstranily, je třeba krmit modely více daty, včetně špatných dat. Tímto způsobem se modely samy trénují a naučí se opravovat chyby. Problém s tímto přístupem je, že způsobí dramatický pokles přesnosti modelu. Nejlepší známé výsledky pro obrázky, například, způsobí pokles přesnosti modelu AI z 98,5% na asi 37%.
AI Firewall nabízí jiné řešení. Odpojíme problém identifikace chyby od role vytváření předpovědi, což znamená, že firewall se může soustředit na jednu konkrétní úlohu: určit, zda bod datového souboru produkuje chybnou předpověď.
To byla sama o sobě výzva kvůli obtížnosti předpovědi chyby v jednom bodě dat. Existuje mnoho důvodů, proč modely dělají chyby, takže stavba technologie, která může předpovídat tyto chyby, nebyla snadným úkolem. Máme velké štěstí, že máme inženýry, které máme.
Jak může systém pomoci zabránit zkreslení AI?
Zkreslení modelu pochází z rozdílu mezi daty, na kterých byl model trénován, a daty, která používá k vytváření předpovědí. Pokud se vrátíme k AI riziku, zkreslení je hlavní problém spojený s tichými chybami. Například, toto je často problém s podreprezentovanými populacemi. Model může mít zkreslení, protože viděl méně dat z této populace, což dramaticky ovlivní výkon modelu a přesnost jeho předpovědí. AI Firewall může upozornit organizace na tyto rozdíly ve datech a pomoci modelu učinit správná rozhodnutí.
Jaké jsou některé další rizika pro organizace, kterým AI firewall pomáhá zabránit?
Jakékoli společnosti, které používají AI k automatizaci rozhodnutí, zejména kritických rozhodnutí, automaticky zavádějí riziko. Špatná data mohou být tak jednoduchá, jako zadání nuly místo jedničky, a přesto vést k významným důsledkům. Bez ohledu na to, zda je riziko špatných lékařských předpovědí nebo falešných předpovědí o půjčkách, AI Firewall pomáhá organizacím zabránit riziku.
Je něco jiného, co byste rádi sdíleli o Robust Intelligence?
Robust Intelligence roste rychle a dostáváme mnoho skvělých kandidátů na pozice. Ale něco, co opravdu chci zdůraznit pro lidi, kteří zvažují přihlášení, je, že nejdůležitější vlastností, kterou hledáme u kandidátů, je jejich vášeň pro misi. Setkáváme se s mnoha kandidáty, kteří jsou silní technicky, takže to opravdu záleží na tom, zda je skutečně nadchne odstraňování rizika AI, aby byl svět bezpečnější a lepší.
Ve světě, kam směřujeme, mnoho rozhodnutí, která jsou nyní učiněna lidmi, bude automatizováno. Bez ohledu na to, zda se nám to líbí nebo ne, je to fakt. Vzhledem k tomu, všichni v Robust Intelligence chceme, aby automatizovaná rozhodnutí byla učiněna zodpovědně. Kdokoli, kdo je nadšen tím, aby měl dopad, kdo chápe, jak to může ovlivnit životy lidí, je kandidát, kterého hledáme, aby se připojil k Robust Intelligence. Hledáme tu vášeň. Hledáme lidi, kteří vytvoří tuto technologii, kterou bude celý svět používat.
Děkuji vám za skvělý rozhovor, bavilo mě se učit o vašich názorech na prevenci zkreslení AI a potřebě AI firewallu, čtenáři, kteří chtějí se dozvědět více, by měli navštívit Robust Intelligence.









