
Rozhovory
Dr. Mathilde Pavis, Head of Legal, OpenOrigins – Rozhovorová série

 Přidejte Unite.AI mezi své preferované zdroje na Google
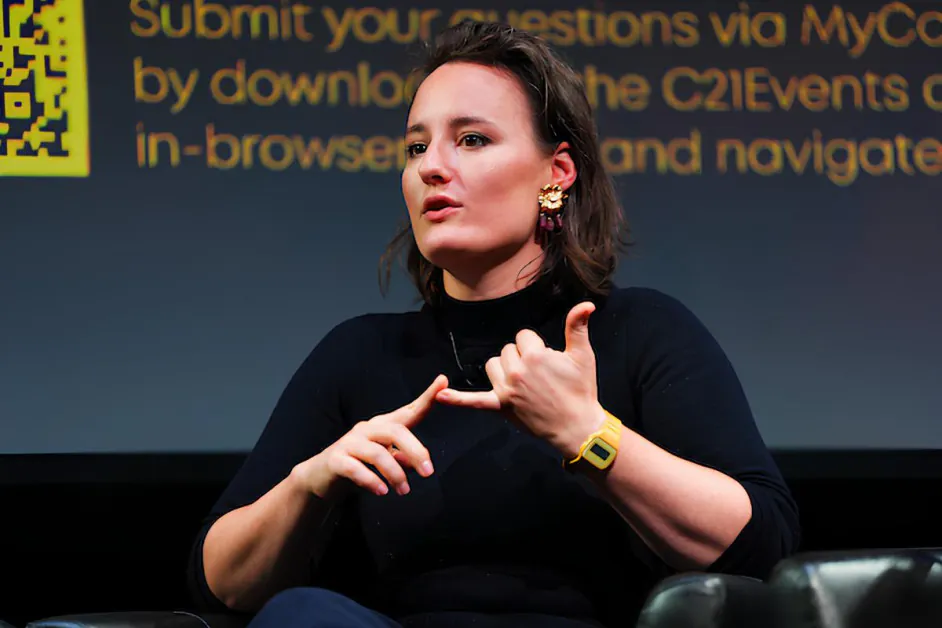
Dr. Mathilde Pavis, Head of Legal ve společnosti OpenOrigins, je přední odbornice na regulaci umělé inteligence a digitální média, specializující se na deepfakes, syntetická média a obsahovou provenienci. Poskytuje poradenství společnostem, vládám a odborovým svazům v oblasti compliance, licencování a rizik spojených s generativní umělou inteligencí a spolupracovala s Microsoftem a ElevenLabs na politice a strategii umělé inteligence. Rovněž poradila UNESCO v oblasti umělé inteligence a duševního vlastnictví a pravidelně poskytuje odborné důkazy britským zákonodárcům.
OpenOrigins vyvíjí technologii pro boj proti dezinformacím a deepfakům vytvořením ověřitelných, nezfalšovatelných záznamů digitálního obsahu. Jeho platforma se zaměřuje na stanovení jasných pravidel původu, což umožňuje médiím, tvůrcům a platformám prokázat, kdy a jak byl obsah vytvořen, editován a distribuován – schopnost, která je stále kritičtější, protože se syntetická média stávají pokročilejšími a obtížněji rozpoznatelnými.
Vy jste poradila vládám, globálním institucím, jako je UNESCO, a společnostem, jako je Microsoft (MSFT ) a ElevenLabs, v oblasti regulace umělé inteligence. Co vás vedlo ke specializaci na deepfakes, digitální repliky a syntetická média, a jak tato cesta ovlivnila vaše rozhodnutí založit Replique?
Má práce na deepfakes nezačala s technologií – začala s mnohem starší právní hádankou. Když jsem v roce 2013 začala zkoumat duševní vlastnictví pro svou disertační práci, byla jsem překvapena tím, jak málo ochrany mají výkonní umělci ve srovnání s autory, skladateli nebo filmaři. V praxi to znamená, že vaše slova nebo vaše hudba jsou lépe chráněny zákonem než vaše hlas, tvář a tělo. Tato nerovnováha se mi zdála divná a vedla mě k zásadní otázce: jak kultura a zákon hodnotí práci někoho, jehož příspěvek je jeho tvář, hlas a tělo na obrazovce?
Tato otázka mě vedla k právu na výkon a datům. V té době se jednalo o úzkou oblast s malým komerčním významem. Byla jsem aktivně doporučena, abych se přesunula do více “lucrativních” oblastí, jako jsou patenty nebo tradiční autorská práva. Předpoklad byl, že otázky týkající se podobizny nebo hlasu byly většinou řešeny neformálně – prostřednictvím odvětvových norem nebo “gentleman’s agreements” v Hollywoodu. Ale pro mě tato absence formální ochrany signalizovala mezeru, ne slepou uličku, a tak jsem v ní pokračovala.
Co se změnilo, je to, že dnes je téměř každý performer. Naše životy jsou zprostředkovány kamerami – na telefonech, notebookech, videohovorech a sociálních platformách. Bez ohledu na to, zda je to pro práci nebo osobní použití, lidé neustále nahrávají a sdílejí verze sami sebe. Právní otázky, které dříve platily hlavně pro herce nebo hudebníky, se nyní vztahují na každého, kdo má smartphone.
Deepfakes tyto problémy nevytvořily – pouze je odhalily a urychily. Výzkum, který jsem prováděla od roku 2013, se najednou stal naléhavým. Přibližně v letech 2017 a 2018 začaly vývoje v neuronových sítích – zejména z míst, jako je MIT a UC Berkeley – demonstrovat, jak přesvědčivě lze digitálně manipulovat osobu, její tvář, hlas a tělo. Do roku se tato schopnost stala široce známou jako “deepfakes” a poprvé získala trakci prostřednictvím hluboce škodlivých způsobů, zejména prostřednictvím nevhodného sexuálního obsahu zaměřeného na ženy a děti.
Až později se objevily komerční důsledky, když se kreativní průmysl začal zajímat o syntetická média. To je okamžik, kdy se smluvní a ekonomické otázky, na kterých jsem pracovala, dostaly do popředí. Téměř přes noc se oblast práva, která byla dříve považována za teoretickou nebo doktrinální, stala vysoce praktickou, komerčně významnou a sociálně naléhavou.
V jádru se právní výzva nezměnila: lidé chtějí sdílet aspekty sami sebe, ale zároveň si zachovat smysluplnou kontrolu. Stávající rámce s tím bojují. Tendence je, že jedince vnímají buď jako zcela soukromé, nebo plně veřejné – buď chráněné, nebo jako správné cíle. Ale většina lidí existuje někde uprostřed. Tento napětí je nyní centrální nejen pro profesionální umělce, ale pro každého, kdo se účastní digitálního života.
Stala jsem se známou jako někdo, kdo se specializuje na výzkum a práci v této oblasti, což mě vedlo k spolupráci s vládami, které se snaží chránit lidi před deepfakes, a se společnostmi, které chtějí vytvořit digitální klonovací produkty bezpečné pro použití, jako je ElevenLabs. V Replique přináším všechno, co jsem se naučila, lidem a společnostem, které chtějí používat digitální klonování nebo digitální replikaci technologie zodpovědně a bezpečně. Základní výzkum jsem vlastně proměnila v poradenskou firmu, která poskytuje specializované právní poradenství kreativním průmyslům.
Jako Head of Legal ve společnosti OpenOrigins, která se zaměřuje na stanovení neměnného záznamu původu obsahu pro boj proti deepfakes, jak vidíte, že systémy založené na původu soutěží nebo nahrazují tradiční přístupy k detekci deepfakes?
Srovnání nástrojů pro detekci deepfakes může se rychle stát cvičením v porovnávání jablek a pomerančů, protože jejich účinnost závisí na kontextu a účelu. Z hlediska politiky potřebujeme řadu komplementárních nástrojů – neexistuje jediné “nejlepší” řešení, a OpenOrigins je pouze částí širšího ekosystému. Tam, kde technologie OpenOrigins vyniká jako řešení pro detekci deepfakes, jsou situace, kdy tvůrce obsahu nebo informační organizace potřebují prokázat autenticitu obsahu, který sdílejí s partnery, diváky nebo veřejností.
Poskytováním ověřitelného původu a “přijetí” v okamžiku vytvoření nabízí silnou formu prevence tím, že prokazuje, že obsah není deepfake. Nicméně, tento přístup je méně užitečný pro běžné uživatele internetu, kteří chtějí rychle posoudit obsah, se kterým se setkávají online. V takových případech se detekce spoléhá více na pravděpodobnostní a obsahovou analýzu než na ověření původu. Potřebujeme různé nástroje pro různé potřeby a musíme přijmout, že neexistuje žádný stříbrný projektil proti deepfakes.
Z právního hlediska, co je v současné době největší mezera v tom, jak jurisdikce nakládají s souhlasem a vlastnictvím v AI-generovaném nebo AI-replikovaném obsahu?
Och, jak dlouho máte čas? Odpověď závisí na tom, co rozumíme pod pojmem AI-generovaný nebo replikovaný obsah. Problémy se liší, zda se díváme na AI-generovanou obraz domu nebo kočky. Nebo digitální rekreaci osoby, její tváře nebo hlasu. Držme se tématu deepfakes a digitální repliky a odpovíme na vaši otázku v kontextu “digitálního klonování”.
Co se týče souhlasu, jádrem problému je, že většina smluv – ať už se jedná o pracovní dohody nebo podmínky platformy – obsahuje široké, vágní klauzule, které poskytují rozsáhlá práva nad uživatelským obsahem. Tyto klauzule mohou být interpretovány jako forma “zadní vrátka” pro souhlas, kde souhlas s podmínkami může být chápán jako souhlas s užitím, jako je klonování, i když většina lidí by s touto interpretací silně nesouhlasila. To vytváří významnou mezeru mezi právní interpretací a očekáváním uživatelů, která v současné době prospívá společnostem, zatímco regulace zaostává.
Co se týče vlastnictví, neexistuje jasná právní odpověď na to, kdo vlastní digitální klon, protože stávající rámce, jako je ochrana dat, autorská práva a práva na osobnost, nebyly navrženy pro tuto technologii. Dnes většina lidí skenuje a klonuje na pracovišti, na žádost a se financováním zaměstnavatele nebo klienta. A tyto subjekty obvykle očekávají vysoký stupeň kontroly nad tímto aktivem, což je pochopitelné, ale často problematické, protože toto aktivum je digitální napodobeninou vaší tváře nebo vašeho hlasu a může říkat věci, které jste nikdy neřekli, nebo dělat věci, které jste nikdy neudělali.
Otázka “komu patří váš klon?” je velmi důležitá, ale zůstává nezodpovězená v zákoně.
Pracovala jste úzce na technologiích pro klonování hlasu. Jaké jsou nejčastěji nepochopitelné právní rizika spojená se syntetickými hlasy, a to jak pro společnosti, tak pro jednotlivce?
Nejpochybnější právní otázka spočívá v rovnováze mezi komerčním zájmem společnosti na financování a využívání digitálního klonu a právem jednotlivce na soukromí a digitální důstojnost. Tento napětí leží napříč několika právními režimy (především duševní vlastnictví, ochranou dat a soukromím), které nebyly navrženy pro fungování společně a interpretují klonování zásadně odlišným způsobem. Jako výsledek, překlad tohoto do fungujících, podnikatelsky přátelských postupů je komplexní a často nejasný. Společnosti proto buď přehlížejí klíčová rizika, nebo nesou významné náklady na jejich řádné řešení. To vede k perverznímu výsledku, kdy zodpovědná compliance se stává obtížnější a dražší cestou, než je norma.
Jak by měly podniky uvažovat o architektuře souhlasu v systémech umělé inteligence, zejména při nakládání s podobiznou, identitou a trénovacími daty?
Společnosti by měly navrhnout své systémy kolem tří základních schopností. První, potřebují zajistit informovaný, kontextový souhlas při prvním přihlášení. Druhé, musí umožnit uživatelům snadno odvolat souhlas a smazat některá nebo všechna svá data, což je technicky náročné a často opomíjené, ale nezbytné pro soulad se zákony, jako je GDPR ve Spojeném království a EU a podobné režimy v USA. Udržování souhlasu v průběhu času znamená budování systémů, kde stažení je operativně hladké a sladěné s obchodním modelem.
Souhlas musí být jemný. A třetí, uživatelé by měli mít možnost spravovat oprávnění na úrovni jednotlivých souborů, aktualizovat svá data o podobizně a rozumět, jak jsou využívána. To vyžaduje transparentnost a kontrolu – nástroje, které umožňují uživatelům monitorovat, přezkoumávat a moderovat, jak jsou jejich digitální klony nasazovány. Tato úroveň flexibility je zatím vzácná, ale je to místo, kde se nachází konkurenční výhoda.
Vaše zkušenosti s poradenskou činností pro startupy i vlády ukazují, kde je největší nesoulad mezi tím, jak je umělá inteligence budována, a jak je regulována?
Nesoulad mezi tím, jak je umělá inteligence budována, a jak je regulována, spočívá v základních rozdílech v misích. Vládám jde o regulaci ve veřejném zájmu, zatímco společnosti umělé inteligence (často s venture kapitálem) jsou primárně poháněny růstem, příjmy a ziskem. Tyto priority se ne vždy střetávají, ale často táhnou v různých směrech, s regulací viděnou jako omezení, spíše než podporu.
To vytváří strukturální napětí: regulátoři a inovátoři operují s odlišnými pobídkami, hodnotami a dokonce i jazyky. To činí praktické sladění obtížným, i když ne nemožným. Začínáme vidět novou vlnu technologických společností, které se více sladí s veřejným zájmem, ale tyto společnosti zůstávají výjimkou, spíše než pravidlem – zejména mezi těmi, které úspěšně expandují.
OpenOrigins se zaměřuje na ověření obsahu v okamžiku jeho vytvoření pomocí kryptografického původu. Jak kritické je toto pojetí “origin-first” ve srovnání s post-distribučními bezpečnostními opatřeními?
To se vrací k mé předchozí odpovědi. Autentizace obsahu při jeho vytvoření, “upstream”, je mnohem účinnější než pokus o jeho ověření v okamžiku distribuce nebo spotřeby, tj. “downstream”. Autentizace obsahu při jeho vytvoření je jako stopování potravin od okamžiku, kdy jsou pěstovány na farmě, spíše než pokus o určení, co je na talíři. Pokud víte, kde kuře bylo vyšlechtěno, jak bylo manipulováno a jak prošlo dodavatelským řetězcem, můžete důvěřovat tomu, co jíte. Pokud se naopak pokoušíte odhadnout vše na základě hotového jídla, spoléháte se na hádání. Stejně je to s rozlišením mezi lidsky vytvořeným a AI-generovaným obsahem online: původ na zdroji poskytuje ověřitelnou jistotu, zatímco detekce “downstream” je inherentně nejistější a reaktivnější.
Jakou roli vidíte pro standardy, jako je C2PA, v budoucnosti médií, a jsou dostatečné samy o sobě k obnovení důvěry online?
C2PA je vítanou iniciativou a mnoha ohledech podporuje stejný pohyb pro autenticitu obsahu, jako OpenOrigins. Jsou důležitou součástí ekosystému bezpečnosti a autenticity obsahu. Jako u každého nástroje kybernetické bezpečnosti neexistuje žádný stříbrný projektil.
Pro tvůrce a talentované lidi v odvětvích, jako je film, hudba a herní průmysl, jaké praktické kroky by měli podniknout dnes, aby se chránili před neoprávněnou digitální replikací?
Umělci dnes čelí dvěma odlišným rizikům: replikaci své práce (jako je hudba, obrázky nebo psaní) a replikaci své podobizny, včetně tváře, hlasu a těla. S minimálním vstupem mohou systémy umělé inteligence nyní reprodukovat obě s vysokou mírou věrnosti. Prakticky to začíná tím, že jsou úmyslní ohledně toho, co sdílejí online, uznávajíce, že jakýkoli obsah, který je zveřejněn, může být skenován a použit v trénovacích datech, často bez jasného souhlasu nebo viditelnosti.
To je nyní základní realita fungování online. Ale bližší a řiditelnější riziko často spočívá ve smlouvách. Dohody, které umělci uzavírají se svými spolupracovníky, distributory nebo platformami, mohou zahrnovat klauzule, které umožňují použití umělé inteligence, opětovné použití nebo prodej obsahu pro trénovací účely – často bez významné účasti na následujícím příjmu.
Pro umělce je proto kritické, aby pečlivě prozkoumali smlouvy. Porozumění tomu, jak může být jejich práce a podobizna použita, licencována nebo repurposed, je nyní stejně důležité jako samotný tvůrčí proces. Velká část současné debaty (přes odbory, odvětvové organizace a platformy) se zaměřuje na nápravu tohoto nesouladu a zajištění, aby tvůrci si zachovali kontrolu a spravedlivou kompenzaci.
Takže dvě hlavní rady: buďte opatrní s tím, co sdílíte online, a pečlivě čtete smlouvy a hledáte klauzule o umělé inteligenci, než je podepíšete.
Pohledem do budoucna, tři až pět let, věříte, že dosáhneme bodu, kdy každý kus digitálního obsahu musí mít ověřitelný původ, nebo důvěra zůstane fragmentovaná napříč platformami a jurisdikcemi?
Rád bych řekl ano, ale realisticky, ne – ne do pěti let. V technologiích pět let vypadá jako dlouhá doba; ve změně uživatelského chování a zvyklostí je to velmi krátká doba. Většina spotřebitelů je nepravděpodobné, že bude své rozhodnutí založena na tom, zda obsah přichází s autentizovaným původem. Platformy obvykle následují poptávku uživatelů, optimalizují se pro zapojení, spíše než původ.
To by se mohlo změnit, kdyby zasáhla regulace. Už vidíme počáteční kroky v místech, jako je Kalifornie, kde jsou zavedeny požadavky na označování a moderaci, ale globální rozšíření bude trvat déle – pravděpodobně bližší desetiletí než pět let.
Další oblastí změny je specifická pro odvětví: průmysly, jako je žurnalistika, finance, pojištění a zdravotnictví, mohou začít vyžadovat původ a autentizaci, protože důvěra je zásadní pro jejich operace.
Nakonec spotřebitelé možná nebudou dbát na informace o původu, ale budou dbát na kvalitu obsahu a kvalitu informací. Pokud se AI-generovaný obsah stane příliš homogenním nebo “nudným”, diváci mohou začít více ocenit lidsky vytvořený obsah. To by mohlo vést k segmentaci trhu, kde některé platformy dají přednost měřítku a AI-generovanému obsahu, zatímco jiné budou kultivovat autenticitu, původ a materiály vedené lidskou důvěrou – ale tato změna zůstává neznámou.
Děkuji vám za vaše skvělé odpovědi, čtenáři, kteří chtějí se dozvědět více, by měli navštívit OpenOrigins.


