
Základy AI
Co je TinyML? Strojové učení na mikrořadičích

 Přidejte Unite.AI mezi své preferované zdroje na Google
TinyML přináší inferenci strojového učení do vysoce omezených zařízení, jako jsou mikrořadiče, malé digitální signálové procesory a nízkoenergetické senzory. Tyto systémy mohou mít kilobajty nebo megabajty paměti, přísné energetické rozpočty, žádné trvalé síťové připojení a termíny v reálném čase.
Hodnota nespočívá jen v menším modelu. Zpracování blízko senzoru může snížit latenci, šířku pásma a vystavení surových dat, zároveň umožňuje produkty, které dlouho fungují na bateriích nebo získané energii.
Klíčové poznatky
- TinyML je definováno kompletním rozpočtem hardwaru a softwaru, nikoli jedním prahem velikosti modelu.
- Kvantizace, kompaktní architektury, optimalizovaná jádra a pečlivé bufferování umožňují nasazení.
- Inferování na zařízení může zlepšit soukromí, ale zabezpečené aktualizace a správa dat jsou stále důležité.
- Porovnávejte přesnost spolu s latencí, maximální pamětí, energií, pracovním cyklem a robustností.
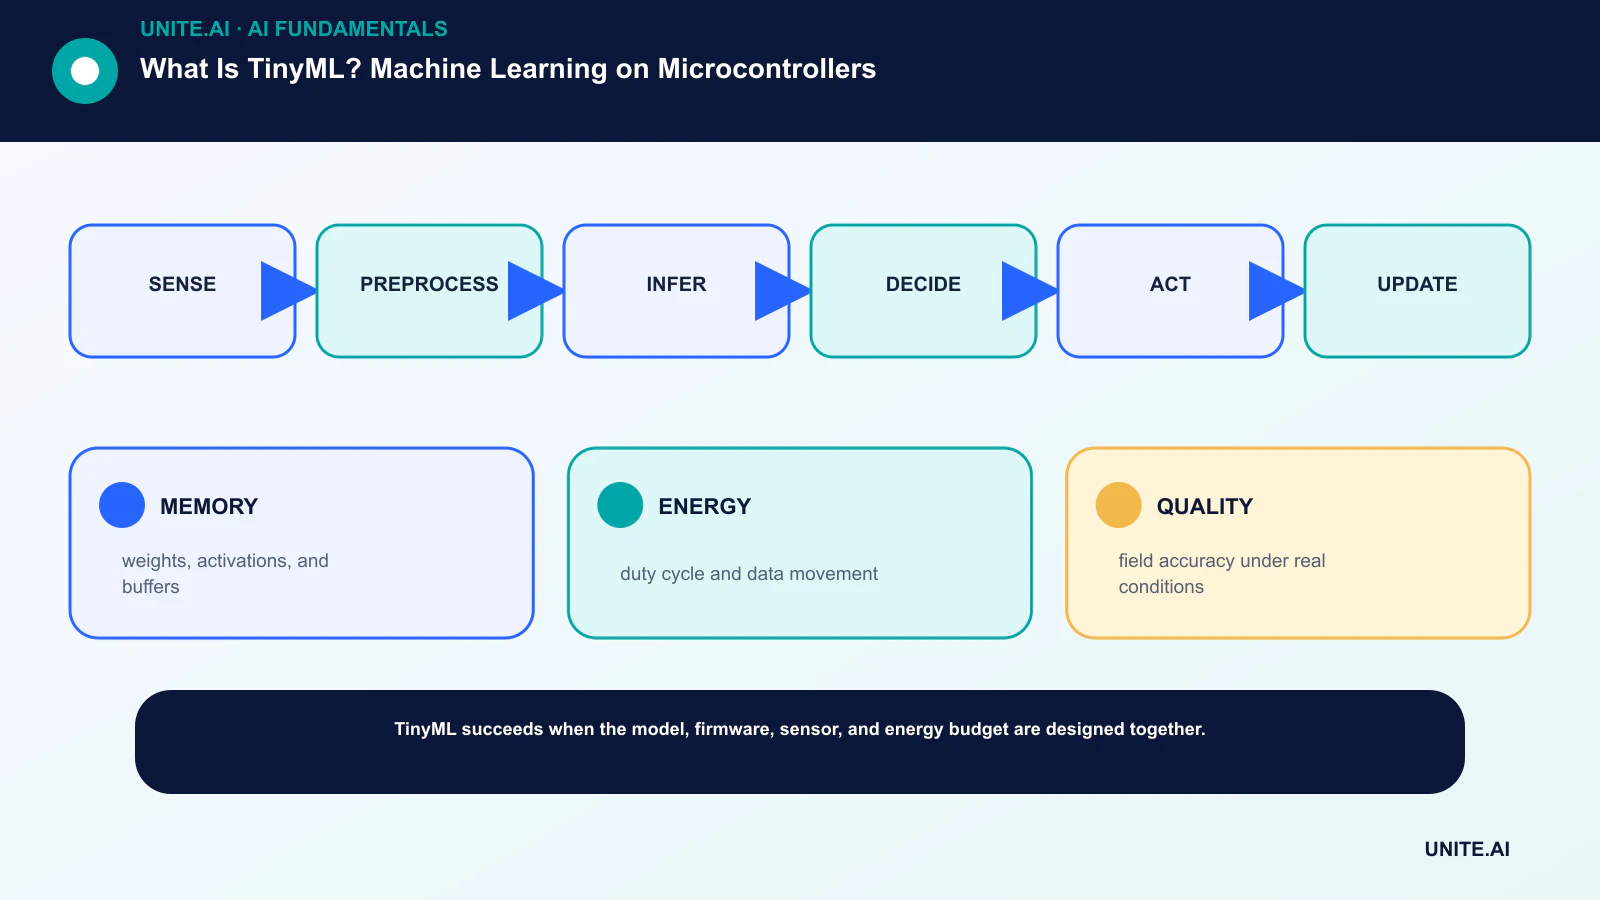
Sada TinyML
Senzor zachytí audio, pohyb, vibraci, obraz nebo jiný signál. Firmware jej předzpracuje na rysy nebo tensory; kompaktní model běží v zabudovaném runtime; aplikační logika rozhoduje, zda probudit větší systém nebo jednat lokálně.
Jedná se o omezenou formu edge AI. Hardwar může zahrnovat MCU, paměť, rozhraní senzorů a někdy neuronový akcelerátor. Každý buffer, operátor a kopie soutěží o omezené zdroje.
Přizpůsobení modelu
Kvantizace nahrazuje vysokopřesné hodnoty menšími celočíselnými reprezentacemi. Prořezávání, destilace, návrh rysů a hledání architektury mohou snížit výpočetní náročnost nebo úložiště. Podpora operátorů v cílovém runtime omezuje, které modely jsou praktické.
Trénink často probíhá na výkonnějším hardwaru, poté je model převeden a zkompilován pro zařízení. Transfer learning může snížit potřebu dat, ale finální artefakt je nutné vyhodnotit po konverzi, protože číselné změny mohou ovlivnit přesnost.
Data a posun prostředí
Laboratorní záznamy zřídka představují každý mikrofon, montážní polohu, teplotu, vibrační vzor, přízvuk nebo podmínky pozadí. Sbírejte data z reprezentativních zařízení a prostředí, udržujte tréninkové a testovací zdroje nezávislé a zahrňte případy „žádná z uvedených“.
Falešné spouštění může plýtvat energií nebo obtěžovat uživatele; opomenutá anomálie může být nákladná. Vyberte prahy na základě skutečných nákladů chyb a sledujte výkon v terénu pomocí souhrnů chránících soukromí nebo vzorkovaných diagnostik, kde je to vhodné.
Měření celého zařízení
Počty operací modelu se nerovnají výkonu produktu. Uveďte frekvenci probouzení, čas předzpracování, latenci inferencí, špičkovou RAM, využití flash, průměrný a špičkový výkon, termální chování a dopad na baterii při explicitním pracovním cyklu.
Plánujte podepsané aktualizace firmwaru a modelu, rollback, identitu zařízení a reakci na zranitelnosti. Malá zařízení mohou být nasazena roky, takže údržba je součástí kvality modelu. Opatření v oblasti kybernetické bezpečnosti nelze odkládat jen proto, že zařízení je malé.
Rozpočtování paměti a výpočtů
Flash ukládá firmware, váhy modelu a konstanty; RAM obsahuje buffery senzorů, mezilehlé aktivace a stav runtime. Špičková paměť aktivací může přesáhnout velikost vah, zejména v raných konvolučních vrstvách. Plánovače paměti znovu využívají buffery, jejichž životnosti se nepřekrývají, zatímco streamování rysů zabraňuje ukládání celého okna signálu.
Počet operací je počáteční odhad, ale efektivita jádra závisí na tvaru tensoru, zarovnání, podpoře instrukcí a přístupu k paměti. Depthwise konvoluce může snížit aritmetiku, ale na hardwaru bez optimalizovaného jádra běží špatně. Porovnávejte zkompilovaný model na cílové desce, ne jen v desktopovém profileru.
Pracovní cyklus dominuje mnoha produktům. Senzor a MCU mohou spát, probudit se pro levný spouštěč, spustit malý model a aktivovat rádio nebo výkonnější procesor jen když je to potřeba. Měřte celý pracovní cyklus, včetně senzoru, převodu, předzpracování, probuzení, inferencí, komunikace a úniku v nečinnosti.
Vývoj a konverze modelu
Začněte s omezeními nasazení a sbírejte reprezentativní data ze senzorů. Předzpracování použité při tréninku musí přesně odpovídat implementaci s pevnou řádovou čárkou nebo vestavěné implementaci. Rozdíly ve vzorkovací frekvenci, okně, konverzi barev, normalizaci nebo extrakci rysů mohou způsobit selhání modelu i když konverze uspěje.
Kvantizace po tréninku kalibruje rozsahy z reprezentativních vzorků; trénink s uvědoměním kvantizace simuluje nižší přesnost během učení. Váhové škály na kanál často zachovávají kvalitu konvoluce lépe než jedna škála. Nepodporované operace mohou být přepsány, aproximovány nebo přesunuty na pomalejší záložní řešení, což vyžaduje nové hodnocení.
Komprese by měla být řízena hypotézou. Prořezávání nestrukturovaných vah nemusí urychlit husté vestavěné jádro; strukturované odstraňování kanálů je pro hardware snazší využít. Destilace přenáší chování z většího učitele, ale může přenést i jeho zkreslení a chyby. Porovnejte se signálovým zpracováním a prahovými referencemi.
Aplikace, testování v terénu a údržba
Běžné úkoly TinyML zahrnují rozpoznávání klíčových slov, detekci probouzecího slova, rozpoznávání gest, detekci vibračních anomálií, obsazenost, akustické události a jednoduché vidění. Model může sloužit jako brána místo konečného rozhodnutí, šetří šířku pásma a posílá nejisté nebo důležité případy do výkonnějšího systému.
Testy v terénu by měly zahrnovat tolerance zařízení, stárnutí senzorů, montáž, stav baterie, teplotu, počasí, uživatele a rušení v pozadí. Sledujte falešné spouštění za hodinu nebo zmeškané události za provozní cyklus, nejen vyváženou přesnost testu. Práh zvolený v laboratoři může vyžadovat kalibraci specifickou pro produkt.
Plánujte podepsané OTA aktualizace, rollback, telemetrii verzí modelu a dlouhá podpora. Pokud jsou aktualizace nemožné, použijte konzervativní modely a dokumentujte očekávaný posun prostředí. Vyřazení musí odvolat přihlašovací údaje zařízení a řešit uložená data, ne jen přestat produkt prodávat.
Praktický příklad: monitor vibrací TinyML
Malý akcelerometr na motoru vzorkuje vibraci při normálním zatížení a známých poruchových podmínkách. Zařízení rozděluje signál do oken, odstraňuje offset, počítá kompaktní rysy v časové nebo frekvenční doméně a spouští detektor anomálií nebo klasifikátor. Vzorkovací frekvence musí zachytit relevantní frekvence ložisek a hřídele, aniž by přetížila paměť nebo energii. Štítky by měly pocházet z ověřených kontrol, ne jen z alarmu, který může být sám nesprávný.
Trénink probíhá na pracovním stanici, následně následuje kvantizace, konverze a kompilace pro cílový mikrořadič. Měřte flash modelu, špičkovou RAM, dobu provádění, energii a přesnost na fyzickém zařízení. Celé aritmetické operace a dostupnost operátorů mohou změnit výstupy oproti tréninkovému modelu. Testujte orientaci senzoru, montáž, teplotu, napětí, variaci komponent a skutečnou vibrační šum v pozadí, ne jen kurátorské laboratorní soubory.
Nasazené zařízení potřebuje kalibraci, zabezpečené aktualizace firmwaru, hlášení verzí, chování při selhání a plán pro posun. Může přenášet jen ukazatel zdraví nebo vybrané rysy, aby šetřilo energii a chránilo surová data, ale místní falešné poplachy stále vytvářejí náklady na údržbu. Použijte stupňovaný práh, vyžadujte trvalost a kombinujte důkazy modelu s provozním stavem. TinyML je nejcennější, když lokální latence, soukromí, konektivita nebo energetické omezení ospravedlňují jeho inženýrské limity.
Produkční testování by mělo zahrnovat obnovu po výpadku napájení, posun hodin, odpojení senzoru, poškozený vstup, vyčerpání paměti a přerušené aktualizace. Definujte, co se stane, když model nemůže běžet nebo se důvěra zhroutí: bezpečná výchozí hodnota, explicitní indikátor chyby nebo konvenční pravidlo může být vhodnější než tichý odhad. Sledujte verze hardwaru a firmwaru flotily, aby nově zaznamenaná chyba mohla být izolována k revizi zařízení, prostředí nebo vydání modelu.
Praktický kontrolní seznam implementace
Převěďte koncept na omezený, testovatelný pracovní postup: snímat → předzpracovat → inferovat → rozhodnout → jednat → aktualizovat. Určete odpovědnou osobu, zdokumentujte data a závislosti, stanovte jednoduchý výchozí stav, definujte kritéria přijetí a zastavení, otestujte reprezentativní selhání a stanovte monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před spuštěním proveďte zdokumentovanou revizi připravenosti s lidmi, kteří systém staví, provozují, zabezpečují a jsou jím ovlivněni. Testujte běžné případy, hraniční podmínky, selhání závislostí a zneužití; uchovejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit práh, přepsat výstup nebo zastavit provoz. Přehodnoťte rozhodnutí po získání reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon v širším měřítku.
- Paměť: váhy, aktivace a buffery.
- Energie: pracovní cyklus a přenos dat.
- Kvalita: přesnost v terénu za reálných podmínek.
Často kladené otázky
Je TinyML to samé jako mobilní AI?
Ne přesně. Mobilní zařízení jsou edge systémy s relativně velkými procesory a pamětí. TinyML se zaměřuje na mnohem přísnější omezení vestavěných systémů a mikrořadičů.
Mohou modely TinyML učit se na zařízení?
Většina nasazení trénuje jinde a inferuje na zařízení. Omezená adaptace je možná, ale paměť, energie, stabilita, soukromí a rollback ztěžují trénink přímo na zařízení.
Primární reference












