
Andersonův úhel
DALL-E 2 jen lepí věci dohromady, aniž by chápal jejich vztahy?

 Přidejte Unite.AI mezi své preferované zdroje na Google

Klíčové bodyDALL-E 2 nedokáže reprodukovat základní prostorové vztahy jako „v“ nebo „na“ ve…
Zobrazit více
- DALL-E 2 nedokáže reprodukovat základní prostorové vztahy jako „v“ nebo „na“ ve vygenerovaných obrázcích.
- Pouze 22 % obrázků DALL-E 2 odpovídalo zadání ve studii se 169 účastníky.
- Selhání systému v oblasti vztahů se zhoršují, když trénovacím datům chybí příklady zobrazované události.
Nová výzkumná práce z Harvardské univerzity naznačuje, že rámec pro generování obrázků z textu DALL-E 2 od OpenAI má značné potíže s reprodukcí i vztahů chápaných už kojenci mezi prvky, které složí do syntetizovaných fotografií, navzdory ohromující sofistikovanosti mnoha svých výstupů.
Výzkumníci provedli uživatelskou studii se 169 účastníky, kterým byly předloženy obrázky DALL-E 2 na základě základních lidských principů vztahové sémantiky, spolu s textovými podněty, které je vytvořily. Když se jich zeptali, zda jsou podněty a obrázky související, méně než 22 % obrázků bylo považováno za relevantní k jejich přidruženým podnětům, z hlediska velmi jednoduchých vztahů, které DALL-E 2 měl vizualizovat.

Snímek z testů provedených pro novou práci. Účastníci byli požádáni, aby vybrali všechny obrázky, které odpovídaly podnětu. Navzdory upozornění v dolní části rozhraní všechny obrázky skutečně vznikly z uvedeného podnětu, což účastníci nevěděli. Zdroj: https://arxiv.org/pdf/2208.00005.pdf
Výsledky také naznačují, že zdánlivá schopnost DALL-E spojovat rozdílné prvky může klesat, jak tyto prvky jsou méně pravděpodobné, aby se vyskytly v reálném tréninkovém datovém souboru, který pohání systém.
Například obrázky pro podnět „dítě dotýkající se misky“ získaly 87% souhlasu (tj. účastníci klikli na většinu obrázků jako relevantních k podnětu), zatímco podobně fotorealistické renderování „opice dotýkající se leguána“ dosáhlo pouze 11% souhlasu:

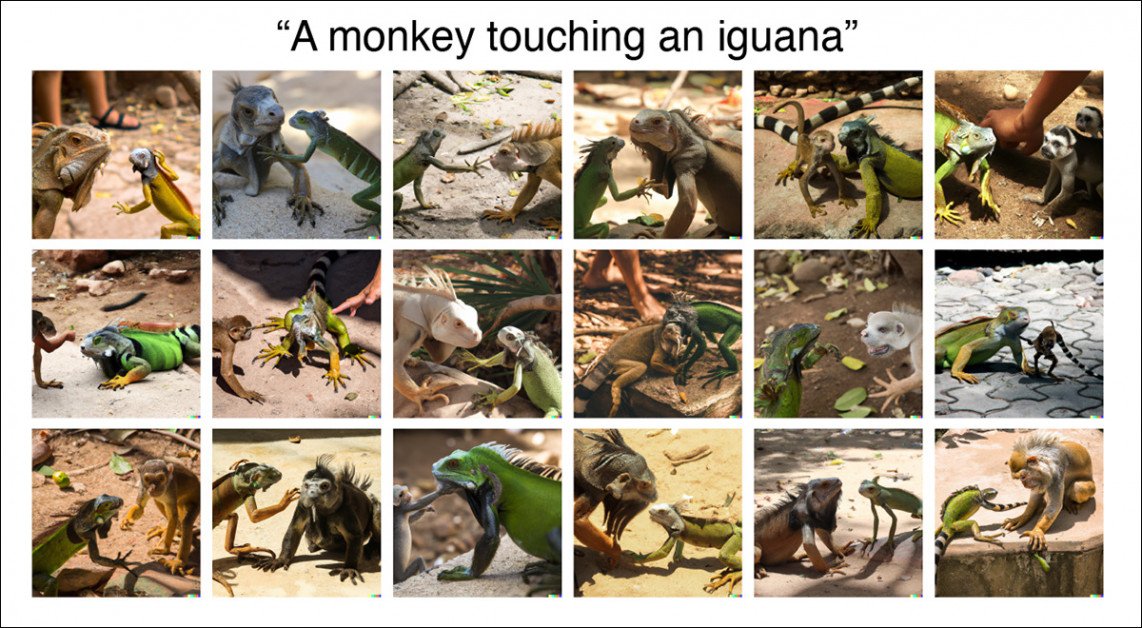
DALL-E má potíže s vykreslením nepravděpodobné události „opice dotýkající se leguána“, nejspíš proto, že taková událost je v tréninkových datech vzácná nebo zcela chybí.
V druhém příkladu DALL-E 2 často chybuje ve velikosti a dokonce i v druhu, pravděpodobně kvůli nedostatku reálných obrázků, které tuto událost zobrazují. Naopak je rozumné očekávat velký počet tréninkových fotografií souvisejících s dětmi a jídlem, a že tato subdoména/třída je dobře rozvinutá.
Obtížnost DALL-E při spojování silně kontrastních obrazových prvků naznačuje, že veřejnost je nyní tak ohromena fotorealistickými a široce interpretativními schopnostmi systému, aby nevyvinula kritické oko pro případy, kdy systém efektivně pouze „přilepil“ jeden prvek na druhý, jako v těchto příkladech z oficiálního webu DALL-E 2:
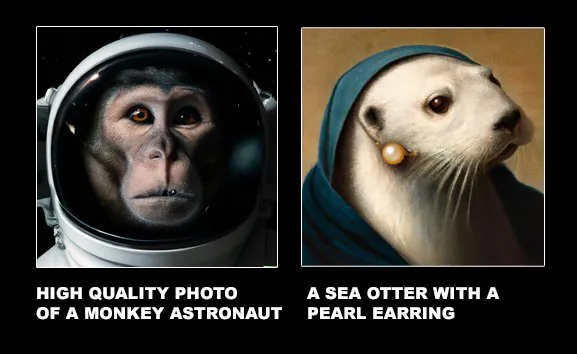
Kombinovaná syntéza, z oficiálních příkladů pro DALL-E 2. Zdroj: https://openai.com/dall-e-2/
Nová práce uvádí*:
‘Relační chápání je základní složkou lidské inteligence, která se objevuje časně ve vývoji, a je vypočítávána rychle a automaticky v percepci.
‘DALL-E 2 má potíže i s základními prostorovými vztahy (jako uvnitř, na, pod) a naznačuje, že systém si dosud neosvojil typy reprezentací, které umožňují lidem flexibilně a robustně strukturovat svět.
‘Přímá interpretace této obtíže je, že systémy jako DALL-E 2 dosud nemají relační kompozicionalitu.’
Autoři navrhují, že systémy textem řízené generace obrazů, jako je DALL-E, by mohly využít algoritmy běžné v robotice, které modelují identity a vztahy současně, kvůli potřebě agenta skutečně interagovat s prostředím, spíše než pouze vytvářet směs různých prvků.
Jedním z takových přístupů je CLIPort, který používá stejný CLIP mechanismus, který slouží jako kvalitativní hodnocení prvků v DALL-E 2:
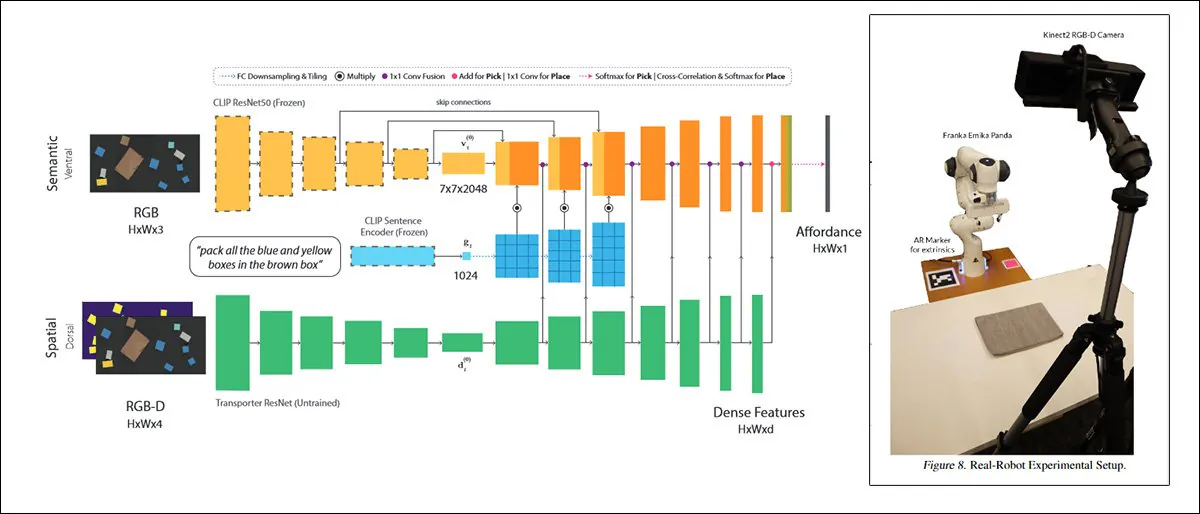
CLIPort, spolupráce z roku 2021 mezi University of Washington a NVIDIA, používá CLIP v kontextu tak praktickém, že systémy trénované na něm musí nutně vyvinout porozumění fyzickým vztahům. Taková motivace chybí v DALL-E 2 a podobných rámcích pro syntézu fantastických obrázků. Zdroj: https://arxiv.org/pdf/2109.12098.pdf
Autoři dále navrhují, že další možný upgrade by mohl být pro architekturu systémů generace obrazů, jako je DALL-E, zahrnout multiplikativní efekty v jediné vrstvě výpočtu, umožňující výpočet vztahů způsobem inspirovaným informačními procesními kapacitami biologických systémů.
Nová práce má název Testování relačního chápání v textem řízené generaci obrazů a pochází od Colina Conwella a Tomera D. Ullmana z Harvardského psychologického oddělení.
Mimo ranou kritiku
Komentář k „falešnému triku“ za realističností a integritou výstupu DALL-E 2, autoři uvádějí předchozí práce, které našly nedostatky v DALL-E-style generativních obrazových systémech.
V červnu tohoto roku, UoC Berkeley uvedl, že DALL-E má potíže s manipulací s odrazy a stíny; stejný měsíc, studie z Koreje prozkoumala „jedinečnost“ a originalitu DALL-E 2-style výstupu s kritickým okem; předběžná analýza DALL-E 2 obrázků, krátce po spuštění, z NYU a University of Texas, nalezla různé problémy s kompozicionalitou a dalšími základními faktory v DALL-E 2 obrazech; a minulý měsíc, společná práce mezi University of Illinois a MIT nabídla návrhy pro architektonická vylepšení takových systémů z hlediska kompozicionality.
Výzkumníci dále uvádějí, že DALL-E luminární, jako je Aditya Ramesh, přiznali problémy frameworku s vazbou, relativní velikostí, textem a dalšími výzvami.
Vývojáři konkurenčního systému Imagen od Googlu navrhli DrawBench, nový srovnávací systém, který měří obrazovou přesnost napříč rámci s různými metrikami.
Místo toho autoři nové práce navrhují, že lepší výsledek by mohl být získán tím, že se bude srovnávat lidské odhady – spíše než algoritmické metriky – s výslednými obrázky, aby se stanovilo, kde leží slabiny, a co by se mohlo udělat, aby je zmírnilo.
Studie
K tomuto účelu se nová práce zakládá na psychologických principech a snaží se ustoupit od současné vlny zájmu v navrhování promptů (což je ve skutečnosti přiznání nedostatků DALL-E 2, nebo jakéhokoli srovnatelného systému), aby prozkoumala a potenciálně řešila omezení, která činí takové „obezličky“ nezbytnými.
Práce uvádí*:
‘Tato práce se zaměřuje na soubor 15 základních vztahů, dříve popsaných, zkoumaných nebo navržených v kognitivní, vývojové či lingvistické literatuře. Soubor zahrnuje konkrétní prostorové vztahy (například „X je na Y“) i abstraktnější vztahy mezi aktéry (například „X pomáhá Y“).
‘Podněty jsou úmyslně jednoduché, bez atributové složitosti nebo rozvoje. To znamená, že místo podnětu, jako je „osel a chobotnice hrající hru. Osel drží lano na jednom konci, chobotnice drží na druhém. Osel drží lano v ústech. Kočka skáče přes lano“, používáme „krabice na noži“.
‘Jednoduchost stále zachycuje širokou škálu vztahů z různých subdomén lidské psychologie a činí potenciální selhání modelu více nápadnými a specifickými.’
Pro svou studii autoři najali 169 účastníků z Prolific, všichni z USA, s průměrným věkem 33 let a 59% žen.
Účastníci byli představeni 18 obrázků organizovaných do 3×6 mřížky s podnětem nahoře a upozorněním na konci, které uvádělo, že všechny, některé nebo žádné obrázky mohly být generovány ze zobrazeného podnětu, a byli požádáni, aby vybrali obrázky, které považovali za související tímto způsobem.
Obrázky představené jednotlivcům byly založeny na lingvistické, vývojové a kognitivní literatuře, skládající se z osm fyzických a sedmi „agenticích“ vztahů (což bude jasné za chvíli).
Fyzické vztahy
uvnitř, na, pod, zakrývající, blízko, zakrytý něčím, visící nad, a přivázaný k.
Agenticí vztahy
tlačící, táhnoucí, dotýkající se, bijící, kopající, pomáhající, a bránící.
Všechny tyto vztahy byly odvozeny z předchozí zmíněných oblastí studia mimo informatiku.
Dvanáct entit bylo takto odvozeno pro použití v podnětech, se šesti objekty a šesti agenty:
Objekty
krabice, válec, deka, miska, šálek, a nůž.
Agenti
muž, žena, dítě, robot, opice, a leguán.
(Výzkumníci přiznávají, že zahrnutí leguána, který není hlavní součástí sociálního nebo psychologického výzkumu, bylo „zábavou“)
Pro každý vztah byly vytvořeny pět různých podnětů náhodným výběrem dvou entit pět krát, což vedlo k 75 celkem podnětů, z nichž každý byl předložen DALL-E 2, a pro každý z nich byly použity počáteční 18 dodaných obrázků, bez jakýchkoli variací nebo druhých šancí.
Výsledky
Práce uvádí*:
‘Účastníci uváděli v průměru nízkou míru souhlasu mezi obrázky DALL-E 2 a podněty, které je vytvořily, s průměrem 22,2 % [18,3, 26,6] napříč 75 rozdílnými podněty.
‘Agenticí podněty, s průměrem 28,4 % [22,8, 34,2] napříč 35 podněty, vygenerovaly vyšší souhlas než fyzické podněty, s průměrem 16,9 % [11,9, 23,0] napříč 40 podněty.’

Výsledky studie. Body v černé barvě označují všechny podněty, přičemž každý bod odpovídá jednomu podnětu. Barva rozlišuje vztahy mezi aktéry od fyzických vztahů mezi objekty.
Pro srovnání rozdílu mezi lidským a algoritmickým vnímáním obrázků, výzkumníci provedli renderování prostřednictvím open source ViT-L/14 CLIP-based frameworku. Průměrné skóre ukázalo „mírný vztah“ mezi dvěma sadami výsledků, což je možná překvapivé, vzhledem k tomu, jak CLIP sám přispívá k generování obrázků.

Výsledky srovnání CLIP (ViT-L/14) proti lidským odpovědím.
Výzkumníci sugerují, že jiné mechanismy v architektuře, možná v kombinaci s náhodnou převahou (nebo nedostatkem) dat v tréninkovém souboru, mohou být zodpovědné za způsob, jakým CLIP může rozpoznat omezení DALL-E, aniž by mohl vždy něco udělat, aby problém vyřešil.
Autoři uzavírají, že DALL-E 2 má pouze nominální schopnost reprodukovat obrázky, které zahrnují relační chápání, fundamentální složku lidské inteligence, která se vyvíjí u nás velmi brzy.
‘Nápad, že systémy jako DALL-E 2 nemají kompozicionalitu, může být překvapující pro kohokoli, kdo viděl DALL-E 2 ohromující odpovědi na podněty, jako je „kreslená malá ředkev daikon v baletní sukénce venčící pudla“. Podněty, jako tyto, často generují rozumnou aproximaci kompozicionálního konceptu, se všemi částmi podnětu přítomnými a na správných místech.
‘Kompozicionalita však není pouze schopnost „lepit“ věci – i věci, které jste nikdy předtím neviděli společně. Kompozicionalita vyžaduje porozumění pravidlům, která věci spojují. Vztahy jsou taková pravidla.’
Člověk kousne T-Rexe
Názor Jak OpenAI zpřístupňuje většímu počtu uživatelů po nedávné beta komercializaci DALL-E 2, a od té doby, co je nyní nutné platit za většinu vytvořených obrázků, mohou se nedostatky v relačním chápání DALL-E 2 stát více zřejmými, protože každý „neúspěšný“ pokus má finanční váhu, a refundace nejsou k dispozici.
Ti z nás, kteří dostali pozvánku trochu dříve, měli čas (a, až do nedávna, větší volnost hrát se systémem) pozorovat některé „vztahové chyby“, které DALL-E 2 může emitovat.
Například pro fanouška Jurassic Park je velmi obtížné dostat dinosaura, aby pronásledoval člověka v DALL-E 2, i když koncept „pronásledování“ zjevně není v cenzurním systému DALL-E 2, a i když dlouhá historie dinosaurů ve filmech by měla poskytnout dostatečné tréninkové příklady (alespoň ve formě trailerů a propagačních snímků) pro toto jinak nemožné setkání druhů.
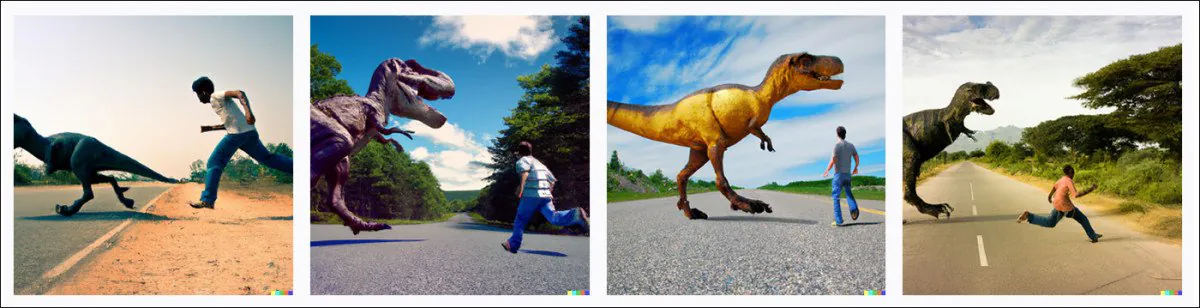
Typická odpověď DALL-E 2 na podnět „barevná fotografie T-Rexe pronásledujícího muže po silnici“.
Já jsem našel, že obrázky výše jsou typické pro varianty podnětu „[dinosaurus] pronásledující [člověka]“, a že žádná elaborace podnětu nemůže dostat T-Rexe, aby pokyn skutečně splnil. Na první a druhé fotografii člověk víceméně pronásleduje T-Rexe; na třetí se k němu přibližuje s lehkomyslnou lhostejností k bezpečí a na poslední běží souběžně s velkým zvířetem. Při zhruba 10–15 pokusech na toto téma jsem zjistil, že dinosaurus je podobně „rozptýlený“.
Mohlo by to být, že jedinými tréninkovými daty, které DALL-E 2 mohl získat, byly v řadě „člověk bojuje s dinosaurem“, z propagačních snímků starších filmů, jako je One Million Years B.C. (1966), a že slavný útěk Jeffa Goldbluma od krále predátorů je prostě outlier v této malé sadě dat.
* Mé konverze autorů inline citací na hypertextové odkazy.
Poprvé zveřejněno 4. srpna 2022.





