
Rozhovory
Gil Elbaz, spoluzakladatel a technický ředitel Datagen – rozhovor

 Přidejte Unite.AI mezi své preferované zdroje na Google
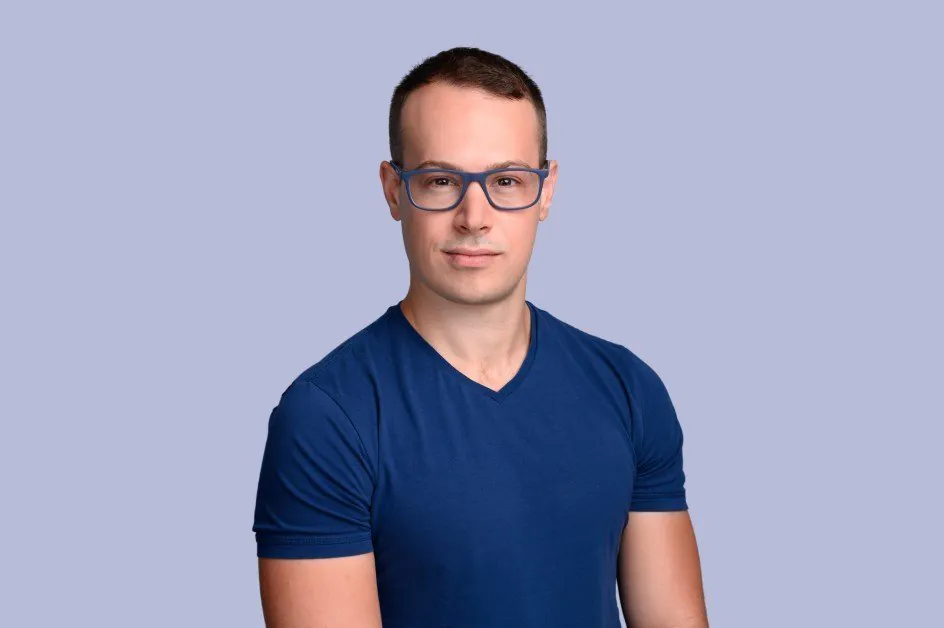
Gil Elbaz je technickým ředitelem a spoluzakladatelem Datagen, se sídlem v Tel Avivu. Vystudoval bakalářský a magisterský titul na Technionu. Výzkumná práce Gila Elbaze se zaměřila na 3D počítačové vidění a byla publikována na konferenci CVPR, která je nejvýznamnější konferencí o počítačovém vidění na světě. Datagen je průkopníkem v novém oboru Simulovaných dat, které jsou podmnožinou syntetických dat a zaměřují se na fotorealistické znázorňování světa kolem nás. Společnost vyšla ze stealth módu s více než 18 miliony dolarů ve financování v březnu 2021 a nyní spolupracuje s mnoha společnostmi z žebříčku Fortune 100 v oblasti rozšířené a virtuální reality, robotiky a automobilového průmyslu, včetně většiny předních amerických technologických gigantů.
Co vás původně přitáhlo k robotice a strojovému učení?
Knihy science fiction, jako je série Nadace od Isaaca Asimova a iRobot, mě vždycky fascinovaly a vedly mě k úvahám o budoucnosti, ve které roboti budou nedílnou součástí našeho každodenního života. Existuje tolik nudných a opakujících se úkolů, které lidé vykonávají; nevěděl jsem, zda chci dělat něco podobného, a nemohl jsem si představit, že by to chtěl dělat někdo jiný. Pokud se jedná o robotiku jako technologickou nevyhnutelnost, myslel jsem si, že směřovat do tohoto směru bude chytré a „budoucnost odolné“ kariérní rozhodnutí.
Na začátku jsem se tedy zaměřil na fyzické aspekty tohoto oboru a získal titul v oboru strojního inženýrství na Technionu v Haifě v Izraeli. Ke konci svého studia jsem začal hluboce pronikat do světa nástrojů a schopností CAD. Tyto nástroje umožňují strojním inženýrům navrhovat struktury a mechanická zařízení (od mostu po auto). Viděl jsem obrovskou příležitost udělat velký dopad bez nutnosti pomalých iterací fyzického světa. V praxi tyto programy měly velmi málo, pokud vůbec nějaké, schopnosti strojového učení a počítačového vidění, které by pomohly inženýrům vytvářet jednodušší, levnější a stabilnější mechanické systémy (to bylo v roce 2015). Zaměřil jsem se na směr počítačového vidění na 3D datech s hlubokým učením (velmi novým v té době) s cílem vytvořit chytřejší programy CAD. Práce v raných dnech moderního hlubokého učení mi dala pocit, že jsem součástí něčeho, co by mohlo být opravdu velké – podobně jako internet.
V praxi byla moje výzkumná práce první, která přinesla revoluci hlubokého učení na naší fakultě na Technionu. To se později změnilo v článek, který byl přijat na nejvýznamnější konferenci o počítačovém vidění na světě, CVPR, a letěl jsem na CVPR 2017 do Havaje. Prezentace mé práce a setkání s lidmi mi otevřeli oči širšímu měřítku komunity počítačového vidění (která je dnes alespoň 10x větší), tisíců účastníků, kteří vášnivě pracují na výzkumu v tomto oboru. Tato událost prakticky utvrdila můj směr a ukázala mi sílu počítačového vidění a potenciál, který čeká na své odhalení.
Můžete sdílet příběh o vzniku Datagen?
Datagen byl založen v roce 2018 s cílem transformovat, jak týmy získávají data pro trénování počítačového vidění. Rok předtím jsme viděli demo Oculus Rift, který se skládal z VR headsetu a ručního ovladače. Po demo jsme se sami sebe ptali: „S takovými pokročilými kamerami vestavěnými do headsetu, proč je potřeba ruční zařízení pro propojení virtuálního prostoru s fyzickým prostorem (tj. sledování pohybu ruky)?“ Neuronové sítě byly již dostatečně pokročilé, aby to zvládly, takže co byl problém?“ A tehdy nám to došlo — Data! Okamžitě jsme viděli obrovskou příležitost vyřešit 3D prostorové problémy pomocí pokročilého počítačového vidění a 3D metadata. Rather než se zaměřit pouze na VR/AR, jsme se rozhodli pro holističtější přístup, soustředěný na zdánlivě neřešitelný problém generování dostatečných (a přesných) trénovacích dat pro umožnění reálných 3D aplikací AI.
S zaměřením na lidi a interakci člověka a prostředí je Datagen průkopníkem v novém oboru Simulovaných dat, které jsou podmnožinou syntetických dat a zaměřují se na fotorealistické znázorňování světa kolem nás. Dnes spolupracujeme s nejvíce inovativními společnostmi na světě, abychom urychli a podpořili vývoj počítačového vidění, a máme podporu od některých z nejuznávanějších investorů v tomto oboru.
Pro čtenáře, kteří nejsou seznámeni, můžete vysvětlit, co přesně jsou syntetická data?
Syntetická data jsou jakákoli trénovací data, která nejsou získávána přímým měřením nebo pozorováním reálného světa, ale jsou generována algoritmicky nebo simulací. V kontextu počítačového vidění jsou syntetická data počítačově generovanými obrázky s přidruženým metadatem potřebným pro trénování umělých inteligencí. S problémy s ochranou soukromí a skutečnými fyzickými a ekonomickými omezeními reálných dat je těžké přehánět význam syntetických dat pro strojové učení a AI. V nedávné zprávě Gartner předpověděl, že do roku 2024 bude většina dat používaných v oblasti AI umělými.
Jaké jsou některé výhody syntetických dat ve srovnání s manuálním získáváním dat?
Krátká odpověď je, že si představte každý aspekt manuálního získávání dat, který je nežádoucí, a odstraňte je z procesu — ty jsou výhody syntetických dat.
Generování rozmanitých datových sad ve velkém měřítku pro trénování počítačového vidění je nákladný a časově náročný proces, a variabilita je velmi omezená samotným faktem, že umístění lidí do konkrétních lokalit a fotografování je komplikovaný proces — mnohem komplikovanější a nákladnější než dělat to v simulovaném prostředí. Další velkou výhodou je efektivní odstranění potřeby manuální anotace, která je nudná, časově náročná a náchylná k lidským chybám.
Datagen označuje simulovaná data jako podmnožinu syntetických dat. Můžete vysvětlit, co přesně jsou simulovaná data?
Simulovaná data jsou syntetická data, která jsou generována simulací. Používáme GANs (a některé další pokročilé metody strojového učení) k generování 3D objektů a jejich umístění do vysoce realistických 3D simulací reálného světa. To vypadá jako proces „virtuální fotografie“ z první osoby, ale funguje v rámci fotorealistického, fyzikálně založeného systému. Tyto simulace produkují vizuální data (jako kdyby byla získaná v reálném světě), spolu s kompletním rozsahem anotací (fyzika, osvětlení atd.). Simulovaná data jsou tedy syntetická data, která jsou fotorealistická, kontextově generovaná, 3D obrazová data, získaná v simulovaném prostředí.
Jak Datagen generuje přizpůsobená simulovaná data?
Technologie Datagen generuje simulovaná data, která jsou nejen snadno škálovatelná, ale také přizpůsobená konkrétním potřebám každého zákazníka. Bereme v úvahu každý aspekt každého projektu — od počítačového vidění použitého v systému po demografické složení regionu, ve kterém bude fungovat. Pokud pracujeme přímo se zákazníky nebo umožňujeme jejich inženýrům, proces Datagen začíná stanovením klíčových parametrů pro každou konkrétní použití, jako jsou specifikace objektivu, osvětlení, prostředí, demografické rozložení atd. Datagen používá GANs a další pokročilé nástroje a techniky k generování obrovského množství aktiv, včetně všeho od lidských hlav s dynamickými mimickými výrazy pro trénování AI v emoční analýze až po interiéry vozidel pro monitorování cestujících uvnitř kabiny a domácí prostředí pro aplikace video konferencí, abychom jmenovali alespoň einige. Pro každý typ aktiva Datagen zavádí variabilitu přes nesčetné diskrétní osy (od tónu pleti a tvaru obočí až po velikost, barvu a tvar domovního nábytku), pomocí parametrů, které jsou jemně naladěny na konkrétní použití.
Díky těmto schopnostem jsou datové sady Datagen nejen velké a vysoce variabilní, ale také optimalizované pro účely trénování unikátního systému pro výkon unikátní úlohy (nebo sadu úkolů) v unikátním prostředí nebo nastavení, ve kterém bude fungovat — vše bez kompromisů ve škálovatelnosti. Bereme v úvahu také konkrétní požadavky na anotaci/metadata pro každou aplikaci.
Jaké jsou některé příklady řešení v robotice, kde se používají syntetická a/nebo simulovaná data?
Jednou z největších výhod používání simulovaných dat v robotice je schopnost generovat obrázky hardwaru, který je stále ve vývoji. Tímto způsobem může být „mozek“ robota (AI) a „tělo“ (hardware) vyvíjeno současně. Nyní může trénink postupovat, jakmile se specifikace vyvíjí, místo aby se čekalo, až bude konečný produkt plně prototypován, než se mohou začít vyvíjet AI.
Kromě toho lze simulovaná data generovat v kontextu, aby se zohlednila interakce mezi robotem a jeho prostředím. Pokud si představíte robota, který odstraňuje vadné produkty z výrobní linky, simulovaná data by umožnila generovat data pro každý fyzický defekt produktu, ale také z perspektivy robota, aby zachytil plný rozsah pohybu robota, jeho interakci s objektem, který drží. Navíc 3D metadata znamenají, že není třeba pečlivě anotovat obrázky, aby robot mohl správně identifikovat produkt, defekty, svou paži nebo cokoliv jiného ve svém zorném poli.
Jaké jsou některé použití simulovaných dat ve vývoji chytrých aut?
Simulovaná data ve vývoji chytrých aut usnadňují vývoj datových sad pro konkrétní modely aut, zatímco jsou navrhovány. Inženýři mohou také efektivněji využívat vidění uvnitř kabiny k identifikaci unavených nebo rozptýlených řidičů, zda řidič sundal ruku z volantu nebo jakýkoli jiný krajní případ pro zajištění bezpečnosti řidiče. To také umožňuje inženýrům zohlednit větší rozmanitost řidičů a cestujících a zavést variabilitu ve formě úhlu pohledu a osvětlení — vše bez porušení soukromí skutečných lidí.
Nedávno Datagen oznámil velký počet zajímavých nových náborů, co to znamená pro budoucnost společnosti?
Nedávné doplnění našeho poradního sboru a vedení zahrnuje některé z nejchytřejších a nejzkušenějších profesionálů v oblasti AI a počítačového vidění. Jejich znalosti, vhled a zkušenosti pomohou orientovat a urychlit růst Datagen, zatímco navigujeme v průmyslu, který je stále mladý a plný příležitostí. V oblasti s tolik neznámými není nic cennějšího než znalosti.
Je něco jiného, co byste rádi sdíleli o Datagen?
Založený v Tel Avivu je Datagen součástí mnohem větší ekonomické a kulturní změny, ke které došlo v Izraeli, a jsme hrdí být její součástí. V krátké době se Izrael (zejména Tel Aviv) stal významným globálním technologickým centrem s rozkvétajícím ekosystémem startupů a energickým investičním společenstvím. Ačkoli je Izrael často považován za centrum kybernetické bezpečnosti, AI a datové technologie zde vyrostly exponenciálně v posledních letech. Dnes je v Izraeli více než 680 společností zabývajících se umělou inteligencí, které společně získaly 4,5 miliardy dolarů. Tento explozivní růst v posledních letech je způsoben zejména vysokou koncentrací inženýrů a světově proslulých univerzit v Izraeli. Tyto akademické instituce poskytují přístup k talentům a nejnovějším technologiím ve vývoji. V posledních dvou měsících Datagen najal více než 20 zaměstnanců a plánuje přijmout další členy týmu v prodeji a marketingu, softwaru a DevOps a produktových odděleních.
Děkuji za skvělý rozhovor, čtenáři, kteří si chtějí dozvědět více, by měli navštívit Datagen.


