
Rozhovory
Ben Koska, zakladatel a CEO SF Tensor – rozhovorová série

 Přidejte Unite.AI mezi své preferované zdroje na Google
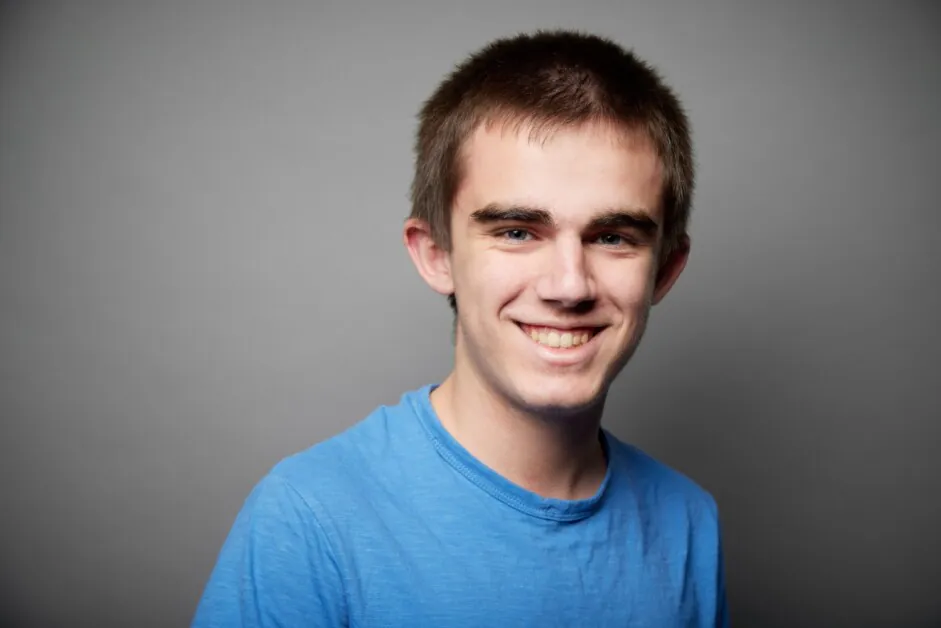
Ben Koska, zakladatel a CEO SF Tensor, je výzkumník v oblasti umělé inteligence a systémový inženýr, známý svou prací na high-performance compute, optimalizaci jader a efektivnímu tréninku modelů. Jeho pozadí zahrnuje vývoj low-level AI infrastruktury, zlepšování propustnosti tréninku a návrh nástrojů, které umožňují pokročilý vývoj modelů bez těžkého inženýrského zatížení. Snaží se o budování systémů, které tlačí hranice rychlosti, portability a spolehlivosti napříč heterogenními hardwarovými zařízeními.
SF Tensor je společnost, kterou vede, aby proměnil tuto filozofii v praktickou platformu. Představuje jednotný programovací model, optimalizátor jader a vrstvu orchestrace napříč cloudy, navrženou tak, aby odstranila složitost distribuovaných AI úloh. Platforma má za cíl poskytnout inženýrům čistší, hardwarově nezávislé prostředí, ve kterém mohou psát kód jednou a nasazovat jej kdekoliv, a automaticky dosahovat vysokých výkonů. Misí SF Tensor je učinit AI výpočet dramaticky rychlejším, snadněji spravovatelným a zbavit se uzamčení dodavatelů.
Založil jste SF Tensor ve věku 19 let, poté co jste již vedl inženýrství ve více startupových firmách. Co vás inspirovalo k tomu, abyste se ujali výzvy reinvenčního AI infrastruktury tak brzy ve své kariéře?
Problém, který řešíme, je ten, o kterém jsem hluboce přesvědčen, protože jsem si s ním sám poradil. Když jsme vyvinuli to, co je nyní jádrem SF Tensor, nepracovali jsme na komerčním projektu, ale na akademickém úkolu. Dostali jsme grant na provedení některých zajímavých výzkumů, ale většinu času jsme strávili řešením infrastruktury a optimalizací, místo aby jsme se věnovali výzkumu. Zjistili jsme, že lidé byli univerzálně více intéressovaní o naší infrastrukturní technologii, než o náš výzkumný projekt.
SF Tensor se zabývá jednou z nejobtížnějších problémů v AI — osvobozením se od dominance NVIDIA CUDA. Jak jste přistupoval k návrhu systému, který by mohl dosáhnout skutečné hardwarové portability bez kompromisů v oblasti výkonu?
Na konci dne se všechny AI redukují na jednoduchou matematiku. Každý model je v podstatě souborem matematických operací, které musíme vypočítat. Tím, že se na to díváme primárně jako na matematický problém, a ne jako na problém počítačové vědy, můžeme identifikovat nejmenší sadu omezení pro výpočty a poté vygenerovat miliony až miliardy různých způsobů, jak tyto výpočty převést na strojový kód, a najít ten nejrychlejší. To je snazší říci než udělat, protože nemůžeme skutečně spustit miliardy různých programů, abychom našli ten nejrychlejší, takže jsme museli vytvořit přesný matematický model, abychom odhadli rychlost daného programu pro dané hardwarové zařízení, což je jedna z hlavních inovací, které činí naše současné možnosti možné.
Společenský blog zdůrazňuje inovace v oblasti kompilátorové optimalizace a cross-cloud orchestrace. Můžete vysvětlit, jak se přístup SF Tensor liší od stávajících rámců, jako je PyTorch nebo JAX?
Ještě jsme nenapsali technický blog o tom, ale ve skutečnosti podporujeme rámce, jako je PyTorch a JAX, a umožňujeme kódu, napsanému v nich, být optimalizovaným našim systémem. Existuje několik architektonických rozhodnutí, která JAX a PyTorch učinily, a která je odlišují od našeho systému, ale nejvýznamnější z nich je, že pohlížíme na celý model jako na jeden výpočet, který musí být vyřešen, místo jednotlivých modulů, které musí být individuálně a poté společně optimalizovány. V tomto smyslu místo tradičních kompilátorových optimalizačních technik a aplikací jednotlivých optimalizací vytváříme prostor pro vyhledávání milionů až miliard potenciálních jader a tvrdíme, že žádný člověk nemůže vytvořit soubor pravidel pro transformaci libovolného kódu do nejrychlejšího, takže místo toho musíme vytvořit všechny kombinace a poté identifikovat ten nejrychlejší.
Mnohé startupy se soustředí na efektivitu tréninku, ale jste zdůraznili „infrastrukturní daň“ — čas, který výzkumníci ztrácejí při správě výpočtů místo inovace. Jak SF Tensor řeší tento nesoulad?
Věříme, že obě problémy musí být řešeny, a mnoho naší práce se soustředí na řešení efektivity tréninku, ale nejaktuálnějším problémem, který můžeme řešit bez budoucích inovací, je infrastrukturní daň, protože je to problém, který jsme již sami vyřešili.
Uvedl jste, že dosáhli jste až 80% snížení nákladů na trénink. Jaké konkrétní optimalizace nebo architektonické průlomy činí toto možné?
Náš celý softwarový stack je postaven na myšlence, že vyhledávací kompilátor vždy porazí lidsky vytvořená pravidla. Dosud největší omezení těchto kompilátorů spočívá v tom, že není možné testovat a řadit miliardy nebo dokonce miliony jader. Bylo proto nezbytné vytvořit matematický model výpočtu, který je schopen přesně odhadnout čas, který bude trvat výpočet dané operace nebo sady operací na daném hardwarovém zařízení. Tímto způsobem jsme schopni rozšířit náš vyhledávací prostor a poté jej zúžit, což je nezbytné pro nalezení nejrychlejších jader.
Jak ovlivnil váš背景 v oblasti vývoje programovacího jazyka Emma architekturu a filozofii SF Tensor směrem k výkonu a abstrakci?
Nepovídejte mému investorovi, ale v srdci jsem stále kompilátorový inženýr. Vždy jsem byl fascinován hledáním různých způsobů, jak věci udělat alespoň o trochu rychlejší. Při vývoji Emma jsme vyhodili celý kompilátor 4 nebo 5krát; začali jsme od začátku, protože jsme narazili na optimalizaci, kterou jsme nemohli implementovat vzhledem k současným omezením, což nás donutilo přepracovat systém, aby byl ještě obecnější, zatímco stále umožňoval nám spadnout na nejnižší úroveň optimalizace, když to bylo nezbytné, často proti běžným principům kompilátorového a jazykového designu. Tyto znalosti a výsledná architektura kombinují téměř dva roky toho, co vypadalo jako malé optimalizace a špatné sázky, které se sčítají do systému, který nám nyní umožňuje iterovat rychleji a optimalizovat lépe než systémy, které následovaly běžné principy, protože tyto principy jsou fundamentálně navrženy pro CPU, ne pro GPU a AI modely.
Pracoval jste na velkých škálách tréninkových běhů napříč 4 000+ GPU — jaké byly některé z největších lekcí, které jste se naučili při správě výpočtů v takové škále?
Velká lekce je, že hardwarová selhání jsou mnohem častější a problematická, než by se mohlo zdát. Když jsem strávil hodně času prací s tradičními programy a kompilátory, obecně platí, že počítač dělá přesně to, co mu bylo řečeno, a pokud něco jde špatně, je to téměř vždy chyba člověka, který napsal kód. S GPU je hardwarová selhání běžná, zejména při distribuovaném tréninku na velmi velkých clusterech. Související s tím je fakt, že na rozdíl od CPU, které obecně fungují deterministicky a předvídatelně, GPU někdy nečekaně dělají věci, jako je snížení taktovací frekvence bez zjevného důvodu, zpomalování celého tréninkového procesu, protože jeden čip běží pomaleji.
Y Combinator podpořil některé z nejtransformativnějších infrastrukturních společností v technologickém odvětví. Jak zkušenost s touto společností ovlivnila váš přístup ke škálování produktu a vize SF Tensor?
Při vstupu do Y Combinator jsem si myslel, že sázka, kterou jsme chtěli učinit, byla ambiciózní. Po několika týdnech se naše definice ambice dramaticky změnila a my jsme se rozhodli pro ještě větší sázku. Kromě toho smysl pro komunitu a učení, které jsem mohl získat tím, že jsem mohl zavolat nebo poslat e-mail téměř jakékoli společnosti nebo osobě a získat odpověď a rady do několika hodin nebo dnů, změnilo způsob, jakým přemýšlíme o řešení problémů a přijímání mnohem více spolupracujícího přístupu.
Pohledem do budoucna jste vyjádřil zájem o ne-LLM modely, robotiku a syntetická data. Jak tyto oblasti zapadají do vaší dlouhodobé vize pro společnost?
LLM jsou absolutně zajímavou technologií a budou mít integrovanou roli v tom, jak bude svět vypadat v budoucnu, ale důvod, proč jsou tak pokročilé ve srovnání s jinými oblastmi AI, spočívá主要ně v tom, že do jejich vývoje je investováno hodně peněz a že je dostatek lidí, kteří spolupracují na řešení problému, takže se staly bastante optimalizovanými. Pokud můžeme snížit bariéru vstupu a umožnit výzkumníkům po celém světě, i těm s omezenými zdroji a málo znalostmi o optimalizacích, provádět výzkum co nejlevněji a nejefektivněji, myslím, že uvidíme novou generaci modelů, které budou řešit problémy, pro které LLM nejsou vhodné, ať už proto, že interagují s fyzickým světem, nebo proto, že jsou problémy, které nelze správně vyjádřit v jazyce.
Co si myslíte, že bude AI infrastrukturní zásobník vypadat za pět let — a kde vidíte roli SF Tensor v něm?
Za pět let doufám, že mnoho společností bude mít vyvinuté a vydáno své vlastní specializované čipy, a že výzkumníci budou moci využívat a využívat je bez nutnosti psát kód specificky pro ně, ideálně aniž by museli vědět, že existují. To je budoucnost, na kterou jsme zaměřeni a kterou, myslím, budeme hrát významnou roli při jejím formování.
Děkuji za skvělý rozhovor, čtenáři, kteří chtějí se dozvědět více, by měli navštívit SF Tensor.


