
Rozhovory
Amy Steier, hlavní výzkumná pracovnice v oblasti strojového učení v Gretel.ai – Série rozhovorů

 Přidejte Unite.AI mezi své preferované zdroje na Google
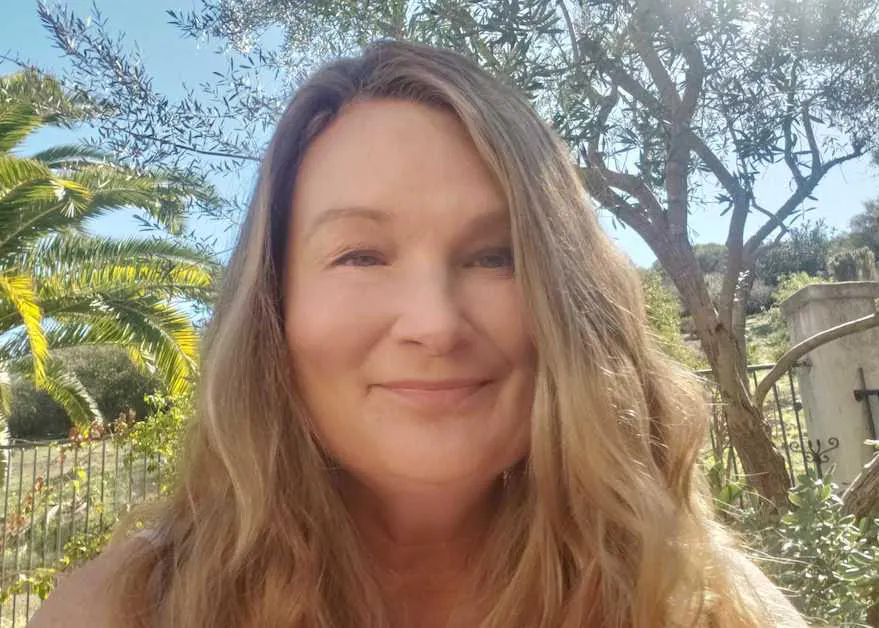
Amy Steier je hlavní výzkumná pracovnice v oblasti strojového učení ve společnosti Gretel.ai, nejpokročilejší platformy pro inženýrství soukromí na světě. Gretel umožňuje snadno integrovat soukromí do datové technologie. Jeho AI-založené, open-sourced knihovny jsou navrženy pro transformaci, anonymizaci a syntetizaci citlivých informací.
Amy je velmi zkušená odbornice na strojové učení a datovou vědu s více než 20 lety zkušeností. Její vášní je big data a odhalování skrytých inteligencí pomocí technik strojového učení, data mining, umělé inteligence a statistiky. Je velmi zkušená v prediktivním modelování, klasifikaci, clusterování, detekci anomálií, datové visualizaci, ensemble metodách, informačním vyhledávání, kybernetické bezpečnosti, NLP, doporučovacích modelech a analýze chování uživatelů.
Co vás původně přitáhlo k tomu, abyste se věnovali kariéře v počítačových vědách a strojovém učení?
Má čistá, nezkrotná a trvalá láska k datům. Síla, tajemství, intrika a potenciál dat mě vždy fascinovaly. Počítačové vědy a strojové učení jsou nástroje pro využití tohoto potenciálu. Je také velmi zábavné pracovat v oboru, kde se nejmodernější technologie pohybuje tak rychle. Miluji průnik výzkumu a produktu. Je velmi uspokojivé brát nejnovější nápady, trochu je posunout a poté je transformovat, aby vyhovovaly existujícím, hmatatelným produktovým potřebám.
Pro čtenáře, kteří nejsou seznámeni, můžete vysvětlit, co jsou syntetická data?
Syntetická data jsou data, která vypadají a chovají se jako původní data, ale jsou také dostatečně odlišná, aby splňovala určitý účel. Nejčastější účel je potřeba chránit soukromí informací v původních datech. Další účel je potřeba vytvořit další data, aby se zvýšila velikost původní datové sady. Dalším využitím je náprava nerovnováhy tříd nebo demografického zkreslení v původních datech. Syntetická data umožňují pokračovat ve vývoji nových a inovativních produktů a řešení, i když by jinak nebyla k dispozici potřebná data.
Jak funguje platforma Gretel pro vytváření syntetických dat prostřednictvím API?
Gretelovy API pro inženýrství soukromí umožňují ingestovat data do Gretel a prozkoumat data, která jsme schopni extrahovat. Tyto API jsou stejné jako ty, které používá naše Konzole. Exponováním API prostřednictvím intuitivního rozhraní doufáme, že budeme moci povzbudit vývojáře a datové vědce, aby vytvářeli své vlastní pracovní postupy kolem Gretel.
Konzole sice vytváření syntetických dat výrazně usnadňuje, API však umožňují začlenit jejich tvorbu do vlastního pracovního postupu. API používám ráda, protože mohu tvorbu dat přizpůsobit velmi konkrétnímu účelu.
Můžete diskutovat o některých nástrojích, které nabízí Gretel, aby pomohly posoudit kvalitu syntetických dat?
Po vytvoření syntetických dat Gretel vygeneruje Syntetickou zprávu. V této zprávě můžete vidět Skóre kvality syntetických dat (SQS), jakož i stupeň ochrany soukromí (PPL).
Skóre SQS je odhad, jak dobře generovaná syntetická data udržují stejné statistické vlastnosti jako původní datová sada. V tomto smyslu lze skóre SQS považovat za skóre užitečnosti nebo důvěru, zda vědecké závěry získané ze syntetické datové sady by byly stejné, kdyby se místo toho použila původní datová sada.
Skóre kvality syntetických dat kombinuje tři jednotlivé ukazatele: stabilitu rozdělení hodnot v polích, stabilitu korelací mezi poli a stabilitu hlubší struktury. První ukazatel měří zachování původního rozdělení hodnot v jednotlivých polích. Druhý měří zachování korelací mezi poli. Třetí hodnotí statistickou integritu hlubších rozdělení a korelací zahrnujících více polí. Gretel ji odhaduje porovnáním analýzy hlavních komponent (PCA) provedené na původních a poté na syntetických datech.
Jak fungují filtry soukromí Gretel?
Filtry soukromí Gretel byly výsledkem rozsáhlého výzkumu o povaze adversárních útoků na syntetická data. Filtry soukromí zabraňují vytváření syntetických dat se slabostmi, které jsou běžně využívány adversárními útoky. Máme dva filtry soukromí, první je Similarity Filter a druhý je Outlier Filter. Similarity Filter zabraňuje vytváření syntetických záznamů, které jsou příliš podobné trénovacím záznamům. Tyto jsou primární cíle adversárních útoků, které se snaží získat informace o původních datech. Druhý filtr soukromí je Outlier Filter. Tento zabraňuje vytváření syntetických záznamů, které by byly považovány za outliery v prostoru definovaném trénovacími daty. Odlehlé hodnoty v syntetické datové sadě lze zneužít při útocích odvozujících příslušnost k trénovací sadě, při odvozování atributů a při řadě dalších útoků. Představují vážné riziko pro soukromí.
Jak mohou syntetická data pomoci snížit předpojatost AI?
Nejběžnější technika je řešit reprezentační předpojatost dat, která vstupují do systému AI. Například, pokud existuje silná nerovnováha tříd v datech nebo demografická předpojatost v datech, Gretel nabízí nástroje, které pomáhají měřit nerovnováhu a poté ji řešit ve syntetických datech. Odstraněním předpojatosti v datech se často odstraní předpojatost v systému AI postaveném na datech.
Zjevně vás baví poznávat nové technologie strojového učení. Jak osobně držíte krok se všemi změnami?
Čtěte, čtete a pak čtete ještě více, lol! Ráda začínám den čtením o nových technologiích strojového učení. Medium mě zná velmi dobře. Ráda čtu články v Towards Data Science, Analytics Vidhya a newsletterů, jako je The Sequence. Facebook (META ) AI, Google (GOOGL ) AI a OpenMined mají skvělé blogy. Existuje spousta dobrých konferencí, které je třeba sledovat, jako NeurIPS, ICML, ICLR, AISTATS.
Mám také ráda nástroje sledující citační řetězce, které pomáhají hledat podobné články, učí se znát vaše zájmy a na pozadí nepřetržitě hledají zajímavé výzkumy. Často používám například Zeta Alpha.
Nelze podceňovat ani přínos kolegů s podobnými zájmy. Tým strojového učení v Gretel sleduje výzkumy související s oblastmi, které zkoumáme, a často se schází k diskusím o zajímavých publikacích.
Jaký je váš výhled do budoucna strojového učení?
Snadný přístup k datům spustí velkou éru inovací ve strojovém učení, které pak pohání inovace v širokém spektru oblastí, jako je zdravotnictví, finance, výroba a biologické vědy. Historicky, mnoho průlomových pokroků ve strojovém učení lze připsat velkému objemu bohatých dat. Historicky, mnoho výzkumů bylo však zpožděno kvůli neschopnosti přístupu nebo sdílení dat z důvodu obav o soukromí. Jak nástroje, jako je Gretel, odstraňují tuto bariéru, přístup k datům bude demokratizován. Celá komunita strojového učení bude mít prospěch z přístupu k bohatým, velkým datovým sadám, místo pouze několika elitních obřích společností.
Je něco jiného, co byste rádi sdíleli o Gretel?
Pokud máte rádi data, budete mít rádi Gretel (takže jasně, že mám ráda Gretel!). Snadný přístup k datům byl trnem v oku každého datového vědce, kterého jsem kdy znala. V Gretel se můžeme pochlubit tím, že jsme vytvořili konzoli a sadu API, které umožňují vytvářet soukromá, sdílená data co nejjednodušeji. Pevně věříme, že data jsou cennější, když jsou sdílena.
Děkuji za skvělý rozhovor a za sdílení vašich poznatků, čtenáři, kteří chtějí se dozvědět více, by měli navštívit Gretel.ai.






