
الأفضل
10 أفضل خوارزميات التعلم الآلي

 أضف Unite.AI إلى مصادرك المفضلة على Google
مع أننا نعيش عصرًا من الابتكار الاستثنائي في التعلم الآلي المسرّع بوحدات معالجة الرسومات، فإن أحدث الأوراق البحثية تتضمن كثيرًا، وبصورة بارزة، خوارزميات عمرها عقود، بل يصل عمر بعضها إلى 70 عامًا.
قد يرى البعض أن كثيرًا من هذه الأساليب القديمة يندرج ضمن «التحليل الإحصائي» لا التعلم الآلي، ويفضّلون تأريخ بداية المجال بعام 1957 فقط، مع اختراع البيرسيبترون.
لكن بالنظر إلى مدى إسهام هذه الخوارزميات القديمة في أحدث اتجاهات التعلم الآلي وتطوراته اللافتة وارتباطها الوثيق بها، يبقى هذا الرأي قابلًا للنقاش. لذا سنستعرض بعض اللبنات «الكلاسيكية» التي تقوم عليها أحدث الابتكارات، إلى جانب خوارزميات أحدث تسعى مبكرًا إلى دخول قاعة مشاهير الذكاء الاصطناعي.
1: المحوّلات
في عام 2017، قاد Google Research تعاونًا بحثيًا توّجته ورقة Attention Is All You Need. عرضت الورقة معمارية جديدة ارتقت بـ آليات الانتباه من مكوّنات مساعدة في نماذج المرمّز/فاكّ الترميز والشبكات المتكررة إلى تقنية تحويلية محورية قائمة بذاتها.
سُمّي هذا النهج المحوّل، وأصبح منذ ذلك الحين منهجية ثورية في معالجة اللغة الطبيعية (NLP)، تقوم عليها، ضمن أمثلة كثيرة، منظومة GPT-3، وهي نموذج لغوي ذاتي الانحدار وأحد رموز الذكاء الاصطناعي.

حلّت المحوّلات بأناقة مشكلة تحويل التسلسلات، التي تُسمّى أيضًا «التحويل»، وتعالج تسلسلات الإدخال لإنتاج تسلسلات الإخراج. ويتلقى المحوّل البيانات ويديرها بصورة متصلة بدلًا من دفعات متتابعة، مما يتيح «استمرارية الذاكرة» التي لم تُصمّم معماريات RNN لتحقيقها. ولعرض أكثر تفصيلًا للمحوّلات، راجع مقالنا المرجعي.
وعلى خلاف الشبكات العصبية المتكررة (RNN) التي بدأت تهيمن على أبحاث التعلم الآلي في عصر CUDA، كان من السهل أيضًا موازاةمعمارية المحوّل، مما أتاح التعامل بكفاءة مع حجم بيانات أكبر بكثير مما تستوعبه RNN.
استخدامات شائعة
أسرت المحوّلات خيال الجمهور في عام 2020 مع إطلاق OpenAI نموذج GPT-3، الذي كان يضم آنذاك عددًا قياسيًا قدره 175 مليار معامل. غير أن هذا الإنجاز المذهل ظاهريًا طغت عليه لاحقًا مشروعات أخرى، مثل إطلاق Microsoft نموذج Megatron-Turing NLG 530B في عام 2021، الذي يضم، كما يوحي اسمه، أكثر من 530 مليار معامل.

تسلسل زمني لمشروعات المحوّلات فائقة النطاق في معالجة اللغة الطبيعية. المصدر: Microsoft
انتقلت معمارية المحوّلات أيضًا من معالجة اللغة الطبيعية إلى الرؤية الحاسوبية، لتشغّل جيلًا جديدًا من أطر توليد الصور، مثل CLIP و DALL-Eمن OpenAI، التي تستخدم الربط بين مجالي النص>الصورة لاستكمال الصور الناقصة وتوليد صور جديدة من المجالات التي دُرّبت عليها، إلى جانب عدد متزايد من التطبيقات ذات الصلة.
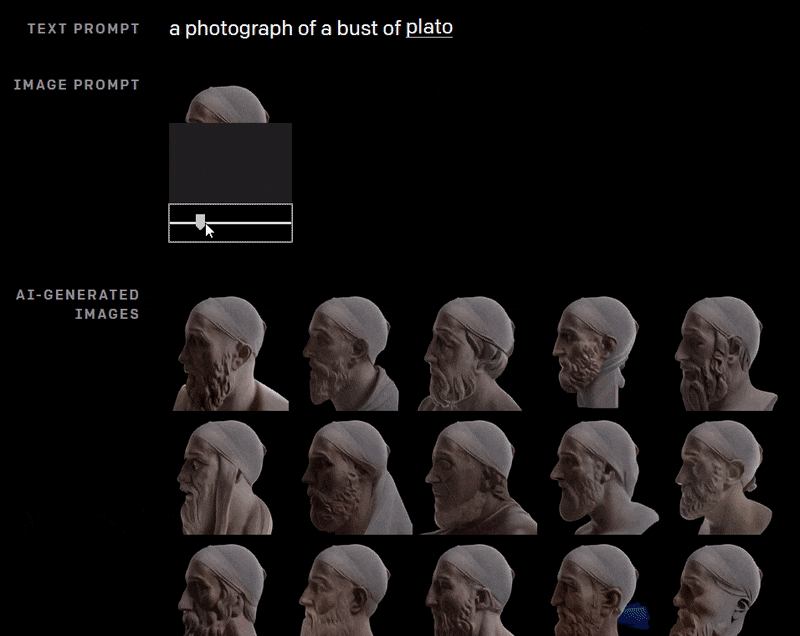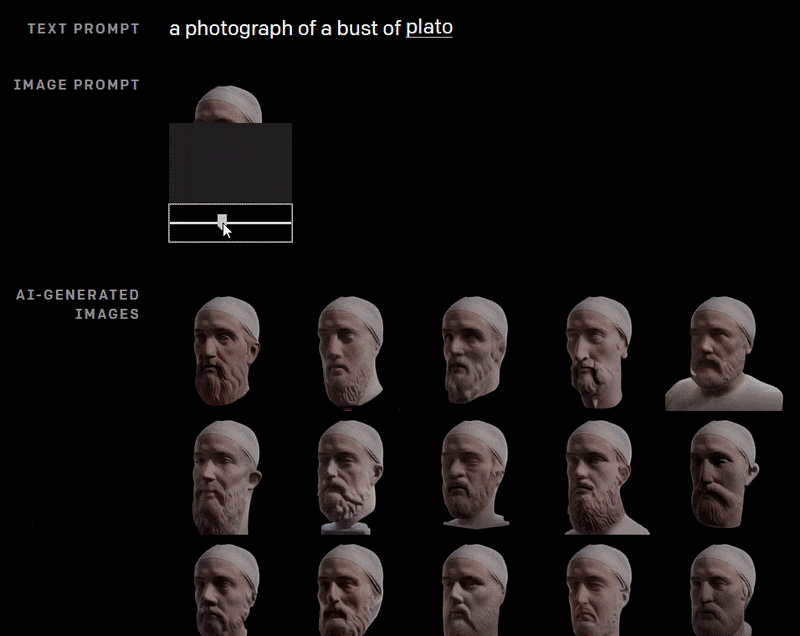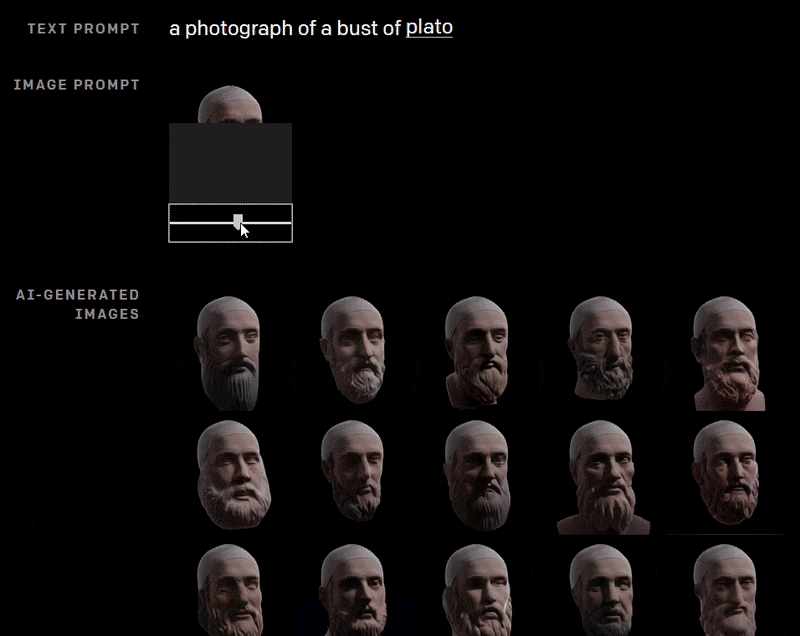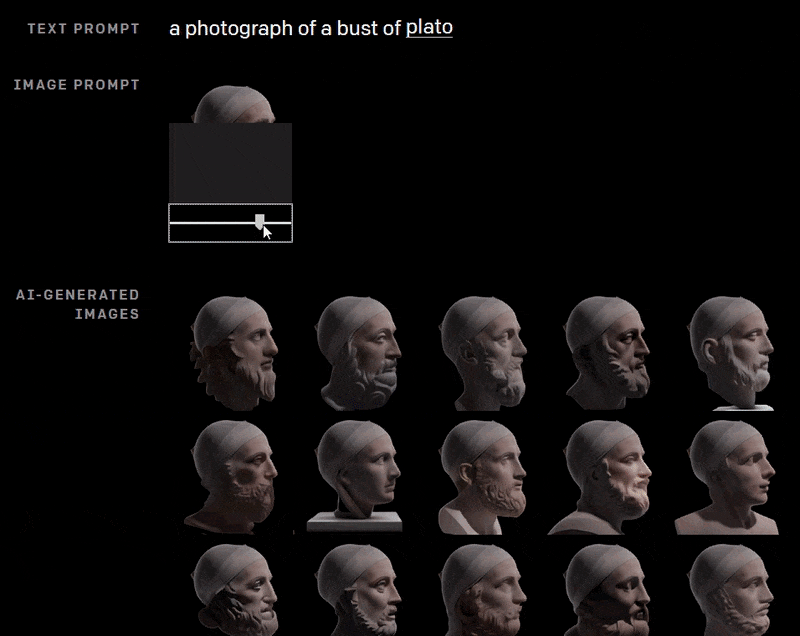
يحاول DALL-E إكمال صورة جزئية لتمثال نصفي لأفلاطون. المصدر: https://openai.com/blog/dall-e/
2: الشبكات التوليدية التنافسية (GAN)
رغم التغطية الإعلامية الاستثنائية التي حظيت بها المحوّلات مع إطلاق GPT-3 واعتماده، أصبحت الشبكة التوليدية التنافسية (GAN) اسمًا معروفًا بحد ذاته، وقد ينضم المصطلح في نهاية المطاف إلى التزييف العميق في استخدامه فعلًا لغويًا.
اقتُرحت لأول مرة في عام 2014 وتُستخدم أساسًا لتوليد الصور، وتتألف معمارية الشبكة التوليدية التنافسية من مولّد و مميّز. يمرّ المولّد على آلاف الصور في مجموعة بيانات ويحاول إعادة بنائها بصورة تكرارية. وفي كل محاولة يقيّم المميّز عمل المولّد ويعيده لتحسين النتيجة، لكنه لا يخبره كيف أخفقت إعادة البناء السابقة.

المصدر: https://developers.google.com/machine-learning/gan/gan_structure
يدفع ذلك المولّد إلى استكشاف مسارات متعددة بدلًا من اتباع طرق مسدودة محتملة كان قد يسلكها لو أخبره المميّز بمواضع الخطأ (انظر البند 8 أدناه). وعند اكتمال التدريب، يكون لدى المولّد تصور تفصيلي وشامل للعلاقات بين النقاط في مجموعة البيانات.
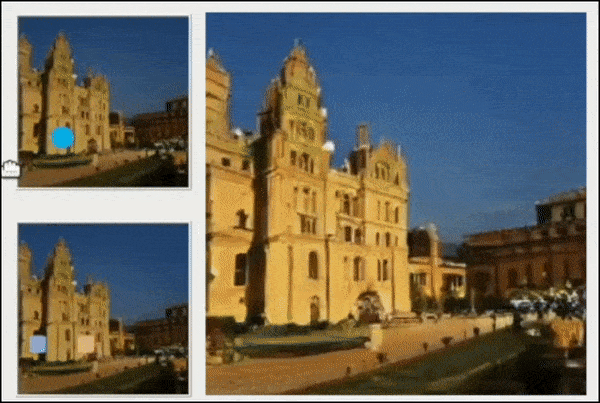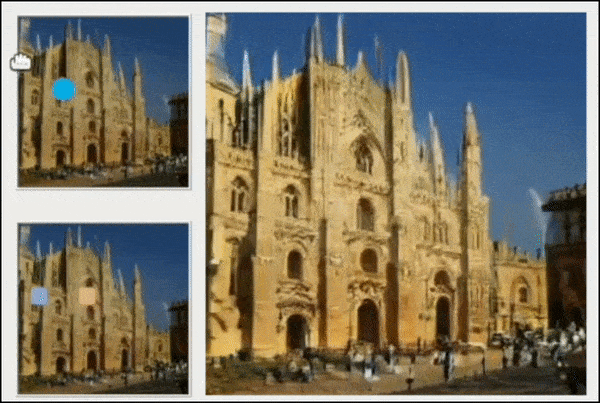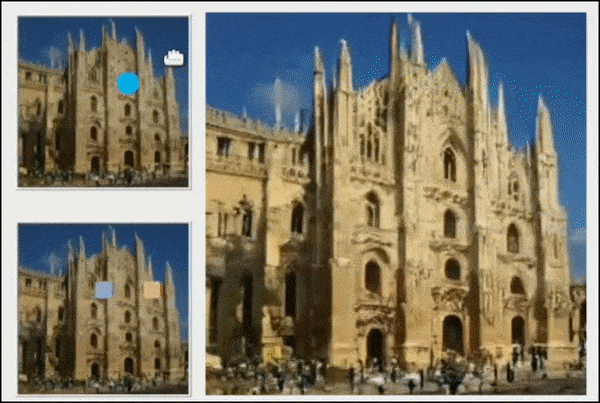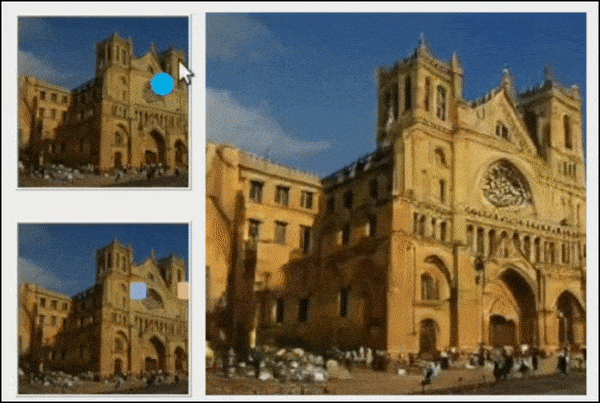
من ورقة Improving GAN Equilibrium by Raising Spatial Awareness: إطار جديد يجوب الفضاء الكامن للشبكة، الذي قد يكون غامضًا أحيانًا، ويوفر تحكمًا تفاعليًا مستجيبًا في معمارية توليد الصور. المصدر: https://genforce.github.io/eqgan/
وبالتشبيه، هذا هو الفرق بين تعلّم مسار تنقّل واحد رتيب إلى وسط لندن، واكتساب المعرفة التفصيلية بشوارعها المطلوبة من سائقي الأجرة، المعروفة باسم The Knowledge، بجهد مضنٍ.
تكون النتيجة مجموعة من السمات عالية المستوى في الفضاء الكامن للنموذج المدرّب. فقد يكون المؤشر الدلالي لسمة عالية المستوى «شخصًا»، بينما يكشف الانتقال إلى تفاصيلها خصائص متعلَّمة أخرى، مثل «ذكر» و«أنثى». وفي المستويات الأدنى قد تنقسم السمات الفرعية إلى «أشقر» و«قوقازي» وغيرها.
ويُعد تشابك السمات مشكلة ملحوظة في الفضاء الكامن لشبكات GAN وأطر المرمّز/فاكّ الترميز: هل الابتسامة على وجه امرأة مولّد بالشبكة سمة متشابكة مع «هويتها» في الفضاء الكامن، أم فرع موازٍ؟

وجوه مولّدة بشبكات GAN من thispersondoesnotexist. المصدر: https://this-person-does-not-exist.com/en
شهد العامان الماضيان عددًا متزايدًا من المبادرات البحثية في هذا الاتجاه، ربما تمهّد للتحرير على مستوى السمات بأسلوب Photoshop داخل الفضاء الكامن لشبكة GAN. لكن كثيرًا من التحويلات لا يزال عمليًا حزمًا من نوع «الكل أو لا شيء». ومن اللافت أن إصدار NVIDIA لأداة EditGAN في أواخر عام 2021 يحقق مستوى مرتفعًا من قابلية التفسير في الفضاء الكامن باستخدام أقنعة التقسيم الدلالي.
استخدامات شائعة
إلى جانب دورها المحدود نسبيًا في مقاطع التزييف العميق الشائعة، انتشرت شبكات GAN المتمحورة حول الصور والفيديو خلال السنوات الأربع الماضية، وأبهرت الباحثين والجمهور. ومن الصعب مواكبة سرعة الإصدارات الجديدة وتواترها، وإن كان مستودع GitHub Awesome GAN Applications يسعى إلى تقديم قائمة شاملة.
يمكن نظريًا للشبكات التوليدية التنافسية اشتقاق السمات من أي مجال محدد جيدًا، بما في ذلك النصوص.
3: آلة المتجهات الداعمة (SVM)
ظهرت في عام 1963، وتُعد آلة المتجهات الداعمة (SVM) خوارزمية أساسية تتكرر في الأبحاث الجديدة. فيها ترسم المتجهات التوزيع النسبي لنقاط البيانات داخل مجموعة البيانات، بينما ترسم المتجهات الداعمة الحدود بين المجموعات أو السمات أو الخصائص المختلفة.

تحدد المتجهات الداعمة الحدود بين المجموعات. المصدر: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
ويُسمّى الحد الناتج المستوى الفائق.
عند المستويات المنخفضة للسمات تكون SVM ثنائية الأبعاد (الصورة أعلاه)، لكن مع التعرف إلى عدد أكبر من المجموعات أو الأنواع تصبح ثلاثية الأبعاد.

يتطلب التوزيع الأكثر تعقيدًا للنقاط والمجموعات آلة متجهات داعمة ثلاثية الأبعاد. المصدر: https://cml.rhul.ac.uk/svm.html
استخدامات شائعة
لأن آلات المتجهات الداعمة تستطيع التعامل بكفاءة، ودون اعتماد على مجال بعينه، مع بيانات عالية الأبعاد من أنواع كثيرة، فإنها تظهر في قطاعات عديدة للتعلم الآلي، منها كشف التزييف العميق، تصنيف الصور، تصنيف خطاب الكراهية، تحليل الحمض النووي ، و التنبؤ بالبنية السكانية، وغيرها الكثير.
4: التجميع بخوارزمية K-Means
التجميع عمومًا نهج للتعلم غير الخاضع للإشراف يسعى إلى تصنيف نقاط البيانات عبر تقدير الكثافة، منتجًا خريطة لتوزيع البيانات المدروسة.

يكتشف تجميع K-Means القطاعات والمجموعات والمجتمعات داخل البيانات. المصدر: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
تجميع K-Means أصبح أكثر تطبيقات هذا النهج شيوعًا، إذ يجمع نقاط البيانات في «K مجموعات» متميزة قد تمثل قطاعات سكانية أو مجتمعات إلكترونية أو أي تجمع خفي ينتظر اكتشافه في البيانات الإحصائية الخام.

تتشكل المجموعات في تحليل K-Means. المصدر: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
قيمة K نفسها عامل حاسم في فائدة العملية وفي تحديد القيمة المثلى للمجموعة. تُعيَّن قيمة K عشوائيًا في البداية، وتُقارَن سماتها وخصائصها المتجهية بجيرانها. ويُلحَق الجيران الأكثر شبهًا بنقطة البيانات ذات القيمة العشوائية بمجموعتها تكراريًا، حتى تنتج البيانات كل التجمعات التي تسمح بها العملية.
ويُظهر رسم الخطأ التربيعي، أو «تكلفة» اختلاف القيم بين المجموعات، نقطة كوع للبيانات:

«نقطة الكوع» في رسم بياني للمجموعات. المصدر: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
تشبه نقطة الكوع من حيث المفهوم استقرار انخفاض الخسارة وتناقص التحسن في نهاية جلسة تدريب على مجموعة بيانات. وهي النقطة التي لا يعود بعدها تمييز المجموعات أوضح، فتشير إلى الانتقال للمراحل التالية في مسار معالجة البيانات، أو الإبلاغ عن النتائج.
استخدامات شائعة
لأسباب واضحة، يمثل تجميع K-Means تقنية أساسية في تحليل العملاء؛ إذ يقدم منهجية واضحة وقابلة للتفسير لتحويل كميات كبيرة من السجلات التجارية إلى رؤى سكانية وعملاء محتملين.
ويُستخدم أيضًا في التنبؤ بالانهيارات الأرضية، تقسيم الصور الطبية، توليد الصور باستخدام GAN، تصنيف المستندات، و التخطيط الحضري، بين استخدامات محتملة وفعلية كثيرة أخرى.
5: الغابة العشوائية
الغابة العشوائية طريقة من طرق التعلم التجميعي تأخذ متوسط نتائج مجموعة من أشجار القرار لوضع تنبؤ إجمالي بالنتيجة.

المصدر: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
حتى لو كان بحثك في الموضوع لا يتجاوز مشاهدة ثلاثية العودة إلى المستقبل ، فمن السهل نسبيًا تصور شجرة القرار: أمامك مسارات متعددة، يتفرع كل منها إلى نتيجة جديدة تتضمن بدورها مسارات أخرى ممكنة.
في التعلم المعززيمكنك التراجع عن مسار والبدء مجددًا من موضع سابق، بينما تلتزم أشجار القرار بمساراتها المختارة.
ولذلك توزع خوارزمية الغابة العشوائية المخاطر بين القرارات. وتُسمّى «عشوائية» لأنها تجري اختيارات وملاحظات حسب الموقف لفهم مجموع النتائج ذي الوسيط من مجموعة أشجار القرار.
ولأنها تراعي عوامل متعددة، قد يصعب تحويل الغابة العشوائية إلى رسوم مفيدة أكثر من شجرة قرار واحدة، لكنها قد تكون أكثر إنتاجية بدرجة ملحوظة.
تتعرض أشجار القرار لفرط التكيّف، فتكون نتائجها خاصة بالبيانات ولا يُرجَّح تعميمها. ويقاوم الانتقاء العشوائي لنقاط البيانات في الغابة العشوائية هذا الميل، وصولًا إلى اتجاهات ممثلة وذات معنى وفائدة داخل البيانات.

الانحدار باستخدام شجرة قرار. المصدر: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
استخدامات شائعة
كما هي الحال مع كثير من خوارزميات هذه القائمة، تعمل الغابة العشوائية عادة في مرحلة مبكرة لفرز البيانات وتصفيتها، ولذلك تظهر باستمرار في الأوراق البحثية الجديدة. ومن أمثلتها توليد صور الرنين المغناطيسي، التنبؤ بسعر بيتكوين، تقسيم بيانات التعداد السكاني، تصنيف النصوص ، و كشف الاحتيال ببطاقات الائتمان.
ولأن الغابة العشوائية خوارزمية منخفضة المستوى في معماريات التعلم الآلي، فقد تسهم أيضًا في أداء أساليب أخرى منخفضة المستوى وخوارزميات التصور، منها التجميع الاستقرائي، تحويلات السمات، وتصنيف المستندات النصية باستخدام السمات المتناثرة، و عرض مسارات المعالجة.
6: بايز الساذج
باقترانه بتقدير الكثافة (انظر البند 4أعلاه)، يُعد مصنّف بايز الساذج خوارزمية قوية وخفيفة نسبيًا تستطيع تقدير الاحتمالات بناءً على السمات المحسوبة للبيانات.

علاقات السمات في مصنّف بايز الساذج. المصدر: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
يشير وصف «الساذج» إلى الافتراض في نظرية بايز بأن السمات غير مترابطة، وهو ما يُعرف بـ الاستقلال الشرطي. ووفق هذا المنظور، لا تكفي المشية والصوت الشبيهان بالبط لإثبات أننا أمام بطة، ولا تُعتمد افتراضات «بديهية» قبل أوانها.
قد يبدو هذا القدر من الدقة الأكاديمية والاستقصائية مفرطًا حين يتوافر «الحس السليم»، لكنه معيار مهم عند استكشاف الغموض والارتباطات التي قد تكون غير ذات صلة داخل مجموعة بيانات للتعلم الآلي.
في شبكة بايزية أصلية، تخضع السمات لـ دوال تقييمتتضمن الحد الأدنى لطول الوصف و التقييم البايزي. وقد تفرض هذه الدوال قيودًا على البيانات وفق الروابط المقدَّرة بين نقاط البيانات واتجاه تدفقها.
أما مصنّف بايز الساذج فيفترض استقلال سمات كائن معين، ثم يستخدم نظرية بايز لحساب احتمال ذلك الكائن استنادًا إلى سماته.
استخدامات شائعة
تُستخدم مرشحات بايز الساذج في التنبؤ بالأمراض وتصنيف المستندات، تصفية الرسائل المزعجة، تصنيف المشاعر، أنظمة التوصية، و كشف الاحتيال، إلى جانب تطبيقات أخرى.
7: أقرب K جيران (KNN)
اقترحته مدرسة طب الطيران بالقوات الجوية الأمريكية لأول مرة في عام 1951، واضطر إلى التكيف مع قدرات الحواسيب في منتصف القرن العشرين. وتظل خوارزمية أقرب K جيران (KNN) خوارزمية مقتصدة تظهر بوضوح في الأوراق الأكاديمية ومبادرات أبحاث التعلم الآلي في القطاع الخاص.
وتُسمّى «المتعلم الكسول» لأنها تفحص مجموعة البيانات بالكامل لتقييم العلاقات بين النقاط بدلًا من اشتراط تدريب نموذج تعلم آلي متكامل.

تجميع باستخدام KNN. المصدر: https://scikit-learn.org/stable/modules/neighbors.html
رغم بساطة معمارية KNN، فإن نهجها المنهجي يتطلب قدرًا ملحوظًا من عمليات القراءة والكتابة، وقد يصعب استخدامها مع مجموعات بيانات ضخمة دون تقنيات مساعدة مثل تحليل المكونات الرئيسية (PCA)، الذي يمكن أن يحوّل البيانات المعقدة والكبيرة إلى مجموعات ممثلة تستطيع KNN اجتيازها بجهد أقل.
وقد قيّمت دراسة حديثة فعالية عدد من الخوارزميات وتكلفتها في توقع ما إذا كان موظف سيترك الشركة، ووجدت أن KNN البالغ عمرها سبعين عامًا ظلت أفضل من منافسات أحدث من حيث الدقة والفعالية التنبؤية.
استخدامات شائعة
رغم بساطة مفهومها وتنفيذها، لم تتوقف KNN عند خمسينيات القرن الماضي؛ فقد كُيّفت إلى نهج أكثر تركيزًا على الشبكات العصبية العميقة (DNN) في مقترح لجامعة ولاية بنسلفانيا عام 2018، وظلت عملية محورية في المراحل المبكرة، أو أداة تحليل للمعالجة اللاحقة، في أطر تعلم آلي أكثر تعقيدًا بكثير.
وفي تشكيلات متعددة، استُخدمت KNN في التحقق من التوقيع عبر الإنترنت، تصنيف الصور، تنقيب النصوص، التنبؤ بالمحاصيل، و التعرف على الوجوه، فضلًا عن تطبيقات وعمليات دمج أخرى.

نظام تعرف على الوجوه قائم على KNN أثناء التدريب. المصدر: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: عملية اتخاذ القرار الماركوفيّة (MDP)
هي إطار رياضي قدّمه عالم الرياضيات الأمريكي ريتشارد بيلمان في عام 1957، وتُعد عملية اتخاذ القرار الماركوفيّة (MDP) من أبسط لبنات معماريات التعلم المعزز . وهي خوارزمية مفهومية مستقلة جرى تكييفها في عدد كبير من الخوارزميات الأخرى، وتظهر كثيرًا في الأبحاث الحالية للذكاء الاصطناعي والتعلم الآلي.
تستكشف MDP بيئة البيانات اعتمادًا على تقييم حالتها الحالية، أي «موضعها» داخل البيانات، لتحديد العقدة التالية التي ستستكشفها.

المصدر: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
تعطي العملية الماركوفيّة الأساسية أولوية للفائدة القصيرة الأجل على الأهداف الأطول أمدًا والأكثر استحسانًا. ولهذا تُدرج عادة ضمن معمارية سياسات أشمل في التعلم المعزز، وتخضع لعوامل مقيّدة مثل المكافأة المخصومة ومتغيرات بيئية معدّلة أخرى، تمنعها من الاندفاع إلى هدف فوري دون مراعاة النتيجة الأوسع المنشودة.
استخدامات شائعة
ينتشر مفهوم MDP منخفض المستوى في البحث وفي التطبيقات الفعلية للتعلم الآلي. وقد اقتُرح استخدامه في أنظمة الدفاع عن أمن إنترنت الأشياء، حصاد الأسماك، و التنبؤ بالأسواق.
وفضلًا عن قابليته الواضحة للتطبيق في الشطرنج وغيرها من الألعاب التسلسلية الصارمة، فهو مرشح طبيعي لـ التدريب الإجرائي للأنظمة الروبوتية، كما يمكن رؤيته في الفيديو أدناه.
9: تكرار المصطلح–معكوس تكرار المستند
يقسم تكرار المصطلح (TF) عدد مرات ظهور كلمة في مستند على العدد الإجمالي لكلماته. فإذا ظهرت كلمة فقمة مرة واحدة في مقال من ألف كلمة، كان تكرارها 0.001. ولا يفيد TF وحده كثيرًا في قياس أهمية المصطلح، لأن الكلمات الوظيفية التي لا تحمل مضمونًا دلاليًا مستقلًا، مثل الكلمات الإنجليزية a، and، the، و it، تهيمن.
وللحصول على قيمة ذات معنى للمصطلح، يحسب معكوس تكرار المستند (IDF) تكرار الكلمة عبر مستندات متعددة في مجموعة البيانات، ويمنح تقييمًا منخفضًا لـ كلمات الوقفشديدة التكرار، مثل أدوات التعريف والتنكير. وتُطبَّع متجهات السمات الناتجة إلى قيم صحيحة، ويُخصَّص لكل كلمة وزن مناسب.

يوزن TF-IDF صلة المصطلحات وفق تكرارها عبر مستندات متعددة، وتكون ندرة الظهور مؤشرًا إلى الأهمية. المصدر: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
مع أن هذا النهج يمنع ضياع الكلمات المهمة دلاليًا باعتبارها قيمًا متطرفة، فإن عكس وزن التكرار لا يعني تلقائيًا أن المصطلح القليل التكرار ليس قيمة متطرفة، لأن بعض الأشياء نادرة و عديمة القيمة. ولذلك يحتاج المصطلح القليل التكرار إلى إثبات قيمته في السياق المعماري الأوسع بالظهور في عدة مستندات ضمن المجموعة، حتى لو قلّ تكراره في كل مستند.
ورغم قِدمه، يظل TF-IDF طريقة قوية وشائعة للتصفية الأولية في أطر معالجة اللغة الطبيعية.
استخدامات شائعة
لأن TF-IDF أسهم على الأقل بدرجة ما في تطوير خوارزمية PageRank الغامضة إلى حد كبير لدى Google خلال السنوات العشرين الماضية، فقد أصبح معتمدًا على نطاق واسع جدًا بوصفه أسلوبًا للتلاعب بتحسين محركات البحث، رغم نفي جون مولر عام 2019 أهميته لنتائج البحث.
وبسبب السرية المحيطة بـPageRank، لا يوجد دليل واضح على أن TF-IDF ليس حاليًا أسلوبًا فعالًا للصعود في ترتيب Google. ويشير نقاش حاد مؤخرًا بين مختصي تقنية المعلومات إلى تصور شائع، صحيحًا كان أم لا، بأن إساءة استخدام المصطلحات قد تظل تحسن ترتيب البحث، وإن كانت اتهامات إساءة استغلال الاحتكار و الإعلانات المفرطة تزيد حدود هذه النظرية غموضًا.
10: الانحدار التدرجي العشوائي
الانحدار التدرجي العشوائي (SGD) طريقة متزايدة الشيوع لتحسين تدريب نماذج التعلم الآلي.
والانحدار التدرجي نفسه طريقة لتحسين التقدم الذي يحرزه النموذج أثناء التدريب ثم قياسه كمّيًا.
وفي هذا السياق يدل «التدرج» على انحدار إلى أسفل، لا تدرج لوني (انظر الصورة أدناه). وتمثل أعلى نقطة من «التل» في اليسار بداية التدريب. عندها لم ير النموذج كامل البيانات ولو مرة واحدة، ولم يتعلم ما يكفي من العلاقات بينها لإنتاج تحويلات فعالة.

انحدار تدرجي خلال جلسة تدريب FaceSwap. نرى أن التدريب استقر عند مستوى ثابت لبعض الوقت في النصف الثاني، لكنه استأنف لاحقًا النزول على التدرج نحو تقارب مقبول.
تمثل أدنى نقطة في اليمين التقارب، أي النقطة التي يصل عندها النموذج إلى أقصى فعالية ممكنة ضمن القيود والإعدادات المفروضة.
ويعمل التدرج سجلًا ومؤشرًا تنبؤيًا للفارق بين معدل الخطأ، أي دقة تمثيل النموذج للعلاقات بين البيانات حاليًا، والأوزان، أي الإعدادات المؤثرة في كيفية تعلمه.
ويمكن استخدام سجل التقدم هذا لتوجيه جدول معدل التعلم، وهو إجراء آلي يوجّه المعمارية إلى مزيد من التفصيل والدقة مع تحول التفاصيل الأولية الغامضة إلى علاقات وخرائط واضحة. وعمليًا، توفر خسارة التدرج خريطة في الوقت المناسب لوجهة التدريب التالية وكيفية مواصلته.
ويكمن ابتكار SGD في تحديث معاملات النموذج عند كل مثال تدريبي في كل تكرار، مما يسرّع عادة الوصول إلى التقارب. ومع ظهور مجموعات بيانات فائقة النطاق في السنوات الأخيرة، ازدادت شعبية SGD بوصفه أحد الحلول الممكنة للمشكلات التشغيلية الناتجة.
ومن جهة أخرى، فإن لـSGD آثارًا سلبية على تحجيم السمات، وقد يتطلب مزيدًا من التكرارات لتحقيق النتيجة نفسها، مع تخطيط ومعاملات إضافية مقارنة بالانحدار التدرجي التقليدي.
استخدامات شائعة
بفضل قابليته للتهيئة ورغم عيوبه، أصبح SGD أكثر خوارزميات التحسين شيوعًا لملاءمة الشبكات العصبية. ومن تشكيلاته التي أصبحت مهيمنة في أوراق الذكاء الاصطناعي والتعلم الآلي الجديدة اختيار محسّن تقدير العزم التكيفي (ADAM)، الذي قُدّم في عام 2015.
يكيّف ADAM معدل التعلم ديناميكيًا لكل معامل («معدل تعلم تكيفي»)، ويدمج نتائج التحديثات السابقة في التشكيل اللاحق («الزخم»). ويمكن تهيئته أيضًا لاستخدام ابتكارات أحدث مثل زخم نيستيروف.
لكن البعض يرى أن الزخم قد يسرّع وصول ADAM والخوارزميات المشابهة إلى نتيجة دون المستوى الأمثل. وكما هو الحال مع جانب كبير من طليعة أبحاث التعلم الآلي، يبقى SGD عملًا قيد التطوير.
نُشر أول مرة في 10 فبراير 2022. عُدّل في 10 فبراير، الساعة 20:05 بتوقيت شرق أوروبا — التنسيق.


