أساسيات الذكاء الاصطناعي
ما هو التعلم المعزز؟

 أضف Unite.AI إلى مصادرك المفضلة على Google
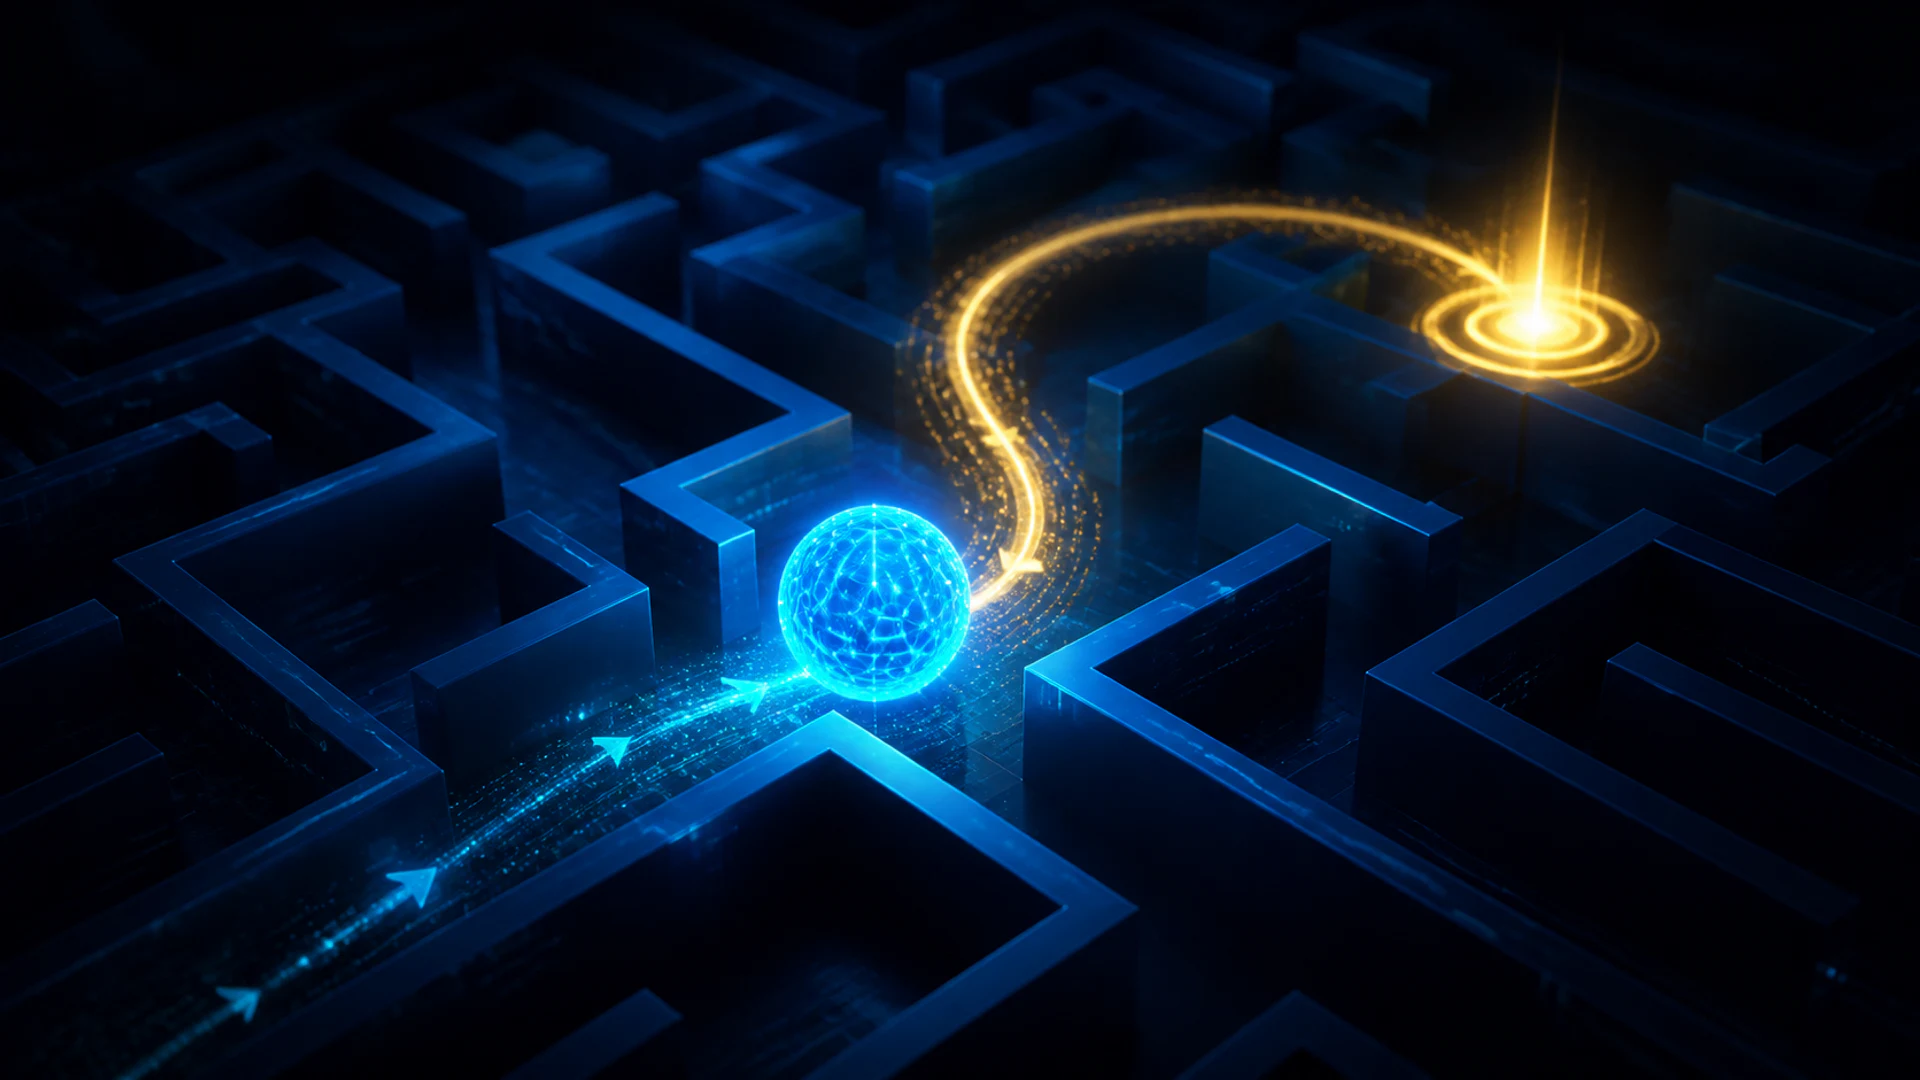
التعلم المعزز (RL) هو إطار عمل لتعلم الآلة يتعلم فيه الوكيل كيفية التصرف من خلال التفاعل مع البيئة. بعد كل فعل، تتغير البيئة وقد تُعيد مكافأة. هدف الوكيل هو تعلم سياسة تُعظم المكافأة المتراكمة المتوقعة، وليس مجرد المكافأة من الخطوة التالية فقط.
يُستخدم التعلم المعزز عندما تتطور القرارات على مدى الزمن ويؤثر فعل واحد على ما سيحدث لاحقًا. وهو مختلف مفهومياً عن التعلم الخاضع للإشراف، حيث توفر مجموعة البيانات إجابة مستهدفة لكل مثال تدريب.
النقاط الرئيسية
- تتضمن مشكلة التعلم المعزز وكيلًا، بيئة، حالات، أفعال، مكافآت، وسياسة.
- كلا من التعزيز الإيجابي والسلبي يزيدان السلوك؛ بينما العقاب يقلل السلوك.
- يجب على الوكيل موازنة استكشاف الأفعال غير المألوفة مع استغلال الأفعال المعروفة التي تعمل.
- الطرق القائمة على القيمة، القائمة على السياسة، الممثل-الناقد، القائمة على النموذج، والطرق غير المتصلة بالإنترنت تحل إعدادات مختلفة للتعلم المعزز.
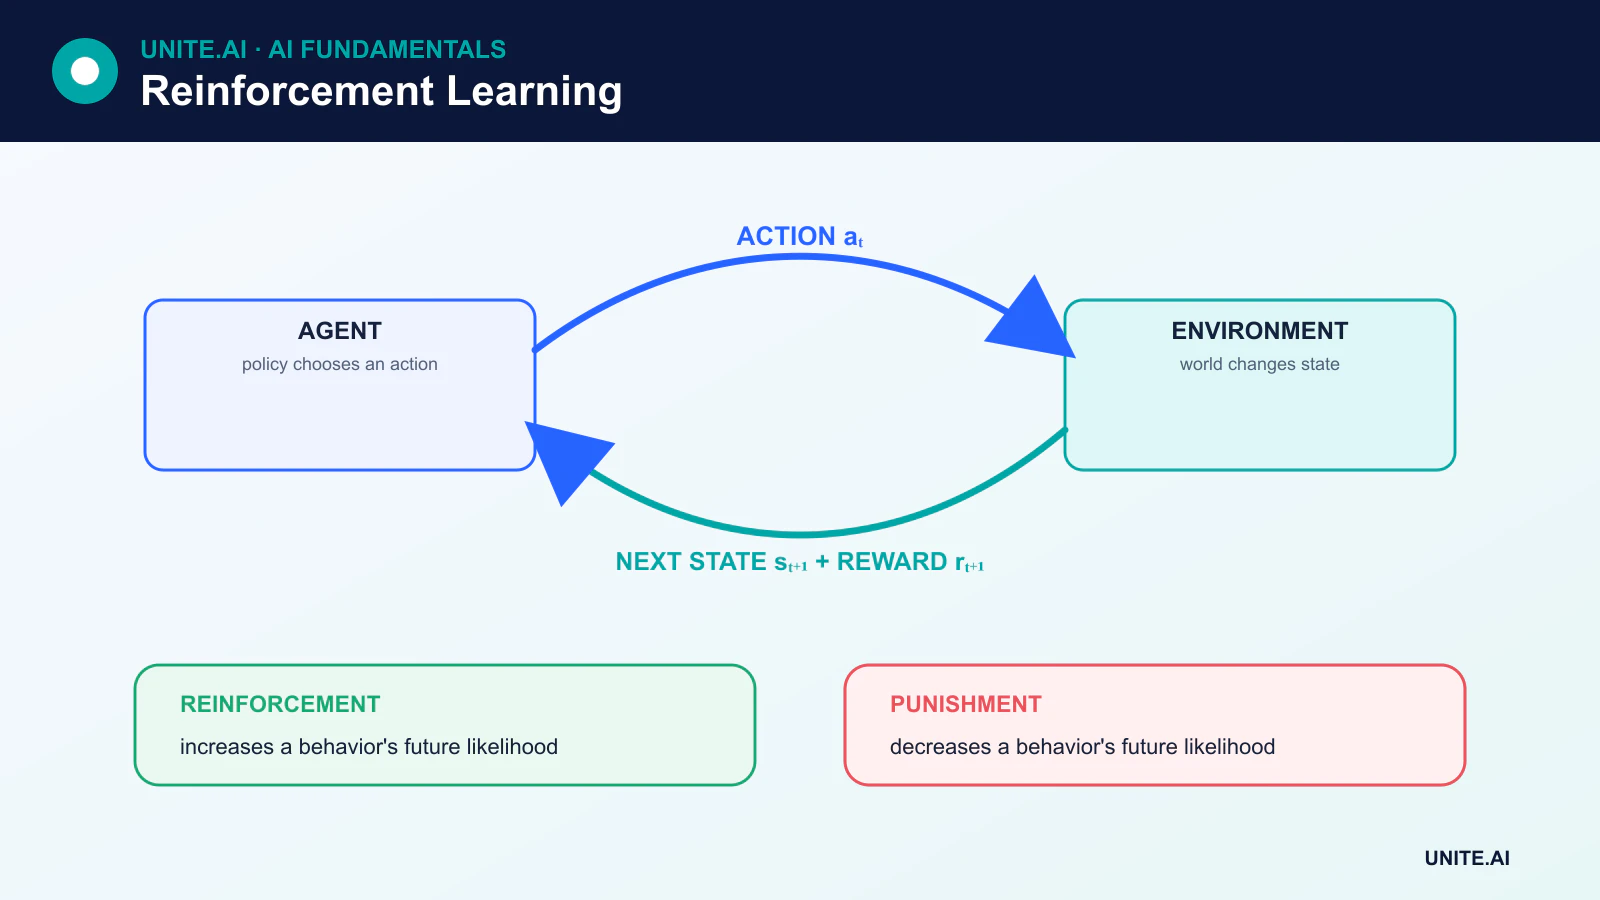
مكونات التعلم المعزز
يُنمذج العديد من مشاكل التعلم المعزز كـ عملية اتخاذ قرار ماركوف (MDP). تشمل عملية اتخاذ القرار ماركوف ما يلي:
- الحالة: معلومات تصف الوضع الحالي.
- الفعل: خيار متاح للوكيل.
- الانتقال: كيف تتغير الحالة بعد فعل.
- المكافأة: رد فعل فوري ينتج عن الانتقال.
- السياسة: استراتيجية الوكيل لاختيار الأفعال.
- عامل الخصم: مدى اعتبار المكافآت المستقبلية مقارنةً بالمكافآت الفورية.
ليس من الضروري أن تكشف الحالة عن كل شيء في العالم. عندما تكون المعلومات الهامة مخفية، قد تكون المشكلة جزئياً قابلة للملاحظة وقد يحتاج الوكيل إلى ذاكرة أو حالة إيمان.
التعزيز ليس هو نفسه العقاب
المصطلحات مستمدة من علم النفس السلوكي. التعزيز الإيجابي يضيف نتيجة تجعل السلوك أكثر احتمالًا. التعزيز السلبي يزيل حالة غير سارة ويجعل السلوك أكثر احتمالًا أيضًا. العقوبة التي تهدف إلى جعل الفعل أقل احتمالًا هي عقاب، وليس تعزيزًا سلبيًا.
في تعلم الآلة، يتحدث الممارسون غالبًا مباشرةً عن المكافآت الإيجابية، المكافآت السلبية، التكاليف، والعقوبات. القضية الأساسية هي كيف تشكل تلك الإشارات العائد الذي يحاول الوكيل تعظيمه.
العائد، القيمة، وتخصيص الائتمان
المكافأة تصف انتقالًا واحدًا. الـ العائد يجمع المكافآت على مدى الزمن، عادةً مع خصم المكافآت التي تصل في المستقبل البعيد. الـ دالة قيمة الحالة تقدر العائد المتوقع من حالة ما، بينما الـ دالة قيمة الفعل تقدر العائد المتوقع بعد اتخاذ فعل معين في تلك الحالة.
هذا يخلق مشكلة تخصيص الائتمان: إذا وصل نتيجة مفيدة بعد وقت طويل، أي من الأفعال السابقة تستحق الائتمان؟ تختلف خوارزميات التعلم المعزز في كيفية تقدير هذه العلاقة.
طريقة مونت كارلو وتعلم الفرق الزمني
طرق مونت كارلو تتعلم من العوائد المأخوذة بالكامل، عادةً بعد انتهاء حلقة. طرق الفرق الزمني (TD) تُحدّث تقديرًا قبل النتيجة النهائية عبر دمج المكافأة الملاحظة مع تقدير لما سيأتي لاحقًا. لذا فإن تعلم الفرق الزمني يستند إلى تقديرات القيمة الحالية.
لا عائلة من الطريقتين هي الأفضل عالميًا. أهداف مونت كارلو غير متحيزة تحت السياسة المأخوذة لكن قد تكون ذات تباين عالٍ وتتطلب إكمال الحلقة. طرق الفرق الزمني يمكنها التعلم عبر الإنترنت ومن مهام مستمرة، لكن أهدافها المستندة إلى التمهيد قد تُدخل تحيزًا.
الاستكشاف مقابل الاستغلال
الاستكشاف يجمع المعلومات عبر تجربة أفعال قيمتها غير مؤكدة. الاستغلال يختار الفعل الذي يُعتقد حاليًا أنه يقدم أفضل عائد. الوكيل الذي لا يستكشف أبداً قد يستقر على استراتيجية ضعيفة؛ والوكيل الذي لا يستغل أبداً يفشل في الاستفادة مما تعلمه.
تشمل الاستراتيجيات البسيطة اختيار الفعل بطريقة إبسيلون-جريدي، والاستكشاف القائم على الثقة، ومكافآت الإنتروبي، وطرق المكافأة الذاتية. في البيئات الحرجة للسلامة، قد يكون الاستكشاف غير المقيد غير مقبول، لذا تصبح المحاكاة، والقيود، والبيانات غير المتصلة، أو الإشراف البشري مهمة.
النهج الرئيسية في التعلم المعزز
الطرق القائمة على القيمة
يتعلم Q-learning وال خوارزميات ذات الصلة قيم الأفعال ويستنتج سياسة عبر اختيار الأفعال ذات القيمة العالية. التعلم المعزز العميق يستخدم الشبكات العصبية لتقريب دوال القيمة أو السياسات عندما تكون فضاءات الحالة كبيرة جدًا لجدول.
طرق الانحدار للسياسة
تقوم طرق الانحدار للسياسة بضبط مباشر لسياسة مُعلمة لتحسين العائد المتوقع. هي مفيدة للأفعال المتصلة والسياسات العشوائية لكنها قد تعطي تقديرات تدرج ذات تباين عالٍ.
طرق الممثل-الناقد
الممثل يختار الأفعال بينما الناقد يقدّر القيمة ويوفر إشارة تعلم. يجمع هذا بين تحسين السياسة مباشرة وتقدير القيمة.
التعلم المعزز القائم على النموذج وغير القائم على النموذج
الأنظمة القائمة على النموذج تتعلم أو تستخدم نموذجًا للانتقالات والمكافآت لتتمكن من التخطيط. الأنظمة غير القائمة على النموذج تتعلم القيم أو السياسات دون نمذجة البيئة صراحةً. يمكن للطرق القائمة على النموذج استغلال الخبرة بكفاءة، لكن الأخطاء في النموذج المتعلم قد تضلل التخطيط.
التعلم المعزز غير المتصل
يتعلم التعلم المعزز غير المتصل من مجموعة بيانات ثابتة بدلاً من جمع تفاعلات جديدة أثناء التدريب. يمكن أن يقلل من تكلفة أو مخاطر الاستكشاف، لكن يجب على الوكيل تجنب الإفراط في تقدير الأفعال التي تم تمثيلها بشكل ضعيف في البيانات.
RLHF وتفضيلات البشر
التعلم المعزز من ملاحظات البشر (RLHF) يستخدم بيانات التفضيل لتدريب إشارة مكافأة أو تحسين سياسة مباشرة. تم استخدامه لتوافق سلوك نماذج اللغة مع أحكام البشر. تحسين التفضيل ليس ضمانًا للحق أو السلامة: النتائج تعتمد على من قدم الملاحظات، وما طُلب منهم الحكم عليه، وكيف صُممت الهدف.
القيود
قد يتطلب التعلم المعزز عددًا هائلًا من التفاعلات، وقد يتصرف بشكل غير مستقر أثناء التدريب، ويستغل اختصارات غير مقصودة في دالة المكافأة. التقييم صعب لأن النتائج قد تتفاوت مع البذور العشوائية وتفاصيل البيئة. الممارسات القوية تشمل تشغيلات متعددة، خطوط أساس شفافة، أهداف مقيدة، اختبار خارج التوزيع، ومراقبة للغش في المكافأة.
تصميم مشكلة التعلم المعزز: الحالة، الفعل، المكافأة، والأفق
النمذجة في التعلم المعزز تتعامل مع القرارات المتسلسلة. تُنتج البيئة ملاحظة، يختار الوكيل فعلًا وفق سياسة، وتُعطي الانتقال مكافأة وملاحظة لاحقة. تفترض عملية اتخاذ قرار ماركوف أن الحالة تحتوي على المعلومات اللازمة لتوقع الانتقالات والمكافآت المستقبلية؛ الملاحظة الجزئية تتطلب ذاكرة، حالة إيمان، أو تمثيلات متكررة. الخصم يتحكم في وزن النتائج المتأخرة، بينما تتطلب المهام المتقطعة والمستمرة تعريفات عائد مختلفة. قد يجعل تصميم الحالة أو الفعل السيئ هدفًا قابلًا للحل غير قابل للتعلم.
تصميم المكافأة يحدد السلوك بشكل غير مباشر وهو مصدر رئيسي للفشل. يمكن استغلال الوكيل عبر وكيل: قد يتجاهل الوكيل المكافأ للسرعة السلامة، بينما قد يحصل الوكيل المكافأ فقط عند إكمال المهمة على إشارة تعلم قليلة جدًا. أضف قيودًا وقواعد إنهاء بناءً على المتطلبات الحقيقية، اختبر حساسية المكافأة، وتفحص المسارات لاستراتيجيات غير مقصودة. توازن طرق الاستكشاف بين جمع المعلومات واستغلال المعرفة الحالية. يمكن للبيانات غير المتطابقة مع السياسة تحسين كفاءة العينة، لكن التفاوت بين سلوك السياسة المستهدفة يتطلب خوارزميات مصممة لذلك.
التقييم، المحاكاة، والنشر الآمن
الطرق القائمة على القيمة تقدر العائد المتوقع للحالات أو الأفعال؛ طرق الانحدار للسياسة تحسن سياسة مُعلمة؛ طرق الممثل‑ناقد تتعلم كليهما. التعلم المعزز القائم على النموذج يتعلم أو يستخدم ديناميكيات الانتقال للتخطيط. تعتمد العائلة المناسبة على نوع الفعل، البيانات، دقة المحاكي، الأفق، ومتطلبات الاستقرار. قارن مع خطوط أساس إرشادية، خاضعة للإشراف، ونظرية التحكم. قيّم العائد المتوسط وأسوأ حالة، انتهاكات القيود، كفاءة العينة، الصمود أمام تغيرات البيئة، والتباين عبر البذور بدلاً من اختيار تشغيل بأفضل منحنى تعلم.
قد يكون الاستكشاف عبر الإنترنت غير مقبول في الرعاية الصحية، المالية، الروبوتات، والبنية التحتية. درّب في محاكاة أو بيانات مسجلة حيثما أمكن، قيّم الفجوة بين المحاكي والواقع، واستخدم تقييم غير متطابق مع السياسة بحذر لأن الأفعال غير المرئية تفتقر إلى الدعم. يجب أن يحد النشر من الأفعال، المعدل، الموارد، ومنطقة التشغيل؛ يشمل موافقة بشرية للقرارات ذات العواقب؛ ويوفر متحكمًا آمنًا أو إيقافًا. راقب المكافأة إلى جانب النتائج الفعلية لأن الوكيل قد يحسن نتيجته مع إضرار الهدف المقصود. أعد التحقق بعد تغيّر البيئة أو السياسة أو المكافأة.
مثال عملي: التحكم في الطاقة باستخدام التعلم المعزز
يقوم مشغل المبنى بنمذجة درجة الحرارة، الإشغال، الطقس، حالة المعدات، وسعر الكهرباء، مع أفعال محدودة لتعديلات نقاط ضبط آمنة. تجمع المكافأة بين الراحة، الطاقة، رسوم الطلب، وقيود المعدات، لكن انتهاكات الراحة الفعلية تُقَيَّم بشكل منفصل بحيث لا يمكن لتحسين المكافأة إخفاء الضرر. توفر التحكم التاريخي والتحكم التنبؤي بالنموذج خطوط أساس. يستخدم التدريب محاكيًا مُعايرًا مع طقس عشوائي، ضوضاء حساسات، وكفاءة المعدات.
قبل التأثير على المبنى، تُجري السياسة تشغيلًا على ملاحظات حية دون اتخاذ إجراءات. يفحص المهندسون المسارات، هوامش القيود، والسلوك خلال العطلات، موجات الحر، الانقطاعات، وفقدان الحساسات. يحد النشر معدل الفعل ونطاقه ويحتفظ بوحدة التحكم السلامية الحالية. يمكن للإنسان تجاوز أي وقت. يَراقب النظام الطاقة والراحة مقارنةً بالفترات المتطابقة، يسجل التدخلات، ويعود إلى الوضع السابق إذا تجاوزت الانتهاكات أو الدورات غير المتوقعة أو عدم توافق النموذج الحدود المحددة.
دليل التنفيذ والاستعداد التشغيلي
يتطلب اتخاذ قرار إنتاجي أكثر من مجرد عرض ناجح. عرّف المستخدمين المستهدفين، بيئة التشغيل، المدخلات، المخرجات، الاعتمادات، المالك، وعواقب كل فشل مهم. أنشئ خط أساس قابل لإعادة الإنتاج ومجموعة تقييم بإصدارات قبل الضبط. اختبر الحالات العادية، ظروف الحدود، المدخلات المشوهة أو المفقودة، تحول التوزيع، انقطاع الاعتماد، سوء الاستخدام، والمجموعات أو البيئات الأكثر احتمالًا لتكون غير مخدومة. قِس جودة المهمة جنبًا إلى جنب مع المعايرة أو عدم اليقين، الكمون، الإنتاجية، تكلفة الموارد، الوصولية، الخصوصية، والأمان. سجّل كل تحويل وعَتبة حتى يتمكن مراجع مستقل من إعادة إنتاج النتيجة والتمييز بين الأدلة والنموذج الأولي الجذاب.
قبل الإطلاق، خصّص سلطة للإصدار، الاستثناءات، التغييرات، الاسترجاع، والتقاعد. استخدم نشرًا متدرجًا، حافظ على احتياطي آمن، وتحقق من المراقبة عبر فشل مُدخَل عمدًا. يجب أن تكشف بيانات التتبع التشغيلية عن جودة المدخلات، سلوك المخرجات، نسخة النموذج أو القاعدة، صحة الاعتماد، تجاوزات بشرية، والنتائج المؤكدة دون جمع بيانات حساسة غير ضرورية. عيّن حدود التنبيه ومسؤول الاستجابة، ثم راجع الأدلة الواقعية بعد النشر بدلاً من افتراض استمرار الأداء غير المتصل. أعد التقييم كلما تغيرت مصادر البيانات أو المستخدمون أو النماذج أو البائعون أو السياسات أو الأجهزة أو الأهداف. النظام المُحافظ عليه يحتاج أيضًا إلى وثائق استعادة، تعلم من الحوادث، إجراءات الحذف والاحتفاظ، ونقطة واضحة يجب فيها إيقافه أو استبداله.
المراجع الأساسية