أساسيات الذكاء الاصطناعي
ما هو تجميع K‑Means؟

 أضف Unite.AI إلى مصادرك المفضلة على Google
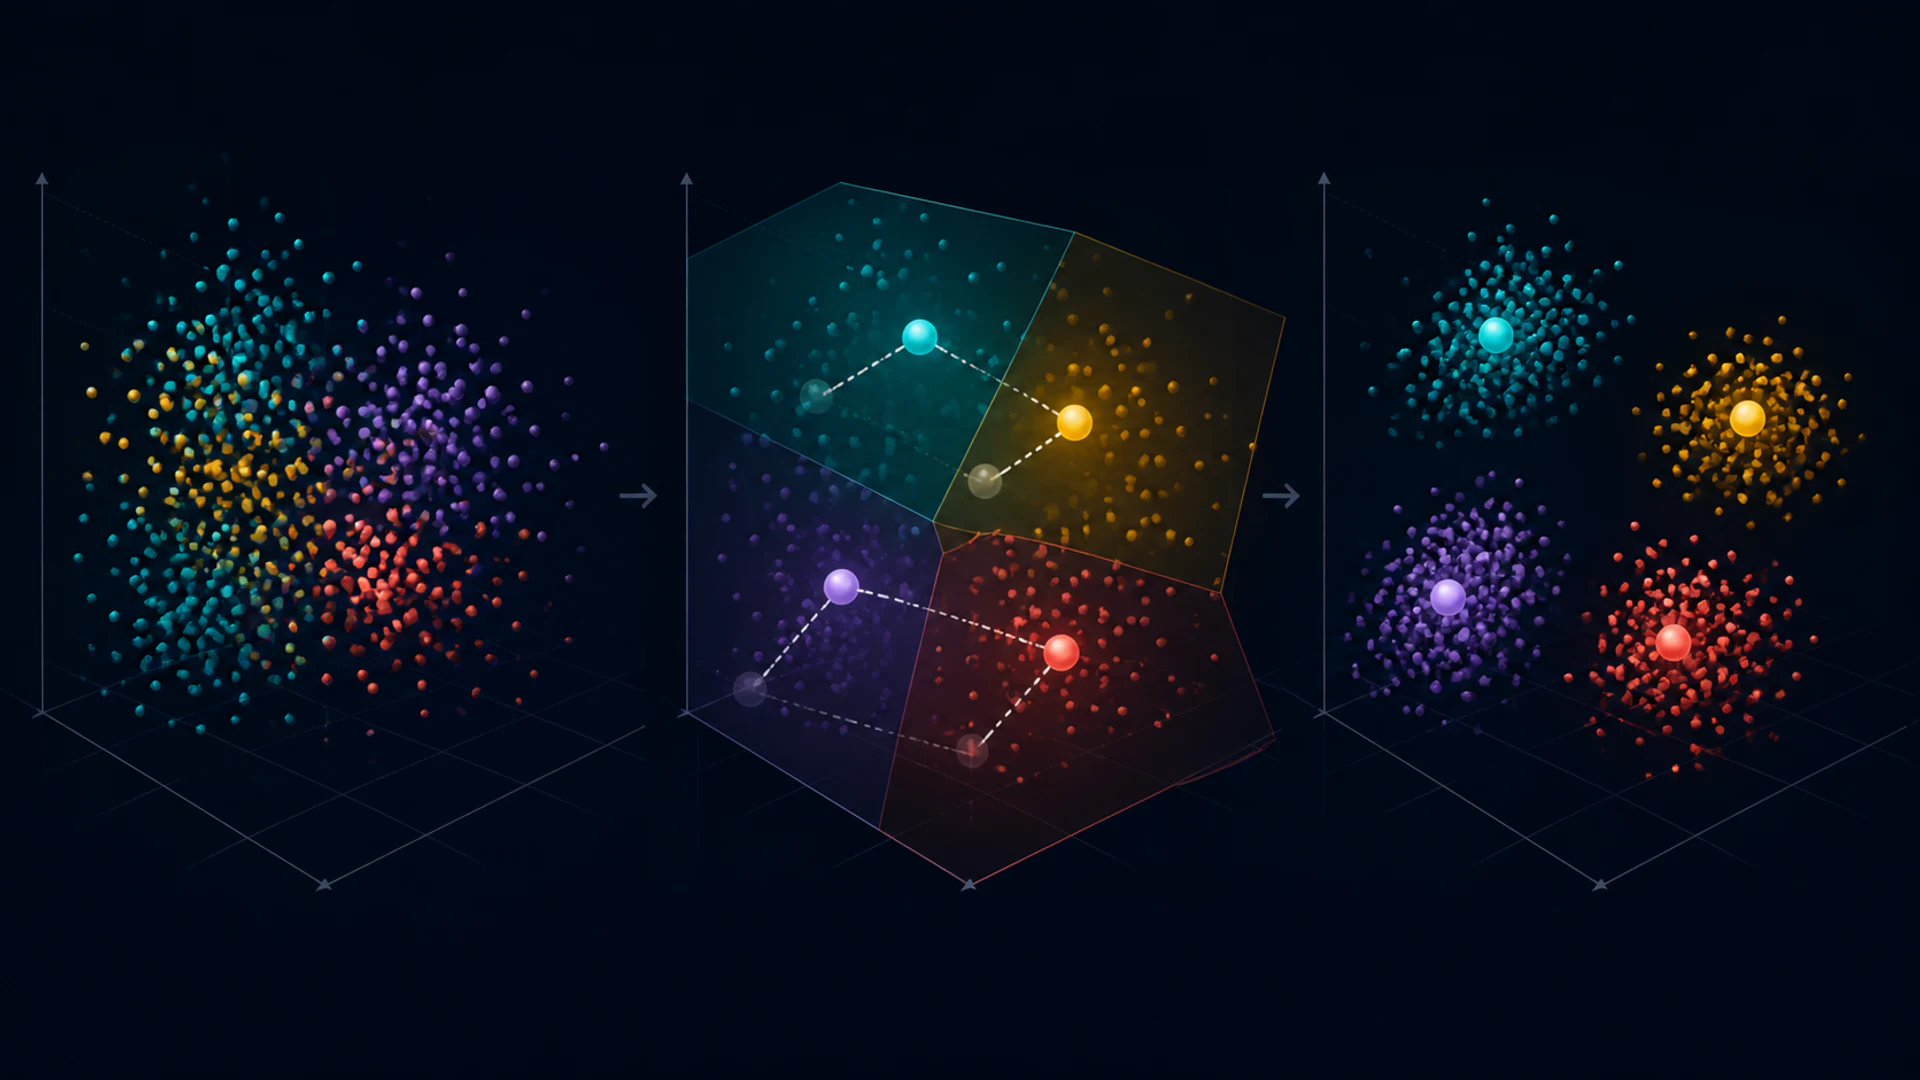
K-means هو خوارزمية غير خاضعة للإشراف تقوم بتقسيم الملاحظات الرقمية إلى k مجموعات. تتناوب بين إسناد كل نقطة إلى أقرب مركز وإعادة حساب كل مركز كمتوسط النقاط المخصصة له.
الخوارزمية سريعة ومفيدة، لكن نتيجتها تتأثر بالتحجيم والمسافة والتهيئة والقيمة المختارة لـ k. المجموعة هي تقسيم رياضي، لا تُعد تلقائيًا فئة في العالم الحقيقي.
النقاط الرئيسية
- يقوم K-means بتقليل المسافة الإقليدية المربعة داخل كل مجموعة إلى المراكز.
- التهيئة مهمة؛ يوزع k-means++ المراكز الأولية عادةً ما يحسن النتائج.
- قم بتوحيد الخصائص عندما يجب أن تساهم وحداتها أو مقاييسها بصورة متساوية.
- يواجه K-means صعوبة مع القيم المتطرفة، والمجموعات غير الكروية، والكثافات غير المتساوية والبيانات الفئوية.
الهدف وحلقة التحديث
مع وجود k مراكز، خطوة الإسناد تُرسل كل ملاحظة إلى الأقرب. خطوة التحديث تستبدل كل مركز بمتوسط الملاحظات المخصصة له. لا يمكن لمجموع المربعات داخل المجموعة أن يزداد تحت هذه الخطوات، لذا يتقارب العملية إلى optimum محلي.
التقارب لا يضمن optimum عالمي. يمكن أن تؤدي المراكز الأولية المختلفة إلى تقسيمات مختلفة، وهذا هو السبب في أن التطبيقات تُجري عدة تهيئات وتحتفظ بالحل الذي يمتلك أقل عزم.
التهيئة وk-means++
اختيار جميع المراكز الأولية عشوائيًا من منطقة كثيفة واحدة قد ينتج حلًا ضعيفًا أو تقاربًا بطيئًا. يختار K-means++ البذور باحتمالية تتعلق بالمسافة من البذور الموجودة، مما يشجع تغطية مجموعة البيانات.
تظل عمليات التشغيل المتعددة مفيدة. سجِّل قيمة البذرة العشوائية وعدد التهيئات حتى يمكن إعادة إنتاج النتائج.
التحجيم والمسافة
المسافة الإقليدية المربعة تجعل K-means حساسًا للوحدات. يمكن لخاصية تُقاس بالآلاف أن تهيمن على أخرى تُقاس بين صفر وواحد. التوحيد شائع، لكن يجب أن يقرر خبراء المجال ما إذا كان تساوي التباين الموحَّد يعكس تساوي الأهمية.
يمكن للقيم المتطرفة سحب المتوسط بعيدًا عن النقاط النموذجية. قد تكون التحجيم المتين، أو القطع، أو الأساليب القائمة على الميدويد أفضل. تُنشئ الخصائص الفئوية المشفرة بنظام one‑hot هندسة مسافة قد لا تتطابق مع تشابه الفئات.
اختيار k والتحقق من المجموعات
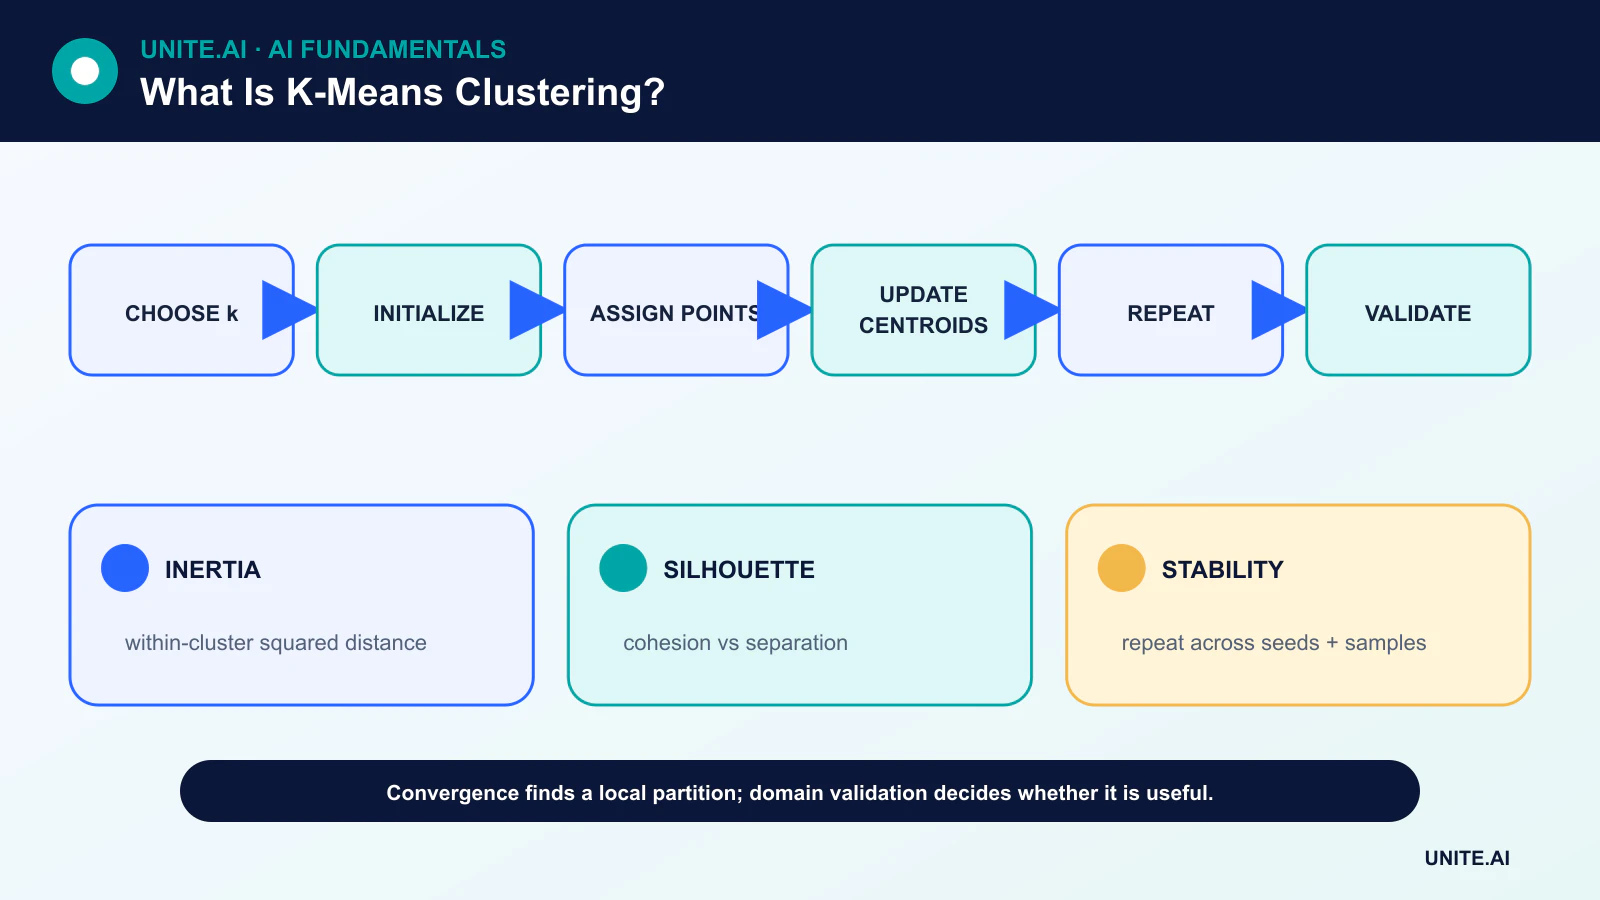
يتناقص العزم كلما زاد k، لذا لا يمكنه اختيار k بمفرده. تبحث طريقة الكوع عن تحسن متناقص. يقارن تحليل السيلويت بين التماسك والانفصال. يضيف الاستقرار عبر العينات والبذور فحصًا آخر.
أقوى طريقة للتحقق هي الفائدة للمجال المستهدف. قارن المجموعات بالنتائج المعروفة، أو مراجعة الخبراء، أو مهمة لاحقة دون التظاهر بأن التسميات اللاحقة اكتُشفت بشكل موضوعي.
القيود والبدائل
يفضل K-means المجموعات المدمجة، الكروية تقريبًا، ذات المقياس المتشابه. نماذج المزيج الغاوسي تمثل مكوّنات إهليلجية احتمالية؛ طرق نمط DBSCAN تحدد المناطق الكثيفة والضوضاء؛ التجميع الهرمي ينتج شجرة من الدمجات.
Dimensionality reduction يمكن لتقليل الأبعاد تحسين السرعة أو إزالة الضوضاء من المدخلات، لكن تطبيقه على مجموعة البيانات الكاملة قد يغيّر سؤال التحقق. يقلل Mini‑batch K‑means من الحسابات للمجموعات الكبيرة على حساب تحديث تقريبي.
الهدف، التهيئة، والتقارب
يقوم K‑means بتقسيم الملاحظات الرقمية إلى k مجموعات عن طريق تقليل المسافة الإقليدية المربعة داخل كل مجموعة إلى المراكز. يتناوب خوارزمية لوييد بين إسناد كل نقطة إلى أقرب مركز وإعادة حساب المراكز حتى تستقر الإسنادات أو الهدف. يتقارب إلى optimum محلي، ليس بالضرورة الأفضل عالميًا. تهيئة K‑means++ توزع المراكز الأولية عادةً ما تحسن النتائج، لكن تظل البذور المتعددة مهمة. يجب توحيد الخصائص عندما يجب أن تساهم الوحدات بصورة متساوية لأن المسافة المربعة تضخم المتغيرات ذات المقياس العالي والقيم المتطرفة.
تفترض الطريقة مجموعات مدمجة تقريبًا، كروية، ذات مقياس متشابه تحت الهندسة الإقليدية. تواجه صعوبة مع الأشكال المستطيلة، الكثافة غير المتساوية، البيانات الفئوية، القيم المتطرفة الكبيرة، والبنية المتداخلة. تحتاج المجموعات الفارغة والنقاط المكررة إلى معالجة محددة. يوسع Mini‑batch k‑means إلى بيانات كبيرة مع مقايضة تقريبية. بالنسبة للنص المتناثر، قد يتطابق k‑means الكروي الموجه للجيب تمامًا مع الاتجاه، بينما تمثل المزيجات، وأساليب الكثافة، والتجميع الهرمي، أو k‑medoids افتراضات أخرى.
اختيار k والتحقق من المعنى
يمكن لمنحنيات الكوع، درجات السيلويت، معايير المعلومات في النماذج ذات الصلة، والاستقرار أن توجه اختيار k، لكن لا أحد يكتشف رقمًا صحيحًا فريدًا. تهم الفائدة التجارية وتفسير المجال. أعد الملاءمة عبر العينات والبذور، قارن حركة المراكز واتساق الإسناد، وتحقق من المجموعات على نتائج مستقلة لم تُستخدم في تشكيلها. قد يشوه الإسقاط ثنائي الأبعاد الفصل، لذا افحص المسافات والأمثلة في الفضاء الأصلي أو الفضاء الممثل المُتحقق.
المجموعات هي مجموعات وصفية تُنشأ بالخصائص والقياس المختار؛ ليست أنواعًا طبيعية أو شرائح سببية. قد تكون الملفات الشخصية المستندة إلى نفس المتغيرات المستخدمة في التجميع دائرية. استخدم السمات المحتفظ بها ومراجعة نوعية، وتحقق مما إذا كانت المجموعات تعيد في الأساس الجغرافيا أو مصدر البيانات أو السمات الحساسة. قد تكون المجموعات الصغيرة شذوذًا أو آثارًا. تسمية مجموعة لا تجعل كل عضو يطابق التسمية.
النشر والصيانة
احفظ التحجيم، ترتيب الخصائص، المراكز، تعريف المسافة، وتسميات المجموعات معًا. بالنسبة للنقاط الجديدة، راقب المسافة إلى المركز المخصص والنسبة التي تتجاوز دعم التدريب؛ قدم حالة غير معروفة بدلاً من إجبار كل حالة على الانضمام إلى مجموعة. تتبع أحجام المجموعات، المراكز، وصلة النتائج بمرور الوقت. يغيّر إعادة التدريب هوية المجموعات، لذا قم بربط أو إصدار قواعد ما بعد المعالجة بدلاً من إعادة استخدام الأسماء القديمة بصمت. يُعد K‑means أساسًا مفيدًا للضغط والتقسيم عندما تتطابق هندسته مع السؤال، وليس محرك اكتشاف شامل.
مثال عملي: تجزئة العملاء باستخدام k-means
تقوم شركة اشتراكات بتوحيد ميزات الاستخدام على فترة ثابتة، وتزيل معرفات الحساب، وتختبر k عبر البذور. يتم مراجعة الاستقرار، السيلويت، والنتائج التجارية المحتفظ بها، لكن فرق المنتج تفحص أيضًا الحسابات النموذجية والحدية. يكتشفون أن إحدى المجموعات هي ببساطة عملاء جدد بملاحظة أقصر، لذا يتم التعامل مع مدة الاشتراك صراحة. يُقارن K‑means بالبدائل الهرمية والمعتمدة على الكثافة بدلاً من افتراض ملاءمتها. يُعامل التمرين كـ تعلم غير خاضع للإشراف، وليس اكتشاف تسميات.
توجه الشرائح البحث وتجارب الرسائل، لا الأهلية أو السعر. تتلقى الحسابات الجديدة البعيدة عن جميع المراكز إسنادًا غير معروف. تُصدر التحجيم والخصائص والمراكز والأسماء، وتُعيد التدريب ربط المجموعات الجديدة بالقديمة فقط عند وجود دليل. يراقب الرصد حجم المجموعة، والمسافة، وصلة النتيجة. تُدقق السمات الحساسة والوكيلات، ويتجنب الفريق وصف المجموعات كأنواع شخصية طبيعية عندما تكون تقسيمات رياضية لسلوك مختار.
دليل التنفيذ والاستعداد التشغيلي
يتطلب قرار الإنتاج أكثر من عرض ناجح. عرّف المستخدمين المستهدفين، بيئة التشغيل، المدخلات، المخرجات، الاعتمادات، المالك، وعواقب كل فشل مهم. أنشئ خط أساس قابل لإعادة الإنتاج ومجموعة تقييم مُصدَّرة قبل الضبط. اختبر الحالات العادية، ظروف الحدود، المدخلات المشوهة أو المفقودة، تحول التوزيع، انقطاع الاعتماد، سوء الاستخدام، والمجموعات أو البيئات الأكثر احتمالًا لتقليل الخدمة. قس جودة المهمة مع المعايرة أو عدم اليقين، الكمون، الإنتاجية، تكلفة الموارد، إمكانية الوصول، الخصوصية، والأمان. سجِّل كل تحويل وعَتبة حتى يتمكن مراجع مستقل من إعادة إنتاج النتيجة وتمييز الأدلة عن النموذج الجذاب.
قبل الإطلاق، عيّن سلطة للإصدار، الاستثناءات، التغييرات، التراجع، والتقاعد. استخدم نشرًا متدرجًا، احتفظ ببديل آمن، وتحقق من المراقبة عبر إدخال أخطاء متعمدة. يجب أن تكشف القياسات التشغيلية عن جودة المدخلات، سلوك المخرجات، نسخة النموذج أو القاعدة، صحة الاعتماد، التدخل البشري، والنتائج المؤكدة دون جمع بيانات حساسة غير ضرورية. عرّف عتبات التنبيه وصاحب الاستجابة، ثم راجع الأدلة الواقعية بعد النشر بدلاً من افتراض استمرار الأداء غير المتصل. أعد التقييم كلما تغيرت مصادر البيانات أو المستخدمون أو النماذج أو البائعون أو السياسات أو الأجهزة أو الأهداف. يحتاج النظام المُصان أيضًا إلى إجراءات موثقة للاسترداد، تعلم الحوادث، الحذف والاحتفاظ، ونقطة واضحة يجب فيها تعطيله أو استبداله.
الأسئلة المتكررة
هل K-means خاضع للإشراف أم غير خاضع للإشراف؟
إنه غير خاضع للإشراف لأنه يتلقى الخصائص وعدد المجموعات المختار، وليس تسميات الهدف.
هل يقوم K-means بتصنيف البيانات الجديدة؟
بعد التدريب، يمكن إسناد نقطة جديدة إلى أقرب مركز لها. هذا إسناد مجموعة، وليس بالضرورة تنبؤًا فئةً خاضعًا للإشراف.
المراجع الأساسية